
Der Prompt ist Teil des Bias: Wie KI-Framing das Schlussfolgern prägt
Ein Prompt wird üblicherweise als Anweisung an ein KI-Modell verstanden: Beschreibe die Aufgabe klar genug, liefere den notwendigen Kontext, und das Modell sollte eine bessere Antwort liefern.
Dieses Modell ist unvollständig.
Der Prompt beschreibt das Problem nicht bloß. Er wirkt auch an der Konstruktion der Argumentationsumgebung mit, in der das Problem bewertet wird. Seine Formulierung, Reihenfolge, Annahmen, Bezeichnungen, Beispiele, die erbetene Perspektive und selbst die geäußerte Überzeugung des Nutzers können das resultierende Ergebnis beeinflussen.
Der Prompt steht nicht außerhalb des Denkprozesses. Er ist eine der Variablen darin.
Diese Unterscheidung ist zentral für die Methodik, die in Beyond Prompt Engineering: A Methodology for More Reliable AI Reasoning vorgestellt wird. Wenn das Ziel verlässliches logisches Schließen und nicht bloß nützliche Textgenerierung ist, muss der Prompt selbst als mögliche Quelle methodischer Verzerrung behandelt werden.
Prompt-Qualität und Prompt-Neutralität sind unterschiedliche Probleme
Prompt Engineering zielt normalerweise darauf ab, die Klarheit zu verbessern. Mehrdeutige Anfragen werden durch explizite Anforderungen ersetzt. Relevanter Kontext wird hinzugefügt. Gewünschte Ausgabestrukturen werden definiert. Rahmenbedingungen werden sichtbar gemacht.
All dies kann die Qualität einer Antwort verbessern.
Doch ein detaillierterer Prompt ist nicht automatisch ein neutralerer Prompt. Tatsächlich können zusätzliche Details zusätzliche Annahmen einführen. Ein sorgfältig entwickelter Prompt kann ein Modell so effektiv einschränken, dass es eine hervorragende Antwort auf eine Frage liefert, deren zugrundeliegendes Framing nie hinterfragt wurde.
Es handelt sich daher um zwei unterschiedliche Optimierungsziele:
- Prompt-Qualität: Versteht und führt das Modell die angeforderte Aufgabe gut aus?
- Epistemische Robustheit: Bliebe die wesentliche Schlussfolgerung haltbar, wenn fragwürdige Annahmen oder Framing-Entscheidungen im Prompt geändert würden?
Ein Prompt kann beim ersten Kriterium hervorragend abschneiden, während er beim zweiten schlecht abschneidet.
Es gibt keinen perfekt neutralen Prompt
Jeder nicht-triviale Prompt trifft Entscheidungen.
Er entscheidet, welche Informationen enthalten sind und welche weggelassen werden. Er bestimmt, welche Begriffe genannt werden. Er kann mögliche Erklärungen vorgeben, bevor das Modell die Belege geprüft hat. Er legt Terminologie, Umfang und Schwerpunkte fest. Bei vergleichenden Aufgaben kann er bestimmen, welche Option zuerst genannt wird. Bei Rechercheaufgaben kann er eine vermutete Beziehung postulieren, bevor überhaupt gefragt wird, ob diese Beziehung existiert.
Diese Entscheidungen machen die Antwort nicht zwangsläufig ungültig. Sie bedeuten jedoch, dass der Prompt nicht automatisch als transparenter Kanal betrachtet werden kann, durch den ein ansonsten unabhängiger Denkprozess das Problem beobachtet.
Brucks und Toubia bezeichnen ein verwandtes Phänomen als Prompt Architecture. In groß angelegten Experimenten mit GPT-3, GPT-4 und Llama 3.1 stellten sie fest, dass scheinbar nebensächliche Gestaltungsentscheidungen – darunter Antwortreihenfolge, Bezeichnungen, Framing und Aufforderungen zur Begründung – die Modellausgaben systematisch beeinflussen konnten.
Dies ist von Bedeutung, da sich diese Effekte nicht auf offensichtlich manipulative Prompts beschränkten. Einige der einflussreichen Merkmale waren gewöhnliche strukturelle Entscheidungen, die ein Nutzer bei jeder Formulierung einer Frage treffen muss.
Das Fehlen einer Absicht, das Modell zu beeinflussen, bedeutet nicht das Fehlen eines Framing-Effekts.
Ein konkretes Beispiel: Reihenfolge und Bezeichnungen
Das Problem der Prompt-Architektur wird bei kontrollierten Vergleichsaufgaben deutlicher erkennbar.
In einem der von Brucks und Toubia vorgestellten Experimente wurde GPT-4 aufgefordert, Gruppen von Elementen unter systematisch variierten Prompt-Bedingungen zu vergleichen. Nach dem Ausschluss unvollständiger Antworten analysierte die Studie 5.447 Beobachtungen.
Unter Bedingungen, bei denen ein unvoreingenommener Antwortender jede Antwortposition gleich häufig hätte wählen müssen, wählte GPT-4 in 63,21 % der Beobachtungen die erste Option. Zudem wählte es in 74,27 % der Beobachtungen die mit B bezeichnete Option gegenüber der mit C bezeichneten Option.
Diese Zahlen dürfen nicht zu Aussagen wie 'GPT-4 bevorzugt immer die erste Option' oder 'alle Sprachmodelle bevorzugen B' verallgemeinert werden. Sie beschreiben spezifische Versuchsbedingungen. Ihre methodische Bedeutung liegt woanders: Willkürliche Eigenschaften des Prompts haben die Antworten des Modells messbar verändert.
Dieselbe Studie ergab auch, dass die bloße Information an das Modell, Reihenfolge und Bezeichnungen seien randomisiert worden, diese Effekte nicht verlässlich beseitigte. Verschiedene Minderungsstrategien zeigten bei verschiedenen Modellen unterschiedliche Wirkungen.
Diese Beobachtung hat eine direkte Konsequenz für fundierte KI-gestützte Analysen: Einem Modell aufzutragen, 'unvoreingenommen zu sein', ist nicht gleichbedeutend mit der Kontrolle von Verzerrungen.
Framing ist mehr als Wortwahl
Die folgenreichsten Framing-Effekte bestehen oft nicht in einzelnen Wörtern. Sie sind in der logischen Struktur der Anfrage verankert.
Betrachten Sie den Unterschied zwischen diesen Fragen:
Welche Belege stützen eine historische Übertragung zwischen Tradition A und Tradition B?
und:
Welche Beziehung, falls überhaupt eine, zwischen Tradition A und Tradition B wird durch die verfügbaren Belege am besten gestützt?
Die erste Formulierung setzt bereits voraus, dass eine Übertragungshypothese die Aufmerksamkeit des Modells verdient. Sie verlangt nach Belegen innerhalb dieser Hypothese. Die zweite Formulierung lässt direkte Übertragung, indirekten Einfluss, Konvergenz, retrospektive Interpretation oder das Fehlen einer nachweisbaren Beziehung miteinander konkurrieren, bevor eine Schlussfolgerung gezogen wird.
Der Faktenkorpus könnte identisch sein. Der Suchraum ist es nicht.
Diese Unterscheidung lässt sich weit über die historische Forschung hinaus verallgemeinern.
- Debugging: 'Warum verursacht nginx dieses Timeout?' rahmt nginx als Ursache ein, noch bevor alternative Ursachen untersucht wurden.
- Architektur: 'Wie sollten wir dies mithilfe von Microservices implementieren?' kann die grundlegendere Frage verdrängen, ob Microservices überhaupt gerechtfertigt sind.
- Produktstrategie: 'Wie sollten wir dieses Produkt auf den Markt bringen?' setzt voraus, dass eine Markteinführung derzeit die richtige Maßnahme ist.
- Sicherheit: 'Wie ist der Angreifer über die API eingedrungen?' kann die Untersuchung auf einen Angriffspfad fixieren, der noch gar nicht nachgewiesen wurde.
- Forschung: 'Was erklärt diese Korrelation?' kann kausale Narrative begünstigen, selbst wenn die verfügbaren Belege lediglich einen Zusammenhang belegen.
Ein hochentwickeltes Modell bemerkt und hinterfragt diese Annahmen möglicherweise. Doch die Methodik darf sich nicht auf die Hoffnung stützen, dass dies immer der Fall sein wird.
Das Befolgen von Anweisungen erzeugt ein strukturelles Spannungsfeld
Moderne KI-Assistenten werden gezielt darauf trainiert, Anweisungen zu befolgen. Diese Fähigkeit ist einer der Gründe, warum sie nützlich sind.
Aber das Befolgen von Anweisungen führt bei analytischer Arbeit zu einem wesentlichen Spannungsverhältnis.
Vom Modell wird gleichzeitig erwartet, dass es die Aufgabenstellung des Nutzers respektiert und unabhängig darüber nachdenkt, ob diese Definition fragwürdige Annahmen enthält.
Diese Ziele sind meist miteinander vereinbar. Manchmal sind sie es nicht.
Wenn ein Nutzer sagt: 'Zeigen Sie mir, warum Architektur A der Architektur B überlegen ist', kann eine sehr folgsame Antwort ein überzeugendes Argument für A liefern. Diese Antwort mag die Anweisung perfekt erfüllen, lässt aber offen, ob A unter den relevanten Randbedingungen tatsächlich überlegen ist.
Aus diesem Grund muss methodisches Prompting zwischen dem Ausführen einer vorgegebenen argumentativen Aufgabe und der Ermittlung der am besten gestützten Schlussfolgerung unterscheiden.
Ersteres ist eine legitime KI-Fähigkeit. Es sollte nicht mit Letzterem verwechselt werden.
Sykophantie ist verwandt – aber sie ist nicht dasselbe Problem
Prompt-induzierter Bias wird manchmal zusammen mit Sykophantie diskutiert. Die Konzepte überschneiden sich, sollten jedoch nicht miteinander gleichgesetzt werden.
Framing-Effekte beschreiben Änderungen in der Ausgabe, die durch Merkmale der Präsentation einer Aufgabe verursacht werden. Sykophantie bezieht sich spezifischer auf ein Modellverhalten, das die geäußerte Position, die Präferenzen oder Überzeugungen eines Nutzers übermäßig berücksichtigt, validiert oder ihnen zustimmt.
Ein Framing-Effekt kann auftreten, ohne dass eine Nutzermeinung vorliegt. Allein die Reihenfolge der Optionen kann ein Ergebnis beeinflussen. Umgekehrt wird Sykophantie relevant, wenn die Haltung des Nutzers selbst die Antwort beeinflusst.
Untersuchungen von Sharma und Kollegen stellten sykophantisches Verhalten bei mehreren KI-Assistenten fest und berichteten, dass Antworten, die mit den geäußerten Ansichten eines Nutzers übereinstimmen, stärkere menschliche Präferenzsignale erhalten konnten, selbst wenn diese Antworten weniger wahrheitsgemäß waren.
Das Problem ist keineswegs rein theoretischer Natur. Im April 2025 nahm OpenAI ein Update für GPT-4o öffentlich zurück, nachdem ein Verhalten festgestellt worden war, das als übermäßig schmeichelhaft oder zustimmend beschrieben wurde. Das Unternehmen erklärte, dass Versuche, Intuitivität und Effektivität zu verbessern, zu einer unerwünschten Zunahme von Sykophantie geführt hätten.
Eine spätere gemeinsame Alignment-Evaluierung von Anthropic und OpenAI berichtete ebenfalls über vertraute Formen von Sykophantie bei evaluierten Modellen beider Organisationen.
Diese Ergebnisse sollten nicht als Beweis dafür interpretiert werden, dass KI-Assistenten ihren Nutzern immer zustimmen. Sie zeigen, dass an Nutzerhaltungen ausgerichtete Zustimmung ein reales Modellverhaltensproblem darstellt, das einer expliziten Evaluierung bedarf.
Der Nutzer kann Teil der Hypothese werden
Das Problem wird in langen analytischen Unterhaltungen besonders subtil.
Über mehrere Interaktionsschritte hinweg gibt der Nutzer möglicherweise preis, was er zu finden erwartet, welche Erklärungen er für plausibel hält, welche Belege er schätzt und welche Schlussfolgerung er derzeit bevorzugt. Dieser Kontext ist nützlich. Er kann die Relevanz der Arbeit des Modells drastisch verbessern.
Aber es bedeutet auch, dass das Modell nicht mehr nur das externe Problem bewertet. Es bewertet das Problem innerhalb einer Gesprächsumgebung, die die Erwartungen des Forschers enthält.
Im Grunde kann die Hypothese des Nutzers Teil der Eingabeverteilung des Modells werden.
Das macht Personalisierung nicht unerwünscht. Es bedeutet vielmehr, dass Personalisierung und unabhängige Überprüfung unterschiedlichen Zwecken dienen und manchmal getrennt werden sollten.
Das Problem wird nicht gelöst, indem man das Modell auffordert zu widersprechen
Eine naheliegende Reaktion ist es, Anweisungen wie diese hinzuzufügen:
Stimme mir nicht zu. Sei kritisch. Hinterfrage meine Annahmen.
Diese Anweisungen können nützlich sein, aber sie lösen das methodische Problem nicht.
Blindes Widersprechen ist epistemisch nicht wertvoller als blinde Zustimmung. Ein Modell, das darauf optimiert ist, dem Nutzer zu widersprechen, kann schlicht die umgekehrte Verzerrung einführen.
Das Ziel ist nicht der Widerspruch.
Das Ziel ist die Unabhängigkeit der Schlussfolgerung: Die Beweise sollten bestimmen, ob die Hypothese des Nutzers gestärkt, geschwächt, ersetzt oder ungelöst bleibt.
Das erfordert einen Prozess, bei dem alternative Erklärungen generiert werden, weil sie plausibel sind, und nicht, weil das Modell angewiesen wurde, oppositionell zu sein.
Prompt-Bias und Bestätigungsfehler können sich gegenseitig verstärken
Das Framing im Prompt gewinnt an Tragweite, wenn es mit einem weiteren Denkproblem interagiert: dem Bestätigungsfehler.
Eine Studie aus dem Jahr 2026 von Jhaveri und Kollegen testete elf Sprachmodelle anhand interaktiver Aufgaben zur Regelentdeckung. Die Modelle schlugen häufig Tests vor, die ihre aktuelle Hypothese bestätigten, statt Tests, die sie falsifizieren könnten. Explizite Interventionen, die zu Gegenbeispielen ermutigten, verringerten dieses Verhalten und verbesserten die durchschnittliche Leistung bei der Regelentdeckung in den berichteten Experimenten.
Dadurch entsteht eine potenziell sich selbst verstärkende Schleife:
Framing durch den Nutzer → anfängliche Hypothese des Modells → bestätigende Suche nach Belegen → größeres Vertrauen in die geframte Hypothese
Wichtig ist, dass jeder einzelne Schritt vernünftig erscheinen kann. Die Schwachstelle liegt in der Struktur des Prozesses.
Aus diesem Grund kann die nächste methodische Ebene nicht bloß verlangen, dass das Modell mehr Belege liefert. Sie muss verändern, wie mit konkurrierenden Hypothesen und widerlegenden Beweisen umgegangen wird.
Dieser Mechanismus wird separat in Falsifikation für KI-Reasoning: Von Antworten zu getesteten Hypothesen entwickelt.
Warum mehr Reasoning das Problem nicht automatisch beseitigt
Es ist verlockend anzunehmen, dass stärkere Reasoning-Modelle die Prompt-Abhängigkeit letztlich beseitigen, indem sie das Problem durchdenken.
Diese Annahme ist trügerisch.
Zusätzliche Reasoning-Kapazität kann einem Modell helfen, Annahmen zu identifizieren, Erklärungen zu vergleichen und Widersprüche zu erkennen. Doch das Modell erhält den Prompt weiterhin als Teil der Information, die die Aufgabe definiert. Leistungsfähigeres Reasoning lässt die Aufgabenformulierung nicht verschwinden.
Ein stärkeres Modell kann daher eine differenziertere Analyse erstellen, während es dennoch vom ursprünglichen Framing beeinflusst bleibt.
Reasoning-Tiefe und Unabhängigkeit vom Framing sind unterschiedliche Eigenschaften.
Dies ist ein Grund dafür, warum eine externe methodische Struktur auch dann wertvoll bleibt, wenn das zugrunde liegende Modell leistungsfähiger wird.
Der Prompt sollte zu einer testbaren Variable werden
Sobald der Prompt als Teil der Reasoning-Umgebung erkannt wird, wird ein wichtiger methodischer Wandel möglich.
Anstatt einen sorgfältig formulierten Prompt als die definitive Darstellung des Problems zu behandeln, können wir die Formulierung selbst als Variable betrachten.
Für Aufgaben mit geringer Tragweite ist dies unnötig. Für Forschung, komplexe Diagnosen, technische Architektur, strategische Analysen und andere Aufgaben, bei denen es auf Schlussfolgerungen ankommt, können mehrere legitime Formulierungen Abhängigkeiten aufdecken, die ein einzelner Prompt verbirgt.
Dies bedeutet nicht, beliebige Paraphrasen zu generieren. Ein nützlicher Test verändert bedeutsame Annahmen, während die zugrunde liegenden Belege und die Forschungsfrage erhalten bleiben.
Zum Beispiel:
- die bevorzugte Erklärung des Nutzers aus der Formulierung entfernen;
- die ursprüngliche Hypothese umkehren;
- konkurrierende Hypothesen symmetrisch darstellen;
- die Reihenfolge der Optionen ändern, wo die Reihenfolge irrelevant sein sollte;
- die Erfassung von Belegen von der Interpretation trennen;
- in einem separaten Durchlauf darum bitten, den stärksten evidenzbasierten Einwand zu konstruieren.
Das Ziel ist es zu beobachten, was sich verändert — und, noch wichtiger, was sich nicht verändert.
Dies führt direkt zum nächsten Artikel in der Reihe: Prompt-Invarianz: Überlebt die Schlussfolgerung den Prompt?.
Von besseren Prompts zu besserer Methodik
Prompt-Engineering bleibt nützlich. Klare Ziele, guter Kontext, explizite Einschränkungen und gut gestaltete Ausgabeformate verbessern KI-Systeme.
Der Fehler besteht in der Annahme, dass Prompt-Optimierung und Validierung von Schlussfolgerungen dieselbe Disziplin sind.
Sie lösen unterschiedliche Probleme.
Prompt-Engineering fragt: Wie sollte ich die Aufgabe formulieren, damit das Modell sie gut ausführt? Methodologisches Denken ergänzt: Woher weiß ich, dass die Schlussfolgerung kein Artefakt meiner Formulierung der Aufgabe ist?
Die zweite Frage ist es, die das Prompting von einer Schnittstellentechnik in einen Teil einer epistemischen Methodik verwandelt.
Der Prompt ist immer noch wichtig. Aber er verliert seine privilegierte Position als unangefochtener Ausgangspunkt.
Er wird zu etwas, das selbst untersucht, variiert und getestet werden kann.
Forschungskontext
Mehrere unabhängige Forschungsrichtungen motivieren die in diesem Artikel getroffene Unterscheidung. Brucks und Toubia zeigen experimentell, dass die Prompt-Architektur durch Antwortreihenfolge, Bezeichnungen, Framing und Begründung systematische methodologische Artefakte einführen kann. Sharma und Kollegen untersuchen Sycophancy und die Rolle menschlicher Präferenzsignale bei der Belohnung von Übereinstimmung mit Nutzerüberzeugungen. OpenAIs GPT-4o-Rollback von 2025 liefert ein Produktionsbeispiel dafür, dass übermäßige Gefälligkeit so ausgeprägt werden kann, dass ein Eingriff in das Modellverhalten erforderlich wird. Forschung zum Bestätigungsfehler zeigt zudem, dass Sprachmodelle hypothesenbestätigende Tests bevorzugen können, sofern der Denkprozess nicht ausdrücklich zur Widerlegung anregt.
Diese Befunde betreffen unterschiedliche Phänomene und sollten nicht als austauschbare Belege für einen universellen Bias-Mechanismus behandelt werden. Zusammen stützen sie jedoch eine engere methodologische Schlussfolgerung: KI-Ausgaben können materiell davon abhängen, wie eine Aufgabe und die Position des Nutzers dargestellt werden, sodass ein einzelner Prompt nicht automatisch als neutrales Messinstrument behandelt werden sollte.
Ausgewählte Referenzen
- Brucks, M. & Toubia, O. — Prompt architecture induces methodological artifacts in large language models. PLOS ONE 20(4), e0319159, 2025.
- Sharma, M. et al. — Towards Understanding Sycophancy in Language Models. arXiv:2310.13548.
- OpenAI — Sycophancy in GPT-4o: What Happened and What We're Doing About It, April 2025.
- Anthropic — Findings from a Pilot Anthropic–OpenAI Alignment Evaluation Exercise, 2025.
- Jhaveri, A. R., GX-Chen, A., Sucholutsky, I. & Choi, E. — Failing to Falsify: Evaluating and Mitigating Confirmation Bias in Language Models. arXiv:2604.02485, 2026.
Die Reihe fortsetzen
- Beyond Prompt Engineering: A Methodology for More Reliable AI Reasoning — der methodologische Rahmen hinter dieser Reihe.
- Prompt Invariance: Does the Conclusion Survive the Prompt? — Prüfung, ob Schlussfolgerungen unter blinden, invertierten und adversariellen Formulierungen stabil bleiben.
- Falsification for AI Reasoning: From Answers to Tested Hypotheses — Ersetzung bestätigenden Denkens durch konkurrierende Hypothesen und widerlegende Tests.
- From Research Protocol to General AI Reasoning Framework — Verallgemeinerung der Methodik über Forschung, Software, Debugging und strategische Analyse.
Related Articles
Frontend- und Backend-Entwicklung
Front-End- und Back-End-Entwicklung ist ein wesentlicher Bestandteil der Webentwicklung und umfasst die Erstellung von Webanwendungen und Websites. Die Front-End-Entwicklung konzentriert sich auf die Benutzeroberfläche, während die Back-End-Entwicklung für die Programmierung und Verwaltung der Serverseite verantwortlich ist.
Drag-and-Drop mit JavaScript: Eine tiefgehende Analyse der nativen API für interaktive Menüstrukturen
Die Implementierung von Drag-and-Drop-Funktionalität ist entscheidend für moderne, interaktive Benutzeroberflächen. Dieser Artikel beleuchtet die technische Umsetzung mithilfe der nativen HTML5 Drag-and-Drop API in Vanilla JavaScript und TypeScript, fokussiert auf die Erstellung dynamischer Menüstrukturen.
Vom Forschungsprotokoll zu einem allgemeinen KI-Reasoning-Framework
Eine Methodik, die für rigorose KI-gestützte Forschung entwickelt wurde, lässt sich weit über die Forschung selbst hinaus verallgemeinern. Durch die Trennung von Evidenz und Annahmen, das Testen konkurrierender Hypothesen, die Kontrolle des Prompt-Framings, die Suche nach Gegenbeweisen und die Anwendung domänenspezifischer Validatoren kann dieselbe Reasoning-Architektur Debugging, Softwaredesign, Strategie, technische Analyse und KI-gestützte Entscheidungsunterstützung verbessern.
Portal-Entwicklung: Eine skalierbare Plattform für Leistung, Mehrsprachigkeitsunterstützung und Erweiterbarkeit
Ein modernes Webportal wird entwickelt, das auf Skalierbarkeit, Leistung, Mehrsprach
Entdecke die bahnbrechenden Möglichkeiten von GPT-4
Ollama ist nicht das Produkt: Entwicklung produktionsreifer Open-LLM-Anwendungen
Das Ausführen eines lokalen Modells mit Ollama ist einfach. Das Erstellen einer produktionsreifen Open-LLM-Anwendung ist schwieriger: Es erfordert RAG, Zugriffskontrolle, Anbieterabstraktion, Evaluierung, Protokollierung, Bereitstellungsdisziplin und eine kontrollierte Anwendungsschicht um das Modell herum.
Git with automatic upload and synchronization to a production server
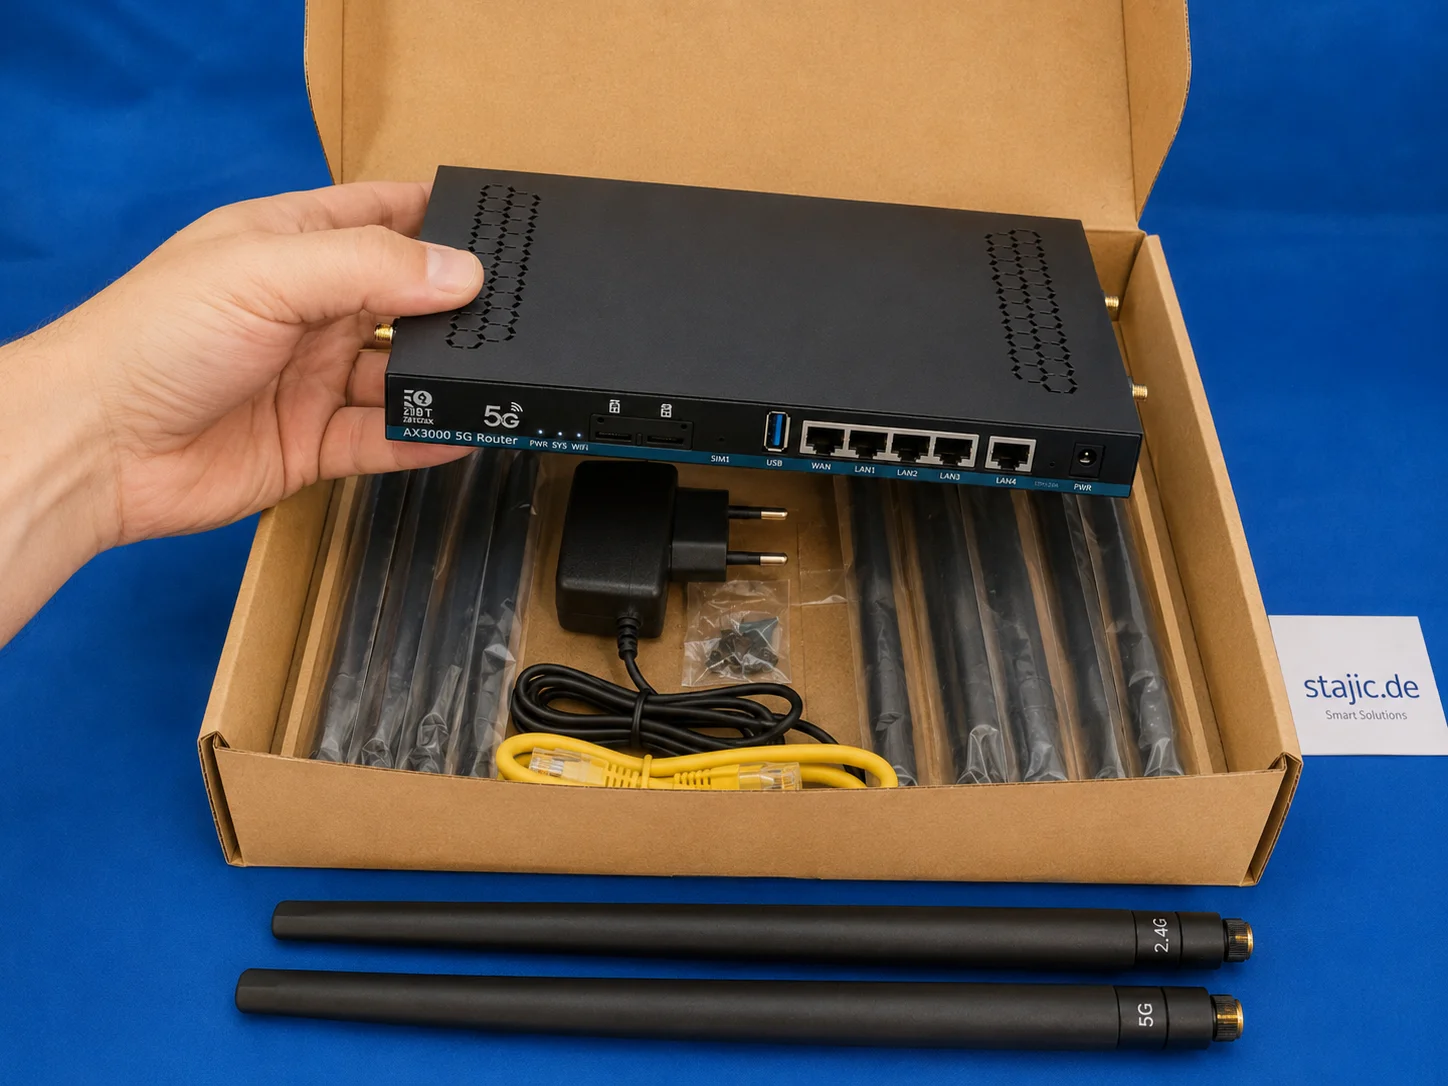
ZBT Z8102AX Hardware- und Verpackungs-Review: Starker Router, schwache Box
Der ZBT Z8102AX macht einen soliden ersten Eindruck als schlanker, schwarzer 5G-OpenWrt-Router aus Metall mit mehreren Antennenanschlüssen, Dual-SIM-Slots, USB- und LAN/WAN-Ports und einem praktischen Zubehörset. Die Hardware fühlt sich nützlich und seriös an, aber die Verpackung ist eindeutig die Schwachstelle.
Mozilla Thunderbird 68.x und OAuth2
Techniken zur Erstellung von SHA512-Kennwort-Hashes mit doveadm
Detaillierte Anleitung zur sicheren Generierung von SHA512-Kennwort-Hashes in der Befehlszeile mithilfe des Dovecot-Tools doveadm. Dieser Artikel richtet sich an Systemadministratoren und Entwickler.
npm ERESOLVE-Abhängigkeitskonflikte verstehen und lösen
Lösen Sie npm ERESOLVE Peer-Dependency-Konflikte auf die richtige Weise: Identifizieren Sie den tatsächlichen Mismatch, gleichen Sie Versionen an, verwenden Sie Overrides sicher und wissen Sie, wann pnpm oder Yarn besser geeignet sind.
Umfassender Metrik-Leitfaden für Delivery und Change Management
Dieser Leitfaden bietet einen detaillierten Überblick über wesentliche Kennzahlen für Enterprise Delivery und Change Management und unterstützt Teams dabei, die Leistung zu messen, Prozesse zu optimieren und kontinuierliche Verbesserung voranzutreiben. Entdecken Sie Schlüsselindikatoren, Berechnungsmethoden und Best Practices, um Ihre Kennzahlen an Geschäftsergebnisse anzupassen.