
Falsifikation für KI-Schlussfolgern: Von Antworten zu getesteten Hypothesen
Ein Sprachmodell kann für eine überraschend große Anzahl plausibler Erklärungen unterstützende Belege liefern.
Diese Fähigkeit ist nützlich für die Erkundung, aber gefährlich als Validierungsmethode. Wenn das Modell mit einer Hypothese beginnt und die Aufgabe einfach darin besteht zu erklären, warum sie richtig sein könnte, kann eine kohärente Antwort entstehen, lange bevor die Hypothese einen ernsthaften Test bestanden hat.
Zuverlässiges KI-Schlussfolgern erfordert daher eine stärkere Frage:
Welche Belege würden diese Hypothese widerlegen?
Dieser Artikel entwickelt eine falsifikationsorientierte Denkweise als nächste Ebene der Methodik, die in Beyond Prompt Engineering: A Methodology for More Reliable AI Reasoning eingeführt wurde. Der vorherige Artikel, Prompt Invariance: Does the Conclusion Survive the Prompt?, prüft, ob eine Schlussfolgerung Änderungen der Formulierung übersteht. Falsifikation befasst sich mit einem anderen Problem: ob die Hypothese Belegen standhält, die gegen sie sprechen könnten.
Prompt-Invarianz testet die Abhängigkeit von der Formulierung. Falsifikation testet die Anfälligkeit für Belege.
Warum Bestätigung zu einfach ist
Angenommen, einem KI-System wird eine Hypothese vorgegeben und es wird gebeten festzustellen, ob sie plausibel ist.
Das Modell kann sein Wissen, bereitgestellte Dokumente oder abgerufene Quellen nach Beobachtungen durchsuchen, die mit dieser Hypothese vereinbar sind. Wenn genügend vereinbare Beobachtungen gefunden werden, kann die resultierende Erklärung zunehmend überzeugend wirken.
Aber Vereinbarkeit ist schwache Evidenz, wenn mehrere konkurrierende Hypothesen dieselbe Beobachtung vorhersagen.
Betrachten Sie einen abstrakten Fall:
Beobachtung E ist mit Hypothese H1 vereinbar.
Diese Aussage allein belegt H1 nicht. Wenn H2, H3 und H4 ebenfalls E vorhersagen, trägt E wenig dazu bei, zwischen ihnen zu unterscheiden.
Evidenz wird informativer, wenn konkurrierende Erklärungen unterschiedliche Vorhersagen darüber treffen, was wir beobachten sollten.
Dies verschiebt den Denkprozess vom Sammeln unterstützender Fakten hin zum Entwerfen diskriminierender Tests.
Die klassische Idee hinter der Falsifikation
Karl Poppers Falsifikationismus betonte eine Asymmetrie zwischen Verifikation und Widerlegung. Wiederholte Beobachtungen, die mit einer allgemeinen Aussage vereinbar sind, können logisch nicht beweisen, dass diese Aussage wahr ist, während eine echte unvereinbare Beobachtung direkt mit ihr in Konflikt geraten kann.
In vereinfachter logischer Form:
Wenn H wahr ist, sollte die Beobachtung O auftreten. O tritt nicht auf. Daher wird H, wie unter den Testbedingungen angegeben, in Frage gestellt.
Die Stärke dieses Ansatzes liegt nicht darin, Theorien bei jeder Gelegenheit als falsch zu erweisen, sondern darin, zu verlangen, dass Behauptungen sich der Möglichkeit des Scheiterns aussetzen.
Eine Hypothese, die jedes denkbare Ergebnis ohne Änderung aufnehmen kann, ist schwer zu testen, weil keine Beobachtung ihr sinnvoll widerspricht.
Eine nützliche Hypothese sollte ein Risiko eingehen: Einige mögliche Belege müssen mit ihr weniger vereinbar sein als mit ihren Alternativen.
Falsifikation ist in der Praxis komplizierter
Die populäre Version der Falsifikation ist oft zu einfach: Eine widersprüchliche Beobachtung erscheint, daher ist die Hypothese sofort falsch.
Reale Untersuchungen funktionieren selten so sauber.
Eine Vorhersage hängt normalerweise nicht nur von der zentralen Hypothese ab, sondern auch von Hilfsannahmen: Messgenauigkeit, Zuverlässigkeit der Quelle, Umweltbedingungen, Implementierungsdetails, Hintergrundtheorien oder der Vollständigkeit der verfügbaren Belege.
Eine realistischere logische Struktur ist:
H + A1 + A2 + A3 → erwartete Beobachtung O
Wenn O nicht beobachtet wird, sagt uns die fehlgeschlagene Vorhersage, dass etwas in der vollständigen erklärenden Struktur falsch ist. Sie sagt uns nicht automatisch, welche Komponente versagt hat.
Die Hypothese kann falsch sein. Die Messung kann unzuverlässig sein. Eine angenommene Bedingung wurde möglicherweise nicht erfüllt. Eine Quelle kann unvollständig sein. Das Modell hat die Belege möglicherweise missverstanden.
Diese Unterscheidung ist entscheidend für KI-Schlussfolgerungen. Das Ziel ist nicht naive Ablehnung. Das Ziel ist die systematische Aussetzung von Hypothesen gegenüber Belegen, die sie schwächen können.
Falsifikationsorientiertes Denken für LLMs
Strikte Poppersche Falsifikation lässt sich am natürlichsten auf Behauptungen anwenden, die klar testbare Konsequenzen erzeugen. Viele von KI-Assistenten bearbeitete Aufgaben sind weniger sauber: historische Interpretation, Fehlersuche, Architektur, Strategie und Kausalanalyse beinhalten oft unvollständige Belege und probabilistische Erklärungen.
Für diese Bereiche ist der allgemeinere Begriff falsifikationsorientiertes Denken nützlich.
Das Ziel ist nicht unbedingt, einen einzelnen logisch entscheidenden Falsifikator zu erhalten. Es geht darum, die Analyse so zu organisieren, dass Belege, die der aktuellen Hypothese widersprechen, sie schwächen oder gegen sie unterscheiden können, ausdrückliche Beachtung erhalten.
Frage nicht nur, was H stützt. Frage, was existieren sollte, wenn H wahr ist, was schwer zu erklären sein sollte, wenn H wahr ist, und welche Alternative dieselben Belege besser erklärt.
Schritt 1 — Formuliere die Hypothese präzise
Eine Hypothese kann nicht sinnvoll getestet werden, wenn sie vage genug ist, um jedes Ergebnis zu absorbieren.
Vergleiche:
Das System ist instabil, weil etwas in der Netzwerkschicht falsch ist.— Schwache Hypothese
mit:
Die intermittierenden API-Fehler werden dadurch verursacht, dass der Reverse-Proxy Upstream-Verbindungen schließt, wenn das konfigurierte Timeout überschritten wird.— Testbare Hypothese
Die zweite Behauptung setzt sich konkreten Tests aus. Wir können Timeout-Werte, Verbindungsdauer, Proxy-Logs, Upstream-Verhalten und Fehler unterhalb des konfigurierten Schwellenwerts untersuchen.
Je präziser eine Hypothese die behauptete Beziehung definiert, desto leichter lässt sich bestimmen, welche Evidenz gegen sie sprechen würde.
Schritt 2 — Generiere echte konkurrierende Hypothesen
Eine einzelne Hypothese isoliert zu testen ist schwach, weil fast jede Beobachtung relativ zu etwas anderem interpretiert wird.
Das System sollte daher glaubwürdige Alternativen konstruieren, bevor es die Evidenz bewertet.
Für denselben API-Fehler könnten Kandidatenerklärungen Folgendes umfassen:
- H1: Reverse-Proxy-Timeout;
- H2: Absturz oder Neustart der Upstream-Anwendung;
- H3: Erschöpfung der Datenbankverbindungen;
- H4: Netzwerkunterbrechung oder Paketverlust;
- H5: clientseitiges Timeout;
- H6: Interaktion zwischen mehreren Schichten statt einer isolierten Ursache.
Die Alternativen müssen plausibel genug sein, um zu konkurrieren. Offensichtlich unterlegene Alternativen zu generieren, erzeugt lediglich den Anschein kritischen Denkens.
Eine Hypothese hat den Wettbewerb nicht überstanden, wenn die Alternativen darauf ausgelegt waren zu verlieren.
Schritt 3 — Leite erwartete Beobachtungen ab
Für jede ernsthafte Hypothese sollte das Modell Beobachtungen ableiten, die unter dieser Erklärung erwartet werden.
Wenn H1 die Reverse-Proxy-Timeout-Hypothese ist, könnten erwartete Beobachtungen Folgendes umfassen: Fehler, die um eine bestimmte Dauer herum gehäuft auftreten, entsprechende Timeout-Meldungen in Proxy-Logs, gesunde Upstream-Prozesse zum Zeitpunkt des Fehlers und das Verschwinden des Fehlers nach einer kontrollierten Timeout-Änderung.
Für H2, eine Hypothese eines Anwendungsneustarts, würden wir ein anderes Muster erwarten: Prozessneustarts, Ausnahmen, fehlende Anwendungsverfügbarkeit, Ressourcenerschöpfung oder korrelierte Container-Ereignisse.
Der wichtige Schritt besteht darin, diese Erwartungen abzuleiten, bevor jede verfügbare Beobachtung als Unterstützung interpretiert wird.
Schritt 4 — Definieren Sie potenzielle widerlegende Beweise
Fragen Sie für jede Hypothese, welche Beweise sie wesentlich schwächen würden.
Was würden wir erwarten, nicht zu beobachten, wenn diese Hypothese die Haupterklärung wäre?
Für die Proxy-Timeout-Hypothese gehören dazu Beispiele wie Fehler, die weit unter dem konfigurierten Schwellenwert auftreten, identische Fehler bei Umgehung des Proxys, kein relevantes Ereignis auf der Proxy-Seite oder Hinweise darauf, dass die Upstream-Anwendung die Verbindung zuerst beendet.
Dies ändert das Suchziel des Modells.
Bestätigungssuche: Finden Sie Beweise, die mit H1 vereinbar sind. Widerlegungssuche: Finden Sie Beobachtungen, die H1 schlecht vorhersagt oder die H2 wesentlich besser vorhersagt.
Schritt 5 — Bevorzugen Sie diskriminierende Tests
Nicht jeder Test ist gleichermaßen informativ.
Angenommen, H1 und H2 sagen beide erhöhte Fehlerraten voraus. Das Beobachten eines weiteren Fehlers bietet wenig Unterscheidungskraft.
Ein besserer Test sucht nach einer Beobachtung, bei der ihre Vorhersagen auseinandergehen.
Guter Test: eine Beobachtung, die unter H1 wahrscheinlich, unter H2 jedoch unwahrscheinlich ist, oder umgekehrt.
Beim Debuggen kann das Umgehen des vermuteten Proxys diskriminierend sein. In der historischen Forschung kann der Nachweis einer Chronologie, die eine direkte Übertragung unmöglich macht, stark diskriminierend sein. In der Produktanalyse kann die Beobachtung desselben Nachfragerückgangs in einem Kontrollmarkt, der von der vorgeschlagenen Ursache nicht betroffen ist, eine kausale Erklärung schwächen.
Die Methodik bewertet Beweise daher nicht nur nach ihrer Zuverlässigkeit, sondern auch nach ihrer Fähigkeit, zwischen konkurrierenden Erklärungen zu unterscheiden.
Schritt 6 — Suchen Sie aktiv nach Gegenbeweisen
Sobald potenzielle Falsifizierer und diskriminierende Beobachtungen definiert sind, sollte das System aktiv nach ihnen suchen.
Diese Anforderung ist wichtig, weil Sprachmodelle selbst eine bestätigungsverzerrte Hypothesenprüfung aufweisen können.
Im Jahr 2026 passten Jhaveri, GX-Chen, Sucholutsky und Choi eine klassische Aufgabe zur Regelentdeckung an elf Sprachmodelle aus verschiedenen Modellfamilien und Größenordnungen an. Die Modelle schlugen häufig Beispiele vor, die ihre aktuelle Regel bestätigen würden, anstatt Beispiele zu entwerfen, die sie widerlegen sollten.
Die Konsequenz war praktischer Natur: Bestätigungsorientierte Exploration führte zu einer langsameren und weniger erfolgreichen Entdeckung der verborgenen Regel.
Als die Forscher ausdrücklich die Berücksichtigung von Gegenbeispielen förderten, stieg der durchschnittliche Erfolg bei der Regelentdeckung in den berichteten Experimenten von 42 % auf 56 %.
Das Modell brauchte keine neue Wissensbasis. Es brauchte eine bessere Strategie zur Hypothesenprüfung.
Dies ist direkt relevant für die breitere Methodik: Die Qualität des Schlussfolgerns kann sich verbessern, wenn der Inferenzprozess von der Bestätigungssuche zur falsifikationsorientierten Exploration übergeht.
Schritt 7 — Widerspruch von Ablehnung trennen
Das Finden von Beweisen gegen eine Hypothese rechtfertigt nicht immer eine sofortige Ablehnung.
Das System sollte zunächst die Qualität der Gegenbeweise bewerten:
- Ist die Beobachtung zuverlässig?
- Ist die Quelle primär oder indirekt?
- Könnten Mess- oder Abruffehler den Konflikt erklären?
- Sagt die Hypothese tatsächlich die strittige Beobachtung voraus?
- Hängt der Widerspruch von einer Hilfsannahme ab?
- Ist der Gegenbeweis unabhängig bestätigt?
- Erklärt eine konkurrierende Hypothese die Beweise erfolgreicher?
Erst nach dieser Bewertung sollte das Modell entscheiden, ob die Hypothese geschwächt, wesentlich überarbeitet oder abgelehnt wird.
Schritt 8 — Ad-hoc-Rettung verhindern
Eine Hypothese kann effektiv unfalsifizierbar werden, wenn jede widersprüchliche Beobachtung eine neue Ausnahme erzeugt.
Das Muster sieht so aus:
Vorhersage schlägt fehl → Ausnahme hinzufügen → Vorhersage schlägt erneut fehl → weitere Ausnahme hinzufügen → ursprüngliche Schlussfolgerung unbegrenzt beibehalten
Nicht jede Modifikation ist unzulässig. Wissenschaftlicher und technischer Fortschritt tritt häufig auf, weil unerwartete Beweise eine fehlende Variable oder eine falsche Hilfsannahme aufdecken.
Die methodische Unterscheidung besteht darin, ob die Überarbeitung neue testbare Konsequenzen erzeugt oder lediglich die bevorzugte Schlussfolgerung vor dem Scheitern schützt.
Eine produktive Überarbeitung erhöht die erklärende und vorhersagende Präzision. Eine Ad-hoc-Rettung verringert nur die Wahrscheinlichkeit, dass die Hypothese jemals scheitern kann.
Schritt 9 — Konfidenz aktualisieren statt die ursprüngliche Antwort zu verteidigen
Das Ergebnis falsifikationsorientierten Denkens muss nicht binär sein.
Mögliche Zustände sind:
- Stark gestützt: übersteht ernsthafte diskriminierende Tests und konkurrierende Erklärungen schneiden wesentlich schlechter ab.
- Vorläufig gestützt: beste verfügbare Erklärung, aber wichtige Unsicherheiten bleiben bestehen.
- Geschwächt: es gibt erhebliches Gegenbeweismaterial, aber es ist nicht entscheidend.
- Unterbestimmt: mehrere Hypothesen erklären die derzeitige Evidenz ähnlich gut.
- Verworfen: zuverlässige Evidenz widerspricht einer zentralen Vorhersage und alternative Erklärungen schneiden besser ab.
- Mit verfügbarer Evidenz nicht testbar: der derzeitige Korpus kann die Behauptungen nicht sinnvoll unterscheiden.
Die zentrale Regel ist einfach: Das Vertrauen sollte dem Ergebnis der Tests folgen und nicht der rhetorischen Investition des Modells in seine erste Antwort.
Eine Falsifikationsmatrix
Für komplexe Analysen können Hypothesen in eine Vergleichsmatrix normalisiert werden.
| Dimension | H1 | H2 | H3 |
| Kernbehauptung | Präzise definieren | Präzise definieren | Präzise definieren |
| Erwartete Evidenz | Vorhersagen auflisten | Vorhersagen auflisten | Vorhersagen auflisten |
| Potenzielles Gegenbeweismaterial | Definieren | Definieren | Definieren |
| Diskriminierender Test | Spezifizieren | Spezifizieren | Spezifizieren |
| Stützende Beobachtungen | Erfassen | Erfassen | Erfassen |
| Widersprüchliche Beobachtungen | Erfassen | Erfassen | Erfassen |
| Hilfsannahmen | Offenlegen | Offenlegen | Offenlegen |
| Aktueller Status | Neu bewerten | Neu bewerten | Neu bewerten |
Die Matrix verhindert einen häufigen Fehlermodus: rigorose Prüfung auf Alternativen anzuwenden, während die bevorzugte Hypothese vage bleiben darf.
Negative Evidenz erfordert besondere Sorgfalt
Das Fehlen erwarteter Evidenz kann eine Hypothese schwächen, aber nur unter bestimmten Bedingungen.
Die Aussage 'wir haben keine Evidenz für X gefunden' ist nicht gleichbedeutend mit 'X ist nicht eingetreten'.
Negative Evidenz wird informativ, wenn es eine gerechtfertigte Erwartung gibt, dass die Evidenz wahrscheinlich beobachtbar, erhalten, protokolliert, dokumentiert oder messbar wäre, wenn die Hypothese wahr wäre.
Das Fehlen von Evidenz ist am wichtigsten, wenn Evidenz nicht fehlen sollte.
Beim Debugging kann das Fehlen eines erforderlichen Log-Ereignisses aussagekräftig sein, wenn bekannt ist, dass die Protokollierung vollständig ist. In der historischen Forschung ist das Fehlen in einem fragmentarischen Archiv normalerweise viel schwächer. In der Sicherheitsanalyse hat das Fehlen einer Warnung wenig Wert, wenn die relevante Telemetrie nie erfasst wurde.
Das Modell muss daher sowohl die fehlende Evidenz als auch die Wahrscheinlichkeit bewerten, dass solche Evidenz überlebt hätte oder beobachtbar gewesen wäre.
Historische Forschung: Überlieferung versus Ähnlichkeit
Die historische Forschung veranschaulicht, warum falsifikationsorientiertes Denken bereichsspezifisch sein muss.
Angenommen, zwei Traditionen enthalten konzeptionell ähnliche Ideen und die Ausgangshypothese schlägt direkte Überlieferung vor.
Unterstützende Ähnlichkeit ist nicht genug. Die Hypothese sollte zusätzliche Erwartungen erzeugen: chronologische Kompatibilität, plausibler geografischer Kontakt, Vermittler, textliche oder terminologische Spuren, dokumentarische Belege oder ein Muster der Transformation, das mit einer Übertragung vereinbar ist.
Potenziell schädliche Beobachtungen könnten eine Chronologie umfassen, die die vorgeschlagene Richtung umkehrt, geografische Isolation, die mit dem behaupteten Mechanismus unvereinbar ist, frühere unabhängige Beispiele in beiden Traditionen oder Belege dafür, dass das angeblich gemeinsame Merkmal erst in viel späteren Neuinterpretationen auftrat.
Kein einzelnes Fehlen falsifiziert notwendigerweise eine historische Übertragung. Aber mehrere unabhängige Fehlschläge können ihren Erklärungsvorteil gegenüber Konvergenz oder indirekter Vererbung verringern.
Software-Debugging: Vom Verdacht zur Grundursache
Debugging profitiert natürlicherweise von Falsifikation, weil das Ziel nicht darin besteht, eine plausible Erzählung um eine Fehlermeldung herum zu schaffen. Es besteht darin, den Mechanismus zu isolieren, der den Fehler erzeugt.
Eine nützliche Debugging-Schleife ist:
Symptom → mögliche Ursachen → vorhergesagte Beobachtungen → diskriminierender Test → Ursachen ausschließen → reproduzieren → Grundursache
Eine Hypothese wird nicht dadurch stärker, dass mehr Prosa zu ihren Gunsten geschrieben werden kann, sondern dadurch, dass realistische Alternativen Tests nicht bestehen, die sie besteht.
Software-Architektur: Falsifizierung einer Designentscheidung
Architekturentscheidungen können normalerweise nicht im streng wissenschaftlichen Sinne falsifiziert werden, aber sie können einer falsifikationsorientierten Analyse unterzogen werden.
Angenommen, die Hypothese lautet:
Eine Microservice-Architektur ist erforderlich, um die Skalierbarkeits- und organisatorischen Anforderungen des Systems zu erfüllen.
Anstatt die Vorteile von Microservices aufzulisten, sollte die Analyse fragen, was die Behauptung unnötig machen würde.
Wenn realistische Lasttests zeigen, dass ein modularer Monolith die erwartete Skalierung erfüllt, wenn Unabhängigkeit bei der Bereitstellung nicht erforderlich ist und wenn betriebliche Komplexität zu den dominierenden Kosten wird, wurde die ursprüngliche Behauptung wesentlich geschwächt.
Das Ziel ist nicht, Microservices als Technologie zu falsifizieren. Es ist, die spezifische architektonische Behauptung unter den Einschränkungen des Projekts zu testen.
Strategie: Was würde die Geschäftsthese falsch machen?
Geschäftsstrategie leidet häufig unter Bestätigung, weil Belege im Nachhinein interpretiert werden können.
Ein stärkerer Prozess definiert Fehlerkriterien vor der Ausführung.
Wenn eine Produktthese vorhersagt, dass ein Zielsegment für eine bestimmte Fähigkeit bezahlen wird, sollte die Methodik definieren, welches beobachtbare Verhalten diese Behauptung schwächen würde: geringe Konversion nach qualifizierter Exposition, wiederholte Ablehnung aus demselben Grund, Unfähigkeit, einen Zielpreis zu halten, oder Belege dafür, dass Kunden das Problem über einen alternativen Workflow lösen.
Eine Strategie wird testbarer, wenn ihre Erfolgskriterien von expliziten Misserfolgskriterien begleitet werden.
Falsifikation ist nicht dasselbe wie Advokaten des Teufels
Ein Modell, das angewiesen wird, 'gegen diese Schlussfolgerung zu argumentieren', kann immer Einwände generieren.
Das ist noch keine Falsifikation.
Die Advokatur des Teufels optimiert auf Opposition. Falsifikationsorientiertes Denken optimiert auf informative Tests.
Ein gutes Gegenargument klingt plausibel. Ein guter Falsifikationstest hat ein Ergebnis, das ändert, was wir glauben sollten.
Diese Unterscheidung verhindert, dass der Verifikationsprozess zu einer künstlichen Debatte verkommt, in der ein Modell für eine Position argumentiert und ein anderes automatisch dagegen.
Falsifikation und Prompt-Invarianz wirken zusammen
Prompt-Invarianz und Falsifikation testen unterschiedliche Abhängigkeiten.
| Methode | Primäre Frage | Erkennt |
| Prompt-Invarianz | Überlebt die Schlussfolgerung alternative legitime Formulierungen? | Abhängigkeit von der Prompt-Formulierung |
| Falsifikation | Überlebt die Hypothese Belege, die darauf ausgelegt sind, sie herauszufordern? | Abhängigkeit von Bestätigung und schwachem Testen |
Eine Hypothese kann einen Test bestehen und den anderen nicht bestehen.
Ein Modell kann dieselbe falsche Schlussfolgerung unter mehreren Prompt-Formulierungen reproduzieren, was hohe Framing-Stabilität, aber geringe Evidenzvalidität erzeugt. Umgekehrt kann eine starke Hypothese instabil erscheinen, weil verschiedene Prompts unterschiedliche Teilmengen unvollständiger Belege offenlegen.
Die Kombination beider Methoden schafft eine stärkere Sequenz:
Framing-Variation → konkurrierende Hypothesen → erwartete Beobachtungen → Gegenbelege → diskriminierende Tests → Konfidenz-Update
Lassen Sie nicht zu, dass derselbe Agent seinen eigenen Test unkritisch beurteilt
Es gibt ein weiteres architektonisches Problem.
Wenn dasselbe Modell eine Hypothese generiert, den Test entwirft, die Belege interpretiert und entscheidet, ob die Hypothese überlebt hat, können sich seine Fehler durch jede Phase fortpflanzen.
Dies macht den Prozess nicht nutzlos, aber es motiviert die Trennung von Rollen.
Hypothesengenerator → Testdesigner → Evidenzabrufer → Kritiker → Verifizierer → finaler Synthesizer
Diese Rollen erfordern nicht unbedingt sechs verschiedene Modelle. Sie können als isolierte Inferenzdurchläufe mit separatem Kontext, kontrollierter Evidenz und strukturierten Ausgaben implementiert werden.
Die wichtige Eigenschaft ist die verfahrenstechnische Unabhängigkeit: Spätere Phasen sollten nicht einfach die rhetorische Bindung der ursprünglichen Antwort erben.
Dies wird zum technischen Thema von Designing an Epistemic Verification Layer for LLMs.
Ein allgemeiner falsifikationsorientierter KI-Workflow
Problem → Evidenznormalisierung → konkurrierende Hypothesen → Vorhersagen → potenzielle Falsifikatoren → diskriminierende Tests → Suche nach Gegenbeweisen → Überprüfung von Hilfsannahmen → Hypothesenvergleich → Neukalibrierung des Vertrauens → Schlussfolgerung
Dieser Workflow erfordert nicht, dass sich jede Aufgabe wie Laborwissenschaft verhält.
Stattdessen extrahiert er ein allgemeines epistemisches Prinzip aus der Falsifikation: Erklärungen sollten Bedingungen ausgesetzt werden, unter denen sie verlieren können.
Der genaue Validator ändert sich dann je nach Domäne.
Historische Analyse testet Chronologie, Provenienz und Überlieferung. Debugging testet beobachtbares Systemverhalten. Architektur testet Anforderungen und Einschränkungen. Strategie testet Marktannahmen und vordefinierte Fehlerkriterien.
Dieser domänenunabhängige Kern und seine domänenspezifischen Validatoren werden in From Research Protocol to General AI Reasoning Framework weiterentwickelt.
Was Falsifikation nicht leisten kann
- Sie kann unvollständige Evidenz nicht vollständig machen.
- Sie kann nicht garantieren, dass die korrekte Alternativhypothese generiert wurde.
- Sie kann Fehler, die vom Modell, den Quellen und dem Bewertungsprozess geteilt werden, nicht eliminieren.
- Sie kann inhärent interpretative Aussagen nicht in Laborexperimente umwandeln.
- Sie kann nicht jede fehlende Beobachtung als Evidenz gegen eine Hypothese behandeln.
- Sie kann nicht automatisch identifizieren, welche Hilfsannahme versagt hat, wenn eine Vorhersage widerlegt wird.
- Sie kann eine überlebende Hypothese nicht als wahr beweisen.
- Sie kann Experimente, Primärquellen, Domänenexpertise oder empirische Messungen nicht ersetzen, wo diese erforderlich sind.
Eine Hypothese, die wiederholten Falsifikationsversuchen standhält, wird besser als durch die durchgeführten Tests bestätigt beschrieben denn als bewiesen.
Das zentrale Prinzip
Generative KI macht Bestätigung billig.
Angesichts einer ausreichend plausiblen Aussage kann ein leistungsfähiges Sprachmodell normalerweise Argumente, Analogien, unterstützende Fakten und kohärente Narrative darum herum produzieren.
Genau deshalb sollte Bestätigung nicht der letzte Test sein.
Ein zuverlässiger Denkprozess sollte nicht nur fragen, warum eine Hypothese richtig sein könnte. Er muss auch definieren, wie die Hypothese falsch sein könnte.
Die Qualität einer KI-Schlussfolgerung hängt daher nicht nur davon ab, wie viele unterstützende Belege das System abrufen kann, sondern davon, ob konkurrierende Erklärungen gewinnen durften.
Das verändert die Rolle des Modells.
Es ist nicht mehr nur ein Antwortgenerator.
Es wird zu einem Teilnehmer an einem kontrollierten Prozess, in dem seine eigene erste Erklärung vorläufig, testbar und ersetzbar ist.
Die stärkste KI-Antwort ist nicht die mit den meisten unterstützenden Argumenten. Es ist die, deren stärkste Alternativen eine faire Chance hatten, sie zu besiegen.
Forschungskontext
Die Methodik in diesem Artikel übernimmt Ideen aus der Wissenschaftsphilosophie und der zeitgenössischen empirischen Forschung zum Sprachmodell-Denken. Karl Poppers Falsifikationismus betonte, dass wissenschaftliche Behauptungen sich möglichen Beobachtungen aussetzen sollten, die ihnen widersprechen, während die spätere Wissenschaftsphilosophie deutlich machte, dass praktische Falsifikation komplizierter ist als die einfache Ablehnung einer Hypothese nach einer anomalen Beobachtung.
Die Unterscheidung ist für KI-Systeme wichtig, weil echte Tests normalerweise von Hilfsannahmen, Evidenzqualität und Interpretation abhängen. Falsifikationsorientiertes KI-Denken nutzt daher die Logik der Widerlegung, ohne vorzugeben, dass jede komplexe analytische Behauptung auf ein einziges entscheidendes Experiment reduziert werden kann.
Die 2026-Studie von Jhaveri, GX-Chen, Sucholutsky und Choi liefert eine direkte empirische Motivation für dieses Design. Über elf LLMs hinweg fanden die Autoren in einer interaktiven Regelentdeckungsaufgabe eine bestätigungsverzerrte Hypothesenerkundung. Die Aufforderung an die Modelle, Gegenbeispiele zu berücksichtigen, reduzierte diese Verzerrung konsequent und erhöhte die durchschnittlichen Regelentdeckungsraten von 42 % auf 56 %.
Diese Ergebnisse belegen nicht, dass die hier vorgeschlagene vollständige Methodik als ein einheitliches Rahmenwerk experimentell validiert wurde. Sie stützen eine engere und wichtige Aussage: Explizite Interventionen hin zu widerlegenden Belegen können die Hypothesenerkundung von LLMs verbessern.
Ausgewählte Referenzen
- Popper, K. R. — The Logic of Scientific Discovery. Englische Ausgabe, 1959.
- Popper, K. R. — Conjectures and Refutations: The Growth of Scientific Knowledge. 1963.
- Stanford Encyclopedia of Philosophy — Scientific Method, Abschnitte zu hypothetisch-deduktiver Prüfung und Falsifikationismus.
- Stanford Encyclopedia of Philosophy — Karl Popper, Diskussion von Basissätzen, Falsifizierbarkeit und praktischen Komplikationen der Falsifikation.
- Jhaveri, A. R., GX-Chen, A., Sucholutsky, I. & Choi, E. — Failing to Falsify: Evaluating and Mitigating Confirmation Bias in Language Models. arXiv:2604.02485, 2026.
Setze die Serie fort
- Beyond Prompt Engineering: A Methodology for More Reliable AI Reasoning — das vollständige methodische Rahmenwerk.
- The Prompt Is Part of the Bias — warum Framing und Nutzerannahmen das KI-Denken beeinflussen können.
- Prompt Invariance: Does the Conclusion Survive the Prompt? — Testen, ob Schlussfolgerungen blinde, invertierte und adversariale Framings überstehen.
- From Research Protocol to General AI Reasoning Framework — die Umwandlung der Methodik in einen domänenunabhängigen Denkprozess.
Related Articles
Laravel 12 Custom CMS mit Filament 3: Der Experten-Workflow
Eine detaillierte Betrachtung der Synergien zwischen Laravel 12 und Filament 3 für die Erstellung maßgeschneiderter Content-Management-Systeme. Experten analysieren den innovativen Workflow, Vorteile, Nachteile und die Herausforderung des Jetstream-Workflows.
Git with automatic upload and synchronization to a production server
Install PCL Library on Python Ubuntu 19.10 - Point Cloud Library
Umfassender Leitfaden zum Evaluation Harness: LLM-Leistungsbewertung meistern
Dieser Leitfaden bietet eine detaillierte Einführung in Evaluation Harness, ein unverzichtbares Framework zur strengen Bewertung der Fähigkeiten von Large Language Models (LLMs) in Enterprise-LLMOps-Pipelines. Erfahren Sie mehr über Einrichtung, Best Practices und fortgeschrittene Techniken, um ein zuverlässiges Modell-Benchmarking und eine Optimierung zu gewährleisten.
Snap-Pakete: Warum sie für anspruchsvolle Tools wie DBeaver zu kurz greifen
Snap-Pakete führen ein restriktives Sandboxing ein, das fortgeschrittene Workflows unterbricht. Dieser Artikel erklärt, warum DBeaver mit SSH-Tunneling unter Snap zu kämpfen hat und warum Flatpak oder native Pakete bessere Alternativen sind.
Multi-Datenbank-Architektur mit Prisma 7: Ein Deep Dive für Experten
Die Verwaltung komplexer Datenlandschaften erfordert moderne Architekturen. Prisma 7 bietet erweiterte Funktionen für die Multi-Datenbank-Integration und adressiert die Herausforderungen der Polyglot Persistence.
Kanonische Architektur, URL-Design, Resolver-Logik, API- & Skalierbarkeitsspezifikation
Geobasierte Erkennungsarchitektur für Mehrmandantenportale. Definiert kanonische URLs, Resolver-Logik, Caching-Strategie und ein Geo-Read-Modell ohne CMS-Kopplung oder Datenbank-Refactoring. Konzipiert für SEO-Stabilität, Skalierbarkeit und zukünftige Erweiterungen wie Buchung und Karten.
Umfassender Leitfaden für Test DEv Enterprise Stajic.de: Architektur und Best Practices
Entdecken Sie die Architekturprinzipien, Vorteile und technischen Details der Verwaltung einer Entwicklungs- und Testumgebung der Enterprise-Klasse mit Test DEv Enterprise Stajic.de.
Prompt-Invarianz: Überlebt die Schlussfolgerung den Prompt?
Eine praktische Methodik zur Überprüfung, ob eine KI-Schlussfolgerung davon abhängt, wie ein Problem gerahmt wurde. Prompt Invariance vergleicht ursprüngliche, blinde, invertierte und adversariale Formulierungen, während die Evidenzstruktur kontrolliert bleibt.
HEIC zu JPG Konvertierung: Warum Sie es in Betracht ziehen sollten und wie es funktioniert
HEIC bietet moderne Bildkompression und hohe Qualität, aber JPG bleibt das kompatibelste Format. Dieser Leitfaden erklärt, wann und wie Sie HEIC mithilfe von Linux-Tools und Automatisierung in JPG konvertieren.
Google I/O 2026: Architektonische Neuausrichtungen, agentische KI und der Realitätscheck des einheitlichen Ökosystems
Die Google I/O 2026 war nicht nur ein Modell-Event. Sie zeigte eine tiefgreifendere Plattformverschiebung über Gemini-Modelle, Entwicklertools, mit Android verknüpfte Oberflächen und intelligente Geräte hinweg. Dieser Artikel schlüsselt die Keynote als Hub-Story für Ingenieure, Architekten und Produktteams auf, die reale Laufzeitauswirkungen vom Hype auf der Bühne trennen müssen.
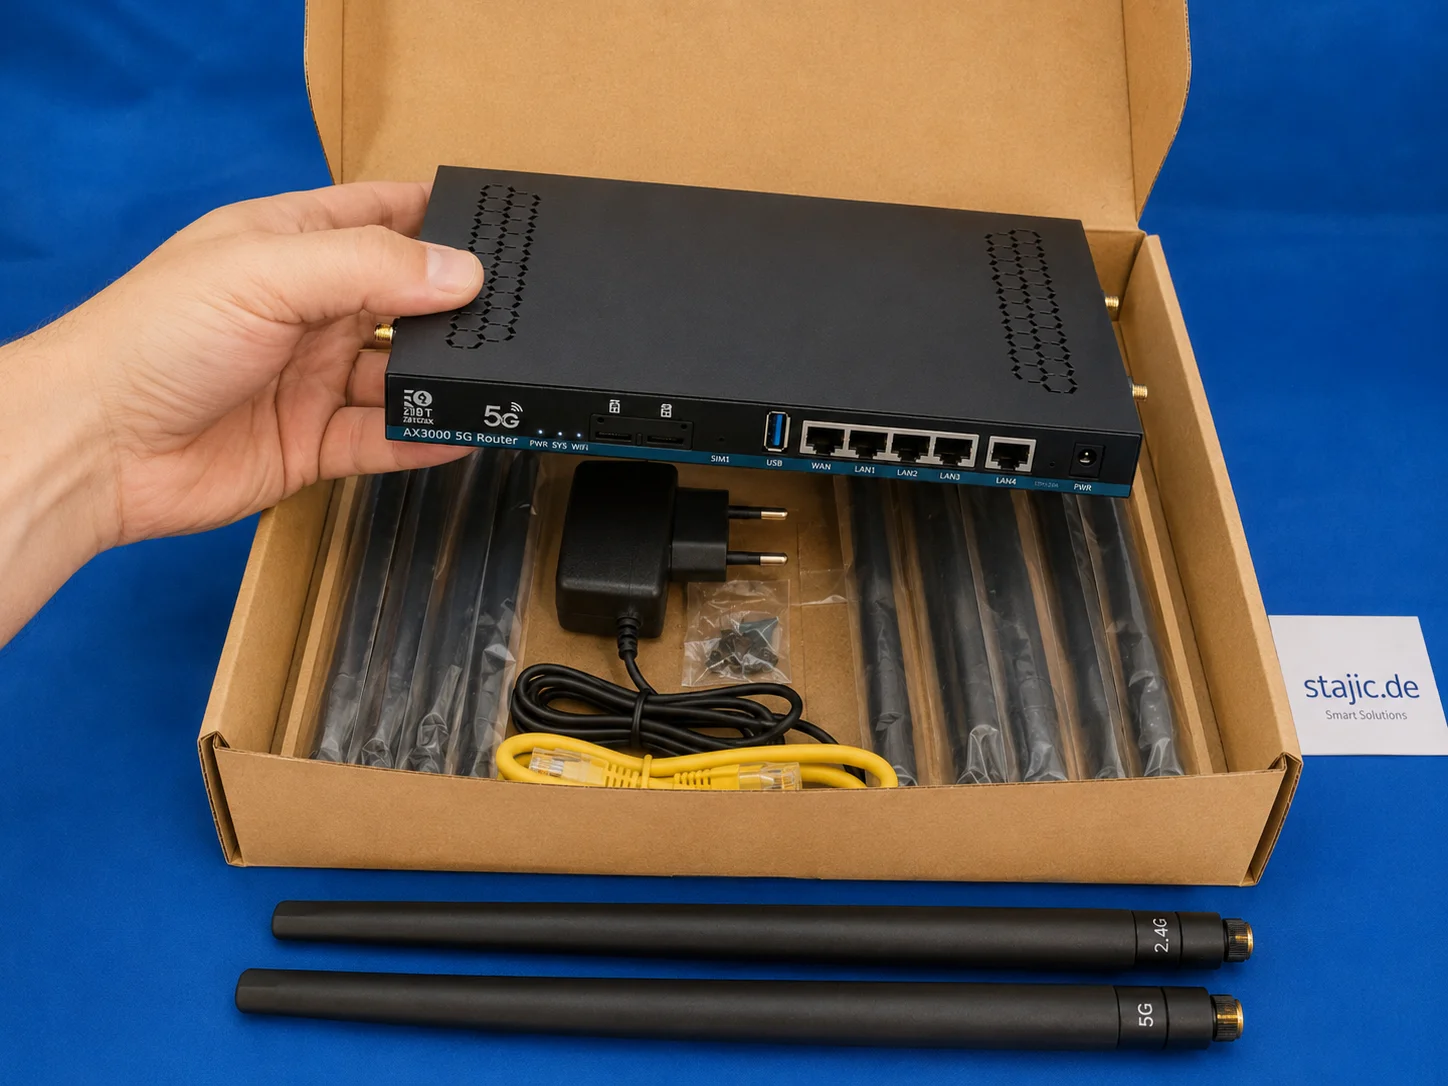
ZBT Z8102AX Hardware- und Verpackungs-Review: Starker Router, schwache Box
Der ZBT Z8102AX macht einen soliden ersten Eindruck als schlanker, schwarzer 5G-OpenWrt-Router aus Metall mit mehreren Antennenanschlüssen, Dual-SIM-Slots, USB- und LAN/WAN-Ports und einem praktischen Zubehörset. Die Hardware fühlt sich nützlich und seriös an, aber die Verpackung ist eindeutig die Schwachstelle.