
Jenseits des Prompt-Engineerings: Eine Methodik für zuverlässigeres KI-Schlussfolgern
Prompt-Engineering wird üblicherweise als die Kunst betrachtet, einem Modell bessere Fragen zu stellen. Das ist nützlich, adressiert jedoch nur einen Teil des Problems. Ein gut formulierter Prompt kann Relevanz, Struktur und Aufgabentreue verbessern, ohne die resultierende Schlussfolgerung epistemisch belastbar zu machen.
Das tieferliegende Problem besteht darin, dass ein großes Sprachmodell nicht unabhängig von dem Prompt, der es aktiviert, schlussfolgert. Formulierung, Framing, Reihenfolge, in die Anfrage eingebettete Annahmen und die vom Nutzer ausdrücklich vertretene Position können alle beeinflussen, welche Teile des internen Wissens des Modells in der generierten Antwort dominant werden.
Das bedeutet, dass die Verbesserung der KI-Schlussfolgerungsfähigkeit mehr erfordert als bessere Anweisungen. Es erfordert eine Methodik, die den Prompt selbst als potenzielle Bias-Quelle behandelt und die Schlussfolgerung des Modells einer strukturierten Verifikation unterzieht.
Das Ziel ist nicht, das Modell intelligenter zu machen. Das Ziel ist, die bereits verfügbare Intelligenz rigoroser zu nutzen.
Fähigkeit ist nicht dasselbe wie Schlussfolgerungsdisziplin
Moderne Schlussfolgerungsmodelle können komplexe Aufgaben zerlegen, Alternativen vergleichen, Belege prüfen, Widersprüche identifizieren und Schlussfolgerungen revidieren. Aber diese Fähigkeiten zu besitzen bedeutet nicht, dass jede Antwort automatisch alle davon nutzt.
Ein Allzweck-KI-Assistent muss über radikal unterschiedliche Aufgaben und Nutzer hinweg operieren. Ein Nutzer möchte eine Berechnung. Ein anderer möchte eine kurze Nachricht umgeschrieben haben. Ein weiterer erwartet Software-Debugging. Ein anderer erwartet eine historische oder wissenschaftliche Untersuchung. Ein maximales Hypothesentestprotokoll auf jede Anfrage anzuwenden, würde häufig Latenz, Ausführlichkeit und kognitiven Overhead erhöhen, ohne den tatsächlichen Nutzen der Antwort zu verbessern.
Folglich ist die zentrale Frage nicht einfach, ob ein Modell rigoroses Schlussfolgern kann. Die wichtigere Frage ist, unter welchen Bedingungen diese Fähigkeit systematisch aktiviert, herausgefordert und verifiziert wird.
Der Prompt ist keine neutrale Schnittstelle
Die Forschung hat wiederholt gezeigt, dass scheinbar sekundäre Merkmale von Prompts die Modellausgaben beeinflussen können. Prompt-Reihenfolge, Labels, Framing und Bitten um Begründung haben alle nachweislich messbare methodologische Artefakte erzeugt. Separate Forschung zur Sycophancy hat gezeigt, dass Sprachmodelle ihre Antworten manchmal an vom Nutzer geäußerte Positionen anpassen können, anstatt eine völlig unabhängige Bewertung beizubehalten.
Das bedeutet nicht, dass jedes Modell lediglich seinem Nutzer zustimmt, noch dass jeder Prompt jede Schlussfolgerung kontaminiert. Es bedeutet etwas Präziseres: Der Prompt bildet einen Teil der Inferenzumgebung. Daher kann eine unter einem Framing gewonnene Schlussfolgerung nicht automatisch als invariant unter einem anderen angenommen werden.
Die Konsequenzen dieser Unterscheidung werden separat in Der Prompt ist Teil des Bias untersucht, wo Prompt-Framing, Anweisungsbefolgung und Modellzustimmungsverhalten als methodologisches Problem statt lediglich als Prompting-Problem behandelt werden.
Vom Prompt-Engineering zu einem epistemischen Prozess
Traditionelles Prompt-Engineering optimiert in erster Linie die Eingabe. Die hier vorgeschlagene Methodik strukturiert stattdessen den vollständigen Weg von der Frage zur Schlussfolgerung.
Eine vereinfachte Form dieses Prozesses lässt sich darstellen als:
Problem → Zerlegung → Belege → konkurrierende Hypothesen → Gegenbelege → Falsifikationsversuche → Synthese → Framing-Prüfung → kalibrierte Schlussfolgerung
Der wichtige Unterschied besteht darin, dass die erste kohärente Antwort nicht mehr als Endpunkt behandelt wird. Sie wird zu einer Kandidatenschlussfolgerung, die zusätzliche Tests überstehen muss.
1. Belege von Interpretation trennen
Die erste Anforderung besteht darin, zu verhindern, dass Beobachtungen, Interpretationen und Annahmen zu einer einzigen Erzählung verschmelzen. Ein Modell sollte ausdrücklich unterscheiden, was direkt gestützt wird und was abgeleitet ist.
- Evidenz: Informationen, die direkt durch eine Quelle, Beobachtung, Messung, ein Protokoll, ein Dokument oder ein reproduzierbares Ergebnis gestützt werden.
- Interpretation: eine aus der Evidenz abgeleitete Erklärung.
- Annahme: eine Aussage, die derzeit für den Denkprozess erforderlich ist, aber noch nicht unabhängig belegt wurde.
- Offene Frage: eine relevante Unsicherheit, für die die verfügbare Evidenz nicht ausreicht.
Diese Trennung ist einfach, hat aber eine wichtige Konsequenz: Unsicherheit wird sichtbar, bevor sie in die endgültige Erzählung aufgenommen wird.
2. Konkurrierende Hypothesen generieren
Eine starke Erklärung ist nicht schon dadurch belegt, dass Evidenz zu ihren Gunsten interpretiert werden kann. Das Modell sollte glaubwürdige Alternativen konstruieren und fragen, ob dieselbe Evidenz auch durch sie erklärt werden kann.
In der historischen Forschung könnte dies bedeuten, direkte Überlieferung, indirekte Überlieferung, unabhängige Konvergenz und retrospektive Interpretation zu unterscheiden. Beim Software-Debugging kann es bedeuten, einen Netzwerkausfall, einen Konfigurationsfehler, einen Anwendungsfehler und einen Ausfall eines externen Dienstes zu trennen. In der Geschäftsanalyse kann es bedeuten, mehrere kausale Erklärungen für dasselbe Marktsignal zu vergleichen.
Die Bezeichnungen ändern sich je nach Disziplin. Das methodologische Prinzip nicht.
3. Nach Evidenz suchen, die die bevorzugte Erklärung scheitern lassen könnte
Bestätigung ist vergleichsweise einfach. Angesichts einer plausiblen Hypothese können sowohl Menschen als auch Sprachmodelle oft Fakten finden, die mit ihr vereinbar erscheinen. Ein anspruchsvollerer Test fragt, welche Evidenz existieren sollte, wenn die Hypothese wahr wäre, welche Evidenz nicht existieren sollte und welche Beobachtung sie erheblich schwächen würde.
Neuere experimentelle Arbeiten zum Bestätigungsfehler in Sprachmodellen stützen die Bedeutung dieses Schritts. Wenn Modelle Hypothesen frei testen dürfen, können sie bestätigende Tests gegenüber falsifizierenden bevorzugen. Es hat sich gezeigt, dass ausdrückliche Interventionen, die Gegenbeispiele und widerlegende Tests fördern, die Hypothesenentdeckung verbessern.
Die vollständige Rolle von Falsifikation und Gegenbeweisen in dieser Methodologie wird in Falsifikation für KI-Schlussfolgern: Von Antworten zu getesteten Hypothesen entwickelt.
4. Provenienz und kausale Distanz bewahren
Nicht alle stützenden Informationen haben denselben Beweiswert. Ein Primärdokument, eine sekundäre Interpretation, ein späteres Zitat, eine quellenlose Zusammenfassung und eine modellgenerierte Paraphrase können nicht als austauschbar behandelt werden, nur weil sie ähnliche Behauptungen enthalten.
Ein rigoroser Prozess bewahrt daher den Weg zwischen Quelle und Schlussfolgerung. Wo möglich, sollte die Argumentationskette nachprüfbar bleiben:
Schlussfolgerung → Interpretation → stützende Evidenz → Quelle
Anschließend können domänenspezifische Validatoren hinzugefügt werden. Historische Forschung erfordert Chronologie, geografische Plausibilität, Provenienz und mögliche Überlieferungskanäle. Softwarearchitektur erfordert Einschränkungen, Kompatibilität, Leistung, Wartbarkeit und Fehlermodi. Wissenschaftliche Analyse erfordert Versuchsplanung, Messqualität, Reproduzierbarkeit und alternative kausale Erklärungen.
5. Testen, ob die Schlussfolgerung den Prompt übersteht
Die wichtigste Erweiterung besteht darin, den Prompt selbst als Variable zu behandeln.
Ich verwende hier den Begriff Prompt-Invarianz für einen praktischen Test: Bleibt die wesentliche Schlussfolgerung stabil, wenn dieselben Belege unter materiell unterschiedlichen, aber legitimen Prompt-Formulierungen untersucht werden?
Eine nützliche Umsetzung kann mindestens vier Durchgänge enthalten:
- Originaldurchgang: das Problem so analysieren, wie es ursprünglich formuliert wurde.
- Blinder Durchgang: die vom Nutzer bevorzugte Erklärung entfernen und fragen, welche Hypothese durch die Belege gestützt wird.
- Invertierter Durchgang: eine glaubwürdige Gegenhypothese als Ausgangsbehauptung behandeln und sie an denselben Belegen prüfen.
- Adversarialer Durchgang: bewusst die stärkste evidenzbasierte Herausforderung der aktuellen Schlussfolgerung konstruieren.
Das Ziel ist nicht, vier identische Antworten zu erzwingen. Legitime Unterschiede in der Formulierung können zuvor verborgene Annahmen offenlegen. Das relevante Signal ist, welche faktischen Feststellungen, kausalen Zusammenhänge und Vertrauensurteile über die verschiedenen Formulierungen hinweg bestehen bleiben.
Prompt-Invarianz sollte daher nicht mit faktischem Beweis verwechselt werden. Sie ist besser als Robustheitstest gegen eine bestimmte Klasse methodischer Abhängigkeit zu verstehen: übermäßige Abhängigkeit von der ursprünglichen Formulierung.
Das Konzept und seine Grenzen werden ausführlich entwickelt in Prompt-Invarianz: Überlebt die Schlussfolgerung den Prompt?.
6. Die Schlussfolgerung kalibrieren, statt Gewissheit zu erzwingen
Eine Methodik, die darauf ausgelegt ist, Bestätigungsfehler zu widerstehen, muss zulassen, dass der Endzustand unsicher bleibt. Der Prozess ist gescheitert, wenn jede Untersuchung mit einem überzeugten Ja oder Nein enden muss.
Mögliche Ergebnisse sind starke Unterstützung, mäßige Unterstützung, schwache Unterstützung, ungelöste Konkurrenz zwischen Hypothesen, unzureichende Belege oder Belege, die der ursprünglichen Behauptung widersprechen. Die wichtige Anforderung ist, dass die Zuversicht der Qualität und Struktur der Belege folgt und nicht der rhetorischen Kohärenz der generierten Antwort.
Ein domänenunabhängiger Kern mit domänenspezifischen Validatoren
Die Methodik wird ursprünglich besonders in Forschungsaufgaben sichtbar, weil Forschung naturgemäß Probleme von Belegen, Interpretation und konkurrierenden Erklärungen offenlegt. Ihr Kern ist jedoch nicht auf historische oder akademische Arbeit beschränkt.
Dieselbe allgemeine Struktur kann auf Debugging, Softwarearchitektur, Produktstrategie, technische Due Diligence, Projektmanagement, Sicherheitsanalyse und andere Bereiche angewendet werden, in denen eine plausible erste Antwort erheblich schwächer sein kann als eine geprüfte Schlussfolgerung.
Was sich ändert, ist die Validierungsschicht. Der epistemische Kern bleibt weitgehend stabil, während jede Domäne ihre eigenen Regeln dafür liefert, was als starker Beleg, plausibler kausaler Mechanismus oder aussagekräftiger Falsifikationstest gilt.
Dieser Übergang von einem Forschungsprotokoll zu einem wiederverwendbaren Denkrahmen ist Gegenstand von Vom Forschungsprotokoll zum allgemeinen KI-Denkrahmen.
Warum ein Schlussfolgerungsmodell die vollständige Methode nicht automatisch anwendet
Es wäre verlockend zu schlussfolgern, dass ausreichend fortgeschrittene Schlussfolgerungsmodelle diese Methodik überflüssig machen sollten. Diese Schlussfolgerung verwechselt Fähigkeit mit Standardverhalten.
Ein allgemeiner Assistent hat keinen universellen Grund, bei jeder Anfrage die epistemische Verifikation zu maximieren. Nutzer unterscheiden sich in Fachkenntnis, Zielen, verfügbarer Zeit, gewünschter Tiefe und Toleranz gegenüber Komplexität. Auch Aufgaben unterscheiden sich radikal in den Kosten eines Fehlers.
Bei vielen Anfragen ist eine direkte Antwort das korrekte Produktverhalten. Bei anderen, insbesondere Forschung, Architektur, Entscheidungen mit hoher Wirkung und komplexer technischer Diagnose, kann zusätzliche Verifikation die Zuverlässigkeit erheblich verbessern.
Die Methodik fungiert daher als eine bewusste Änderung des Argumentationsziels. Statt in erster Linie auf eine nützliche und kohärente Antwort zu optimieren, verleiht sie der epistemischen Robustheit, der Nachvollziehbarkeit und der Widerstandsfähigkeit gegenüber der ursprünglichen Rahmung des Nutzers zusätzliches Gewicht.
Von der Methodik zu einer epistemischen Verifikationsschicht
Sobald sie als wiederholbarer Prozess ausgedrückt wird, muss die Methodik nicht mehr nur als lange Anweisung existieren, die einem Sprachmodell vorangestellt wird. Sie kann Teil einer KI-Architektur werden.
Verschiedene Agenten oder Inferenzdurchläufe können Hypothesen generieren, nach widersprüchlichen Belegen suchen, Quellen bewerten, eine adversariale Überprüfung durchführen und Ergebnisse über Prompt-Varianten hinweg vergleichen. Die endgültige Antwort kann dann aus dem verifizierten Zwischenzustand erzeugt werden, anstatt direkt aus der ursprünglichen Nutzeranfrage.
Prompt → Zerlegung → Kandidatenerklärungen → Belege → Infragestellung → Verifikation → Synthese → Antwort
Diese Architektur und ihre Beziehung zu Agenten, Retrieval-Systemen und Mehrfachdurchlauf-Inferenz werden in Designing an Epistemic Verification Layer for LLMs entwickelt.
Was diese Methodik nicht beansprucht
Eine rigorose Methodik sollte auch ihre eigenen Grenzen definieren.
- Sie garantiert nicht, dass das Modell über das notwendige Wissen verfügt.
- Sie macht schwache oder fehlende Belege nicht stärker.
- Sie beseitigt keine Halluzinationen, Rahmungseffekte oder Modellverzerrungen.
- Sie beweist nicht, dass eine Schlussfolgerung wahr ist, nur weil mehrere Prompt-Varianten sie hervorgebracht haben.
- Sie ersetzt keine Fachexpertise, Primärquellen, Experimente oder externe Verifikation, wo diese erforderlich sind.
- Sie erhöht den Rechenaufwand, den Token-Verbrauch und die Latenz.
- Ihr Zweck ist es, Fehler, Annahmen und Abhängigkeiten leichter offenzulegen, bevor sie zu Schlussfolgerungen werden.
Das zentrale Prinzip
Prompt-Engineering fragt, wie man eine bessere Antwort von einem Modell erhält.
Die hier beschriebene Methodik stellt eine andere Frage:
Welchen Prozess sollte eine KI-Schlussfolgerung durchlaufen, bevor wir entscheiden, dass die Antwort gut genug ist, um ihr zu vertrauen?
Dieser Perspektivwechsel ist grundlegend. Er verlagert den Fokus weg von der Optimierung eines einzelnen Prompts hin zur Steuerung des Argumentationsprozesses um ihn herum.
Der Prompt bleibt wichtig, aber er wird nicht mehr als unangefochtener Ausgangspunkt behandelt. Er wird zu einer Eingabe in einen Prozess, der seine Annahmen prüfen, seine Rahmung infrage stellen und testen kann, ob die resultierende Schlussfolgerung alternativen Interpretationen standhält.
In praktischer Hinsicht versucht die Methodik nicht, ein klügeres Modell zu schaffen. Sie versucht, eine diszipliniertere Nutzung der vorhandenen Fähigkeiten des Modells zu erreichen.
Forschungskontext
Der methodische Vorschlag in diesem Artikel wird von mehreren verwandten Bereichen der aktuellen LLM-Forschung beeinflusst. Sharma et al. untersuchten sykophantisches Verhalten bei KI-Assistenten und die Beziehung zwischen menschlichen Präferenzsignalen und der Übereinstimmung mit Nutzerüberzeugungen. Brucks und Toubia zeigten, dass die Prompt-Architektur – einschließlich Reihenfolge, Bezeichnungen, Framing und Begründung – systematische methodische Artefakte in Modellantworten erzeugen kann. Jhaveri et al. untersuchten experimentell den Bestätigungsfehler während der Hypothesenexploration und stellten fest, dass Interventionen, die Gegenbeispiele förderten, bestätigendes Verhalten reduzierten und die Regelentdeckung verbesserten.
Diese Studien belegen nicht die hier vorgeschlagene vollständige Methodik, noch stellen sie einen Beleg dafür dar, dass Prompt-Invarianz eine standardisierte Validierungsmetrik ist. Sie liefern engere empirische Befunde, die die Notwendigkeit einer expliziteren Kontrolle über Framing, Hypothesentestung und Verifikation begründen.
Ausgewählte Referenzen
- Sharma, M. et al. — Towards Understanding Sycophancy in Language Models. arXiv:2310.13548, ursprünglich veröffentlicht 2023; überarbeitet 2025.
- Brucks, M. S. & Toubia, O. — Prompt architecture induces methodological artifacts in large language models. PLOS ONE, 2025.
- Jhaveri, A. R., GX-Chen, A., Sucholutsky, I. & Choi, E. — Failing to Falsify: Evaluating and Mitigating Confirmation Bias in Language Models. arXiv, 2026.
Setze die Serie fort
- Der Prompt ist Teil der Verzerrung — wie Framing, Anweisungen und Nutzerannahmen die Schlussfolgerungen des Modells beeinflussen.
- Prompt-Invarianz: Überlebt die Schlussfolgerung den Prompt? — ein praktischer Robustheitstest mit blinden, invertierten und adversariellen Formulierungen.
- Falsifikation für KI-Schlussfolgerungen: Von Antworten zu getesteten Hypothesen — Gegenbeweise, konkurrierende Hypothesen und widerlegende Tests.
- Vom Forschungsprotokoll zum allgemeinen KI-Schlussfolgerungsframework — Anwendung der Methodik über die historische Forschung hinaus.
- Gaming-KI: Angewandtes Schlussfolgern unter unsicheren Informationen — eine angewandte Perspektive von figure.rocks.
Related Articles
Google I/O 2026: Antigravity, AI Studio und der Wandel zu agentischen DevTools
Google I/O 2026 machte eines für Ingenieure klar: KI-Tooling bewegt sich über die Autovervollständigung hinaus hin zu verwalteter agentischer Ausführung. Dieser Artikel schlüsselt Antigravity 2.0, die wachsende Rolle von Google AI Studio, Gemini 3.5 Flash und die realen Kompromisse rund um Orchestrierung, Lock-in, Verifizierung und das Design von Entwickler-Workflows auf.
Wie man erkennt, ob ein KI-Agent tatsächlich die richtigen Belege verwendet hat
Ein KI-Agent kann Quellen zitieren und trotzdem die falschen Belege verwenden. Dieser Artikel stellt eine praktische Methode zur Überprüfung der Belegung von Behauptungen, der Quellenautorität, der Anwendbarkeit, der Herkunft sowie der Frage vor, ob die Belege die Antwort tatsächlich beeinflusst haben.
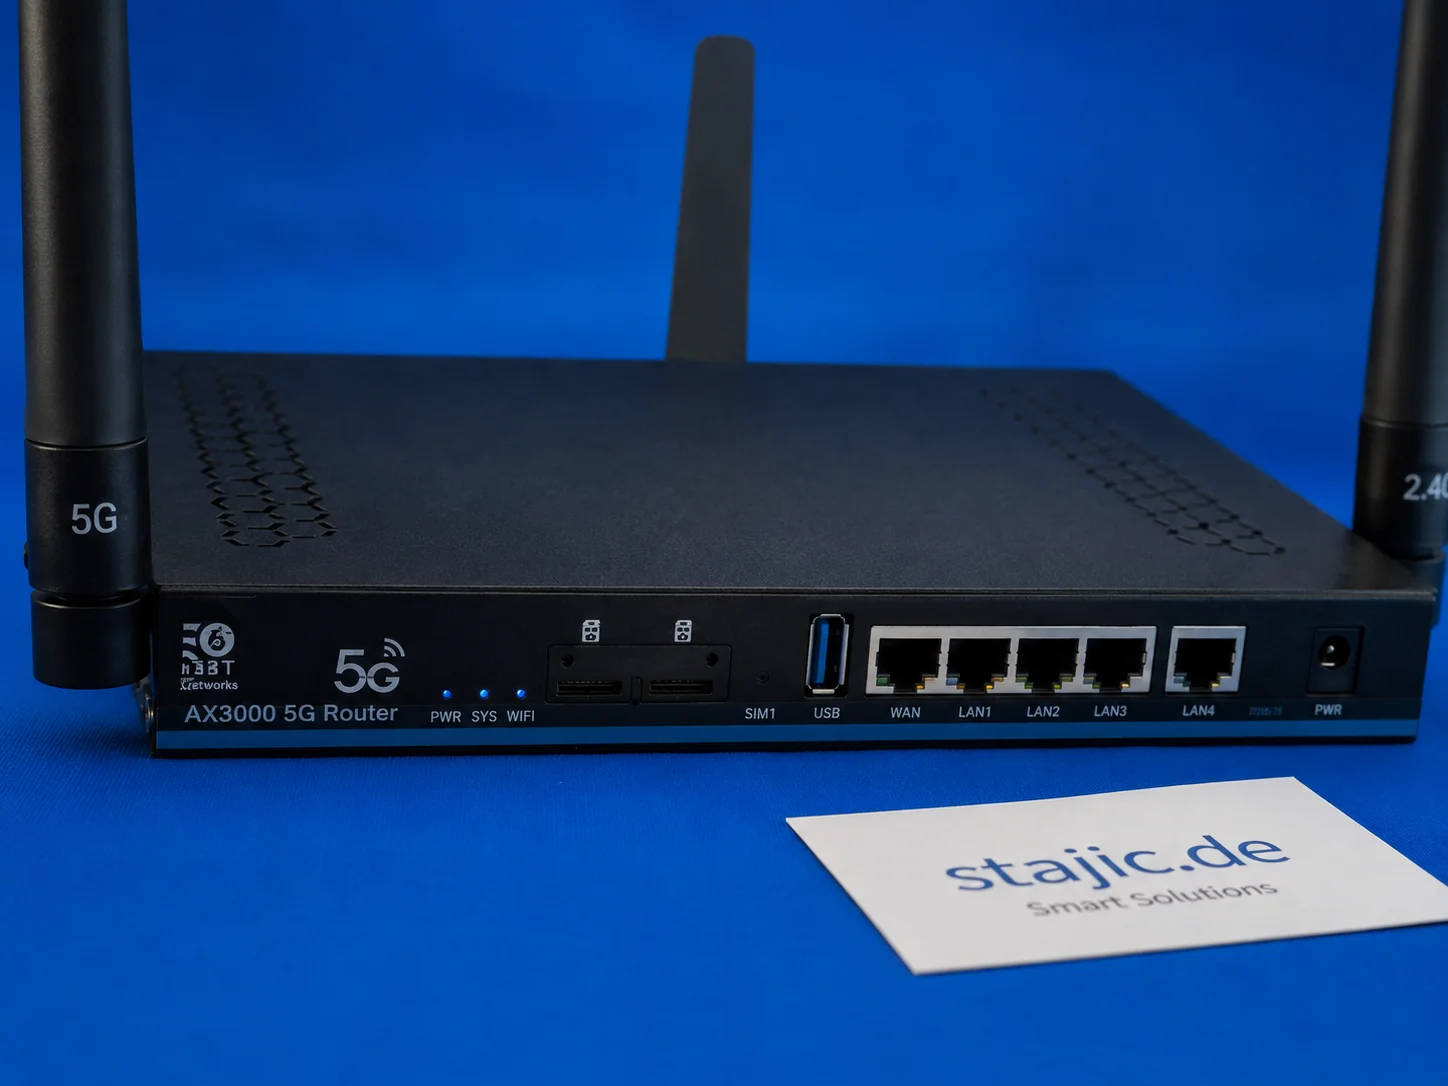
Quectel RM500U-EA im ZBT Z8102AX: 5G-Bänder, o2 Germany und Signalverhalten in der Praxis
Der ZBT Z8102AX verwendet ein Quectel RM500U-EA-Modem für die 4G- und 5G-Konnektivität. Im ersten Praxistest verband sich der Router erfolgreich mit o2 Germany mit LTE-Band 3 und NR n28. Das Modem funktioniert, aber tiefergehende Diagnosen wie RSRP, RSRQ, SINR, Band-Locking und Zellverhalten müssen noch richtig getestet werden.
Portal-Entwicklung: Eine skalierbare Plattform für Leistung, Mehrsprachigkeitsunterstützung und Erweiterbarkeit
Ein modernes Webportal wird entwickelt, das auf Skalierbarkeit, Leistung, Mehrsprach
Wann sollte eine KI aufhören, ihrem eigenen Wissen zu vertrauen? — Der Retrieval-Trigger
Ein KI-Modell benötigt nicht für jede Frage einen Retrieval. Das wichtige Problem ist zu erkennen, wann sein internes Wissen nicht mehr ausreicht. Der Retrieval-Trigger ist eine praktische Entscheidungsgrenze, die bestimmt, wann ein KI-System aufhören sollte, sich allein auf das Modellwissen zu verlassen, und vor der Beantwortung externe Evidenz einholen sollte.
Umfassender Metrik-Leitfaden für Delivery und Change Management
Dieser Leitfaden bietet einen detaillierten Überblick über wesentliche Kennzahlen für Enterprise Delivery und Change Management und unterstützt Teams dabei, die Leistung zu messen, Prozesse zu optimieren und kontinuierliche Verbesserung voranzutreiben. Entdecken Sie Schlüsselindikatoren, Berechnungsmethoden und Best Practices, um Ihre Kennzahlen an Geschäftsergebnisse anzupassen.
Google I/O 2026: Architektonische Neuausrichtungen, agentische KI und der Realitätscheck des einheitlichen Ökosystems
Die Google I/O 2026 war nicht nur ein Modell-Event. Sie zeigte eine tiefgreifendere Plattformverschiebung über Gemini-Modelle, Entwicklertools, mit Android verknüpfte Oberflächen und intelligente Geräte hinweg. Dieser Artikel schlüsselt die Keynote als Hub-Story für Ingenieure, Architekten und Produktteams auf, die reale Laufzeitauswirkungen vom Hype auf der Bühne trennen müssen.
Der nächste OpenWrt-5G-Router: Warum Wi-Fi 7, eine stärkere CPU und bessere Firmware wichtig sind
Der ZBT Z8102AX ist ein nützliches erstes Sample, aber der nächste Schritt sollte stärker sein: Wi-Fi 7, eine leistungsstärkere Vier-Kern-Plattform, mehr Klarheit bei der Firmware, eine verbesserte Verpackung und eine stabilere Preispolitik. Das Ziel ist nicht nur ein weiterer 5G-Router, sondern ein besser konfiguriertes, OpenWrt-basiertes Prosumer-Gerät.
KI-Agenten-Gedächtnis ist kein RAG: Wie man Gedächtnis, Retrieval, Zustand und Kontext voneinander trennt
Agentengedächtnis, RAG, Zustand und Kontext werden oft so verwendet, als wären sie austauschbar. Das sind sie nicht. Dieses praktische Architekturmodell trennt die vier Schichten, zeigt, wohin jede gehört, und erklärt, was kaputtgeht, wenn Systeme sie zu einer einzigen zusammenfassen.
ZBT Z8102AX 5G OpenWrt Router Test: Dual-SIM, RM500U-EA und eine ehrliche Einschätzung
Der ZBT Z8102AX ist ein ungewöhnlicher 5G-Router mit einer OpenWrt-Basis, einem Dual-SIM-Konzept und einem Quectel RM500U-EA-Modem. Im Test zeigt er klare Stärken bei Flexibilität, Schnittstellen und mobiler Konnektivität, aber auch die typischen Schwächen eines vom Hersteller modifizierten OpenWrt-Builds.
Der Prompt ist Teil des Bias: Wie KI-Framing das Schlussfolgern prägt
Die Formulierung von Prompts ist nicht neutral. Erfahren Sie, wie Framing, Annahmen, Instruktionsbefolgung und Sykophantie das logische Denken von KI prägen können—und warum verlässliche Schlussfolgerungen Tests erfordern, die über den ursprünglichen Prompt hinausgehen.
Migration vom OpenAI Agents SDK zur Agents API: Was ändert sich tatsächlich architektonisch?
Die Migration vom OpenAI Agents SDK zur neuen Agents API ist keine reine Umbenennung von Imports. Die Laufzeitgrenze verschiebt sich: Die Agent-Schleife, die dauerhafte Sitzung, die Orchestrierung, die Kontextkomprimierung und die Wiederherstellung bewegen sich in Richtung einer verwalteten Harness. Dieser Leitfaden zeigt, was verschoben werden sollte, was in Ihrer Anwendung bleiben sollte und wie Sie die Migration vor dem Cutover nachweisen können.