
Prompt-Invarianz: Überlebt die Schlussfolgerung den Prompt?
Wenn der Prompt selbst die Argumentation eines KI-Modells beeinflussen kann, dann lässt die Bewertung einer Schlussfolgerung, die aus nur einem Prompt hervorgegangen ist, eine wichtige Variable unkontrolliert.
Eine naheliegende Reaktion ist, den Prompt umzuschreiben und es erneut zu versuchen. Doch einfache Wiederholung reicht nicht aus. Eine andere Formulierung kann eine andere Sprache erzeugen, während dieselbe Argumentation erhalten bleibt, und identische Schlussfolgerungen können über verschiedene Prompts hinweg aus den falschen Gründen bestehen bleiben.
Was benötigt wird, ist ein strukturierter Test, ob die wesentliche Schlussfolgerung übermäßig von der Rahmung abhängt, die sie hervorgebracht hat.
Ich verwende den Begriff Prompt-Invarianz für einen praktischen Robustheitstest: Bleibt die wesentliche Schlussfolgerung verteidigbar, wenn dasselbe Problem und dieselben Belege unter materiell unterschiedlichen legitimen Rahmungen untersucht werden?
Prompt-Invarianz wird hier nicht als etablierte akademische Metrik, als mathematische Invariante oder als Beweis für die Wahrheit einer Antwort vorgeschlagen. Es ist eine operative Methodik zur Erkennung einer bestimmten Schwäche in KI-gestützter Argumentation: Schlussfolgerungen, die zu stark davon abhängen, wie der ursprüngliche Nutzer das Problem gerahmt hat.
Sie erweitert den Rahmen, der in Beyond Prompt Engineering: A Methodology for More Reliable AI Reasoning eingeführt wurde, und befasst sich direkt mit dem Prompt-Abhängigkeitsproblem, das in The Prompt Is Part of the Bias untersucht wird.
Das Problem: Ein Prompt erzeugt ein konditionales Ergebnis
Eine KI-Antwort wird nicht allein aus der Frage generiert. Sie wird aus einem vollständigen Inferenzkontext generiert: der Formulierung der Frage, dem vorangehenden Gespräch, den bereitgestellten Belegen, den Systemanweisungen, Beispielen, der Reihenfolge, den Bezeichnungen, der angeforderten Perspektive und der Modellkonfiguration.
Die Antwort sollte daher als konditional auf diese Umgebung verstanden werden.
Antwort = Modell(Problem | Rahmung, Kontext, Belege, Anweisungen)
Für gewöhnliche Aufgaben mag diese Unterscheidung irrelevant sein. Wenn die Aufgabe darin besteht, einen Absatz zusammenzufassen oder eine Einheit umzurechnen, gibt es in der Regel wenig Wert darin, mehrere unabhängige Argumentationsumgebungen zu konstruieren.
Für Forschung, komplexe technische Diagnosen, Architekturentscheidungen, strategische Analysen und andere Aufgaben, bei denen die Argumentation selbst von Bedeutung ist, ändert sich die Situation. Eine Schlussfolgerung sollte idealerweise durch die Belege gestützt werden und nicht durch eine zufällige Eigenschaft des Prompts, der die Belege eingeführt hat.
Prompt-Invarianz ist nicht textuelle Konsistenz
Die erste Unterscheidung ist wesentlich: Prompt-Invarianz verlangt nicht, dass das Modell denselben Text erzeugt.
Zwei Antworten können völlig unterschiedliche Formulierungen verwenden und dennoch dieselbe evidenzbasierte Schlussfolgerung erreichen. Umgekehrt können zwei Antworten nahezu identische Schlussfolgerungen enthalten, während sie auf unterschiedlichen Annahmen oder unvereinbaren Belegen beruhen.
Das relevante Objekt ist daher nicht die lexikalische Ähnlichkeit. Es ist die Stabilität der Argumentationsstruktur.
- Faktenstabilität: Welche zentralen faktischen Feststellungen überleben über verschiedene Formulierungen hinweg?
- Evidenzstabilität: Welche Quellen oder Beobachtungen bleiben entscheidend?
- Hypothesenstabilität: Welche konkurrierenden Erklärungen bleiben plausibel oder werden verworfen?
- Schlussfolgerungsstabilität: Bleibt dieselbe allgemeine Schlussfolgerung am besten gestützt?
- Konfidenzstabilität: Ändert sich die geschätzte Stärke der Schlussfolgerung wesentlich?
- Kausalstabilität: Bleiben dieselben kausalen oder Übertragungszusammenhänge bestehen, wenn sich die Rahmung ändert?
Diese Unterscheidung vermeidet auch einen methodischen Fehler, der in der jüngeren Forschung zur Prompt-Sensitivität identifiziert wurde. Einige scheinbare Sensitivität kann durch starre Bewertungsmethoden übertrieben werden, die semantisch äquivalente Antworten allein deshalb als unterschiedlich einstufen, weil sie unterschiedliche Ausdrucksformen verwenden.
Die Vergleichseinheit sollte daher die Bedeutung und die argumentative Struktur der Antwort sein, nicht die exakte Übereinstimmung auf Zeichenkettenebene.
Ein Vier-Stufen-Test zur Prompt-Invarianz
Die grundlegende Methode nutzt vier bewusst unterschiedliche Argumentationsdurchläufe zur selben zugrundeliegenden Forschungsfrage.
Durchlauf 1 — Original
Der erste Durchlauf behält die ursprüngliche Formulierung des Nutzers bei, einschließlich dessen Hypothese, sofern eine solche explizit genannt wurde.
Sein Zweck besteht nicht nur darin, eine erste Antwort zu generieren. Er dient auch als Referenzbasis, mit der spätere Durchläufe verglichen werden können.
Beispiel: Welche Belege stützen die Hypothese, dass Tradition A die Tradition B beeinflusst hat?— Ursprüngliches Framing
Diese Formulierung ist legitim, wenn die Forschungsaufgabe explizit darin besteht, diese Hypothese zu untersuchen. Sie lenkt die Aufmerksamkeit jedoch bereits auf eine bestimmte Beziehung.
Durchlauf 2 — Blind
Der Blinddurchlauf entfernt die vom Nutzer erwartete Schlussfolgerung aus der Aufgabenstellung.
Beispiel: Welche Beziehung – sofern vorhanden – zwischen Tradition A und Tradition B wird auf Basis der verfügbaren Belege am besten gestützt?— Blindes Framing
Die Belege haben sich nicht geändert. Was sich ändert, ist die anfängliche Verteilung der Aufmerksamkeit.
Direkter Einfluss, indirekter Einfluss, unabhängige Konvergenz, spätere Reinterpretation und das Fehlen einer nachweisbaren Beziehung können nun in die Analyse einfließen, ohne dass eine dieser Möglichkeiten durch den Nutzer einen privilegierten Status erhält.
Durchlauf 3 — Invertiert
Der invertierte Durchlauf weist einer starken Alternativerklärung bewusst die Position zu, die zuvor von der bevorzugten Hypothese des Nutzers eingenommen wurde.
Beispiel: Prüfen Sie die Hypothese, dass sich die Ähnlichkeiten zwischen Tradition A und Tradition B unabhängig voneinander entwickelt haben und nicht durch direkte Übertragung.— Invertiertes Framing
Das Ziel besteht nicht darin, das Modell dazu zu bringen, sich selbst zu widersprechen. Ebenso wenig wird davon ausgegangen, dass die Alternative zutrifft.
Der Zweck ist Symmetrie: Wenn die Positionierung einer Hypothese als Ausgangsthese ihr einen künstlichen Vorteil verschafft, kann es diese Abhängigkeit offenlegen, wenn man der stärksten Alternative denselben Vorteil einräumt.
Durchlauf 4 — Adversarisch
Der adversarische Durchlauf beginnt, nachdem sich bereits eine vorläufige Schlussfolgerung herausgebildet hat.
Konstruieren Sie die stärkste evidenzbasierte Anfechtung der vorläufigen Schlussfolgerung. Identifizieren Sie unbegründete Annahmen, widersprüchliche Evidenz, alternative Kausalerklärungen und Beobachtungen, die von der aktuellen Erklärung nur unzureichend erfasst werden.— Adversarisches Framing
Dies ist kein generischer Contrarianismus. Der adversarische Durchlauf muss evidenzbasiert bleiben.
Ein Einwand erhält Gewicht, weil er eine Schwachstelle in der Beweisführung aufdeckt, nicht bloß weil er von der aktuellen Antwort abweicht.
Die Evidenz muss kontrolliert werden
Es gibt eine methodische Komplikation, die kritisch wird, wenn das Modell Zugriff auf Websuche, RAG, Datenbanken oder andere Retrieval-Systeme hat.
Wenn jeder Prompt eine andere Auswahl an Quellen abruft, kann eine veränderte Schlussfolgerung mindestens zwei Erklärungen haben:
- die Argumentation hat sich geändert, weil sich das Framing des Prompts geändert hat;
- die Argumentation hat sich geändert, weil sich die dem Modell zur Verfügung stehenden Informationen geändert haben.
Diese Effekte sollten nicht miteinander verwechselt werden.
Für kontrollierte Prompt-Invarianz-Tests friert das stärkste Versuchsdesign daher den Evidenzkorpus ein, bevor die Framing-Varianten ausgeführt werden.
Gleiche Frage + gleiche Evidenz + unterschiedliches legitimes Framing— Kontrollierte Prompt-Invarianz
Dies isoliert die Empfindlichkeit der Argumentation effektiver.
Ein zweites Experiment kann das Retrieval bewusst aktiviert lassen. Das misst etwas anderes: die Robustheit der gesamten KI-Recherche-Pipeline.
- Korpusfixierte Invarianz: testet die Argumentationsebene, während die Evidenz konstant gehalten wird.
- Retrieval-inklusive Invarianz: testet, ob Framing sowohl das verändert, was das System abruft, als auch das, was es schlussfolgert.
Beides ist nützlich. Sie beantworten unterschiedliche Fragen.
Was sollte verglichen werden?
Vier lange, natürlichsprachige Antworten manuell zu vergleichen, ist ineffizient und unzuverlässig. Die Ausgaben sollten daher in eine gemeinsame analytische Struktur normalisiert werden.
Jeder Durchgang kann dieselben Felder zurückgeben:
- Gesicherte Fakten
- Relevante Quellen oder Beobachtungen
- Annahmen
- Hypothesenkandidaten
- Belege, die jede Hypothese stützen
- Belege, die jeder Hypothese widersprechen
- Offene Fragen
- Vorläufige Schlussfolgerung
- Konfidenz und Gründe für diese Konfidenz
In der Vergleichsphase wird dann eher die Struktur als die Prosa bewertet.
Wenn alle vier Durchgänge eine unterschiedliche Sprache verwenden, aber dieselben Kernbelege beibehalten, dieselben Alternativen ausschließen und zu derselben qualifizierten Schlussfolgerung konvergieren, zeigt das Ergebnis eine wesentlich höhere Framing-Robustheit als eine Schlussfolgerung, die aus einem einzigen Prompt allein gewonnen wurde.
Wenn sich die bevorzugte Erklärung jedes Mal ändert, wenn sich das Framing ändert, sollte die Schlussfolgerung abgeschwächt werden, bis die Ursache dieser Instabilität verstanden ist.
Vier verschiedene Formen der Stabilität
Prompt-Invarianz wird nützlicher, wenn Stabilität nicht auf ein einfaches Ja-oder-Nein-Ergebnis reduziert wird.
Evidenz-Invarianz
Bleiben dieselben Belege wichtig, unabhängig davon, welche Hypothese der Prompt in den Vordergrund stellt?
Wenn eine Quelle nur dann als entscheidend angesehen wird, wenn der Prompt eine Erklärung bevorzugt, erfordert ihre Rolle eine genauere Prüfung.
Hypothesen-Invarianz
Tauchen über alle Durchgänge hinweg dieselben plausiblen Alternativen auf?
Eine Hypothese, die nur dann auftaucht, wenn sie vom Benutzer explizit vorgegeben wird, kann dennoch zutreffen, aber ihr Fehlen in einer Blindanalyse ist methodisch relevant.
Schlussfolgerungs-Invarianz
Bleibt dieselbe grundlegende Schlussfolgerung auch nach einer Änderung des Framings die beste Erklärung?
Dies erfordert keine identische Formulierung. „Direkte Übertragung wird stark gestützt“ und „die verfügbaren Belege sprechen für eine direkte Übertragung gegenüber einer unabhängigen Konvergenz“ gehören zur selben allgemeinen Schlussfolgerungsklasse.
Konfidenz-Invarianz
Bleibt die Konfidenz annähernd stabil?
Ein Modell, das unter dem ursprünglichen Framing eine Konfidenz von 90 % ausdrückt und bei einer verblindeten Formulierung zutiefst verunsichert ist, hat etwas Wichtiges offenbart – selbst wenn seine nominelle Schlussfolgerung unverändert bleibt.
Eine Prompt-Invarianz-Matrix
Für komplexe Untersuchungen lassen sich die vier Durchläufe in einer einfachen Matrix zusammenfassen.
| Dimension | Original | Verblindet | Invertiert | Adversariell |
|---|---|---|---|---|
| Zentrale Fakten | Ergebnisse erfassen | Ergebnisse erfassen | Ergebnisse erfassen | Umstrittene Fakten hinterfragen |
| Führende Hypothese | Vom Nutzer gerahmt | Durch Evidenz ausgewählt | Alternativ gerahmt | Aktuelle Schlussfolgerung angegriffen |
| Gegenbeweise | Erfassen | Erfassen | Erfassen | Stärkste priorisieren |
| Schlussfolgerung | Basiswert | Vergleichen | Vergleichen | Neu bewerten |
| Konfidenz | Basiswert | Vergleichen | Vergleichen | Rekalibrieren |
Die Matrix muss keinen numerischen Score erzeugen. Ihr primärer Zweck ist diagnostischer Natur: Abhängigkeiten sichtbar zu machen.
Eine numerische Bewertung könnte für automatisierte Systeme ergänzt werden, doch sollten solche Scores nicht als wissenschaftlich validierte Metriken dargestellt werden, solange sie nicht selbst empirisch validiert wurden.
Warum einfaches Paraphrasieren nicht ausreicht
Neuere Forschungen liefern nützliche Belege dafür, dass semantisch äquivalente Prompt-Formulierungen mitunter zu unterschiedlichen Modellurteilen führen können.
Eine Studie von Alhetelah und Ahmad aus dem Jahr 2026 untersuchte 200 Meinungsfragen mit jeweils fünf menschlich validierten Paraphrasen über fünf Sprachmodelle hinweg unter deterministischen Einstellungen. Die Modelle unterschieden sich darin, wie stabil ihre Entscheidungen unter Paraphrasierung blieben.
Dieses Ergebnis spricht für das Testen der Prompt-Robustheit, doch Prompt-Invarianz geht über das reine Testen von Paraphrasen hinaus.
Eine Paraphrase bewahrt idealerweise sowohl die Semantik als auch das Framing. Die hier vorgeschlagene Methodik verändert gezielt ausgewählte Teile des Framings, während das zugrunde liegende Forschungsproblem beibehalten wird.
Paraphrasentests fragen, ob ein gleichwertiger Wortlaut die Antwort ändert. Prompt-Invarianz fragt, ob ein legitimer Perspektivwechsel das ändert, was das Modell durch die Evidenz als gestützt ansieht.
Letzteres ist eine stärkere methodische Intervention.
Instabilität ist nicht automatisch Modellversagen
Prompt-Sensitivität muss mit Vorsicht interpretiert werden.
Hua und Kollegen untersuchten die Prompt-Sensitivität erneut anhand von sieben Sprachmodellen, sechs Benchmarks und zwölf Prompt-Vorlagen. Ihre Studie aus dem Jahr 2025 ergab, dass ein Teil der zuvor berichteten Sensitivität auf Evaluierungsverfahren wie den starren Abgleich von Antworten zurückgeführt werden konnte und nicht auf substantielle Änderungen der Modellkorrektheit.
Genau deshalb sollte Prompt-Invarianz nicht bloß die Oberflächenform vergleichen.
Ein veränderter Satz bedeutet nicht zwangsläufig eine veränderte Schlussfolgerung. Und eine veränderte Schlussfolgerung ist ebenfalls nicht zwingend ein Fehler.
Instabilität kann mehrere grundlegend verschiedene Situationen aufzeigen:
- der ursprüngliche Prompt enthielt einen Framing-Bias;
- das zugrundeliegende Problem ist tatsächlich mehrdeutig;
- die verfügbaren Belege stützen mehrere konkurrierende Interpretationen;
- das Retrieval lieferte unterschiedliche Belege;
- die Evaluationsmethode stufte äquivalente Antworten fälschlicherweise als unterschiedlich ein;
- stochastische Generierung führte zu einem anderen Denkpfad;
- ein Framing brachte eine valide Überlegung zutage, die die anderen ausgelassen hatten.
Prompt-Invarianz ist daher kein Test, bei dem Variation automatisch als Fehlschlag gilt. Variation ist ein diagnostisches Signal, das einer Erklärung bedarf.
Stabilität ist nicht automatisch Wahrheit
Der umgekehrte Fehler ist noch wichtiger.
Angenommen, der ursprüngliche, der blinde, der invertierte und der adversarielle Durchlauf konvergieren alle zur selben Schlussfolgerung.
Das ist ein Beleg für Robustheit gegenüber den getesteten Framing-Änderungen. Es ist kein Beweis für Wahrheit.
Alle Durchläufe können dieselben fehlenden Informationen teilen. Das Modell kann in jedem Durchlauf denselben faktischen Fehler aufweisen. Der Belegkorpus kann unvollständig sein. Verschiedene Prompts können dasselbe erlernte Fehlkonzept aktivieren. Mehrere Agenten, die auf demselben zugrundeliegenden Modell basieren, können denselben Fehler reproduzieren.
Prompt-Invarianz testet die Abhängigkeit vom Framing. Sie validiert nicht das Weltmodell an sich.
Externe Belege, Quellenkritik, Messungen, Experimente und Domänenexpertise bleiben überall dort notwendig, wo das Problem sie erfordert.
Ein technisches Beispiel
Betrachten wir ein Produktivsystem, das intermittierend API-Verbindungen verliert.
Die anfängliche Hypothese der Entwickler lautet, dass nginx die Verbindungen trennt.
Original: Analysiere, warum nginx diese API-Verbindungen trennt.
Blind: Analysiere die Logs und die Konfiguration und bestimme die wahrscheinlichste Ursache für die API-Verbindungsfehler.
Invertiert: Teste, ob die Verbindungsfehler ihren Ursprung in der Anwendung, dem Upstream-Dienst oder der Netzwerkschicht haben und nicht in nginx.
Adversariell: Gehe davon aus, dass die aktuelle Nginx-Diagnose falsch ist. Identifiziere die stärksten Belege, die ihr widersprechen, und die Beobachtungen, die eine andere Hypothese besser erklärt.
Wenn alle Durchläufe unabhängig voneinander auf dieselbe Nginx-Timeout-Konfiguration und dieselben Log-Belege konvergieren, steigt das Vertrauen in die Diagnose.
Wenn nur der ursprüngliche Prompt nginx identifiziert, während die blinde Analyse auf Upstream-Resets hinweist, sollte die erste Diagnose nicht einfach beibehalten werden, nur weil sie zuerst auftrat.
Die Methodik hat das Debugging-Problem nicht von selbst gelöst. Sie hat aufgezeigt, wo weitere unterscheidende Tests erforderlich sind.
Ein historisches Forschungsbeispiel
Dieselbe Struktur gilt für die historische Forschung, aber die Validatoren ändern sich.
Eine behauptete intellektuelle oder religiöse Überlieferung erfordert mehr als thematische Ähnlichkeit. Chronologie, Geographie, dokumentierter Kontakt, textliche Abhängigkeit, Vermittler und Provenienz können alle von Bedeutung sein.
Die vier Prompt-Invarianz-Durchläufe können feststellen, ob die Überlieferungshypothese unter alternativer Formulierung bevorzugt bleibt. Sie können die historischen Beweise, die zur Etablierung der Überlieferung selbst erforderlich sind, nicht ersetzen.
Diese Unterscheidung veranschaulicht die Beziehung zwischen dem domänenunabhängigen Argumentationsrahmen und domänenspezifischen Validatoren, die weiter entwickelt werden in Vom Forschungsprotokoll zum allgemeinen KI-Argumentationsrahmen.
Prompt-Invarianz und Falsifikation
Prompt-Invarianz und Falsifikation lösen verwandte, aber unterschiedliche Probleme.
Prompt-Invarianz fragt:
Überlebt die Schlussfolgerung eine bedeutsame Änderung der Formulierung?
Falsifikation fragt:
Welche Beweise oder Beobachtungen sollten uns dazu bringen, die Hypothese abzulehnen oder wesentlich zu schwächen?
Eine robuste Methodik braucht beides.
Eine Hypothese kann prompt-invariant sein, weil das Modell wiederholt denselben Fehlschluss reproduziert. Falsifikation führt eine stärkere Anforderung ein: die Beobachtungen zu identifizieren, die gegen sie sprechen würden, und aktiv nach ihnen zu suchen.
Diese nächste Ebene wird entwickelt in Falsifikation für KI-Argumentation: Von Antworten zu getesteten Hypothesen.
Von vier Prompts zu einer Verifikationsarchitektur
Der Vier-Durchlauf-Prozess kann manuell ausgeführt werden, aber er wird interessanter, wenn er als Teil eines KI-Systems implementiert wird.
Input → Evidenz-Normalisierung → ursprünglicher Durchlauf → verblindeter Durchlauf → invertierter Durchlauf → adversarieller Durchlauf → strukturierter Vergleich → Rekalibrierung des Konfidenzniveaus → finale Synthese
Einzelne Durchläufe können separate Kontexte nutzen, sodass spätere Analysen nicht durch die vorherige Antwort kontaminiert werden. Ihre Ausgaben können als strukturierte Daten statt als Fließtext gespeichert werden. Ein abschließender Verifizierer kann Fakten, Evidenz, Hypothesen und Konfidenz vergleichen, bevor eine für den Benutzer bestimmte Antwort generiert wird.
Das Ergebnis ist nicht länger eine einzelne Modellantwort. Es ist ein kleiner Verifizierungsprozess.
Die architektonische Implementierung dieses Ansatzes wird in Designing an Epistemic Verification Layer for LLMs entwickelt.
Wann Prompt-Invarianz den Aufwand wert ist
Das Ausführen mehrerer analytischer Durchläufe kostet zusätzliche Token, Latenz und Rechenleistung. Es sollte nicht zum rituellen Mehraufwand für jede Interaktion werden.
Die Methode ist dann am wertvollsten, wenn eine oder mehrere der folgenden Bedingungen zutreffen:
- der Benutzer bereits eine stark bevorzugte Hypothese hat;
- mehrere plausible Erklärungen miteinander konkurrieren;
- die Schlussfolgerung eine wichtige technische oder strategische Entscheidung beeinflussen wird;
- die Forschungsfrage kontrovers ist oder die Evidenz unvollständig ist;
- Kausalitätsbehauptungen aus indirekter Evidenz abgeleitet werden;
- das Modell als Evaluator, Beurteiler oder Entscheidungsunterstützungssystem agiert;
- die Kosten einer selbstsicheren, aber geframten Antwort wesentlich höher sind als die Kosten zusätzlicher Inferenz.
Für einfache deterministische Aufgaben bringt der zusätzliche Prozess möglicherweise kaum einen Mehrwert.
Das methodische Prinzip
Ein starker Prompt bleibt nützlich. Ein starker Prompt sollte jedoch nicht mit einer unabhängigen Verifizierung der Schlussfolgerung verwechselt werden, die er hervorbringt.
Prompt-Invarianz fügt eine zweite Ebene der Befragung hinzu.
Fragen Sie nicht nur, ob die Antwort überzeugend ist. Fragen Sie, welche Teile der Antwort überleben, wenn die Bedingungen geändert werden, die sie überzeugend gemacht haben.
Wenn die Fakten, die Evidenzstruktur und die Schlussfolgerung verblindete, invertierte und adversarielle Formulierungen überstehen, hat das Ergebnis Widerstandsfähigkeit gegenüber einer bedeutenden Quelle von KI-Denkfehlern bewiesen.
Wenn sie nicht überstehen, war die Methodik dennoch erfolgreich.
Sie hat gezeigt, dass die ursprüngliche Schlussfolgerung stärker von ihrem Framing abhing, als eine einzelne geschliffene Antwort offenbart hätte.
Das Ziel von Prompt-Invarianz ist nicht die Übereinstimmung zwischen Prompts. Das Ziel ist es aufzudecken, welche Schlussfolgerungen von ihnen abhängen.
Forschungskontext
Prompt-Invarianz, wie sie in diesem Artikel definiert wird, ist ein vorgeschlagenes methodisches Konstrukt und kein standardisierter Benchmark aus der Fachliteratur. Sie stützt sich auf mehrere angrenzende Forschungsbereiche: Prompt-Architektur, Paraphrasen-Robustheit, Positionsverzerrung und die Evaluation der Prompt-Sensitivität.
Brucks und Toubia zeigten, dass Reihenfolge, Bezeichnungen, Framing und Begründungen systematische methodische Artefakte in LLM-Antworten hervorrufen können. Schilcher und Kollegen untersuchten separat Positionseffekte über mehrere Modelle hinweg und stellten fest, dass die Eingabereihenfolge strukturelle Merkmale, Kohärenz sowie bei einigen Modellen Auslassungs- oder Umordnungsverhalten beeinflussen kann.
Alhetelah und Ahmad testeten fünf Modelle anhand von 200 Meinungsfragen mit jeweils fünf menschlich validierten Paraphrasen und wiesen signifikante Unterschiede in der Robustheit gegenüber semantisch gleichwertigen Formulierungen nach. Hua und Kollegen liefern ein wichtiges Gegengewicht: Ihre Untersuchung von sieben Modellen, sechs Benchmarks und zwölf Prompt-Vorlagen ergab, dass eine scheinbare Prompt-Sensitivität mitunter auf die Evaluationsmethodik und nicht auf tatsächliche Veränderungen der Modellkompetenz zurückzuführen ist.
Zusammengenommen sprechen diese Erkenntnisse dafür, die Robustheit über verschiedene Prompt-Formulierungen hinweg zu testen, erfordern jedoch gleichzeitig Sorgfalt bei der Messung und Interpretation von Unterschieden.
Ausgewählte Referenzen
- Alhetelah, B. & Ahmad, I. — Measuring LLMs' Sensitivity to Paraphrased Opinion Prompts. WASSA / ACL, 2026.
- Hua, A., Tang, K., Gu, C., Gu, J., Wong, E. & Qin, Y. — Flaw or Artifact? Rethinking Prompt Sensitivity in Evaluating LLMs. EMNLP, 2025.
- Brucks, M. S. & Toubia, O. — Prompt Architecture Induces Methodological Artifacts in Large Language Models. PLOS ONE, 2025.
- Schilcher, P. et al. — Characterizing Positional Bias in Large Language Models: A Multi-Model Evaluation of Prompt Order Effects. Findings of EMNLP, 2025.
- Pezeshkpour, P. & Hruschka, E. — Large Language Models Sensitivity to the Order of Options in Multiple-Choice Questions. Findings of NAACL, 2024.
Serie fortsetzen
- Beyond Prompt Engineering: A Methodology for More Reliable AI Reasoning — das vollständige methodische Rahmenwerk.
- The Prompt Is Part of the Bias — warum Framing, Befolgen von Anweisungen und Annahmen der Nutzenden das KI-Schlussfolgern beeinflussen können.
- Falsification for AI Reasoning: From Answers to Tested Hypotheses — bestimmen, welche Belege eine Hypothese tatsächlich schwächen oder widerlegen könnten.
- From Research Protocol to General AI Reasoning Framework — Anwendung der Methodik in Forschung, Debugging, Architektur und Strategie.
Related Articles
KI-Agenten-Gedächtnis ist kein RAG: Wie man Gedächtnis, Retrieval, Zustand und Kontext voneinander trennt
Agentengedächtnis, RAG, Zustand und Kontext werden oft so verwendet, als wären sie austauschbar. Das sind sie nicht. Dieses praktische Architekturmodell trennt die vier Schichten, zeigt, wohin jede gehört, und erklärt, was kaputtgeht, wenn Systeme sie zu einer einzigen zusammenfassen.
Woher bezieht ein LLM seine Daten? RAG-Datenquellen in Python
Ein LLM kennt deine Dateien, Datenbanken oder APIs nicht auf magische Weise. Diese praktische Fortsetzung der RAG-Reihe zeigt mit einfachem Python, wie externe Daten zu abrufbaren Belegen werden: von Textdateien und SQL bis hin zu Volltextsuche, Embeddings, Kontextzusammenstellung und dem abschließenden LLM-Aufruf.
Falsifikation für KI-Schlussfolgern: Von Antworten zu getesteten Hypothesen
KI-Modelle können überzeugende Belege für nahezu jede plausible Hypothese generieren. Eine zuverlässigere Methodik stellt die entgegengesetzte Frage: Welche Belege würden die Schlussfolgerung abschwächen, ihr widersprechen oder uns zwingen, sie aufzugeben? Dieser Artikel entwickelt eine falsifikationsorientierte Argumentation für LLMs mithilfe konkurrierender Hypothesen, diskriminierender Tests, Gegenbelegen und expliziter Ablehnungskriterien.
Was sollte ein KI-Agent behalten, vergessen, neu berechnen oder erneut abrufen?
Langlaufende Agenten sollten sich nicht alles merken. Dieser Artikel bietet ein praktisches Lebenszyklusmodell für die Entscheidung, was in den dauerhaften Speicher gehört, was erneut abgerufen werden sollte, was sicherer neu zu berechnen ist und was ablaufen oder ersetzt werden sollte.
RBAC vs. Mandantenisolierung: Zwei unterschiedliche Sicherheitsgrenzen
RBAC steuert, was ein Benutzer tun darf; Mandantenisolierung steuert, auf welche Ressourcen eines Mandanten diese Aktion zugreifen darf. Erfahren Sie, warum die Sicherheit von Multi-Tenant-SaaS beide Grenzen erfordert.
Enterprise – Hier starten: Ihr Tor zu Operational Excellence
Neu auf unserer Enterprise-Plattform? Dieser Leitfaden bietet einen strukturierten Onboarding-Pfad, von grundlegenden Referenzmodellen bis hin zu umsetzbaren Playbooks, Runbooks und Assessments, die für eine nahtlose Implementierung konzipiert sind.
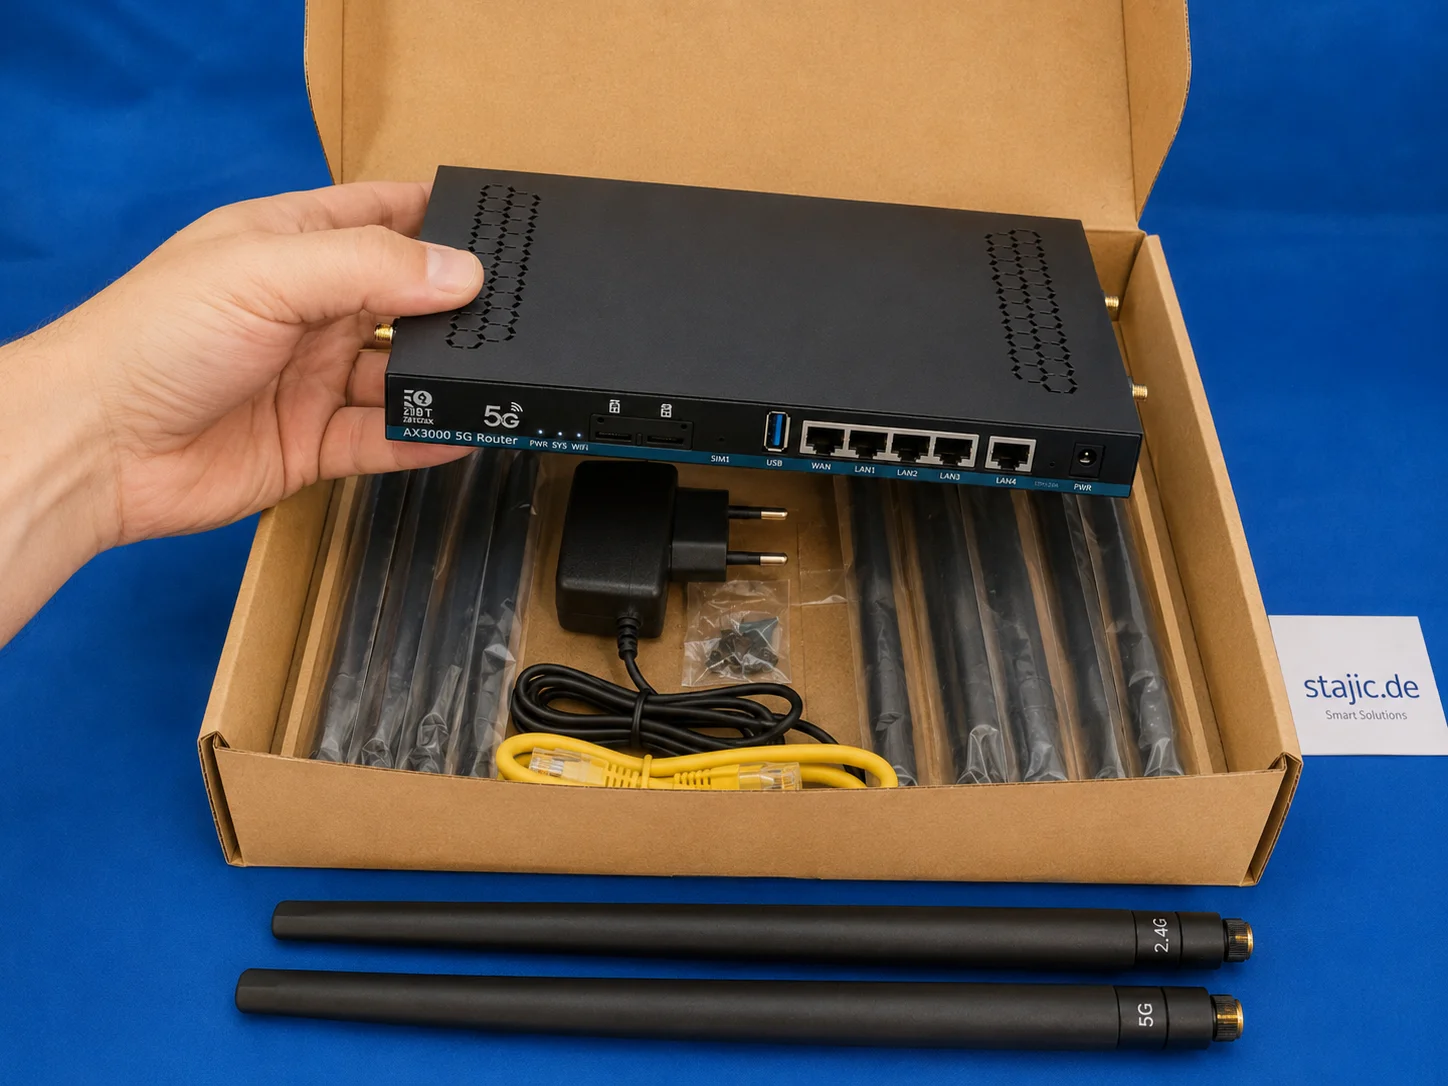
ZBT Z8102AX Hardware- und Verpackungs-Review: Starker Router, schwache Box
Der ZBT Z8102AX macht einen soliden ersten Eindruck als schlanker, schwarzer 5G-OpenWrt-Router aus Metall mit mehreren Antennenanschlüssen, Dual-SIM-Slots, USB- und LAN/WAN-Ports und einem praktischen Zubehörset. Die Hardware fühlt sich nützlich und seriös an, aber die Verpackung ist eindeutig die Schwachstelle.
MCP vs A2A vs UCP vs AP2 vs A2UI: Der Agenten-Protokoll-Stack erklärt
MCP, A2A, UCP, AP2 und A2UI werden oft als konkurrierende Agentenstandards dargestellt. Sie lösen größtenteils unterschiedliche Interoperabilitätsprobleme. Dieser Leitfaden ordnet jedes Protokoll der Grenze zu, die es tatsächlich standardisiert—und zeigt, wie sie in einem Produktionssystem zusammenarbeiten können.
Umfassender Leitfaden für Test DEv Enterprise Stajic.de: Architektur und Best Practices
Entdecken Sie die Architekturprinzipien, Vorteile und technischen Details der Verwaltung einer Entwicklungs- und Testumgebung der Enterprise-Klasse mit Test DEv Enterprise Stajic.de.
Agentische KI erklärt: Wenn ein KI-System planen, Werkzeuge nutzen und handeln kann
Agentische KI verwendet Modelle innerhalb mehrstufiger Ausführungsschleifen, in denen sie Werkzeuge auswählen, Ergebnisse beobachten, den Zustand aktualisieren und ihre nächste Aktion innerhalb expliziter Laufzeit- und Berechtigungsgrenzen anpassen können.
ZBT Z8102AX OpenWrt 21.02 Firmware-Test: Stabil genug, aber ist sie zukunftssicher?
Der ZBT Z8102AX läuft mit einem herstellermodifizierten OpenWrt 21.02-Build mit Kernel 5.4.246. Im praktischen Test funktionierte die Firmware erfolgreich und hielt den Router mehrere Tage lang stabil, aber die alte Basis wirft wichtige Fragen zu Sicherheit, Modemsteuerung, Upgrade-Pfaden und langfristiger Wartbarkeit auf.
Umfassender Leitfaden zu Rollback-Triggern in Enterprise-AI-Runbooks
Dieser Leitfaden untersucht Rollback-Trigger, wesentliche Mechanismen in Enterprise-AI-Runbooks, die automatisch Anomalien erkennen und Rollbacks einleiten, um die Systemstabilität aufrechtzuerhalten. Erfahren Sie, wie Sie diese Trigger für robuste KI-Bereitstellungen konfigurieren, überwachen und optimieren.