
Umfassender Metrik-Leitfaden für Delivery und Change Management
# Umfassender Metrik-Leitfaden für Delivery und Change Management
In Unternehmensumgebungen basieren effektive Delivery und Change Management auf datengestützten Erkenntnissen. Metriken bilden die Grundlage für die Bewertung der Leistung, die Identifizierung von Engpässen und die Sicherstellung der Ausrichtung auf strategische Ziele. Dieser Leitfaden behandelt Kernmetriken über Delivery-Pipelines, Change-Prozesse und die Gesamtwertrealisierung mit praktischen Implementierungsschritten.
## Warum Metriken in Delivery und Change wichtig sind
Metriken wandeln subjektive Meinungen in objektive Daten um und ermöglichen es Teams: - Fortschritte anhand von Zielen zu verfolgen - Risiken vorherzusagen und zu mindern - Ressourcenzuweisung zu optimieren - ROI gegenüber Stakeholdern nachzuweisen
Ohne robuste Metriken riskieren Organisationen isolierte Bemühungen, verlängerte Ausfallzeiten und gescheiterte Transformationen.
## Kern-Delivery-Metriken
### 1. Deployment-Häufigkeit Misst, wie oft Code in die Produktion deployt wird. - **Ziel**: Täglich oder mehrmals täglich für Elite-Performer (DORA-Standards) - **Berechnung**: Anzahl der Deployments pro Tag/Woche/Monat - **Praktische Schritte**: 1. Deployment-Tracking in die CI/CD-Pipeline integrieren 2. Nach Umgebung segmentieren (dev/staging/prod) 3. Mit Branchenstandards vergleichen
### 2. Lead Time für Changes Zeit vom Commit bis zum Deployment in die Produktion. - **Ziel**: Weniger als ein Tag - **Berechnung**: Durchschnittliche Zeit über alle Changes hinweg - **Praktische Schritte**: 1. Tools wie GitHub Actions oder Jenkins für automatisiertes Logging nutzen 2. Verzögerungen in Review-, Test- oder Freigabestufen identifizieren 3. Wo möglich automatisieren, um menschliche Engpässe zu reduzieren
### 3. Change Failure Rate Prozentsatz der Deployments, die Ausfälle in der Produktion verursachen. - **Ziel**: 0-15% - **Berechnung**: (Fehlgeschlagene Changes / Gesamte Changes) × 100 - **Praktische Schritte**: 1. 'Fehler' definieren (z. B. Rollback, Hotfix, beeinträchtigter Service >1 Std.) 2. Canary Releases und Feature Flags implementieren 3. Post-Mortems zu Fehlern durchführen
### 4. Mean Time to Recovery (MTTR) Durchschnittliche Zeit zur Wiederherstellung des Services nach einem Ausfall. - **Ziel**: Weniger als eine Stunde - **Berechnung**: Gesamtausfallzeit / Anzahl der Vorfälle - **Praktische Schritte**: 1. Alerting mit PagerDuty oder Opsgenie einrichten 2. Rollback-Verfahren automatisieren 3. Chaos-Engineering-Übungen durchführen
## Wichtige Change-Management-Metriken
### 1. Change Success Rate Anteil der Changes, die ohne Probleme implementiert wurden. - **Ziel**: >85% - **Berechnung**: (Erfolgreiche Changes / Gesamte Changes) × 100 - **Praktische Schritte**: 1. Change-Request-Vorlagen standardisieren 2. Risikobewertungen und Peer-Reviews vorschreiben 3. Über ITSM-Tools wie ServiceNow verfolgen
### 2. Change-Volumen und Backlog Anzahl der verarbeiteten Changes vs. ausstehender Changes. - **Ziel**: Backlog <10% des monatlichen Volumens - **Berechnung**: Ausstehende Changes / Gesamte eingereichte Changes - **Praktische Schritte**: 1. Mit der MoSCoW-Methode priorisieren 2. Change Advisory Boards (CAB) implementieren 3. Zykluszeit von der Anfrage bis zur Genehmigung überwachen
### 3. Prozentsatz der Notfall-Changes Verhältnis der dringenden Changes zu allen Changes. - **Ziel**: <10% - **Berechnung**: (Notfall-Changes / Gesamt) × 100 - **Praktische Schritte**: 1. Ursachen von Notfällen analysieren 2. Auf proaktive Wartung umstellen 3. Post-Change-Reviews durchsetzen
## Wertrealisierungs-Metriken
### 1. Gelieferter Business Value Quantifiziert die Auswirkung von Changes auf wichtige Ergebnisse. - **Beispiele**: Umsatzsteigerung, Kosteneinsparungen, Nutzerengagement - **Berechnung**: Delta der KPIs vor/nach dem Change - **Praktische Schritte**: 1. Changes mit erwarteten Business Outcomes taggen 2. OKR-Frameworks für die Ausrichtung nutzen 3. Vierteljährliche Value-Scorecards berichten
### 2. Kundenzufriedenheit (CSAT) Feedback zu gelieferten Changes. - **Ziel**: >4/5 Punkte - **Berechnung**: Durchschnittliche Bewertung der Post-Deployment-Umfrage - **Praktische Schritte**: 1. NPS/CSAT-Umfragen automatisieren 2. Mit Deployment-Metriken korrelieren 3. Basierend auf qualitativem Feedback iterieren
## Implementierung eines Metrik-Frameworks
1. **Metriken auswählen**: Beginnen Sie mit den vier Schlüsselmetriken von DORA und ergänzen Sie dann veränderungsspezifische Metriken. 2. **Tooling**: Nutzen Sie Observability-Plattformen (Datadog, New Relic), die mit ITSM integriert sind. 3. **Dashboards**: Erstellen Sie Echtzeitansichten in Grafana oder Tableau. 4. **Benchmarking**: Vergleichen Sie mit Branchenkollegen über den Accelerate State of DevOps Report. 5. **Review-Rhythmus**: Wöchentliche Team-Reviews, monatliche Führungskräfte-Updates. 6. **Aktionsschleifen**: Verknüpfen Sie Metriken mit Retrospektiven und PI-Planung.
## Häufige Fallstricke und Best Practices
- **Fallstrick**: Eitelkeitsmetriken (z. B. Codezeilen) – Konzentrieren Sie sich auf Ergebnisse. - **Best Practice**: Kontext ist entscheidend; segmentieren Sie nach Team/Service. - **Fallstrick**: Überfrachtung mit Metriken – Beschränken Sie sich auf 7–10 Kernmetriken. - **Best Practice**: Automatisieren Sie die Erfassung, um Genauigkeit sicherzustellen.
Verfeinern Sie Ihre Metriken regelmäßig, um sich ändernden Prioritäten gerecht zu werden. Für den Erfolg auf Unternehmensebene integrieren Sie diese in Ihre Referenzmodelle für Delivery und Change.
Related Articles
Jenseits des Prompt-Engineerings: Eine Methodik für zuverlässigeres KI-Schlussfolgern
Große Sprachmodelle scheitern nicht zwangsläufig, weil ihnen die Fähigkeit zum Schlussfolgern fehlt. Sie scheitern oft, weil der Schlussfolgerungsprozess nicht ausreichend eingeschränkt, herausgefordert oder überprüft wird. Dieser Artikel stellt eine domänenunabhängige Methodik vor, die das Prompting in einen strukturierten epistemischen Prozess verwandelt: Fakten von Annahmen trennen, konkurrierende Hypothesen generieren, Gegenbeweise prüfen, Falsifikation anwenden und überprüfen, ob Schlussfolgerungen unter alternativen Rahmungen stabil bleiben. Das Ziel ist nicht, das Modell „weniger zustimmen“ zu lassen, sondern seine Schlussfolgerungen weniger abhängig von der ursprünglichen Rahmung des Nutzers zu machen.
KI-Governance: Modelle, Daten, Berechtigungen, Risiko und Auditierbarkeit
KI-Governance definiert, wer KI-Systeme über Modelle, Anbieter, Daten, Berechtigungen, Risiken, Evaluierung und den gesamten Lebenszyklus hinweg genehmigen, betreiben, ändern und prüfen darf.
Aufkommende Linux-Trends 2026: Die Zukunft der Serverinfrastruktur gestalten
Entdecken Sie die wichtigsten Linux-Trends von 2026, von der Kubernetes-Dominanz und unveränderlichen Distributionen bis hin zur KI-Integration und eBPF-Sicherheit.
Umfassender Leitfaden zum Evaluation Harness: LLM-Leistungsbewertung meistern
Dieser Leitfaden bietet eine detaillierte Einführung in Evaluation Harness, ein unverzichtbares Framework zur strengen Bewertung der Fähigkeiten von Large Language Models (LLMs) in Enterprise-LLMOps-Pipelines. Erfahren Sie mehr über Einrichtung, Best Practices und fortgeschrittene Techniken, um ein zuverlässiges Modell-Benchmarking und eine Optimierung zu gewährleisten.
Sollten Sie einen 5G-OpenWrt-Router mit alter Firmware kaufen? ZBT Z8102AX als praktisches Beispiel
Kauf eines 5G-OpenWrt-Routers mit älterer Firmware kann sinnvoll sein, aber nur unter den richtigen Bedingungen. Der ZBT Z8102AX zeigt beide Seiten deutlich: Die Hardware ist nützlich, das Modem funktioniert, und der Router blieb im Test stabil, aber OpenWrt 21.02, schwache Verpackung und unklare Upgrade-Pfade erfordern eine sorgfältige Kaufentscheidung.
Google I/O 2026: Antigravity, AI Studio und der Wandel zu agentischen DevTools
Google I/O 2026 machte eines für Ingenieure klar: KI-Tooling bewegt sich über die Autovervollständigung hinaus hin zu verwalteter agentischer Ausführung. Dieser Artikel schlüsselt Antigravity 2.0, die wachsende Rolle von Google AI Studio, Gemini 3.5 Flash und die realen Kompromisse rund um Orchestrierung, Lock-in, Verifizierung und das Design von Entwickler-Workflows auf.
Was ist ein KI-Plattform-Architekt? Modelle, Daten, Laufzeitumgebung, Sicherheit und Betrieb
Ein KI-Plattform-Architekt entwirft wiederverwendbare KI-Grundlagen über Modelle, Anbieter, Retrieval, Agenten, Identität, Sicherheit, Evaluierung, Observability und Betrieb hinweg.
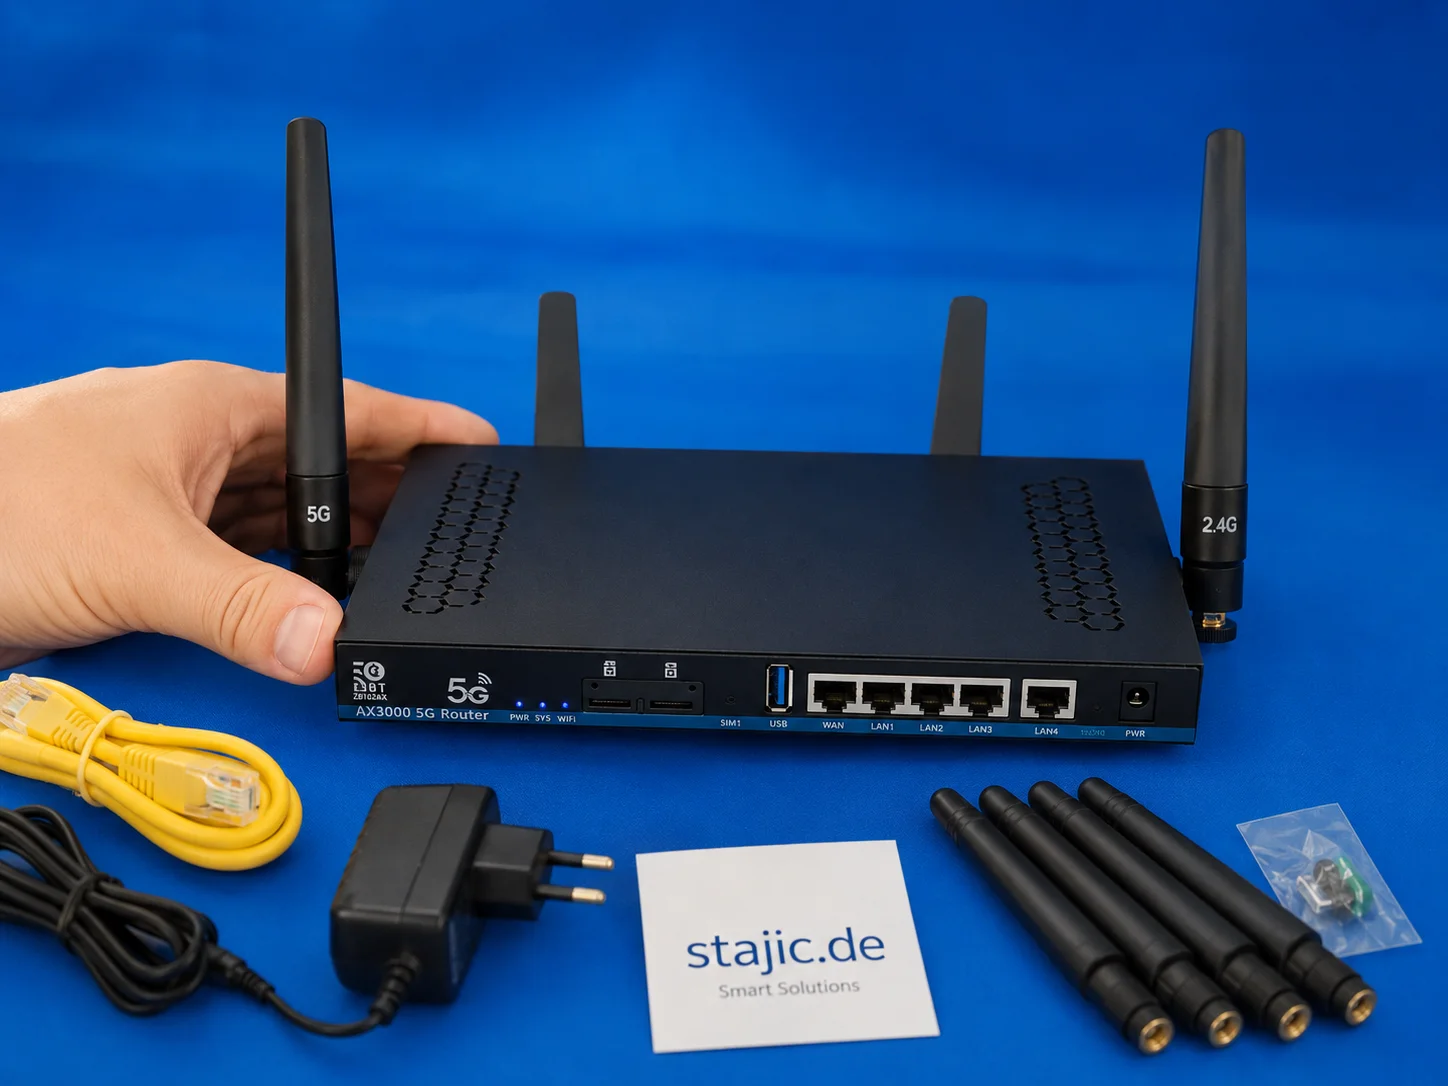
Der nächste OpenWrt-5G-Router: Warum Wi-Fi 7, eine stärkere CPU und bessere Firmware wichtig sind
Der ZBT Z8102AX ist ein nützliches erstes Sample, aber der nächste Schritt sollte stärker sein: Wi-Fi 7, eine leistungsstärkere Vier-Kern-Plattform, mehr Klarheit bei der Firmware, eine verbesserte Verpackung und eine stabilere Preispolitik. Das Ziel ist nicht nur ein weiterer 5G-Router, sondern ein besser konfiguriertes, OpenWrt-basiertes Prosumer-Gerät.
Was ist ein KI-Lösungsarchitekt? Systemgrenzen, Verantwortlichkeiten und Kompromisse
Ein KI-Lösungsarchitekt verwandelt Geschäftsanforderungen in ein produktionsreifes KI-System über Daten, Modelle, Tools, Sicherheit, Laufzeit, Evaluierung und Betrieb hinweg.
Wie man erkennt, ob ein KI-Agent tatsächlich die richtigen Belege verwendet hat
Ein KI-Agent kann Quellen zitieren und trotzdem die falschen Belege verwenden. Dieser Artikel stellt eine praktische Methode zur Überprüfung der Belegung von Behauptungen, der Quellenautorität, der Anwendbarkeit, der Herkunft sowie der Frage vor, ob die Belege die Antwort tatsächlich beeinflusst haben.
Google I/O 2026: Gemini Omni, Gemini 3.5 und der Compute-Layer hinter agentischer KI
Google I/O 2026 stellte Gemini Omni und Gemini 3.5 in den Mittelpunkt von Googles agentischer KI-Strategie. Dieser Artikel schlüsselt den Unterschied zwischen multimodaler Erstellung und handlungsfähiger Intelligenz auf, warum Gemini 3.5 Flash für Agenten und Coding wichtig ist und wie diese Modelle den umfassenderen Plattformwechsel der Google I/O 2026 vorantreiben.
RBAC vs. Mandantenisolierung: Zwei unterschiedliche Sicherheitsgrenzen
RBAC steuert, was ein Benutzer tun darf; Mandantenisolierung steuert, auf welche Ressourcen eines Mandanten diese Aktion zugreifen darf. Erfahren Sie, warum die Sicherheit von Multi-Tenant-SaaS beide Grenzen erfordert.