
Google I/O 2026: Gemini Omni, Gemini 3.5 und der Compute-Layer hinter agentischer KI
Google I/O 2026 rückte die Rechenebene der KI-Strategie von Google wieder in den Mittelpunkt. Die Keynote war voller Agenten, Entwicklertools, Wearable-Schnittstellen und Produktintegrationen, aber all diese Ebenen hängen von zwei Modellrichtungen ab: Gemini Omni und Gemini 3.5. Die eine treibt die multimodale Erstellung und Bearbeitung voran. Die andere treibt zukunftsweisende Intelligenz mit Handlungsfähigkeit voran, insbesondere durch Gemini 3.5 Flash.
Dieser Artikel ist die Compute-Layer-Speiche innerhalb des größeren Google I/O 2026 Architectural Hub. Der Bereich Entwickler-Tools wird in Antigravity, AI Studio und Google DevTools behandelt. Das Thema Geräteoberflächen wird in Android XR und Intelligent Eyewear behandelt. Das Thema Produktoberflächen wird in Agentic Products Across Search, Workspace, and Shopping behandelt.
Wichtig ist, Gemini Omni und Gemini 3.5 nicht als eine einzige, generische Ankündigung eines „neuen KI-Modells“ zu verstehen. Sie lösen unterschiedliche Produkt- und Infrastrukturprobleme. Bei Omni geht es um kreative Generierung aus beliebigen Eingaben, beginnend mit Video. Gemini 3.5 steht für schnelle, handlungsorientierte Intelligenz für Agenten, Coding und Workflows mit langem Zeithorizont. Diese Trennung ist für Entwickler, Produktteams und Plattformarchitekten von Bedeutung.
Die Compute-Ebene hinter der Keynote
Googles eigene I/O 2026-Sammlung stellt die Veranstaltung in den Kontext von zwei neuen Modellen: Gemini Omni und Gemini 3.5. Gemini Omni wird als ein großer Fortschritt im Weltverständnis, in der Multimodalität und Bearbeitung beschrieben, der in der Lage ist, Ausgaben aus Eingaben über Text, Bilder, Audio und Video hinweg zu erstellen, beginnend mit Video. Gemini 3.5 Flash wird als das erste Modell der Gemini 3.5-Familie eingeführt, das Spitzenintelligenz mit Handlungsfähigkeit verbindet.
- Gemini Omni konzentriert sich auf multimodale Erstellung und Bearbeitung, beginnend mit Video.
- Gemini 3.5 Flash konzentriert sich auf extrem hohe Geschwindigkeit für Agenten, Programmierung und komplexe Workflows.
- Die Aufteilung der Modelle spiegelt die breitere Plattformaufteilung von Google wider: reichhaltigere Medien erstellen und dann schneller über Produkte und Tools hinweg agieren.
- Der eigentliche strategische Wert entsteht, wenn diese Modelle mit Antigravity, AI Studio, Search, Workspace, Android XR und Gemini-gestützten Geräten verbunden werden.
Die Modell-Story ist nicht nur ein größerer Kontext oder bessere Demos. Es ist eine Rollenspezialisierung: Erstellung auf der einen Seite, Aktion auf der anderen.— Interpretation der Rechenebene
Gemini Omni: Erstellung aus beliebigen Eingaben
Gemini Omni ist Googles direkter Versuch, logisches Denken mit Erstellung zu verschmelzen. Die offizielle Positionierung ist klar: Es kann alles aus jeder Eingabe erstellen, beginnend mit Video. Das Modell akzeptiert Kombinationen aus Text, Bild, Audio und Video und generiert dann qualitativ hochwertige Videos, die auf dem realen Wissen von Gemini basieren. Es unterstützt auch die dialogbasierte Videobearbeitung, was in tatsächlichen kreativen Workflows wahrscheinlich wichtiger sein wird als die One-Shot-Generierung.
Dieser letzte Punkt ist wichtig. Der praktische Wert von kreativer KI liegt selten nur im „Generieren eines Videos“. Produktions-Workflows erfordern Überarbeitung, Austausch, Timing, Stilkontinuität und Absprachen über Änderungen. Wenn Omni die Bearbeitung dialogorientierter gestalten kann, während der Kontext erhalten bleibt, wird es zu mehr als nur einem Neuheitsgenerator. Es wird zu einer kreativen Schnittstelle.
// Gemini Omni sollte als kreatives Workflow-Modell verstanden werden
input = { text: "Zeige einen Produktlaunch in einer regnerischen Cyberpunk-Stadt", image: "brand-reference.png", audio: "voiceover.wav", video: "rough-cut.mp4"
} output = GeminiOmni.generateVideo(input)
revision = GeminiOmni.edit(output, "Mache die Beleuchtung wärmer und behalte das gleiche Produktdesign bei")
Für Teams, die Medientools, E-Commerce-Produktvisualisierungen, Bildungsinhalte, Prototypen für Spiele, Werbe-Workflows oder Social-Video-Pipelines erstellen, ist dies der wichtigste Teil der I/O 2026. Die Schnittstelle bewegt sich von der manuellen Bearbeitung auf einer Zeitleiste hin zu einer absichtsbasierten multimodalen Bearbeitung. Das nimmt die kreative Urteilskraft nicht weg, aber es verändert, wofür die kreative Arbeit aufgewendet wird.
Gemini 3.5 Flash: Frontier-Intelligenz mit Handlungsfähigkeit
Gemini 3.5 Flash ist die andere Hälfte der Rechenleistungs-Story. Google beschreibt die Gemini 3.5-Familie als eine Kombination aus Frontier-Intelligenz und Handlungsfähigkeit und positioniert 3.5 Flash als die erste Veröffentlichung in dieser Familie. Der Schwerpunkt liegt auf Agenten, Codierung, komplexen, langfristigen Aufgaben und praktischem Nutzen im Alltag. Diese Formulierung ist kein Zufall. Sie weist direkt auf Systeme hin, die handeln, und nicht nur auf Systeme, die antworten.
Für Entwickler ist „Flash“ wichtig, da agentenbasierte Workflows latenzempfindlich sind. Ein Modell, das intelligent, aber langsam ist, kann für die Forschung oder sorgfältiges Schreiben funktionieren. Es ist weitaus schwieriger, dies in terminal-native Automatisierung, IDE-Schleifen, mehrstufige Tool-Nutzung, Hintergrund-Agenten und Produkterlebnisse zu integrieren, die sofortiges Feedback erfordern. Google versucht offensichtlich, schnelles Frontier-Verhalten zur Standard-Engine für agentenbasierte Workflows zu machen.
// Klassische Modellnutzung
answer = model.generate("Erkläre diese Funktion") // Agentische Modellnutzung
plan = model.plan(task)
toolResult = tools.run(plan.nextStep)
verification = model.verify(toolResult) if verification.failed: rollback()
else: continueExecution()
Diese Verschiebung ist der Grund, warum Gemini 3.5 in denselben Cluster wie Antigravity gehört. Antigravity benötigt ein Modell, das planen, ausführen, verifizieren und in Bewegung bleiben kann, ohne die Entwicklungsumgebung in einen Warteraum zu verwandeln. Hier wird Rechenleistung zur Developer Experience.
Warum Geschwindigkeit und Aktion zusammengehören
Googles Keynote-Fokus auf Geschwindigkeit ist nicht nur Marketing. Agentische Systeme multiplizieren die Latenz. Eine einzelne Antwort erfordert einen Modell-Roundtrip. Ein Multi-Agenten-Workflow kann viele haben: Planung, Tool-Auswahl, Code-Bearbeitung, Terminal-Ausführung, Verifizierung, Reparatur, Zusammenfassung und menschliche Überprüfung. Wenn jeder Schritt langsam ist, wird das gesamte System unbrauchbar.
- Schnelle Ausgabe verbessert interaktive Codierungsschleifen.
- Geringe Latenz sorgt dafür, dass sich mehrstufige Agenten weniger anfällig anfühlen.
- Hoher Durchsatz ist wichtig, wenn Agenten im Hintergrund für Wartungsaufgaben ausgeführt werden.
- Stabile Argumentation ist wichtig, da schnellere falsche Aktionen immer noch falsche Aktionen sind.
- Die Verifizierung bleibt unerlässlich, da Geschwindigkeit allein nicht gleichbedeutend mit Vertrauen ist.
Der nützliche Agent ist nicht das Modell, das einmal antwortet. Es ist das Modell, das weiter agieren kann, ohne dass sich der Workflow wie eine Warteschlange anfühlt.— Agentische Laufzeitperspektive
Gemini Omni vs. Gemini 3.5: Unterschiedliche Aufgaben, gleicher Stack
Der klarste Weg, die Compute-Ankündigungen der I/O 2026 zu verstehen, besteht darin, die Aufgaben zu trennen. Gemini Omni ist ein multimodales Erstellungs- und Bearbeitungsmodell. Gemini 3.5 Flash ist ein aktionsorientiertes Modell für Agenten und Codierung. Sie ergänzen sich gegenseitig und sind nicht austauschbar. Ein Produktteam könnte Omni verwenden, um Medien zu generieren, und Gemini 3.5 Flash, um den Workflow um diese Medien herum zu orchestrieren.
// Beispiel für einen Produkt-Workflow
creativeAsset = GeminiOmni.generateVideo(brief) agentPlan = Gemini35Flash.plan({ task: "Publish launch campaign", asset: creativeAsset, channels: ["YouTube Shorts", "landing page", "email"]
}) Gemini35Flash.execute(agentPlan, tools)
Das ist die breitere Architektur, auf die Google hinweist. Kreativmodelle erzeugen reichhaltigere Artefakte. Aktionsmodelle koordinieren Aufgaben rund um diese Artefakte. Produktoberflächen machen diese Funktionen für Nutzer zugänglich. Entwicklertools bieten Orchestrierung und Verifizierung. Geräteoberflächen machen den Assistenten in mehr Kontexten verfügbar.
Was das für Entwickler bedeutet
Entwickler sollten Gemini 3.5 Flash nicht nur als eine weitere Modelloption betrachten. Es verändert die Art von Anwendungen, die auf Googles Stack aufgebaut werden können. Wenn ein Modell längere Aufgabensequenzen bewältigen, Tools zuverlässig nutzen und schnell genug für reale Workflows arbeiten kann, können sich Anwendungen von isolierten KI-Funktionen hin zu modellgesteuerten Prozessen entwickeln.
- Code-Agenten können größere Aufgabeneinheiten refaktorieren, testen und verifizieren.
- Produkt-Agenten können Benutzern helfen, innerhalb eines einzigen Ablaufs von der Absicht zur Aktion überzugehen.
- Medienanwendungen können Omni-Generierung mit Gemini 3.5-Orchestrierung kombinieren.
- Such- und Workspace-Funktionen können sich von der Beantwortung hin zur Ausführung entwickeln.
- Mobile und XR-Oberflächen können Gemini als Live-Kontextebene anstelle eines entfernten Cloud-Assistenten nutzen.
Die Gefahr besteht darin, zu viel zu bauen, bevor das Betriebsmodell ausgereift ist. Entwickler benötigen weiterhin Versionierung, Evaluierung, Protokollierung, Kostenkontrollen, Fallback-Verhalten und menschliche Bestätigung für folgenschwere Aktionen. Ein stärkeres Modell macht technische Disziplin nicht überflüssig. Es erhöht den Wert dieser Disziplin.
Was das für Produktteams bedeutet
Produktteams sollten Gemini Omni und Gemini 3.5 als Signal dafür verstehen, dass Google möchte, dass KI zu einer Ausführungsebene im gesamten Ökosystem wird. Das birgt Chancen und Risiken. Die Chance liegt in einem schnelleren Weg von der Benutzerabsicht zum fertigen Ergebnis. Das Risiko besteht darin, dass das Produktverhalten weniger transparent wird, wenn Entscheidungen von Agenten hinter einer polierten Benutzeroberfläche verborgen bleiben.
agenticProductChecklist = { userIntent: "clear", modelRole: "defined", tools: "permissioned", outputs: "reviewable", failures: "recoverable", costs: "measured", userControl: "explicit"
}
Wenn ein Produktteam nicht beantworten kann, was das Modell tun darf, wie es evaluiert wird und wie der Benutzer eine fehlerhafte Aktion rückgängig machen kann, ist die Integration nicht bereit für die Produktion. Dies gilt insbesondere dann, wenn Gemini mit der Suche, Workspace, Shopping, Android oder Wearable-Schnittstellen verbunden ist.
Der Realitätscheck: Benchmarks sind nicht das Produkt
Das Risiko bei jedem Modellstart ist eine Benchmark-Intoxikation. Eine bessere Leistung ist wichtig, aber der Produktionswert hängt von der Integrationsqualität ab. Ein Modell kann schneller und stärker sein und dennoch bei einem bestimmten Workflow scheitern, weil die Prompts schwach sind, die Tool-Richtlinien zu locker sind, die Evaluierung oberflächlich ist oder Rollback-Pfade fehlen.
- Ein kreatives Modell benötigt Konsistenz, Editierbarkeit und Ausgabekontrolle.
- Ein Aktionsmodell benötigt Tool-Disziplin, Verifizierung und sichere Fehlermodi.
- Ein Entwicklermodell benötigt wiederholbares Verhalten in echten Repositories.
- Ein Produktmodell benötigt das Vertrauen der Nutzer und klare Kontrollgrenzen.
- Ein Plattformmodell benötigt Versionierung, Monitoring und Kostenbeobachtbarkeit.
Das Launch-Modell erregt Aufmerksamkeit. Das Betriebsmodell entscheidet, ob es die Produktion überlebt.— Engineering-Realitätscheck
Wie sich dies in den Google I/O 2026 Cluster einfügt
Dieser Artikel befasst sich mit der Modellebene des Clusters. Der Haupt-Hub zur Google I/O 2026 erklärt den gesamten architektonischen Wandel. Antigravity, AI Studio und Google DevTools erklären, wie die Modelle in die Entwickler-Workflows einfließen. Android XR und Intelligent Eyewear erklären, wie dieselbe Intelligenz auf Wearables übertragen wird. Agentenbasierte Produkte in Search, Workspace und Shopping erklären, was passiert, wenn diese Funktionen Endverbraucher- und Produktivitätsprodukte erreichen.
Ähnliche Artikel in diesem Cluster
- Haupt-Hub: Google I/O 2026: Architektonische Weichenstellungen, agentische KI und der Realitätscheck des vereinheitlichten Ökosystems
- Entwickler-Tools: Google I/O 2026: Antigravity, AI Studio und Google DevTools
- Android, XR und Geräteoberflächen: Google I/O 2026: Android XR und intelligente Brillen
- Agentische Verbraucherprodukte: Google I/O 2026: Agentische Produkte in der Suche, Workspace und Shopping
Abschließende Perspektive
Gemini Omni und Gemini 3.5 definieren die Aufteilung der Rechenleistung hinter der Google I/O 2026. Omni ist die Erstellungsebene: multimodaler Input, Video-Output, konversationelle Bearbeitung und weltbezogene Generierung. Gemini 3.5 Flash ist die Aktionsebene: schnelle Spitzen-Intelligenz für Agenten, Codierung und langfristige Aufgaben. Zusammen erklären sie, warum der Rest der Keynote so aussieht, wie er aussieht. Antigravity benötigt Modelle der Aktionsklasse. Suche und Workspace benötigen Agenten, die logisch denken und handeln können. Android XR benötigt ein Live-Kontextverständnis. Die Keynote ist nicht nur eine Modell-Story, aber ohne diese Rechenebene funktioniert der Rest der Story nicht.
Related Articles
Umfassender Leitfaden zum Evaluation Harness: LLM-Leistungsbewertung meistern
Dieser Leitfaden bietet eine detaillierte Einführung in Evaluation Harness, ein unverzichtbares Framework zur strengen Bewertung der Fähigkeiten von Large Language Models (LLMs) in Enterprise-LLMOps-Pipelines. Erfahren Sie mehr über Einrichtung, Best Practices und fortgeschrittene Techniken, um ein zuverlässiges Modell-Benchmarking und eine Optimierung zu gewährleisten.
Wann sollte eine KI aufhören, ihrem eigenen Wissen zu vertrauen? — Der Retrieval-Trigger
Ein KI-Modell benötigt nicht für jede Frage einen Retrieval. Das wichtige Problem ist zu erkennen, wann sein internes Wissen nicht mehr ausreicht. Der Retrieval-Trigger ist eine praktische Entscheidungsgrenze, die bestimmt, wann ein KI-System aufhören sollte, sich allein auf das Modellwissen zu verlassen, und vor der Beantwortung externe Evidenz einholen sollte.
Umfassender Leitfaden zu Rollback-Triggern in Enterprise-AI-Runbooks
Dieser Leitfaden untersucht Rollback-Trigger, wesentliche Mechanismen in Enterprise-AI-Runbooks, die automatisch Anomalien erkennen und Rollbacks einleiten, um die Systemstabilität aufrechtzuerhalten. Erfahren Sie, wie Sie diese Trigger für robuste KI-Bereitstellungen konfigurieren, überwachen und optimieren.
OpenAI Agents API vs. Agents SDK vs. Responses API: Worauf sollten Sie 2026 aufbauen?
Der Agent-Stack von OpenAI hat sich im September 2026 geändert. Dieser Architekturleitfaden unterscheidet die Agents API, das Agents SDK, die Responses API und das Codex SDK nach Runtime-Ownership—sodass Teams die richtige Kontrollgrenze wählen können, anstatt Produktnamen zu vergleichen.
Warum ruft KI einige Quellen ab und ignoriert andere? — Die Retrieval-Autoritätsschicht
Ein relevantes Dokument zu finden, reicht nicht aus. KI-Systeme müssen auch Quellen, die aktuell, maßgeblich, anwendbar und nachvollziehbar sind, von Quellen unterscheiden, die lediglich ähnlich aussehen. Die Retrieval Authority Layer definiert diese Grenze der Quellenauswahl.
Was ist RAG? Die einfachste Erklärung, wie es funktioniert
RAG klingt kompliziert, aber die Idee ist einfach: Bevor eine KI antwortet, sucht sie zunächst nützliche Informationen aus einer Wissensquelle und gibt diese Informationen an das Sprachmodell weiter. Dieser Leitfaden erklärt RAG, LLMs, Zustand, Gedächtnis und Werkzeuge anhand eines einfachen mentalen Modells.
Vektordatenbanken, Embeddings und Reranking: Drei verschiedene Teile des Retrievals
Embeddings repräsentieren Bedeutung, Vektordatenbanken rufen Kandidaten ab und Reranker verfeinern Ergebnisse. Erfahren Sie, wie sich diese drei Retrieval-Ebenen unterscheiden und in RAG zusammenwirken.
Enterprise-KI-Architektur: Was ändert sich, wenn KI in ein Unternehmen eintritt
Enterprise-KI-Architektur erklärt, wie KI Unternehmenssysteme über Datenhoheit, Identität, Berechtigungen, Anbieter, Risiko, Governance, Evaluierung, Compliance und Betrieb hinweg verändert.
Managed Agent Harness vs. Self-Hosted Agent Loop: Was Sie gewinnen, was Sie verlieren
“Selbst gehosteter Agent” kann sehr unterschiedliche Architekturen bedeuten. Dieser Leitfaden unterscheidet zwischen dem Managed Harness, der selbst gehosteten Ausführungsumgebung und dem vollständig selbst betriebenen Agent-Loop—und zeigt, welche Kontrollgrenze Teams tatsächlich benötigen.
Google I/O 2026: Android XR, intelligente Brillen und das Ambient-AI-Interface
Google I/O 2026 hat Android XR und intelligente Brillen von einem Konzept hin zu einer echten Plattformrichtung vorangetrieben. Dieser Artikel schlüsselt Audio-Brillen, Display-Brillen, Gemini-gestütztes Kontextbewusstsein, Auswirkungen auf Entwickler sowie Datenschutzrisiken auf und erklärt, warum es bei Wearable-KI weniger darum geht, Telefone zu ersetzen, als vielmehr darum, ambiente Assistenzflächen zu schaffen.
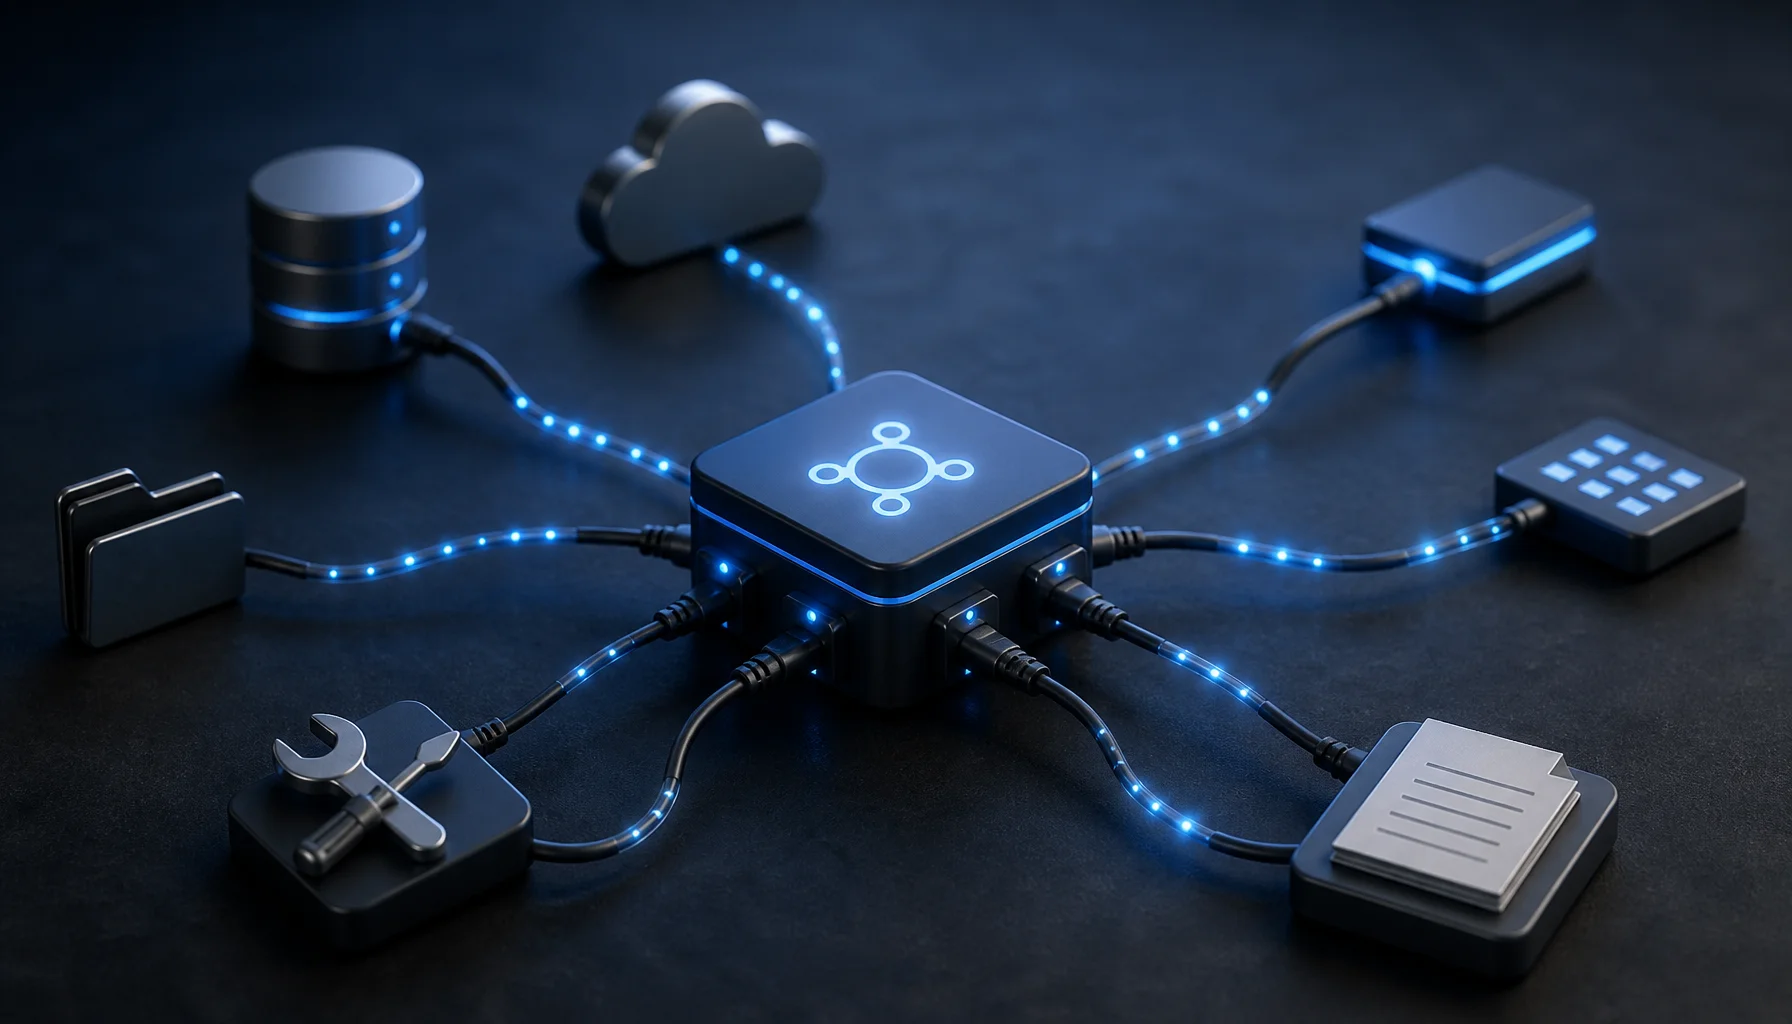
MCP erklärt: Was es verbindet, was es nicht tut und wo es passt
Das Model Context Protocol verbindet KI-Anwendungen über eine standardisierte Client-Server-Grenze mit externen Tools, Ressourcen und Prompts. Erfahren Sie, was MCP tut, was es nicht tut und wo es in der Agentenarchitektur einzuordnen ist.
Ultimativer Leitfaden zu Akzeptanzkriterien für die LLM-Einführung in Enterprise-Playbooks
Meistere die Kunst, präzise Akzeptanzkriterien zu definieren, um eine erfolgreiche LLM-Integration in Ihrer Unternehmensumgebung sicherzustellen. Dieser umfassende Leitfaden bietet umsetzbare Frameworks, Beispiele und Best Practices, die auf playbook-gesteuerte Adoption zugeschnitten sind.