
Enterprise – Hier starten: Ihr Tor zu Operational Excellence
Willkommen bei Enterprise: Hier beginnen
Wenn Sie neu auf unserer Enterprise-Plattform sind oder Ihre Abläufe optimieren möchten, sind Sie hier genau richtig. Der Hier beginnen-Hub dient als Ihr umfassendes Onboarding-Zentrum und führt Sie durch bewährte Frameworks, Tools und Prozesse, die auf Implementierungen im Enterprise-Maßstab zugeschnitten sind. Ganz gleich, ob Sie eine Führungskraft auf C-Level, ein IT-Leiter oder ein Operations Manager sind, diese Seite zeigt Ihnen einen klaren Weg auf, wie Sie unsere Ressourcen effektiv nutzen können.
Warum hier beginnen?
Enterprise-Umgebungen erfordern Zuverlässigkeit, Skalierbarkeit und Effizienz. Unsere Plattform adressiert diese Anforderungen mit praxiserprobten Komponenten, die die Implementierungszeit verkürzen, Risiken minimieren und messbare Ergebnisse liefern. Wenn Sie hier beginnen, stellen Sie sicher, dass Sie auf einem soliden Fundament aufbauen, anstatt Prozesse von Grund auf neu zu erfinden.
Erfolg im Enterprise-Betrieb beginnt mit dem richtigen Bauplan – nicht mit Versuch und Irrtum.— Prinzip des Enterprise-Betriebs
Ihr strukturierter Onboarding-Pfad
Folgen Sie diesem sequenziellen Pfad, um den maximalen Nutzen zu erzielen. Jeder Schritt baut auf dem vorherigen auf und lässt sich nahtlos in unser gesamtes Ökosystem integrieren.
- Prüfen Sie Referenzmodelle, um branchenübliche Architekturen und Best Practices zu verstehen.
- Tauchen Sie in Playbooks ein, um Schritt-für-Schritt-Strategien für gängige Enterprise-Szenarien zu erhalten.
- Implementieren Sie mit Runbooks für eine präzise, wiederholbare Ausführung kritischer Verfahren.
- Messen Sie den Fortschritt mithilfe von Assessments, um Ihren Betrieb zu bewerten und zu verfeinern.
Schritt 1: Referenzmodelle erkunden
Referenzmodelle bieten Baupläne für Enterprise-Architekturen und decken Bereiche wie Cloud-Migration, Sicherheitskonzepte und DevOps-Pipelines ab. Diese Modelle wurden aus realen Implementierungen bei Fortune-500-Unternehmen abgeleitet und gewährleisten Anwendbarkeit ohne hohen Anpassungsaufwand. Beginnen Sie hier, um Ihre Strategie an bewährten Mustern auszurichten.
Schritt 2: Playbooks meistern
Playbooks übersetzen übergeordnete Strategien in handfeste Anleitungen. Von der Reaktion auf Vorfälle bis hin zur Skalierung der Infrastruktur enthält jedes Playbook Entscheidungsbäume, Checklisten und Integrationspunkte für Ihre vorhandenen Tools. Nutzen Sie diese, um komplexe Initiativen souverän zu steuern.
Schritt 3: Mit Runbooks ausführen
Runbooks sind Ihre taktischen Ausführungshandbücher. Sie sind für den On-Demand-Einsatz konzipiert und enthalten detaillierte Befehle, API-Aufrufe und Abläufe zur Fehlerbehebung. Runbooks sind ideal für 24/7-Betriebsteams und gewährleisten Konsistenz und Geschwindigkeit in Drucksituationen.
Schritt 4: Mit Assessments bewerten
Assessments bieten objektive Bewertungsrahmen, um Reifegrade anhand von Benchmarks zu messen. Führen Sie Selbsteinschätzungen oder geführte Audits durch, um Lücken zu identifizieren, Verbesserungen zu priorisieren und den ROI im Zeitverlauf zu verfolgen.
Best Practices für den Einstieg
- Stellen Sie ein funktionsübergreifendes Team zusammen, das IT-, Sicherheits- und Geschäfts-Stakeholder einbezieht.
- Legen Sie klare KPIs fest, die an Ihrer Auswahl der Referenzmodelle ausgerichtet sind.
- Führen Sie ein Pilotprojekt für ein Playbook in einer Nicht-Produktionsumgebung durch, bevor der vollständige Rollout erfolgt.
- Planen Sie vierteljährliche Bewertungen, um den Schwung beizubehalten.
- Nutzen Sie unsere Community-Foren für Einblicke von Gleichgesinnten und Unterstützung.
Bereit für den nächsten Schritt?
Dieser Hub ist Ihr Startpunkt. Setzen Sie ein Lesezeichen und kehren Sie im weiteren Verlauf hierher zurück. Für eine persönliche Beratung kontaktieren Sie unser Enterprise Success Team. Transformieren Sie noch heute Ihren Betrieb – beginnen Sie mit den Referenzmodellen.
Related Articles
Google I/O 2026: Agentische Produkte in Search, Workspace und Shopping
Google I/O 2026 zeigte, dass sich agentenbasierte KI über Modelldemos und Entwicklertools hinaus in alltägliche Produktoberflächen bewegt. Dieser Artikel schlüsselt auf, wie Search, Workspace, Gemini Spark und Universal Cart auf ein neues Produktmodell hinweisen, bei dem Google-Agenten Nutzern helfen, über vernetzte Dienste hinweg zu recherchieren, zu arbeiten, einzukaufen und zu agieren.
Google I/O 2026: Antigravity, AI Studio und der Wandel zu agentischen DevTools
Google I/O 2026 machte eines für Ingenieure klar: KI-Tooling bewegt sich über die Autovervollständigung hinaus hin zu verwalteter agentischer Ausführung. Dieser Artikel schlüsselt Antigravity 2.0, die wachsende Rolle von Google AI Studio, Gemini 3.5 Flash und die realen Kompromisse rund um Orchestrierung, Lock-in, Verifizierung und das Design von Entwickler-Workflows auf.
MLOps vs. LLMOps: Was sich ändert, wenn das Modell ein LLM ist
MLOps betreibt Systeme für maschinelles Lernen; LLMOps erweitert diese Praktiken auf Prompts, Kontext, Retrieval, Anbieter, Tools, Evaluierungen und Laufzeitverhalten rund um große Sprachmodelle.
KI-Agenten-Gedächtnis ist kein RAG: Wie man Gedächtnis, Retrieval, Zustand und Kontext voneinander trennt
Agentengedächtnis, RAG, Zustand und Kontext werden oft so verwendet, als wären sie austauschbar. Das sind sie nicht. Dieses praktische Architekturmodell trennt die vier Schichten, zeigt, wohin jede gehört, und erklärt, was kaputtgeht, wenn Systeme sie zu einer einzigen zusammenfassen.
Ollama ist nicht das Produkt: Entwicklung produktionsreifer Open-LLM-Anwendungen
Das Ausführen eines lokalen Modells mit Ollama ist einfach. Das Erstellen einer produktionsreifen Open-LLM-Anwendung ist schwieriger: Es erfordert RAG, Zugriffskontrolle, Anbieterabstraktion, Evaluierung, Protokollierung, Bereitstellungsdisziplin und eine kontrollierte Anwendungsschicht um das Modell herum.
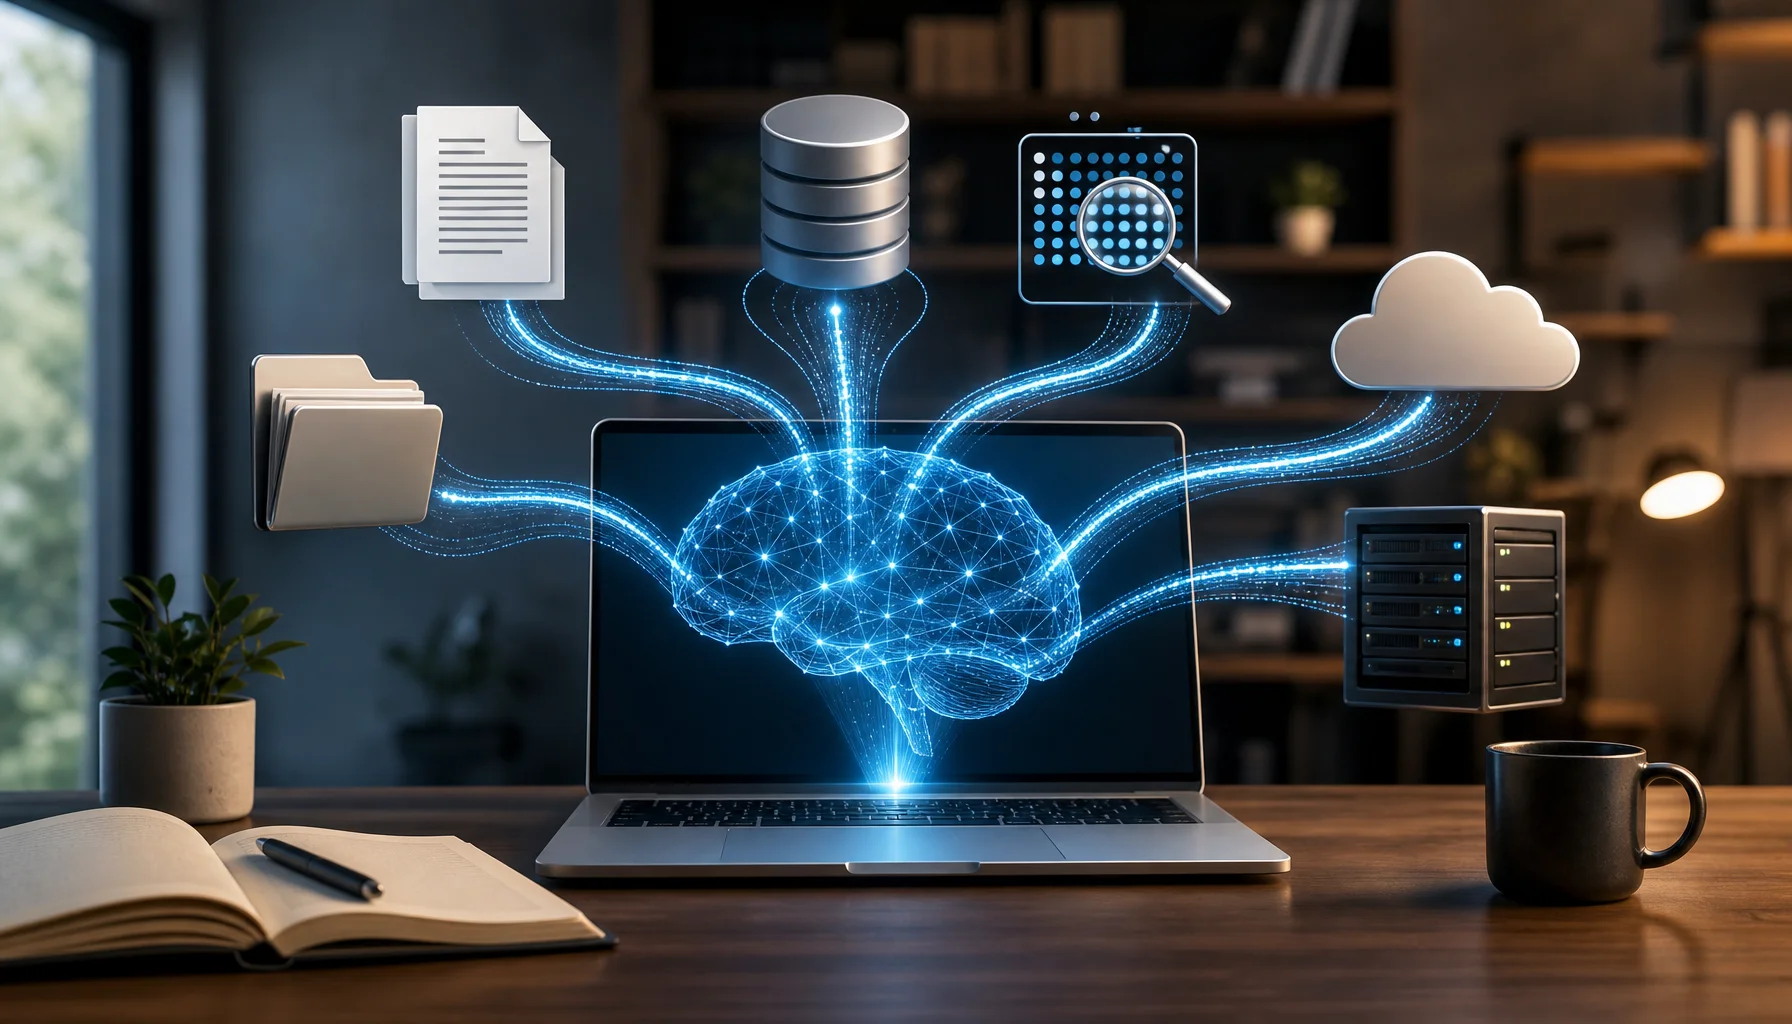
Woher bezieht ein LLM seine Daten? RAG-Datenquellen in Python
Ein LLM kennt deine Dateien, Datenbanken oder APIs nicht auf magische Weise. Diese praktische Fortsetzung der RAG-Reihe zeigt mit einfachem Python, wie externe Daten zu abrufbaren Belegen werden: von Textdateien und SQL bis hin zu Volltextsuche, Embeddings, Kontextzusammenstellung und dem abschließenden LLM-Aufruf.
Vektordatenbanken, Embeddings und Reranking: Drei verschiedene Teile des Retrievals
Embeddings repräsentieren Bedeutung, Vektordatenbanken rufen Kandidaten ab und Reranker verfeinern Ergebnisse. Erfahren Sie, wie sich diese drei Retrieval-Ebenen unterscheiden und in RAG zusammenwirken.
Was ist ein KI-Plattform-Architekt? Modelle, Daten, Laufzeitumgebung, Sicherheit und Betrieb
Ein KI-Plattform-Architekt entwirft wiederverwendbare KI-Grundlagen über Modelle, Anbieter, Retrieval, Agenten, Identität, Sicherheit, Evaluierung, Observability und Betrieb hinweg.
RAG fehlgeschlagen – aber welche Ebene ist tatsächlich fehlgeschlagen? Eine diagnostische Methode
Wenn eine RAG-Antwort falsch ist, ist es zu vage, das Retrieval oder das Modell verantwortlich zu machen. Diese Diagnosemethode isoliert Quellenabdeckung, Query-Konstruktion, Retrieval, Ranking, Kontextzusammenstellung, Generierung, Evidenzzuordnung und Aktualität – sodass der tatsächliche Fehler reproduziert und behoben werden kann.
Warum ruft KI einige Quellen ab und ignoriert andere? — Die Retrieval-Autoritätsschicht
Ein relevantes Dokument zu finden, reicht nicht aus. KI-Systeme müssen auch Quellen, die aktuell, maßgeblich, anwendbar und nachvollziehbar sind, von Quellen unterscheiden, die lediglich ähnlich aussehen. Die Retrieval Authority Layer definiert diese Grenze der Quellenauswahl.
Was sollte ein KI-Agent behalten, vergessen, neu berechnen oder erneut abrufen?
Langlaufende Agenten sollten sich nicht alles merken. Dieser Artikel bietet ein praktisches Lebenszyklusmodell für die Entscheidung, was in den dauerhaften Speicher gehört, was erneut abgerufen werden sollte, was sicherer neu zu berechnen ist und was ablaufen oder ersetzt werden sollte.
Vom Forschungsprotokoll zu einem allgemeinen KI-Reasoning-Framework
Eine Methodik, die für rigorose KI-gestützte Forschung entwickelt wurde, lässt sich weit über die Forschung selbst hinaus verallgemeinern. Durch die Trennung von Evidenz und Annahmen, das Testen konkurrierender Hypothesen, die Kontrolle des Prompt-Framings, die Suche nach Gegenbeweisen und die Anwendung domänenspezifischer Validatoren kann dieselbe Reasoning-Architektur Debugging, Softwaredesign, Strategie, technische Analyse und KI-gestützte Entscheidungsunterstützung verbessern.