RAG klingt kompliziert, aber die Idee ist einfach: Bevor eine KI antwortet, sucht sie zunächst nützliche Informationen aus einer Wissensquelle und gibt diese Informationen an das Sprachmodell weiter. Dieser Leitfaden erklärt RAG, LLMs, Zustand, Gedächtnis und Werkzeuge anhand eines einfachen mentalen Modells.
Computer-Use-Agenten können mittlerweile beeindruckende Browser- und Desktop-Workflows abschließen, aber ein erfolgreicher Durchlauf beweist Fähigkeit—nicht Zuverlässigkeit. Dieser Artikel zeigt, wie man Wiederholbarkeit, Umgebungsrobustheit, Steuerung über lange Zeithorizonte, Zustandsbewusstsein, Ergebnisüberprüfung und sichere Zielhandhabung testet.
MCP, A2A, UCP, AP2 und A2UI werden oft als konkurrierende Agentenstandards dargestellt. Sie lösen größtenteils unterschiedliche Interoperabilitätsprobleme. Dieser Leitfaden ordnet jedes Protokoll der Grenze zu, die es tatsächlich standardisiert—und zeigt, wie sie in einem Produktionssystem zusammenarbeiten können.
“Selbst gehosteter Agent” kann sehr unterschiedliche Architekturen bedeuten. Dieser Leitfaden unterscheidet zwischen dem Managed Harness, der selbst gehosteten Ausführungsumgebung und dem vollständig selbst betriebenen Agent-Loop—und zeigt, welche Kontrollgrenze Teams tatsächlich benötigen.
Die Migration vom OpenAI Agents SDK zur neuen Agents API ist keine reine Umbenennung von Imports. Die Laufzeitgrenze verschiebt sich: Die Agent-Schleife, die dauerhafte Sitzung, die Orchestrierung, die Kontextkomprimierung und die Wiederherstellung bewegen sich in Richtung einer verwalteten Harness. Dieser Leitfaden zeigt, was verschoben werden sollte, was in Ihrer Anwendung bleiben sollte und wie Sie die Migration vor dem Cutover nachweisen können.
Der Agent-Stack von OpenAI hat sich im September 2026 geändert. Dieser Architekturleitfaden unterscheidet die Agents API, das Agents SDK, die Responses API und das Codex SDK nach Runtime-Ownership—sodass Teams die richtige Kontrollgrenze wählen können, anstatt Produktnamen zu vergleichen.
Ein größeres Kontextfenster garantiert keine bessere Antwort. Dieser Artikel erklärt, wie Signalverwässerung, widersprüchliche Belege, veralteter Zustand, Positionssensitivität und verlustbehaftete Kompression die KI-Zuverlässigkeit verringern können—und stellt einen praktischen Context Pressure Test vor.
Ein KI-Agent kann Quellen zitieren und trotzdem die falschen Belege verwenden. Dieser Artikel stellt eine praktische Methode zur Überprüfung der Belegung von Behauptungen, der Quellenautorität, der Anwendbarkeit, der Herkunft sowie der Frage vor, ob die Belege die Antwort tatsächlich beeinflusst haben.
Agentengedächtnis, RAG, Zustand und Kontext werden oft so verwendet, als wären sie austauschbar. Das sind sie nicht. Dieses praktische Architekturmodell trennt die vier Schichten, zeigt, wohin jede gehört, und erklärt, was kaputtgeht, wenn Systeme sie zu einer einzigen zusammenfassen.
Langlaufende Agenten sollten sich nicht alles merken. Dieser Artikel bietet ein praktisches Lebenszyklusmodell für die Entscheidung, was in den dauerhaften Speicher gehört, was erneut abgerufen werden sollte, was sicherer neu zu berechnen ist und was ablaufen oder ersetzt werden sollte.
Wenn eine RAG-Antwort falsch ist, ist es zu vage, das Retrieval oder das Modell verantwortlich zu machen. Diese Diagnosemethode isoliert Quellenabdeckung, Query-Konstruktion, Retrieval, Ranking, Kontextzusammenstellung, Generierung, Evidenzzuordnung und Aktualität – sodass der tatsächliche Fehler reproduziert und behoben werden kann.
Eine Quelle kann relevant und maßgeblich sein und dennoch falsch für die gestellte Frage. Die fehlende Ebene ist die Anwendbarkeit: die Bedingungen, unter denen eine Antwort gilt, und die Veränderungen, die erzwingen, dass sie überdacht werden muss. Dieser Artikel führt die Answer Validity Boundary als ein Quellendesign-Muster für Menschen, KI-Suche und RAG-Systeme ein.
Private KI-Infrastruktur sollte nicht um eine einzige GPU oder ein einziges Modell herum konzipiert werden. Ein resilienterer Ansatz kombiniert schnelle Inferenz-GPUs, speicherstarke KI-Systeme, physische KI-Knoten und optionale Frontier-Cloud-Modelle hinter einer fähigkeitsbewussten Routing-Schicht.
Eine Methodik, die für rigorose KI-gestützte Forschung entwickelt wurde, lässt sich weit über die Forschung selbst hinaus verallgemeinern. Durch die Trennung von Evidenz und Annahmen, das Testen konkurrierender Hypothesen, die Kontrolle des Prompt-Framings, die Suche nach Gegenbeweisen und die Anwendung domänenspezifischer Validatoren kann dieselbe Reasoning-Architektur Debugging, Softwaredesign, Strategie, technische Analyse und KI-gestützte Entscheidungsunterstützung verbessern.
KI-Modelle können überzeugende Belege für nahezu jede plausible Hypothese generieren. Eine zuverlässigere Methodik stellt die entgegengesetzte Frage: Welche Belege würden die Schlussfolgerung abschwächen, ihr widersprechen oder uns zwingen, sie aufzugeben? Dieser Artikel entwickelt eine falsifikationsorientierte Argumentation für LLMs mithilfe konkurrierender Hypothesen, diskriminierender Tests, Gegenbelegen und expliziter Ablehnungskriterien.
Eine praktische Methodik zur Überprüfung, ob eine KI-Schlussfolgerung davon abhängt, wie ein Problem gerahmt wurde. Prompt Invariance vergleicht ursprüngliche, blinde, invertierte und adversariale Formulierungen, während die Evidenzstruktur kontrolliert bleibt.
Die Formulierung von Prompts ist nicht neutral. Erfahren Sie, wie Framing, Annahmen, Instruktionsbefolgung und Sykophantie das logische Denken von KI prägen können—und warum verlässliche Schlussfolgerungen Tests erfordern, die über den ursprünglichen Prompt hinausgehen.
Große Sprachmodelle scheitern nicht zwangsläufig, weil ihnen die Fähigkeit zum Schlussfolgern fehlt. Sie scheitern oft, weil der Schlussfolgerungsprozess nicht ausreichend eingeschränkt, herausgefordert oder überprüft wird. Dieser Artikel stellt eine domänenunabhängige Methodik vor, die das Prompting in einen strukturierten epistemischen Prozess verwandelt: Fakten von Annahmen trennen, konkurrierende Hypothesen generieren, Gegenbeweise prüfen, Falsifikation anwenden und überprüfen, ob Schlussfolgerungen unter alternativen Rahmungen stabil bleiben. Das Ziel ist nicht, das Modell „weniger zustimmen“ zu lassen, sondern seine Schlussfolgerungen weniger abhängig von der ursprünglichen Rahmung des Nutzers zu machen.
Meistere die Kunst, präzise Akzeptanzkriterien zu definieren, um eine erfolgreiche LLM-Integration in Ihrer Unternehmensumgebung sicherzustellen. Dieser umfassende Leitfaden bietet umsetzbare Frameworks, Beispiele und Best Practices, die auf playbook-gesteuerte Adoption zugeschnitten sind.
Das Ausführen eines lokalen Modells mit Ollama ist einfach. Das Erstellen einer produktionsreifen Open-LLM-Anwendung ist schwieriger: Es erfordert RAG, Zugriffskontrolle, Anbieterabstraktion, Evaluierung, Protokollierung, Bereitstellungsdisziplin und eine kontrollierte Anwendungsschicht um das Modell herum.
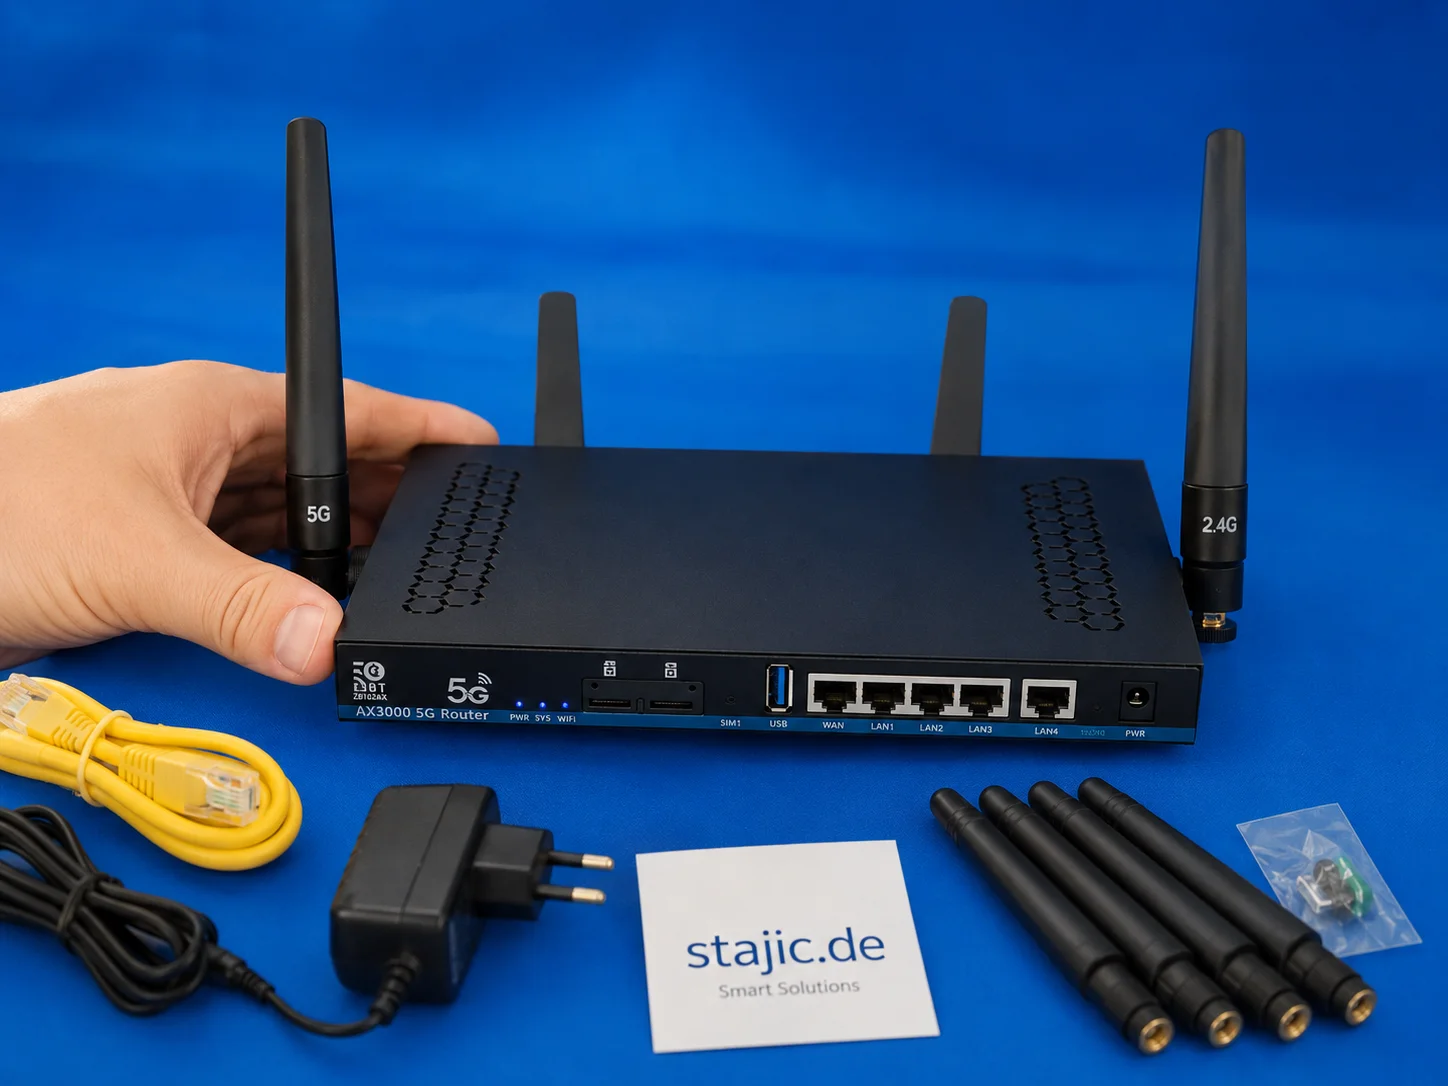
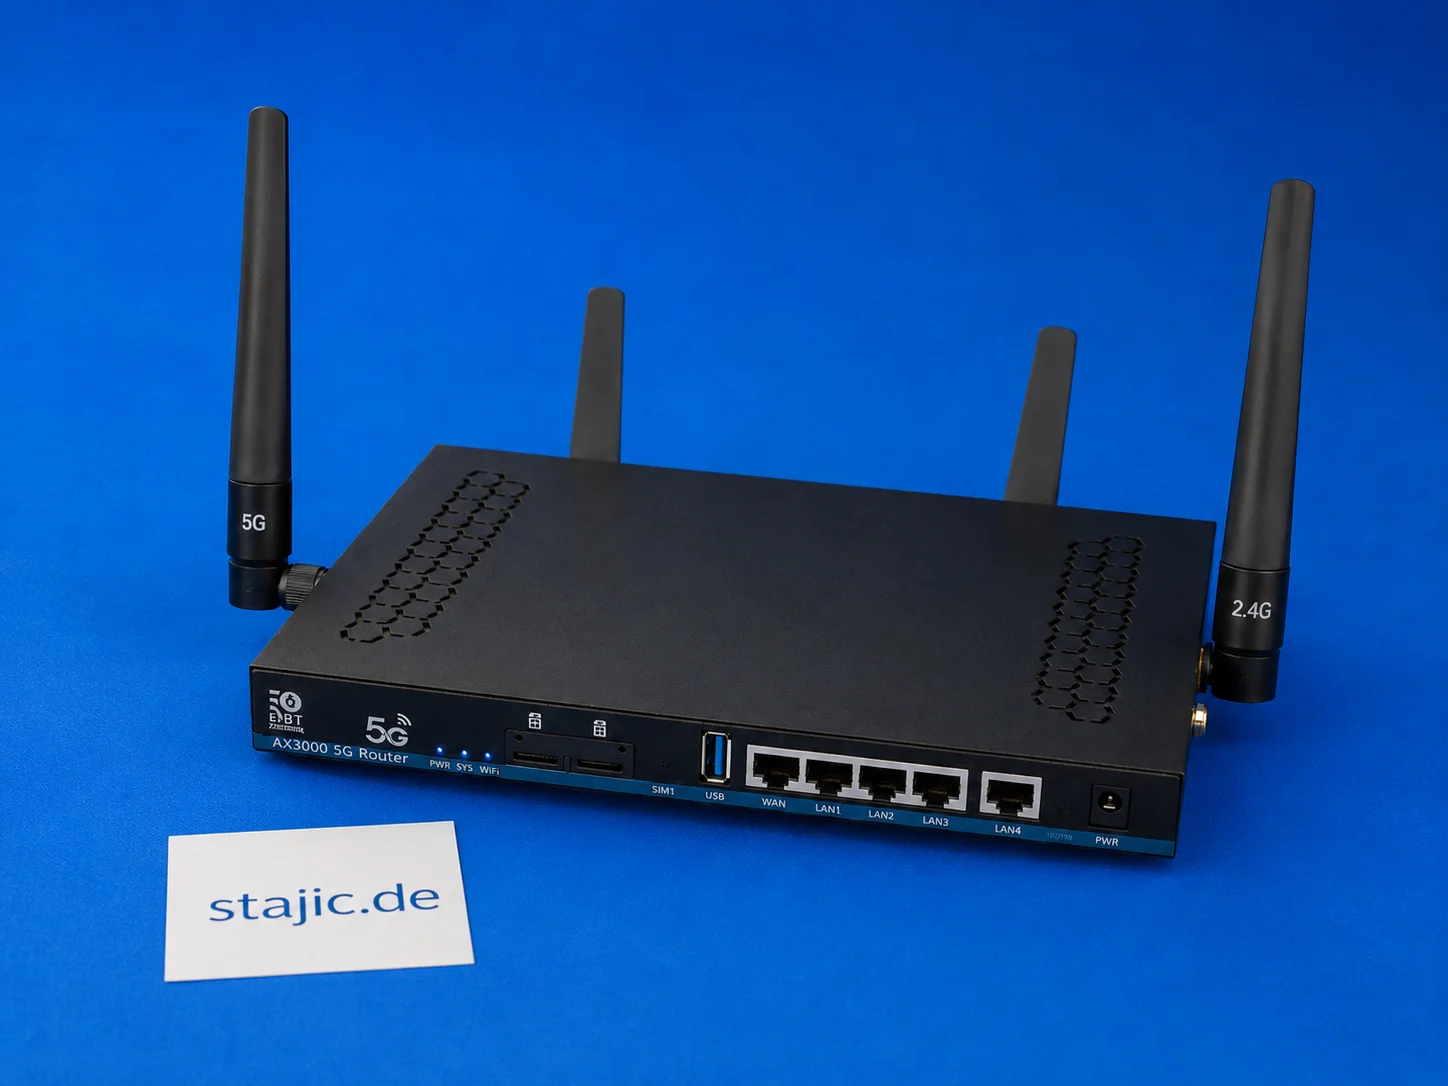
Der ZBT Z8102AX ist ein nützliches erstes Sample, aber der nächste Schritt sollte stärker sein: Wi-Fi 7, eine leistungsstärkere Vier-Kern-Plattform, mehr Klarheit bei der Firmware, eine verbesserte Verpackung und eine stabilere Preispolitik. Das Ziel ist nicht nur ein weiterer 5G-Router, sondern ein besser konfiguriertes, OpenWrt-basiertes Prosumer-Gerät.
Kauf eines 5G-OpenWrt-Routers mit älterer Firmware kann sinnvoll sein, aber nur unter den richtigen Bedingungen. Der ZBT Z8102AX zeigt beide Seiten deutlich: Die Hardware ist nützlich, das Modem funktioniert, und der Router blieb im Test stabil, aber OpenWrt 21.02, schwache Verpackung und unklare Upgrade-Pfade erfordern eine sorgfältige Kaufentscheidung.
Der ZBT Z8102AX ist ein Dual-SIM-5G-OpenWrt-Router, aber Dual-SIM-Hardware allein ist nicht dasselbe wie ein intelligentes Failover. Der Router erkennt die SIM und verbindet sich erfolgreich, aber die automatische Umschaltung, die Modem-Wiederherstellung, signalbasierte Entscheidungen und eine saubere Failover-Logik erfordern noch eingehendere Tests.