
Was ist RAG? Die einfachste Erklärung, wie es funktioniert
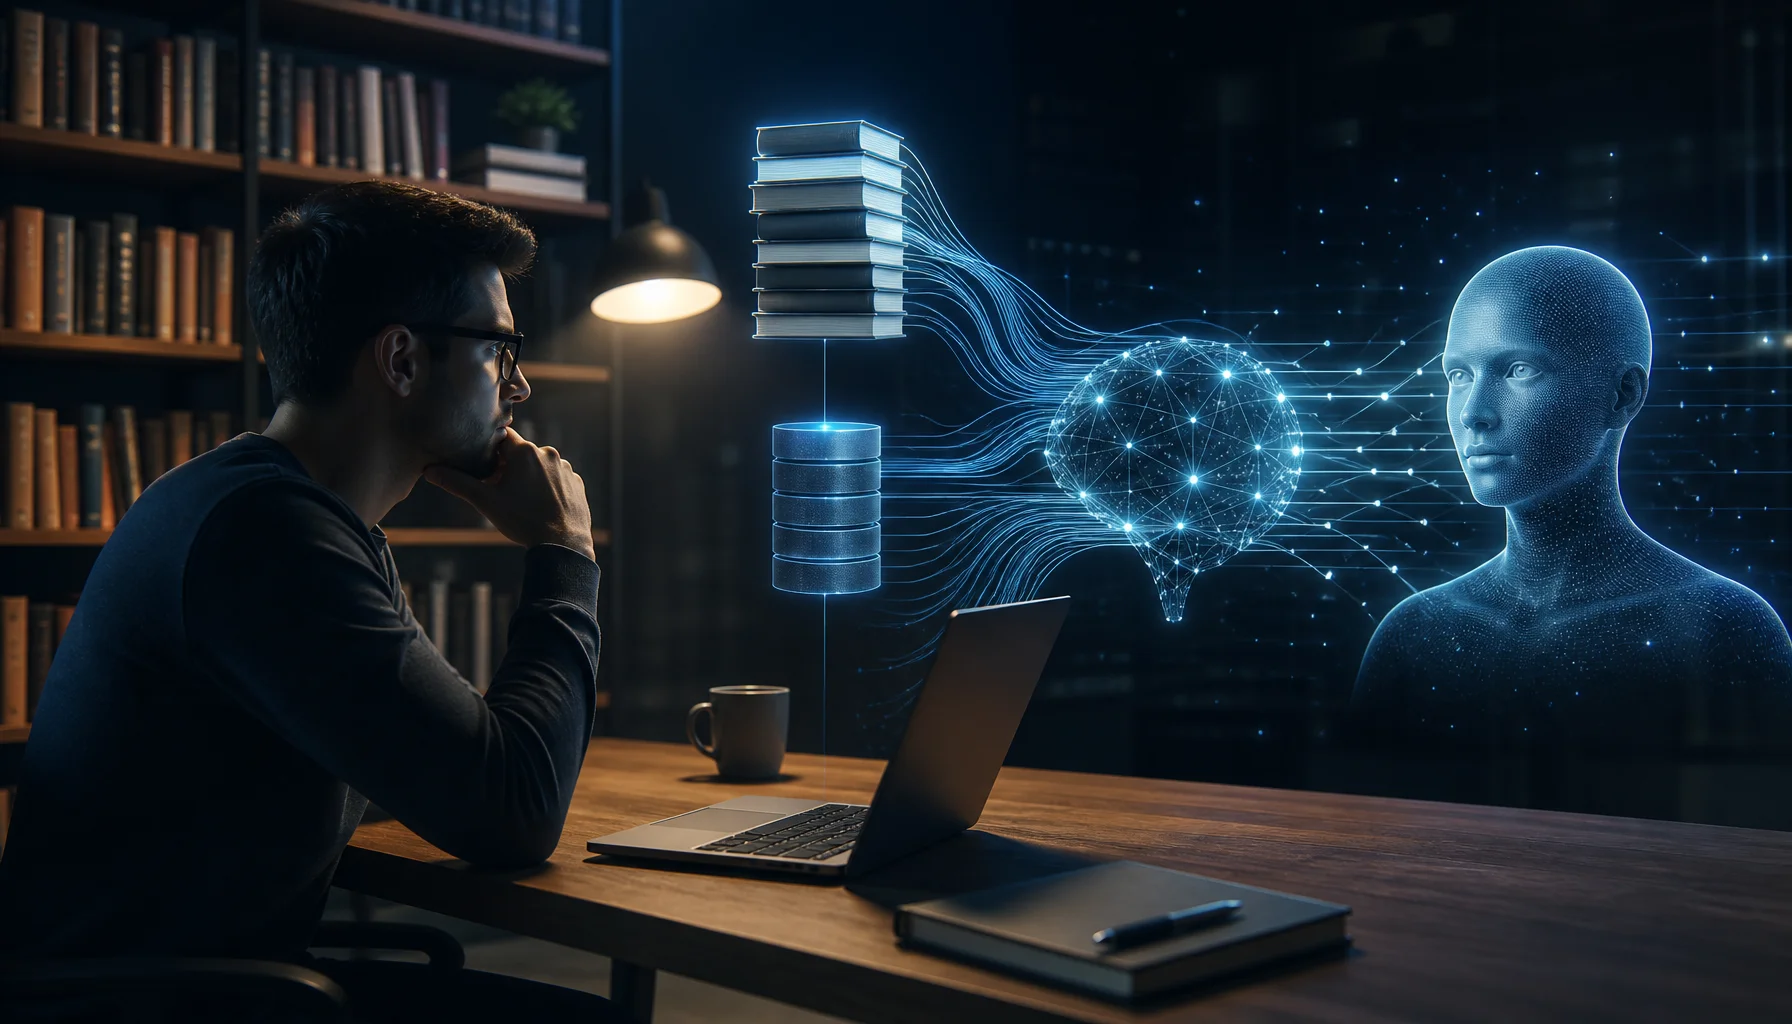
RAG klingt kompliziert, weil der Name kompliziert ist. Die Idee ist es nicht. RAG bedeutet einfach: Bevor die KI antwortet, sucht sie zuerst nach relevanten Informationen aus einer Wissensquelle und gibt diese Informationen an das Sprachmodell weiter.
Stellen Sie sich ein LLM wie eine kluge Person vor, die an einem Schreibtisch sitzt. RAG ist der Bibliothekar, der die richtige Seite aus dem richtigen Buch bringt. Das LLM liest dann diese Seite und antwortet Ihnen.
Zuerst: Was macht das LLM?
Das LLM ist der Teil, der Sprache versteht und Sprache erzeugt. Es kann Ihre Frage lesen, Anweisungen verstehen, Informationen vergleichen, etwas erklären und eine Antwort schreiben.
Aber das LLM weiß nicht automatisch, was sich gerade in Ihrer Unternehmensdatenbank, Ihrer Spielsitzung, Ihren privaten Dokumenten oder einer Datei befindet, die Sie vor fünf Minuten erstellt haben.
Es weiß nur, was bereits im Modell enthalten ist, plus alle Informationen, die die Anwendung ihm in der aktuellen Anfrage gibt.
Dann: Was ist die Wissensdatenbank?
Eine Wissensdatenbank ist einfach eine Information, die die Anwendung durchsuchen kann.
Sie könnte PDFs, Handbücher, Produktdokumentationen, Support-Artikel, Verträge, Spielregeln, Waffendaten, interne Unternehmensdokumente, Datenbankeinträge oder anderen Text enthalten.
Die Wissensdatenbank kann lokal auf Ihrem eigenen Rechner sein. Sie kann auf einem Server sein. Sie kann in einer Vektordatenbank sein. Sie kann auch aus normalen Dateien erstellt werden. RAG bedeutet nicht Internet.
Was macht RAG also tatsächlich?
Der gesamte RAG-Prozess
Das ist RAG.
Der vollständige Name ist Retrieval-Augmented Generation. Retrieval bedeutet, die relevanten Informationen zu finden. Augmented bedeutet, diese Informationen zum Kontext des Modells hinzuzufügen. Generation bedeutet, dass das LLM die endgültige Antwort schreibt.
Ein sehr einfaches Beispiel
Stellen Sie sich vor, Sie haben eine lokale Wissensdatenbank über ein Spiel.
| Wissensdatenbank enthält | Beispiel |
|---|---|
| Waffen | AKM verwendet 7,62-mm-Munition |
| Heilgegenstände | Med Kit stellt Gesundheit wieder her |
| Anbauteile | Dieses Anbauteil funktioniert mit diesen Waffen |
| Kartenregeln | Diese Zone verhält sich auf diese Weise |
Sie fragen: „Welche Munition verwendet die AKM?“
RAG durchsucht die Wissensdatenbank und findet den Eintrag über die AKM. Es gibt dieses kleine Stück Information an das LLM weiter. Das LLM antwortet dann: „Die AKM verwendet 7,62-mm-Munition.“
Das LLM brauchte nicht die gesamte Datenbank. RAG brachte nur den nützlichen Teil.
Nun der wichtige Teil: RAG ist nicht der aktuelle Zustand
Hier werden viele Erklärungen verwirrend.
RAG gibt der KI normalerweise Wissen. Ein Zustandssystem gibt der KI Fakten darüber, was gerade jetzt wahr ist.
Wissen vs. aktueller Zustand
| RAG / Wissen | Aktueller Zustand | |
|---|---|---|
| Waffe | ||
| Munition | ||
| Gesundheit | ||
| Gegner |
Was ist eine Zustandsdatenbank?
Eine Zustandsdatenbank oder ein Zustandsspeicher ist einfach ein Ort, an dem die Anwendung aktuelle Fakten aufbewahrt.
In einem Spiel kennt die Engine bereits Dinge wie Ihre Gesundheit, Position, Inventar, Munition, aktuelle Mission, nahe Objekte und Gegnerstatus. Ein KI-System kann ausgewählte Teile dieses Zustands dem Modell zugänglich machen.
In einer Geschäftsanwendung könnte dieselbe Idee eine Bestelldatenbank, ein Kundendatensatz, ein Projektstatus oder der aktuelle Wert eines Sensors sein.
Der Zustand wird von der Anwendung selbst erstellt, während Dinge geschehen. Wenn Sie Gesundheit verlieren, aktualisiert das Spiel den Gesundheitswert. Wenn Sie Munition aufnehmen, ändert sich das Inventar. Wenn eine Bestellung bezahlt wird, ändert das Geschäftssystem den Bestellstatus.
Wie die drei Teile zusammenwirken
LLM + Zustand + RAG
Die grundlegende Architektur ist also:
Verwendet RAG immer eine Vektordatenbank?
Nein.
Eine Vektordatenbank ist eine gängige Methode, um semantische Suche aufzubauen, aber sie ist nicht die Definition von RAG.
Der wichtige Teil ist das Abrufen: Das System findet relevante externe Informationen und fügt sie dem Kontext des LLM hinzu, bevor die Antwort generiert wird.
OpenAIs File Search kann beispielsweise mit Dateien arbeiten, die in Vektorspeichern abgelegt sind. Dateien werden in kleinere Stücke aufgeteilt, damit das System die Teile abrufen kann, die für eine Frage relevant sind. Das ist eine Umsetzung derselben Grundidee.
Was ist ein Embedding, einfach erklärt?
Du musst Embeddings nicht verstehen, um RAG zu verstehen.
Aber die einfache Version ist diese: Ein Embedding ist eine numerische Darstellung von Bedeutung. Es hilft einem Suchsystem, Text zu finden, der konzeptionell ähnlich ist, auch wenn die Wörter nicht genau dieselben sind.
Zum Beispiel sucht eine normale Stichwortsuche möglicherweise nach den genauen Wörtern „Autoreparatur“. Die semantische Suche kann auch verstehen, dass „repariere mein Fahrzeug“ ein ähnliches Thema betrifft.
Das macht Embeddings für RAG nützlich, aber RAG kann auch Stichwortsuche, Datenbankabfragen oder eine Mischung aus mehreren Methoden verwenden.
RAG ist auch kein Gedächtnis
Gedächtnis ist ein weiteres Konzept, das oft mit RAG vermischt wird.
Gedächtnis sind normalerweise Informationen, die das System über frühere Interaktionen oder frühere Ereignisse behält. RAG ist der Mechanismus, mit dem relevantes Wissen abgerufen wird, wenn es benötigt wird.
| Teil | Einfache Bedeutung |
|---|---|
| LLM | Der Teil, der Sprache versteht und generiert |
| RAG | Der Teil, der vor der Antwort relevantes Wissen nachschlägt |
| Wissensbasis | Die Informationen, die RAG durchsuchen kann |
| Zustand | Was gerade jetzt in der Anwendung oder Welt gilt |
| Gedächtnis | Informationen, die aus früheren Interaktionen oder Ereignissen behalten werden |
| Werkzeug / Aktion | Etwas, das die KI aufrufen oder die Anwendung bitten darf zu tun |
| Kontext | Die Informationen, die dem LLM für diese Anfrage gerade vorgelegt werden |
Ein echtes Spielbeispiel: PUBG Ally
PUBG Ally ist ein nützliches Beispiel, weil es den Unterschied sichtbar macht.
KRAFTON beschreibt den Live-Match-Zustand als separate Quelle der Wahrheit. Das Spiel gibt aktuelle Fakten über Beobachtungswerkzeuge preis: aktuelle Waffe, Munition, Gesundheit, Status der Sicherheitszone, Gegenstände in der Nähe und Kampfsituation.
Die Wissenssuche ist eine andere Aufgabe. Das System kann kuratiertes Wissen über Waffen, Aufsätze, Gegenstände und Regeln nutzen. Das ACE Game Agent SDK von NVIDIA bietet außerdem eine separate RAG-API zum Abrufen von Wissen aus von Entwicklern erstellten Datenbanken.
Das gibt uns die klare Trennung: Die Spiel-Engine sagt, was gerade passiert, der Abruf liefert relevantes Wissen, und das Sprachmodell entscheidet, was die Informationen bedeuten.
Ein vollständiges Beispiel
Stellen Sie sich vor, Sie sagen einem KI-Teamkollegen: „Ich habe wenig Gesundheit. Sollten wir angreifen?“
Was als Nächstes passiert
RAG hat die Figur nicht gesteuert. Die Zustandsdatenbank hat nicht geschlussfolgert. Das LLM hat das Spiel nicht direkt verändert. Jeder Teil hatte eine Aufgabe.
Warum überhaupt RAG verwenden?
Weil es langsam, teuer und oft verwirrend wäre, jedes Dokument, jede Regel und jeden Datenbankeintrag in jeden Prompt aufzunehmen.
RAG ermöglicht es dem System, nur die Informationen auszuwählen, die für die aktuelle Frage nützlich sind.
Es ermöglicht außerdem, die Wissensbasis zu aktualisieren, ohne das gesamte Sprachmodell neu zu trainieren. Ändern Sie das Dokument oder die Datenbank, bauen Sie den Index bei Bedarf neu auf oder aktualisieren Sie ihn, und der nächste Abruf kann die neueren Informationen verwenden.
Was RAG nicht garantiert
RAG kann die Fundierung verbessern, aber es macht eine Antwort nicht automatisch korrekt.
Der Abrufschritt kann das falsche Dokument finden. Das richtige Dokument kann veraltet sein. Das LLM kann gute Belege missverstehen. Oder der aktuelle Zustand kann sich geändert haben.
Ein zuverlässiges System muss daher den Abruf, die Aktualität des Zustands und die endgültige Schlussfolgerung des Modells getrennt validieren.
Das einfachste mentale Modell zum Merken
Stellen Sie sich ein KI-System wie eine Person an einem Schreibtisch vor
| Analogie | KI-System | |
|---|---|---|
| Denkende Person | ||
| Ein Nachschlagewerk finden | ||
| Bücher im Regal | ||
| Aktuelles Dashboard oder Instrumententafel | ||
| Notizen von früheren Besprechungen | ||
| Etwas in der realen Welt tun |
Fazit
RAG ist viel weniger mysteriös, sobald die Teile getrennt sind.
Das LLM versteht und erzeugt Sprache. Die Anwendung verwaltet den aktuellen Zustand. Die Wissensbasis speichert Informationen. RAG findet den nützlichen Teil dieser Informationen und fügt ihn in den Kontext des LLM ein. Werkzeuge oder die Anwendung führen reale Aktionen aus.
Das ist die grundlegende Architektur hinter vielen modernen KI-Assistenten und Agenten.
FAQ
RAG in einfachen Worten
Was ist RAG in einfachen Worten?
Braucht RAG das Internet?
Ist RAG dasselbe wie eine Datenbank?
Ist RAG dasselbe wie Gedächtnis?
Ist der aktuelle Anwendungszustand Teil von RAG?
Macht RAG KI-Antworten korrekt?
Glossar
Die grundlegenden Begriffe
- LLM
- Ein Sprachmodell, das Text versteht und erzeugt und über Informationen, die in seinen Kontext gestellt werden, schlussfolgern kann.
- RAG
- Retrieval-Augmented Generation: Abrufen relevanter externer Informationen und Hinzufügen zum Kontext des Modells, bevor eine Antwort generiert wird.
- Wissensbasis
- Die Dateien, Dokumente, Datensätze oder anderen Informationen, die der Abruf durchsuchen kann.
- Zustand
- Die aktuellen Fakten einer Anwendung, eines Systems oder der Welt zu einem bestimmten Zeitpunkt.
- Kontext
- Die Informationen, die dem Sprachmodell derzeit für eine Anfrage oder einen Schlussfolgerungsschritt bereitgestellt werden.
- Embedding
- Eine numerische Darstellung von Bedeutung, die der semantischen Suche helfen kann, konzeptionell ähnliche Informationen zu finden.
Primärquellen
OpenAI — Vector Store FilesOffizielle Dokumentation, die zeigt, wie Dateien an Vektorspeicher angehängt, in Chunks aufgeteilt und für den Dateisuche-Abruf verfügbar gemacht werden können.
OpenAI — Developer QuickstartOffizielle OpenAI-Dokumentation, die Werkzeuge wie die Dateisuche beschreibt, um Modellen Zugriff auf externe Informationen zu geben.
NVIDIA Developer — ACE for GamesOffizielle NVIDIA-Dokumentation, die separate Agent-, Chat- und RAG-APIs beschreibt, um Spielcharaktere mit Spielzustand, kontextuellem Wissen und modellgesteuerten Aktionen zu verbinden.
NVIDIA Developer — How KRAFTON Built PUBG AllyOffizielle technische Erklärung, die den Live-Match-Zustand von der Wissenssuche und der Schlussfolgerung des Sprachmodells trennt.
Related Articles
Wahrheitsquelle in KI-Systemen: Woher verlässliches Wissen tatsächlich stammt
Eine Quelle der Wahrheit definiert, welche Quelle für einen bestimmten Fakt oder Zustand maßgeblich ist. Erfahren Sie, wie sie sich von RAG, Provenienz, Gedächtnis, Kontext, Vektordatenbanken und Systemen of Record unterscheidet.
Was sollte ein KI-Agent behalten, vergessen, neu berechnen oder erneut abrufen?
Langlaufende Agenten sollten sich nicht alles merken. Dieser Artikel bietet ein praktisches Lebenszyklusmodell für die Entscheidung, was in den dauerhaften Speicher gehört, was erneut abgerufen werden sollte, was sicherer neu zu berechnen ist und was ablaufen oder ersetzt werden sollte.
Was ist ein KI-Lösungsarchitekt? Systemgrenzen, Verantwortlichkeiten und Kompromisse
Ein KI-Lösungsarchitekt verwandelt Geschäftsanforderungen in ein produktionsreifes KI-System über Daten, Modelle, Tools, Sicherheit, Laufzeit, Evaluierung und Betrieb hinweg.
RAG fehlgeschlagen – aber welche Ebene ist tatsächlich fehlgeschlagen? Eine diagnostische Methode
Wenn eine RAG-Antwort falsch ist, ist es zu vage, das Retrieval oder das Modell verantwortlich zu machen. Diese Diagnosemethode isoliert Quellenabdeckung, Query-Konstruktion, Retrieval, Ranking, Kontextzusammenstellung, Generierung, Evidenzzuordnung und Aktualität – sodass der tatsächliche Fehler reproduziert und behoben werden kann.
MCP vs A2A vs UCP vs AP2 vs A2UI: Der Agenten-Protokoll-Stack erklärt
MCP, A2A, UCP, AP2 und A2UI werden oft als konkurrierende Agentenstandards dargestellt. Sie lösen größtenteils unterschiedliche Interoperabilitätsprobleme. Dieser Leitfaden ordnet jedes Protokoll der Grenze zu, die es tatsächlich standardisiert—und zeigt, wie sie in einem Produktionssystem zusammenarbeiten können.
Meistern des SEO-Workflows: Essenzielle Optimierungsstrategien für organisches Wachstum
Ein strukturierter SEO-Workflow ist entscheidend für nachhaltiges organisches Wachstum. Lerne die zehn grundlegenden Strategien, von der Keyword-Recherche und technischen Optimierung bis hin zur Content-Qualität und Performance-Analyse.
Git with automatic upload and synchronization to a production server
Agentische KI erklärt: Wenn ein KI-System planen, Werkzeuge nutzen und handeln kann
Agentische KI verwendet Modelle innerhalb mehrstufiger Ausführungsschleifen, in denen sie Werkzeuge auswählen, Ergebnisse beobachten, den Zustand aktualisieren und ihre nächste Aktion innerhalb expliziter Laufzeit- und Berechtigungsgrenzen anpassen können.
Enterprise-KI-Architektur: Was ändert sich, wenn KI in ein Unternehmen eintritt
Enterprise-KI-Architektur erklärt, wie KI Unternehmenssysteme über Datenhoheit, Identität, Berechtigungen, Anbieter, Risiko, Governance, Evaluierung, Compliance und Betrieb hinweg verändert.
Was ist ein KI-Plattform-Architekt? Modelle, Daten, Laufzeitumgebung, Sicherheit und Betrieb
Ein KI-Plattform-Architekt entwirft wiederverwendbare KI-Grundlagen über Modelle, Anbieter, Retrieval, Agenten, Identität, Sicherheit, Evaluierung, Observability und Betrieb hinweg.
RBAC vs. Mandantenisolierung: Zwei unterschiedliche Sicherheitsgrenzen
RBAC steuert, was ein Benutzer tun darf; Mandantenisolierung steuert, auf welche Ressourcen eines Mandanten diese Aktion zugreifen darf. Erfahren Sie, warum die Sicherheit von Multi-Tenant-SaaS beide Grenzen erfordert.
Warum mehr Kontext KI-Antworten verschlechtern kann
Ein größeres Kontextfenster garantiert keine bessere Antwort. Dieser Artikel erklärt, wie Signalverwässerung, widersprüchliche Belege, veralteter Zustand, Positionssensitivität und verlustbehaftete Kompression die KI-Zuverlässigkeit verringern können—und stellt einen praktischen Context Pressure Test vor.