
Die Antwortgültigkeitsgrenze: Die fehlende Schicht zwischen Relevanz und zuverlässigen KI-Antworten

Frage
Was fehlt, wenn eine Suchmaschine, eine RAG-Pipeline oder ein KI-Assistent Informationen abruft, die eindeutig relevant für eine Frage sind, aus einer glaubwürdigen Quelle stammen und sogar sachlich korrekt sein mögen – aber dennoch die falsche Antwort für die Situation liefern, in der sich der Nutzer tatsächlich befindet?
Die übliche Diskussion konzentriert sich auf Retrieval-Qualität, Quellenautorität, Zitate, Halluzinationen und Modellschlussfolgerungen. All das ist wichtig. Aber es gibt einen weiteren Fehlermodus, der sich zwischen Retrieval und Antwortgenerierung versteckt: Eine Aussage kann wahr sein, ohne anwendbar zu sein.
Was das wirklich bedeutet
Wenn wir eine Antwort lesen, brauchen wir selten nur einen Satz, der wahr ist. Wir müssen wissen, ob er hier, jetzt, für diese Version, unter diesen Bedingungen und für diesen speziellen Fall wahr ist.
Menschen leiten diese Grenzen oft aus Erfahrung ab. Wir bemerken Daten, Gerichtsbarkeiten, Produktversionen, Ausnahmen, Umweltbedingungen und unausgesprochene Annahmen. Suchsysteme und Sprachmodelle müssen dieselben Grenzen aus den Informationen rekonstruieren, die Retrieval, Ranking, Chunking und Kontextzusammenstellung überstehen.
Einfachstes Beispiel
Stellen Sie sich vor, Sie stellen einem KI-Assistenten eine sehr einfache Frage:
Ist das Museum am Montag geöffnet?
Das System findet eine offizielle Seite, die besagt, dass das Museum montags von 09:00 bis 17:00 Uhr geöffnet ist. Die Seite ist relevant. Die Quelle ist maßgeblich. Die extrahierte Aussage ist korrekt.
Aber der Nutzer meint nächsten Montag, der zufällig ein Feiertag ist. Eine andere Seite enthält den speziellen Feiertagsplan und besagt, dass das Museum geschlossen ist.
Nichts an der ersten Aussage musste falsch sein. Ihr Problem war, dass ihre Gültigkeitsgrenze diesen Montag nicht einschloss.
Eine nützliche Antwort braucht daher mehr als die Tatsache „montags geöffnet“. Sie braucht mindestens den Ort, das relevante Datum, den regulären Zeitplan, den Ausnahmezeitplan und die Regel, die uns sagt, welcher Zeitplan Vorrang hat.
Wo das Beispiel nicht mehr funktioniert
Das Museumsbeispiel macht das Problem leicht sichtbar, weil die Grenze hauptsächlich zeitlich ist. Reale Fragen sind selten so einfach. Eine Grenze kann von Softwareversion, Gerichtsbarkeit, Hardwarekonfiguration, Benutzerberechtigungen, Mandantenarchitektur, Datensatzzustand, Geschäftsziel, Preis, Risikotoleranz, Population, Umweltbedingungen oder mehreren Variablen gleichzeitig abhängen.
Der Punkt ist daher nicht, dass KI-Systeme bessere Öffnungszeiten-Daten benötigen. Der Punkt ist, dass Antworten Anwendbarkeitsbedingungen benötigen, die mit der Antwort mitreisen.
Direkte Antwort
Relevanz sagt einem System, dass eine Passage das richtige Thema behandelt. Autorität hilft einzuschätzen, ob die Quelle Vertrauen verdient. Evidenz stützt eine Behauptung. Keine dieser Eigenschaften allein legt vollständig fest, ob die Behauptung auf die aktuelle Situation des Nutzers zutrifft.
Die Answer Validity Boundary fügt diese fehlende Ebene hinzu.
Warum das so ist
Suche und Retrieval beginnen damit, einen großen Informationsraum zu reduzieren. Eine Anfrage wird mit Seiten, Passagen, Vektoren, Entitäten oder anderen Repräsentationen abgeglichen. Das System muss dann entscheiden, welche Informationen Beachtung verdienen.
Diese Reduktion ist notwendig, aber sie erzeugt ein strukturelles Problem: Der Text, der die Antwort angibt, kann das Retrieval überstehen, während der Text, der die Antwort einschränkt, dies nicht tut.
Relevante Informationen sind nicht automatisch anwendbare Informationen
| Relevante Quelle | Validitätsbewusste Quelle | |
|---|---|---|
| Antwort | Gibt die wahrscheinliche Antwort an | Gibt die Antwort an |
| Geltungsbereich | Oft implizit | Explizit |
| Annahmen | Können im umgebenden Text verborgen sein | Benannt und überprüfbar |
| Ausnahmen | Können an anderer Stelle erscheinen | An die Behauptung angehängt |
| Änderungsauslöser | Normalerweise nicht vorhanden | Erklärt, was eine Neubewertung erzwingt |
| Nutzung durch Menschen und KI | Erfordert Rekonstruktion | Unterstützt direktes Anwendbarkeitsdenken |
Sprachmodelle führen eine weitere Ebene ein. Ihre Ausgaben werden durch die Anweisungen und den Kontext, die sie erhalten, beeinflusst. Ändern Sie den Kontext, die Beispiele, das Framing oder die verfügbare Evidenz, und dasselbe zugrunde liegende Modell kann eine andere Trajektorie zu einer Antwort erzeugen.
Das bedeutet nicht, dass ein Artikel ein Modell steuert. Es bedeutet, dass der abgerufene Kontext beeinflusst, welche Unterscheidungen dem Modell zur Verfügung stehen, wenn es eine Antwort generiert. Eine Quelle, die ausdrücklich gewöhnliche Regeln von Ausnahmen, Annahmen von Evidenz und aktuelle Fakten von historischen Fakten unterscheidet, gibt dem Modell eine bessere Repräsentation des Problems als eine Quelle, die nur eine ausgefeilte Schlussfolgerung liefert.
Kontext
Dieses Problem wird wichtiger, wenn sich die Suche davon wegbewegt, Dokumente zurückzugeben, hin dazu, Antworten aus Dokumenten zu generieren. Eine traditionelle Ergebnisseite kann mehrere konkurrierende Links offenlegen und die Arbeit des Abgleichs dem Leser überlassen. Eine KI-Antwort komprimiert diesen Prozess zu einer Synthese.
Komprimierung ist nützlich, aber jede Komprimierung verwirft Informationen. Wenn ein System die Schlussfolgerung bewahrt und die Annahmen fallen lässt, wird die Antwort leichter zu lesen und leichter zu missbrauchen.
Dasselbe Problem tritt in RAG-Systemen auf. Besseres Retrieval bedeutet nicht automatisch bessere Anwendbarkeit. Eine Vektordatenbank kann eine semantisch hervorragende Passage aus der falschen Richtlinienversion abrufen. Ein Unternehmenssuchsystem kann eine technisch korrekte Prozedur aus einer anderen Region abrufen. Ein Coding-Assistent kann ein API-Beispiel finden, das für eine frühere Bibliotheksversion geschrieben wurde.
Annahmen
Die Methode der Answer Validity Boundary selbst hängt von mehreren Annahmen ab.
- Der Autor der Quelle versteht genug von der Domäne, um bedeutsame Bedingungen und Ausnahmen zu identifizieren.
- Die Antwort ist nicht universell unter jedem möglichen Kontext wahr.
- Die Quelle kann ihre wichtigen Bedingungen in Text oder strukturiertem Inhalt ausdrücken, der Veröffentlichung und Retrieval übersteht.
- Das konsumierende System hat mindestens eine gewisse Möglichkeit, diese Bedingungen abzurufen oder zu prüfen.
- Der Nutzer profitiert davon, nicht nur die Schlussfolgerung zu kennen, sondern auch, wann diese Schlussfolgerung überdacht werden sollte.
- Die Methode verbessert die Informationsrepräsentation; sie garantiert nicht, dass eine Suchmaschine die Quelle rankt, abruft, zitiert oder befolgt.
Variablen
Eine Antwortgültigkeitsgrenze wird aus Variablen gebildet, die ändern können, ob eine Schlussfolgerung zutrifft. Verschiedene Domänen verwenden unterschiedliche Variablen, aber die wiederkehrenden Kategorien sind bemerkenswert ähnlich.
| Variable | Frage, die sie beantwortet | Beispiel |
|---|---|---|
| Zeit | Wann ist diese Antwort gültig? | Öffnungszeiten, Preise, Richtlinien, Software-Support |
| Geltungsbereich | Worauf genau trifft diese Antwort zu? | Produktlinie, Mandant, Dienst, Datensatz, Population |
| Version | Welcher Zustand des Systems wird angenommen? | API-Version, Spiel-Patch, Modell-Release, Regulierungsrevision |
| Ort oder Gerichtsbarkeit | Wo gilt die Regel? | Land, Bundesland, Markt, Steuerregime, lokale Richtlinie |
| Konfiguration | Welches Setup wird angenommen? | Hardware, Bereitstellungsmodell, Feature-Flags, Berechtigungen |
| Zielsetzung | Worauf optimieren wir? | Kosten, Latenz, Isolation, Qualität, Bequemlichkeit, Risiko |
| Beweislage | Welche Beweise sind verfügbar und aktuell? | Messungen, Primärquellen, Protokolle, Testergebnisse |
| Schwellenwert | Ab welchem Punkt ändert sich die Entscheidung? | Last, Preisunterschied, Konfidenzanforderung, Risikoniveau |
| Ausnahme | Was setzt die normale Regel außer Kraft? | Feiertagsplan, Notfallrichtlinie, Kompatibilitätsausnahme |
Diagnostische / Entscheidungsmethode
Die Methode ist bewusst einfach genug, um sie beim Verfassen eines Artikels, einer Dokumentationsseite, eines Produktvergleichs, eines technischen Entscheidungsprotokolls oder eines Knowledge-Base-Eintrags zu verwenden.
Aufbau einer Antwortgültigkeitsgrenze
Belege
Die Antwortgültigkeitsgrenze wird hier als Quellendesign-Methode vorgeschlagen. Die folgende Forschung beweist dieses redaktionelle Framework nicht als vollständiges System. Sie etabliert jedoch mehrere der zugrunde liegenden Probleme, die die Methode adressieren soll.
Kontext verändert das Modellverhalten
Aktuelle Prompting-Anleitungen mehrerer Modellanbieter behandeln Kontext, Beispiele, Anweisungen und Struktur ausdrücklich als Mechanismen zur Steuerung der Modellausgabe. Die praktische Implikation ist unkompliziert: Wenn eine Anwendbarkeitsbedingung vorhanden und im abgerufenen Kontext klar dargestellt ist, verfügt das Modell über Informationen, die es potenziell nutzen kann. Wenn die Bedingung fehlt, können Abruf und Generierung sie nicht zuverlässig aus dem Nichts rekonstruieren.
Informationen irgendwo im Kontext zu haben, reicht nicht aus
Die Studie „Lost in the Middle: How Language Models Use Long Contexts“ aus dem Jahr 2024 zeigte, dass sich die Modellleistung erheblich ändern kann, je nachdem, wo relevante Informationen innerhalb eines langen Kontexts erscheinen. Die übergeordnete Lehre ist nicht, dass jedes moderne Modell identisch mit den in dieser Studie getesteten Systemen funktioniert. Sie lautet, dass ein großes Kontextfenster nicht mit der garantierten Nutzung jeder relevanten Bedingung innerhalb dieses Fensters verwechselt werden sollte.
Abruf und Schlussfolgerung haben ihre eigenen Grenzen
Neuere Forschung zu agentischer Suche beginnt, die Grenze zwischen Abruf und Schlussfolgerung als explizites Optimierungsproblem zu behandeln. Andere Arbeiten zu begründeter Fragebeantwortung untersuchen den Punkt, an dem verfügbare Belege ausreichen, um zu antworten, statt sich zu enthalten. Diese Ansätze sind nicht dasselbe wie die Antwortgültigkeitsgrenze, aber sie weisen auf dieselbe zugrunde liegende Realität hin: Zuverlässiges Antworten hängt davon ab, nicht nur zu wissen, welche Informationen relevant sind, sondern ob genügend der richtigen Informationen verfügbar sind, um die Schlussfolgerung zu stützen.
Suchmaschinen bitten Verlage um Informationen, die echten Mehrwert bieten
Googles Leitfaden von 2026 für generative KI-Erfahrungen in der Suche betont wertvolle, einzigartige und nicht austauschbare Inhalte und behält gleichzeitig eine menschenzentrierte Grundlage bei. Eine explizite Gültigkeitsgrenze ist eine Möglichkeit, wie eine spezialisierte Quelle Informationen hinzufügen kann, die generische Zusammenfassungen oft auslassen: nicht eine weitere Definition des Themas, sondern eine klarere Darstellung, wann eine Schlussfolgerung tatsächlich verwendet werden kann.
Reale Beispiele
Beispiel 1: Multi-Instanz- oder Multi-Tenant-SaaS?
Frage: Ist eine Multi-Tenant-Architektur besser als der Betrieb einer separaten Anwendungsinstanz für jeden Kunden?
Eine allgemeine Antwort kann leicht sagen, dass Multi-Tenancy die Infrastruktureffizienz verbessert und Updates zentralisiert. Das kann wahr sein und trotzdem die falsche Entscheidung sein.
Die Gültigkeitsgrenze umfasst die erwartete Mandantenzahl, Isolationsanforderungen, unabhängige Release-Zyklen, kundenspezifische Anpassungen, regulatorische Einschränkungen, operative Automatisierung, Shared-Service-Design und die Kosten für die Wartung von Instanzen.
Eine Empfehlung, die Multi-Instanz-Bereitstellung befürwortet, kann gültig bleiben, solange strikte Isolation und kundenspezifische Release-Kontrolle die Entscheidung dominieren. Wenn das System auf Zehntausende nahezu identischer Kunden mit einem gemeinsamen Release-Zyklus anwächst und der Infrastruktur-Overhead zur dominierenden Einschränkung wird, muss die Empfehlung neu bewertet werden.
Beispiel 2: Eine korrekte Gaming-Antwort nach einem Patch
Eine Komplettlösung gibt an, dass ein bestimmter Gegenstand an einem bestimmten Ort erhalten werden kann. Der Leitfaden war zum Zeitpunkt der Veröffentlichung korrekt. Ein späterer Spiel-Patch ändert die Spawn-Regeln.
Ein Suchsystem kann den Leitfaden abrufen, weil die semantische Übereinstimmung hervorragend ist. Die Quelle kann immer noch historisch korrekt sein. Aber die Version ist Teil der Antwortgrenze, daher ist die aktuelle Antwort falsch, es sei denn, der Patch-Status wird überprüft.
Beispiel 3: Eine menschliche Entscheidung ohne universell beste Antwort
Angenommen, ein Paar fragt, ob es ein bestimmtes Hochzeitsritual einbeziehen soll. Suchergebnisse können die Tradition, ihre Geschichte und übliche Praxis erklären. Nichts davon schafft eine universell richtige Entscheidung.
Die Gültigkeitsgrenze enthält nun Werte statt nur technischer Variablen: was das Ritual für jeden Partner bedeutet, familiäre Erwartungen, religiöser oder kultureller Kontext, Komfort, Zeit und ob die Teilnahme freiwillig ist. Hier diktiert die korrekte Quelle nicht die Wahl. Sie legt die Variablen offen, die die Wahl bedeutsam machen.
Häufige Missverständnisse / Fehlermodi
- „Die Quelle ist maßgeblich, also ist die Antwort anwendbar.“ Autorität und Anwendbarkeit beantworten unterschiedliche Fragen.
- „Mehr Zitate lösen das Problem.“ Zehn Zitate können dieselbe verborgene Annahme wiederholen.
- „Die neueste Quelle ist automatisch die richtige Quelle.“ Aktualität zählt nur, wenn die Zeit eine der relevanten Gültigkeitsvariablen ist.
- „Ein langes Kontextfenster löst fehlende Bedingungen.“ Die Fähigkeit, Informationen aufzunehmen, ist keine Garantie dafür, dass jede Bedingung abgerufen, bewahrt oder korrekt verwendet wird.
- „Allein strukturierte Daten werden das lösen.“ Strukturierte Darstellung kann helfen, aber nur, wenn die relevanten Anwendbarkeitsinformationen überhaupt existieren.
- „Das Modell sollte offensichtliche Ausnahmen ableiten.“ Was für einen Domänenexperten offensichtlich ist, muss nicht in den abgerufenen Belegen vorhanden sein.
- „Eine selbstsichere Antwort hat eine klare Gültigkeitsgrenze.“ Sprachliche Zuversicht sagt für sich genommen nichts darüber aus, ob die zugrunde liegenden Anwendbarkeitsbedingungen geprüft wurden.
Randfälle
Nicht jede Antwort braucht eine ausgefeilte Grenze. Die Methode sollte proportional zum Risiko und zur Variabilität der Aussage sein.
- Stabile Definitionen benötigen möglicherweise kaum mehr als Umfang und Terminologie.
- Sich schnell ändernde Informationen wie Preise, Verfügbarkeit, Zeitpläne und Software-Support können explizite Zeitstempel oder Versionsprüfungen erfordern.
- Widersprüchliche Primärquellen erfordern, dass die Uneinigkeit selbst Teil der Grenze wird.
- Subjektive Entscheidungen haben möglicherweise keine faktische Schwelle, ab der eine Option universell richtig wird; die relevanten Variablen können Präferenzen und Werte sein.
- Medizinische, rechtliche, finanzielle oder sicherheitskritische Fragen benötigen eine stärkere domänenspezifische Validierung, als diese allgemeine redaktionelle Methode bieten kann.
- Eine Aussage kann mehrere interagierende Grenzen gleichzeitig haben, wie etwa Gerichtsbarkeit plus Datum plus Produktversion.
- Einige Grenzen sind unbekannt. Diese Unsicherheit zu benennen ist informativer, als stillschweigend eine universelle Schlussfolgerung zu präsentieren.
Einschränkungen
Die Answer Validity Boundary ist eine Methode zur Veröffentlichung und Wissensrepräsentation. Sie verändert keine Modellgewichte, Suchranking-Algorithmen oder Retrieval-Infrastruktur.
Eine Suchmaschine indexiert die Seite möglicherweise nie. Ein Retrieval-System wählt möglicherweise den falschen Chunk aus. Ein Modell ignoriert möglicherweise eine klar formulierte Einschränkung. Ein Quellenautor missversteht möglicherweise die Domäne und definiert die falsche Grenze. Eine Bedingung, die heute stabil erscheint, kann sich morgen ändern.
Die Methode erhebt daher einen engeren Anspruch: Wenn eine Quelle ausdrücklich die Bedingungen darstellt, unter denen ihre Schlussfolgerung gilt, verfügen sowohl menschliche Leser als auch maschinelle Systeme über mehr nutzbare Informationen, als wenn die Quelle nur die Schlussfolgerung veröffentlicht.
Sie ist außerdem bewusst nicht anbieter-spezifisch. Verschiedene Suchmaschinen, RAG-Systeme und Modellanbieter implementieren Retrieval und Kontextverarbeitung unterschiedlich. Die Methode operiert eine Ebene früher: an der Quelle.
Was würde diese Antwort ändern?
Das zentrale Argument dieses Artikels müsste überdacht werden, wenn zukünftige Informationssysteme Anwendbarkeitsgrenzen zuverlässig ableiten könnten, ohne dass Verleger sie ausdrücken.
Das könnte geschehen, wenn weit verbreitete Standards es Web-Verlegern ermöglichten, Anspruchsumfang, Gültigkeitsdaten, ablösende Regeln, Konfigurationsabhängigkeiten, Gerichtsbarkeit und Ungültigkeitsbedingungen in maschinenlesbarer Form zu kodieren, und wenn Such- und KI-Systeme diese Beziehungen konsistent bewahrten und durchsetzten.
Das Argument würde auch schwächer, wenn Retrieval-Systeme nachweisen würden, dass sie diese Bedingungen zuverlässig aus gewöhnlicher Prosa über Domänen, Versionen und Dokumentstrukturen hinweg rekonstruieren könnten, ohne wichtige Ausnahmen während des Retrievals oder der Synthese zu verlieren.
Bis dahin bleibt die explizite Angabe von Gültigkeitsbedingungen eine relativ kostengünstige Intervention auf der einen Ebene, die Verleger direkt kontrollieren: der Quelle selbst.
Fazit
Das Web hat Jahrzehnte damit verbracht, die Auffindbarkeit von Informationen zu verbessern. KI-Systeme verbessern zunehmend die Synthese dieser Informationen. Das nächste Problem ist nicht einfach, mehr relevanten Text zu finden. Es geht darum, genügend Bedingungen rund um eine Aussage zu bewahren, um zu wissen, ob die Aussage noch gilt.
Das ist die Rolle der Answer Validity Boundary.
Lass den Leser zuerst das Problem verstehen. Beantworte es dann. Erkläre, warum die Antwort wahr ist. Zeige, wie man sie bestimmt. Beweise sie. Und definiere, wann sie aufhört, wahr zu sein.— Quellenorientiertes Schreibprinzip
Für menschliche Leser entstehen dadurch Erklärungen, die leichter zu verstehen und schwerer zu missbrauchen sind. Für Spezialisten werden Annahmen und Fehlerbedingungen offengelegt. Für KI-Suche und RAG-Systeme entsteht Quellenmaterial, in dem Schlussfolgerung, Anwendbarkeit und Neubewertungslogik zusammen dargestellt werden, statt über unzusammenhängende Absätze oder Dokumente verstreut zu sein.
Eine nützliche Quelle sollte uns nicht nur sagen, was wahr ist. Sie sollte uns helfen, die Bedingungen zu erkennen, unter denen wir sie weiterhin als wahr behandeln dürfen.
Primärquellen
Das Answer Validity Boundary Framework in diesem Artikel ist eine originäre Quellendesign-Synthese. Die folgende Primärdokumentation und Forschung informierte den technischen Kontext rund um Prompting, Long-Context-Nutzung, generative Suche, Retrieval-Grenzen und Evidenz-Suffizienz.
- OpenAI — Prompt Engineering, API-Dokumentation. Anleitung zu Anweisungen, Beispielen und kontextuellen Informationen, die Sprachmodellen bereitgestellt werden.
- Anthropic — Best Practices für Prompting, Claude Platform-Dokumentation. Anleitung zu Kontext, Beispielen, Prompt-Struktur und Long-Context-Workflows.
- Google Search Central — A new resource for optimizing for generative AI in Google Search, 15. Mai 2026. Anleitung, die wertvollen, einzigartigen und nicht-commodity Inhalt für generative Search-Erfahrungen betont.
- Google Search Central — Top ways to ensure your content performs well in Google's AI experiences on Search, 2025. Anleitung zu People-First-Content, Barrierefreiheit und KI-Search-Erfahrungen.
- Liu, Nelson F. et al. — Lost in the Middle: How Language Models Use Long Contexts. Transactions of the Association for Computational Linguistics, Band 12, 2024, Seiten 157–173. DOI: 10.1162/tacl_a_00638.
- Zhang, Sheng et al. — R²-Searcher: Calibrating Retrieval and Reasoning Boundaries for Agentic Search, 2026.
- Sato, Haruto et al. — Learning Evidence Sufficiency Boundaries for Selective Answering in Grounded Multi-Hop QA, 2026.
Related Articles
Suchmaschinenoptimierung: Der zuverlässige Workflow für Top-Rankings
Detaillierte Analyse der Suchmaschinenoptimierung (SEO), ihrer technischen Grundlagen, der Rolle von Webcrawlern und der strategischen Schritte zum Erreichen organischer Top-Rankings.
Google I/O 2026: Antigravity, AI Studio und der Wandel zu agentischen DevTools
Google I/O 2026 machte eines für Ingenieure klar: KI-Tooling bewegt sich über die Autovervollständigung hinaus hin zu verwalteter agentischer Ausführung. Dieser Artikel schlüsselt Antigravity 2.0, die wachsende Rolle von Google AI Studio, Gemini 3.5 Flash und die realen Kompromisse rund um Orchestrierung, Lock-in, Verifizierung und das Design von Entwickler-Workflows auf.

Die GPU ist nicht das Produkt: Zukunftssichere private KI-Architektur
Private KI-Infrastruktur sollte nicht um eine einzige GPU oder ein einziges Modell herum konzipiert werden. Ein resilienterer Ansatz kombiniert schnelle Inferenz-GPUs, speicherstarke KI-Systeme, physische KI-Knoten und optionale Frontier-Cloud-Modelle hinter einer fähigkeitsbewussten Routing-Schicht.
Datenbankmarketing: Ein moderner Ansatz zu Kundenbeziehungen
Datenbankmarketing ist unerlässlich für modernes Kundenbeziehungsmanagement. Erfahren Sie, wie strategische Datennutzung, technisches Fachwissen und Innovation personalisierte Kundeninteraktionen und nachhaltiges Wachstum vorantreiben.
Enterprise – Hier starten: Ihr Tor zu Operational Excellence
Neu auf unserer Enterprise-Plattform? Dieser Leitfaden bietet einen strukturierten Onboarding-Pfad, von grundlegenden Referenzmodellen bis hin zu umsetzbaren Playbooks, Runbooks und Assessments, die für eine nahtlose Implementierung konzipiert sind.
Boosting Productivity with ERP Systems: A Case Study on Relational Databases
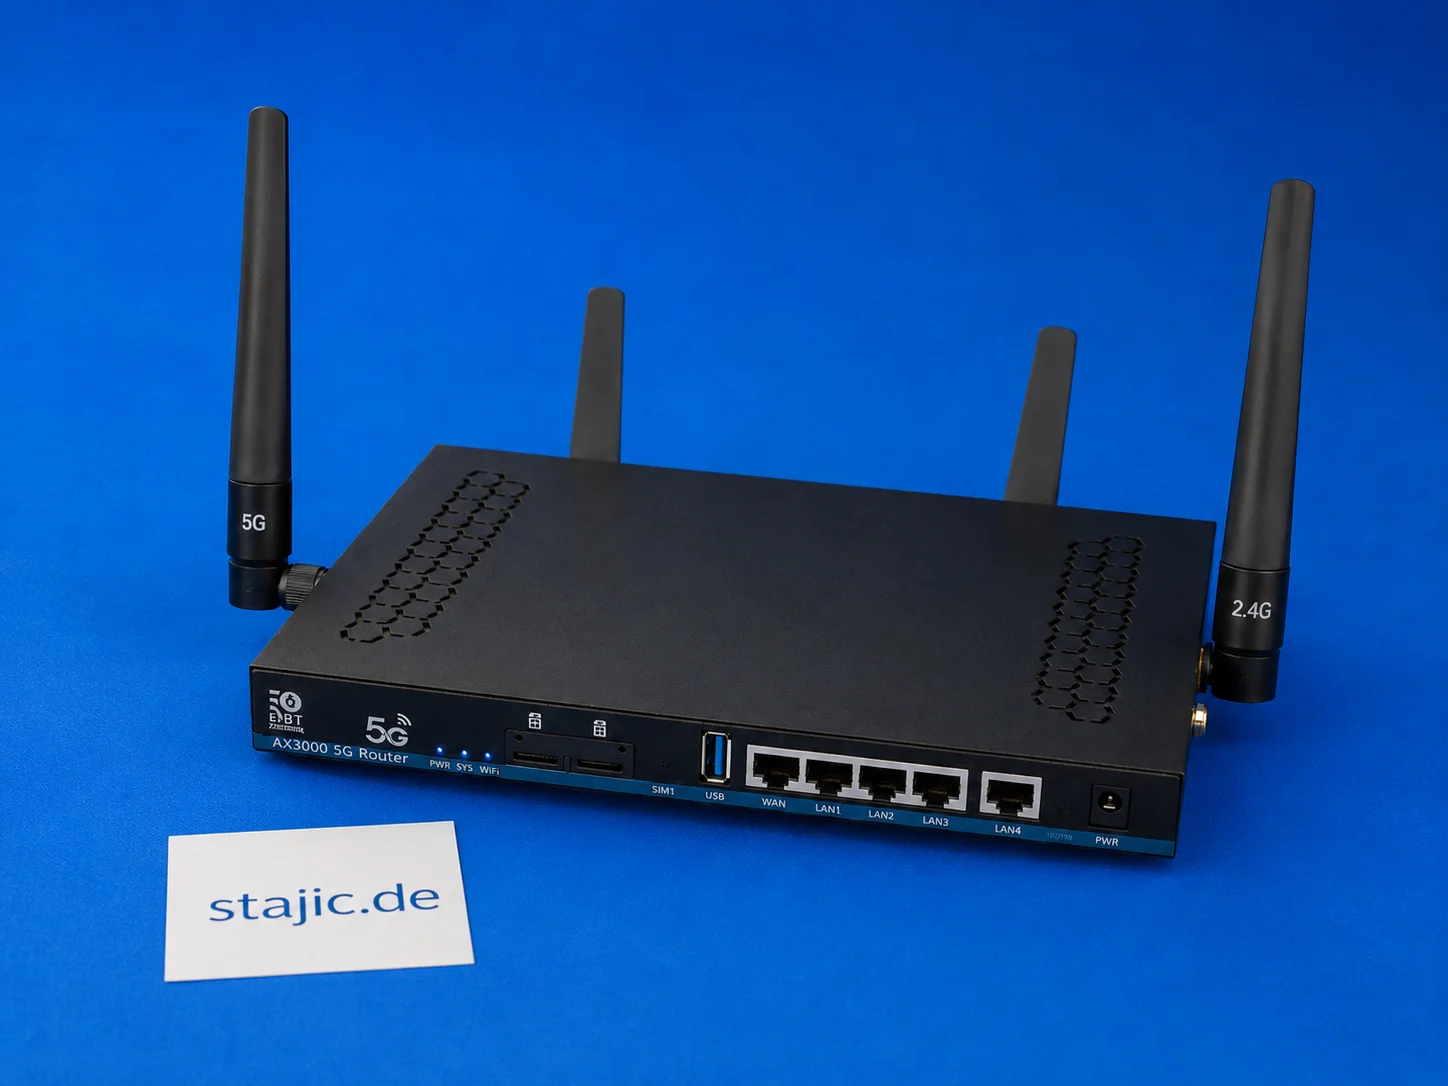
ZBT Z8102AX Dual-SIM-Failover: Was funktioniert, was fehlt und was eine bessere Firmware benötigt
Der ZBT Z8102AX ist ein Dual-SIM-5G-OpenWrt-Router, aber Dual-SIM-Hardware allein ist nicht dasselbe wie ein intelligentes Failover. Der Router erkennt die SIM und verbindet sich erfolgreich, aber die automatische Umschaltung, die Modem-Wiederherstellung, signalbasierte Entscheidungen und eine saubere Failover-Logik erfordern noch eingehendere Tests.
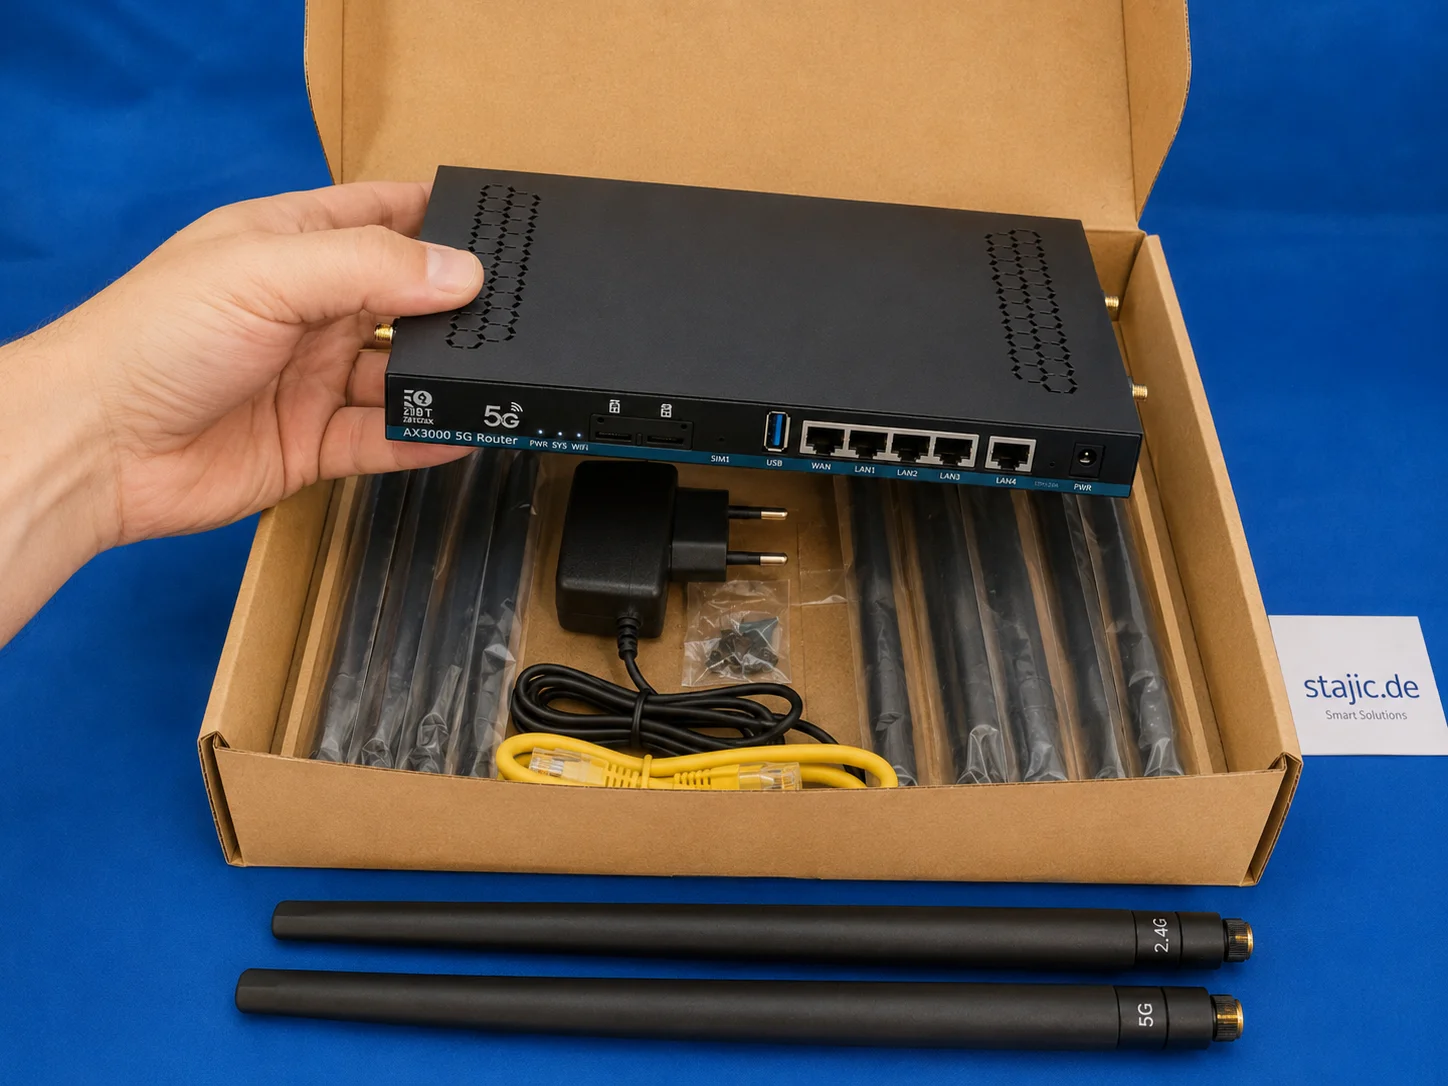
ZBT Z8102AX Hardware- und Verpackungs-Review: Starker Router, schwache Box
Der ZBT Z8102AX macht einen soliden ersten Eindruck als schlanker, schwarzer 5G-OpenWrt-Router aus Metall mit mehreren Antennenanschlüssen, Dual-SIM-Slots, USB- und LAN/WAN-Ports und einem praktischen Zubehörset. Die Hardware fühlt sich nützlich und seriös an, aber die Verpackung ist eindeutig die Schwachstelle.
PostfixAdmin: Management in Unternehmensqualität für Postfix-Mailsysteme — Anno 2026
PostfixAdmin ist eine datenbankzentrierte Verwaltungsoberfläche, entwickelt für professionelle Postfix-Mailsysteme. Anstatt Komplexität zu verbergen, bietet es präzise Kontrolle über Domains, Mailboxen, Aliase und Absenderberechtigungen. Dieser Artikel erklärt, warum PostfixAdmin auch 2026 eine vertrauenswürdige Unternehmenslösung bleibt und wie es in moderne, sicherheitsorientierte Mail-Infrastrukturen passt.

Meistern des SEO-Workflows: Essenzielle Optimierungsstrategien für organisches Wachstum
Ein strukturierter SEO-Workflow ist entscheidend für nachhaltiges organisches Wachstum. Lerne die zehn grundlegenden Strategien, von der Keyword-Recherche und technischen Optimierung bis hin zur Content-Qualität und Performance-Analyse.
Umfassender Leitfaden für Test DEv Enterprise Stajic.de: Architektur und Best Practices
Entdecken Sie die Architekturprinzipien, Vorteile und technischen Details der Verwaltung einer Entwicklungs- und Testumgebung der Enterprise-Klasse mit Test DEv Enterprise Stajic.de.
Optimierung der Codequalität: Testen mit ESLint und Prettier
Dieser Artikel beschreibt die Integration von ESLint und Prettier in moderne Entwicklungs- und Test-Workflows und konzentriert sich auf die praktische Umsetzung für eine konsistente Codequalität und einen einheitlichen Stil.