Woher bezieht ein LLM seine Daten? RAG-Datenquellen in Python
Der vorherige Artikel, Was ist RAG? Die einfachste Erklärung, wie es funktioniert, hat das mentale Modell etabliert: Das LLM schreibt, RAG ruft nützliches Wissen ab, die Anwendung besitzt den aktuellen Zustand, und Tools führen Aktionen aus. Dieser Artikel geht den nächsten Schritt: Woher kommen die Daten eigentlich, und wie sieht Retrieval in Python aus?
Die wichtige Überraschung ist, dass eine „LLM-Datenquelle“ normalerweise nichts Exotisches ist. Es kann eine Textdatei sein, ein Ordner mit Markdown-Dokumenten, eine SQL-Datenbank, eine API-Antwort, ein Produktkatalog, ein Support-System oder ein Vektorindex, der aus diesen Quellen abgeleitet wurde. Die KI kennt diese Systeme nicht auf magische Weise. Ihre Anwendung muss die relevanten Daten laden, abfragen, durchsuchen oder abrufen und das Ergebnis in den Kontext des Modells einfügen.
Datenquelle = wo Informationen leben. Retrieval = wie die Anwendung nützliche Informationen findet. Kontext = die ausgewählten Informationen, die dem Modell gegeben werden. LLM = die Komponente, die diesen Kontext interpretiert und eine Antwort generiert.— Das Vier-Teile-Modell, das in diesem Artikel verwendet wird
Frage
Wie nutzt ein LLM externe Daten wie Dateien, Datenbanken oder APIs, und wie kann ein kleines Python-Programm die wesentlichen RAG-Schritte implementieren, ohne sie hinter einem Framework zu verbergen?
Was das wirklich bedeutet
Wenn Entwickler sagen, dass ein LLM „mit Unternehmensdaten verbunden“ ist, können sich hinter diesem Satz mehrere verschiedene Operationen verbergen. Eine Anwendung führt möglicherweise SQL aus. Eine andere ruft eine API auf. Eine weitere führt eine Volltextsuche durch. Eine andere berechnet die Embedding-Ähnlichkeit über Dokument-Chunks. Alle können einem LLM externe Informationen liefern, aber sie sind nicht die gleiche Retrieval-Methode und sollten nicht als austauschbar behandelt werden.
Diese Unterscheidung ist wichtig, weil die beste Retrieval-Methode von der Form der Frage abhängt. „Wie lautet unsere Rückerstattungsrichtlinie?“ ist ein Dokument-Retrieval-Problem. „Wie lautet der aktuelle Status von Bestellung 4711?“ ist normalerweise eine strukturierte Datenbankabfrage. „Welcher Absatz behandelt die Kontowiederherstellung?“ kann eine Keyword- oder semantische Suche sein. RAG ist am nützlichsten, wenn das System relevantes Wissen vor der Generierung entdecken muss.
Einfachstes Beispiel
Beginnen Sie mit drei Strings in gewöhnlichem Python. Es gibt noch keine Vektordatenbank, kein Framework und kein LLM. Wir wollen nur den Retrieval-Schritt sichtbar machen.
documents = [
    "The AKM uses 7.62 mm ammunition.",
    "A Med Kit restores health.",
    "A 4x scope can be attached to several compatible weapons."
]

question = "Which ammunition does the AKM use?"

for document in documents:
    if "AKM" in document:
        print(document)
Das Programm gibt den ersten Satz aus, weil er den Begriff enthält, nach dem wir gesucht haben. Dies ist primitives Retrieval, aber die Architektur ist bereits sichtbar: Frage → Suche → relevanter Text. RAG fügt einen weiteren wichtigen Schritt hinzu: den abgerufenen Text zusammen mit der Frage an ein Sprachmodell übergeben.
Eine etwas allgemeinere Version ordnet Dokumente nach überlappenden Abfragebegriffen:
import re

documents = [
    {"id": "weapon-akm", "text": "The AKM uses 7.62 mm ammunition."},
    {"id": "healing-medkit", "text": "A Med Kit restores health."},
    {"id": "scope-4x", "text": "A 4x scope can be attached to several compatible weapons."},
]

def words(text):
    return set(re.findall(r"[a-zA-Z0-9.]+", text.lower()))

def retrieve(question, documents, top_k=2):
    query_terms = words(question)
    ranked = []

    for document in documents:
        score = len(query_terms & words(document["text"]))
        if score > 0:
            ranked.append((score, document))

    ranked.sort(key=lambda item: item[0], reverse=True)
    return [document for _, document in ranked[:top_k]]

question = "Which ammunition does the AKM use?"
hits = retrieve(question, documents)

for hit in hits:
    print(hit["id"], "->", hit["text"])
Dies ist keine Produktionssuchmaschine. Sie ignoriert Morphologie, Synonyme, Schreibvarianten, Dokumentlänge und viele Ranking-Signale. Ihr Wert ist pädagogisch: RAG beginnt nicht mit einer Vektordatenbank. Es beginnt mit Retrieval.
Wo das Beispiel nicht mehr funktioniert
Exakte oder lexikalische Übereinstimmung wird schwach, wenn die Frage und die Quelle unterschiedliche Wörter verwenden. Ein Dokument kann „Fahrzeugwartung“ sagen, während der Benutzer fragt: „Wie repariere ich mein Auto?“ Ein lexikalischer Retriever kann die Beziehung verfehlen, obwohl ein Mensch sie sofort sieht. Semantisches Retrieval adressiert dies, indem es Text als Vektoren darstellt und Bedeutung vergleicht, nicht nur exakte Tokens.
Lange Dateien schaffen ein weiteres Problem. Ein ganzes 80-seitiges Handbuch als eine Einheit zu durchsuchen ist zu grob, aber jeden Satz aufzuteilen kann nützlichen Kontext zerstören. Echte RAG-Systeme benötigen daher Entscheidungen über Parsing, Chunking, Metadaten, Ranking, Aktualität, Berechtigungen und Herkunft.
Das Beispiel sagt auch nichts über strukturierte Live-Fakten aus. Wenn der Benutzer nach dem aktuellen Status der Bestellung 4711 fragt und die Anwendung bereits einen Datenbankschlüssel hat, ist die semantische Suche normalerweise das falsche erste Werkzeug. Eine deterministische Datenbankabfrage ist besser.
Direkte Antwort
Eine LLM-Datenquelle ist jedes externe System, aus dem eine Anwendung Informationen für das Modell beziehen kann: Dateien, Datenbanken, APIs, Suchindizes, Vektorspeicher oder Live-Anwendungszustand. RAG ist das Muster, relevantes Wissen aus solchen Quellen vor der Generierung abzurufen.
In Python kann die wesentliche Pipeline sehr klein sein: Daten laden → abrufbare Einheiten erstellen → relevante Belege finden → Kontext zusammenstellen → das LLM aufrufen. Die Abrufmethode sollte zur Quelle und zur Frage passen. Verwenden Sie SQL für exakte strukturierte Fakten, Volltextsuche für lexikalisches Matching, Embeddings für semantische Ähnlichkeit und hybride Suche, wenn mehrere Signale wertvoll sind.
Warum das so ist
Ein Sprachmodell erhält nicht automatisch die Inhalte Ihres Dateisystems, Ihrer PostgreSQL-Datenbank, Ihres CRM, Ihrer privaten API oder eines neu bearbeiteten Dokuments. Die Anwendung entscheidet, auf welche externen Informationen zugegriffen werden kann und was in den aktuellen Kontext des Modells eingefügt wird.
Die ursprüngliche Arbeit zur Retrieval-Augmented Generation von Lewis et al. kombinierte ein generatives Modell mit externem nicht-parametrischem Speicher, der aus einem dichten Vektorindex abgerufen wurde. Die breitere architektonische Idee überlebt über diese spezifische Implementierung hinaus: Externe Belege können zur Inferenzzeit abgerufen werden, anstatt zu erwarten, dass alles nützliche Wissen in den Modellparametern kodiert ist.
Dies schafft eine nützliche Trennung der Zuständigkeiten: Die Quelle speichert Informationen, der Retriever wählt Belege aus, der Kontext trägt diese Belege in die Anfrage, und das Modell interpretiert sie. Wenn diese Grenzen sichtbar bleiben, lassen sich Fehler viel leichter diagnostizieren.
Kontext: Die wichtigsten Arten von Datenquellen
| Quelle | Typische Abrufmethode | Geeignet für |
|---|---|---|
| TXT / Markdown / HTML | Parsing + lexikalische oder semantische Suche | Dokumentation, Handbücher, Artikel, Notizen |
| PDF / DOCX | Struktur-bewusste Extraktion + Suche | Richtlinien, Berichte, Verträge, Handbücher |
| SQL-Datenbank | SQL-Abfrage oder gefilterter Abruf | Bestellungen, Benutzer, Produkte, strukturierte Datensätze |
| REST / GraphQL API | HTTP-Anfrage mit Parametern | Remote-Systeme und Live-Service-Daten |
| Suchindex | BM25 / Volltext / hybride Suche | Große Textsammlungen |
| Vektorindex | Embedding-Ähnlichkeit | Semantischer Dokumentenabruf |
| Anwendungszustand | Direktes Zustandslesen oder Tool-Aufruf | Was gerade jetzt wahr ist |
Ein Vektorindex verdient besondere Aufmerksamkeit. In vielen Architekturen ist er nicht die kanonische Quelle der Wahrheit. Er ist ein Abrufindex, der aus Dokumenten oder Datensätzen abgeleitet wurde. Das maßgebliche Dokument kann in Objektspeicher, einem CMS, Git, PostgreSQL oder einem anderen System liegen, während Embeddings und Metadaten separat für schnelle semantische Suche gespeichert werden. Einige Systeme verwenden einen Vektorspeicher tatsächlich als Primärspeicher, aber das ist eine architektonische Entscheidung und keine Anforderung von RAG.
Wenn die Grenze zwischen Abruf, persistentem Gedächtnis, aktuellem Zustand und Modellkontext noch unklar ist, siehe AI Agent Memory Is Not RAG. Diese Schichten können einige derselben Speichertechnologien verwenden und dennoch unterschiedliche Korrektheitsregeln haben.
Annahmen
- Die Anwendung darf auf die externe Quelle zugreifen.
- Die relevante Quelle enthält genügend Informationen, um die Frage zu beantworten.
- Die Daten können in einer Form geparst oder abgefragt werden, die die Abrufschicht nutzen kann.
- Die abgerufenen Informationen sind frisch genug für die angeforderte Entscheidung.
- Das Modell erhält die ausgewählten Belege in seinem Kontext.
- Die Autorisierung wird durchgesetzt, bevor geschützte Belege das Modell erreichen.
- Das Generierungsmodell kann immer noch falsch liegen, selbst wenn der Abruf korrekt ist.
Diese Annahmen sind wichtig, weil der Abruf fehlende Belege, veraltete Quellversionen, defekte Parser oder unbefugten Zugriff nicht kompensieren kann. Eine RAG-Pipeline kann nur so vertrauenswürdig sein wie der Belegpfad, der sie speist.
Variablen
| Variable | Warum sie das Design verändert |
|---|---|
| Quellstruktur | Eine SQL-Tabelle, ein juristisches PDF und ein Quellcode-Repository benötigen unterschiedliche Abrufstrategien |
| Fragetyp | Exakte Suche, konzeptionelle Suche und Multi-Hop-Recherche sind unterschiedliche Aufgaben |
| Aktualitätsanforderung | Live-Zustand kann direkte Abfragen erfordern anstelle regelmäßig neu aufgebauter Indizes |
| Korpusgröße | In-Memory-Suche kann für Hunderte von Chunks funktionieren, aber nicht für sehr große Sammlungen |
| Sprache | Mehrsprachiger Abruf erfordert Modelle und Tokenisierung, die für die tatsächlichen Sprachen geeignet sind |
| Berechtigungen | Der Abruf muss nach den Zugriffsrechten des aktuellen Benutzers filtern |
| Latenz und Kosten | Mehr Abrufstufen können die Qualität verbessern, aber Laufzeit- und Infrastrukturkosten erhöhen |
| Bedarf an Herkunftsnachweis | Systeme mit hohem Vertrauen benötigen Quell-IDs, Versionen und nachverfolgbare Belege |
Diagnostische / Entscheidungsmethode
Die erste Entscheidung ist nicht „Welche Vektordatenbank soll ich installieren?“ Sie lautet: Welche Art von Fakt versuche ich abzurufen?
| Fragetyp | Bevorzugter erster Ansatz | Grund |
|---|---|---|
| Exakte ID oder aktueller Datensatz | SQL / Schlüsselsuche / API | Deterministischer strukturierter Zugriff |
| Exakter Wortlaut, Codes, Namen | Volltext- oder Stichwortsuche | Lexikalische Präzision |
| Konzeptionelle Frage über Dokumente | Semantische Vektorsuche | Bedeutung kann vom Wortlaut abweichen |
| Gemischtes Unternehmenswissen | Hybrides Retrieval + Metadatenfilter | Kombiniert lexikalische und semantische Signale |
| Aktueller Anwendungszustand | Direkter Zustands-/Werkzeugzugriff | Aktualität ist wichtiger als Dokumentähnlichkeit |
Ein nützlicher Test ist: Weiß ich bereits, welchen Datensatz ich brauche, oder muss das System entdecken, welche Passage relevant ist? Wenn der Datensatz bekannt ist, frage ihn direkt ab. Wenn Relevanz entdeckt werden muss, wird die Suche wichtiger.
Wenn eine Antwort falsch ist, diagnostiziere die Pipeline der Reihe nach, anstatt sofort das LLM zu ändern:
- 1. Quellenabdeckung: Existiert die korrekte Information im zugänglichen Quellensatz?
- 2. Aktualität: Ist diese Version aktuell genug für die Frage?
- 3. Parsing: Wurde der relevante Inhalt korrekt extrahiert?
- 4. Chunking: Blieb der Beleg zusammen mit den Bedingungen, die ihm Bedeutung verleihen?
- 5. Retrieval: Erscheint der korrekte Chunk unter den Kandidaten?
- 6. Ranking: Werden stärkere Quellen über schwächeren oder widersprüchlichen eingestuft?
- 7. Kontextzusammenstellung: Hat die Anwendung die ausgewählten Belege tatsächlich an das Modell gesendet?
- 8. Generierung: Hat das LLM die bereitgestellten Belege getreu verwendet?
- 9. Attribution: Kann jede wichtige Aussage auf eine Quelle zurückgeführt werden?
Für eine tiefergehende Methode zur Produktionsfehlersuche siehe RAG Failed — But Which Layer Actually Failed? A Diagnostic Method, die diese Kette in unabhängig testbare Fehlerebenen erweitert.
Belege
Das RAG-Papier von Lewis et al. formalisierte die Generierung, die auf abgerufenem externem Gedächtnis basiert, anstatt sich nur auf Modellparameter zu verlassen. Das liefert die konzeptionelle Grundlage für die Trennung des Generators von einer abrufbaren Wissensquelle.
Sentence Transformers dokumentiert semantische Suche als Einbettung des Korpus und der Anfrage in einen Vektorraum und Abruf von Elementen mit hoher semantischer Ähnlichkeit. Seine aktuelle API unterscheidet auch zwischen Anfragekodierung und Dokumentkodierung für Retrieval-Aufgaben.
SQLite FTS5 demonstriert die andere Seite des Spektrums: Ausgereiftes Volltext-Retrieval kann Dokumente ohne Einbettungen einstufen. Das ist wichtig, weil lexikalische Suche für Identifikatoren, exakte Terminologie und viele hybride Retrieval-Designs wertvoll bleibt.
OpenAIs Einbettungsdokumentation beschreibt Einbettungen als numerische Vektordarstellungen, die für Verwandtschaft und Suche verwendet werden. Dies ist ein Implementierungspfad für semantisches Retrieval, nicht die Definition von RAG selbst.
Praxisbeispiel 1: Ein Ordner mit Textdateien
Angenommen, ein Verzeichnis namens knowledge/ enthält gewöhnliche Textdateien. Python kann sie ohne jegliche KI-Bibliothek laden.
from pathlib import Path

def load_text_files(folder="knowledge"):
    documents = []

    for path in Path(folder).glob("*.txt"):
        documents.append({
            "source": path.name,
            "text": path.read_text(encoding="utf-8")
        })

    return documents

documents = load_text_files()

for document in documents:
    print(document["source"], len(document["text"]))
Das Dateisystem ist die Datenquelle. Die nächste Frage ist, wie viel Text eine abrufbare Einheit werden soll. Bei langen Dokumenten ist die Suche in einer kompletten Datei oft zu grob. Deshalb erstellen RAG-Pipelines üblicherweise Chunks.
Ein sehr einfacher Chunker
def chunk_text(text, max_chars=800):
    paragraphs = [p.strip() for p in text.split("\n\n") if p.strip()]

    chunks = []
    current = ""

    for paragraph in paragraphs:
        candidate = f"{current}\n\n{paragraph}".strip()

        if current and len(candidate) > max_chars:
            chunks.append(current)
            current = paragraph
        else:
            current = candidate

    if current:
        chunks.append(current)

    return chunks
Dieses Beispiel gruppiert Absätze, bis ein grobes Zeichenlimit erreicht ist. Es ist absichtlich verständlich statt optimal. Produktionssysteme chunkieren oft nach Tokens, Überschriften, Abschnitten, Satzgrenzen oder Dokumentstruktur. Tabellen, Quellcode, Verträge und API-Dokumentation können unterschiedliche Strategien erfordern.
Provenienz beim Chunking bewahren
def build_chunks(documents):
    chunks = []

    for document in documents:
        for index, text in enumerate(chunk_text(document["text"])):
            chunks.append({
                "id": f'{document["source"]}:{index}',
                "source": document["source"],
                "chunk": index,
                "text": text,
            })

    return chunks
Ein nützlicher Chunk enthält mehr als nur Text. Quellenname, Dokument-ID, URL, Zeitstempel, Version oder Abschnitt können später Zitate, Debugging und Aktualitätsprüfungen unterstützen. Wenn die Provenienz während der Ingestion verloren geht, wird es viel schwieriger zu erklären, warum eine bestimmte Antwort erzeugt wurde.
Praxisbeispiel 2: Strukturierte Daten — SQL verwenden, wenn SQL das richtige Werkzeug ist
Nicht jede externe Tatsache sollte durch semantische Suche gehen. Wenn die Frage einen exakten aktuellen Datensatz verlangt, ist eine direkte Datenbankabfrage normalerweise klarer und deterministischer.
import sqlite3

def get_order_status(order_id):
    connection = sqlite3.connect("shop.db")
    cursor = connection.cursor()

    cursor.execute(
        "SELECT status, total, currency FROM orders WHERE id = ?",
        (order_id,)
    )

    row = cursor.fetchone()
    connection.close()

    if row is None:
        return None

    return {
        "order_id": order_id,
        "status": row[0],
        "total": row[1],
        "currency": row[2],
    }

print(get_order_status(4711))
Wenn die Anwendung bereits weiß, dass der Benutzer nach Bestellung 4711 fragt, fügt das Einbetten der gesamten Bestelltabelle und das Auffordern der semantischen Suche, diese Zeile wiederzuentdecken, normalerweise Komplexität ohne Nutzen hinzu. Eine starke Designregel lautet: Strukturierte Fakten mit strukturierten Abfragen abrufen; unstrukturiertes Wissen mit Suche abrufen.
Die zurückgegebene Datenbankzeile kann trotzdem in den Modellkontext eingefügt werden, damit das LLM sie in natürlicher Sprache erklären kann. Aber direkter Zustands- oder Datensatzzugriff ist konzeptionell anders als die Suche in einem Wissenskorpus.
Praxisbeispiel 3: Volltextsuche vor Embeddings
Zwischen einer naiven Python-Schleife und der Vektorsuche liegt eine ausgereifte Klasse lexikalischer Retrieval-Systeme. SQLite enthält FTS5 für die Volltextsuche, einschließlich BM25-Ranking.
import sqlite3

connection = sqlite3.connect("knowledge.db")
cursor = connection.cursor()

cursor.execute(
    "CREATE VIRTUAL TABLE IF NOT EXISTS docs USING fts5(title, body)"
)

cursor.execute(
    "INSERT INTO docs(title, body) VALUES (?, ?)",
    ("AKM", "The AKM uses 7.62 mm ammunition.")
)

connection.commit()

query = "AKM ammunition"

rows = cursor.execute(
    "SELECT title, body, bm25(docs) AS score "
    "FROM docs WHERE docs MATCH ? "
    "ORDER BY score LIMIT 5",
    (query,)
).fetchall()

for row in rows:
    print(row)

connection.close()
Lexikalische Suche ist besonders nützlich, wenn exakte Terminologie, Produktcodes, Namen, Identifikatoren oder domänenspezifische Wörter wichtig sind. Semantische Suche ist nicht automatisch besser. Produktionssysteme kombinieren oft beide Signale.
Praxisbeispiel 4: Semantisches Retrieval mit Embeddings
Embeddings verwandeln Text in numerische Vektoren, sodass semantisch verwandte Passagen verglichen werden können, auch wenn sie nicht identische Formulierungen verwenden. Sentence Transformers bietet eine unkomplizierte lokale Implementierung.
# pip install sentence-transformers

from sentence_transformers import SentenceTransformer, util

documents = [
    "The AKM uses 7.62 mm ammunition.",
    "A Med Kit restores health.",
    "Vehicle maintenance includes checking oil, brakes and tires.",
    "Account recovery requires access to the registered email address."
]

model = SentenceTransformer(
    "sentence-transformers/multi-qa-mpnet-base-cos-v1"
)

document_embeddings = model.encode_document(
    documents,
    convert_to_tensor=True
)

question = "How do I repair my car?"

query_embedding = model.encode_query(
    question,
    convert_to_tensor=True
)

hits = util.semantic_search(
    query_embedding,
    document_embeddings,
    top_k=2
)[0]

for hit in hits:
    print(round(float(hit["score"]), 3), documents[hit["corpus_id"]])
Die Abfrage enthält nicht den Ausdruck „Fahrzeugwartung“, aber ein semantisches Modell kann diese Passage trotzdem hoch einordnen, weil die Konzepte verwandt sind. Das ist der praktische Grund, warum Embeddings in RAG-Systemen üblich sind.
Für kleine Sammlungen können Embeddings im Speicher bleiben. Größere Systeme speichern sie normalerweise in einem vektorfähigen Index oder einer Datenbank und führen dort die Nächste-Nachbarn-Suche durch. Die Speicherung ändert sich, aber die Logik bleibt: die Frage kodieren, relevante Dokumentrepräsentationen finden, die beste Evidenz zurückgeben.
Praxisbeispiel 5: Den Kontext für das LLM aufbauen
Ein Retriever sollte Belege zurückgeben. Das LLM sollte dann die Frage plus diese Belege erhalten. Die Trennung von Retrieval und Generierung macht beides leichter überprüfbar und testbar.
def build_prompt(question, retrieved_documents):
    context = "\n\n".join(
        f'[{doc["id"]}] {doc["text"]}'
        for doc in retrieved_documents
    )

    return f"""
Answer the question using the supplied context.

Rules:
- Do not invent facts that are not supported by the context.
- If the context is insufficient, say so.
- Cite the source IDs you used.

Question:
{question}

Context:
{context}
""".strip()
Die Anweisung macht das Modell nicht unfehlbar. Sie schafft lediglich eine explizite Evidenzgrenze. Das Modell kann gute Belege immer noch missverstehen, eine Bedingung ignorieren oder verallgemeinern. Deshalb müssen Retrieval-Qualität und Generierungsqualität getrennt bewertet werden.
Reales Beispiel 6: Eine vollständige minimale Pipeline
def answer_question(question, all_documents, call_llm):
    # 1. Retrieve evidence
    retrieved = retrieve(question, all_documents, top_k=3)

    # 2. Build model context
    prompt = build_prompt(question, retrieved)

    # 3. Generate the answer
    answer = call_llm(prompt)

    return {
        "answer": answer,
        "sources": [doc["id"] for doc in retrieved]
    }
Die Funktion erhält call_llm absichtlich als Abhängigkeit. Retrieval sollte nicht davon abhängen, ob die Generierung von einem Cloud-Modell, einem lokalen Modell oder einem anderen Anbieter durchgeführt wird. Der Datenpfad gehört zur Anwendung.
Optionaler Generator: OpenAI Responses API
Ein möglicher Generator ist die OpenAI Responses API. Den Modellnamen in einer Umgebungsvariable zu halten, vermeidet die Festcodierung eines bestimmten Modells in die RAG-Architektur.
# pip install openai

import os
from openai import OpenAI

client = OpenAI()

def call_llm(prompt):
    response = client.responses.create(
        model=os.environ["OPENAI_MODEL"],
        input=prompt,
    )
    return response.output_text
Dieselbe Retrieval-Pipeline kann mit einem lokalen Inferenzserver verbunden werden. Dies ist ein wichtiger architektonischer Punkt: RAG gehört nicht dem LLM-Anbieter. Die Anwendung besitzt die Quelle, das Retrieval und die Kontextzusammenstellung.
Die gesamte Architektur in einer Ansicht
USER QUESTION
     |
     v
+-------------+
|  Retriever  |
+-------------+
   |       |
   |       +----> SQL / API / state query
   |
   +------------> keyword / full-text search
   |
   +------------> embedding / vector search
                     |
                     v
              relevant evidence
                     |
                     v
+-----------------------------------+
| question + evidence + instructions |
+-----------------------------------+
                     |
                     v
                   LLM
                     |
                     v
                  answer
Dieses Datenflussmodell ist beständiger als das Auswendiglernen eines Frameworks. Bibliotheken, Datenbanken und Modellanbieter werden sich ändern; die Verantwortlichkeitsgrenzen bleiben bestehen.
Häufige Missverständnisse und Fehlermodi
„RAG bedeutet Vektordatenbank.“
Nein. Vektorsuche ist eine Retrieval-Methode. RAG kann Volltextsuche, SQL, APIs, Wissensgraphen, Vektorsuche oder Kombinationen davon verwenden. Das definierende Muster ist das Abrufen externer Informationen für die Generierung.
„Wenn die Daten in PostgreSQL sind, muss ich die gesamte Datenbank einbetten.“
Nein. Strukturierte Datensätze sollten in der Regel als strukturierte Datensätze abfragbar bleiben. Embeddings sind nützlich für semantische Relevanz, nicht als Ersatz für deterministische Abfragen.
„Mehr Chunks bedeuten eine bessere Antwort.“
Nicht unbedingt. Zusätzlicher Kontext kann Rauschen, widersprüchliche Versionen und irrelevantes Material einbringen. Retrieval sollte auf nützliche Belege optimieren, nicht auf maximales Volumen.
„Ein hoher Ähnlichkeitswert beweist die Antwort.“
Nein. Ähnlichkeit misst Relevanz, nicht Wahrheit oder Anwendbarkeit. Eine hochgradig ähnliche Passage kann veraltet sein, aus der falschen Produktversion stammen oder nur unter Bedingungen gültig sein, die nicht zur Frage passen.
„Sobald der richtige Chunk abgerufen ist, ist Halluzination gelöst.“
Nein. Retrieval verbessert die Verankerung, garantiert aber kein treues Schlussfolgern. Die Generierung muss weiterhin evaluiert werden, und risikoreiche Workflows können deterministische Validierung oder menschliche Prüfung erfordern.
„Das Modell hat versagt, also wechsle das Modell.“
Nicht unbedingt. Die richtige Quelle kann gefehlt haben, falsch geparst, schlecht aufgeteilt, herausgefiltert, zu niedrig eingestuft oder aus dem zusammengestellten Kontext ausgelassen worden sein. Der Modellwechsel sollte nicht der erste Diagnoseschritt sein.
Randfälle
- Widersprüchliche Dokumente: zwei Quellen können voneinander abweichen, weil Versionen, Rechtsordnungen oder Produkte unterschiedlich sind.
- Zeitkritische Fakten: eine semantisch relevante Quelle kann bereits veraltet sein.
- Berechtigungen: ein Retriever darf keine Dokumente zurückgeben, auf die der aktuelle Benutzer nicht zugreifen darf.
- Mehrsprachige Sammlungen: das Embedding-Modell und die Retrieval-Strategie müssen die tatsächlich verwendeten Sprachen unterstützen.
- Tabellen und Quellcode: einfaches Absatz-Chunking kann Strukturen zerstören, die für die Antwort wesentlich sind.
- Sehr kurze Identifikatoren: semantisches Retrieval kann bei SKUs, IDs, Fehlercodes oder Akronymen schwächer sein als exakte Übereinstimmung.
- Lange Fragen, die mehrere Fakten erfordern: Retrieval kann Dekomposition, mehrere Suchen oder Reranking statt einer einzigen Top-k-Abfrage benötigen.
- Quellenhierarchie: eine offizielle aktuelle Richtlinie muss möglicherweise ein älteres, aber semantisch näheres Diskussionsdokument überstimmen.
Einschränkungen
Die Python-Beispiele optimieren bewusst auf Transparenz, nicht auf Skalierung. Der Keyword-Retriever ist naiv, der Chunker verwendet Zeichenlänge, die SQLite-Beispiele enthalten kein Produktions-Verbindungsmanagement, und das semantische Beispiel hält alle Embeddings im Speicher.
Ein Produktionssystem kann Vektorindizes, Reranker, hybrides Retrieval, Dokumentenparser, Caching, inkrementelle Indexierung, Quellenversionierung, Zugriffskontrollfilter, Observability, Evaluierungsdatensätze und Fehlerbehandlung erfordern. Keine dieser Ergänzungen ändert die Kernarchitektur; sie machen jede Grenze zuverlässiger.
RAG kann auch keine Belege erzeugen, die im Quellensatz fehlen. Wenn die Quelle falsch, unvollständig oder veraltet ist, kann ein besseres Embedding-Modell sie nicht in autoritatives Wissen verwandeln.
Was würde diese Antwort ändern?
Die Architektur ändert sich, wenn die Aufgabe mehr als Wissensabruf erfordert. Ein Live-Bestellstatus benötigt den aktuellen Zustand. Eine Finanzberechnung kann deterministischen Code erfordern. Eine Web-Recherche-Aufgabe kann aktive Suche erfordern. Ein Workflow kann Tools benötigen, die Daten in ein anderes System zurückschreiben können. Ein autonomer Agent kann zusätzlich zum Retrieval Planung, Berechtigungen und Ausführungskontrolle benötigen.
RAG lässt sich daher am besten als eine Ebene der Belegbeschaffung innerhalb eines größeren KI-Systems verstehen. Es ist gerade deshalb leistungsfähig, weil es eine enge Aufgabe hat: nützliche externe Informationen finden und in den Arbeitskontext des Modells einfügen.
Fazit
RAG wird viel leichter zu verstehen, wenn die Technologienamen entfernt werden. Eine Datei ist eine Quelle. Eine Datenbank ist eine Quelle. Eine API ist eine Quelle. Eine Suchfunktion ruft Belege ab. Ein Prompt trägt diese Belege zum Modell. Das LLM interpretiert sie dann und erzeugt Sprache.
Das Schwierige an Produktions-RAG ist nicht der Aufruf eines Embedding-Modells. Es ist der Aufbau eines vertrauenswürdigen Belegpfads von der Originalquelle bis zur endgültigen Aussage: die Herkunft bewahren, die richtige Retrieval-Methode auswählen, Informationen aktuell halten, den Zugriff kontrollieren, Retrieval getrennt von der Generierung bewerten und wissen, wann ein direkter Datenbank- oder Tool-Aufruf besser ist als semantische Suche.
Das ist die praktische Fortsetzung des grundlegenden RAG-Modells: zuerst die Rollen verstehen, dann den Datenpfad explizit machen.
Primärquellen
- Lewis et al. — Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks — das Paper von 2020, das die RAG-Formulierung einführte, die Generierung mit abgerufenem nicht-parametrischem Speicher kombiniert.
- Sentence Transformers — Semantic Search — offizielle Dokumentation für semantisches Retrieval, Query-Embeddings und Dokument-Embeddings.
- OpenAI — Vector Embeddings — offizielle Dokumentation, die Embeddings als numerische Repräsentationen beschreibt, die für Verwandtschaft und Suche verwendet werden.
- SQLite — FTS5 Extension — offizielle Dokumentation für Volltextsuche und BM25-Ranking in SQLite.
- OpenAI — SDKs and CLI — offizielles Python-SDK-Beispiel für die Responses API, das im optionalen Generator-Beispiel verwendet wird.
- What Is RAG? The Simplest Explanation of How It Works — der konzeptionelle erste Teil dieser Serie.
Related Articles

Warum mehr Kontext KI-Antworten verschlechtern kann
Ein größeres Kontextfenster garantiert keine bessere Antwort. Dieser Artikel erklärt, wie Signalverwässerung, widersprüchliche Belege, veralteter Zustand, Positionssensitivität und verlustbehaftete Kompression die KI-Zuverlässigkeit verringern können—und stellt einen praktischen Context Pressure Test vor.
Umfassender Leitfaden zum Evaluation Harness: LLM-Leistungsbewertung meistern
Dieser Leitfaden bietet eine detaillierte Einführung in Evaluation Harness, ein unverzichtbares Framework zur strengen Bewertung der Fähigkeiten von Large Language Models (LLMs) in Enterprise-LLMOps-Pipelines. Erfahren Sie mehr über Einrichtung, Best Practices und fortgeschrittene Techniken, um ein zuverlässiges Modell-Benchmarking und eine Optimierung zu gewährleisten.
ZBT Z8102AX Dual-SIM-Failover: Was funktioniert, was fehlt und was eine bessere Firmware benötigt
Der ZBT Z8102AX ist ein Dual-SIM-5G-OpenWrt-Router, aber Dual-SIM-Hardware allein ist nicht dasselbe wie ein intelligentes Failover. Der Router erkennt die SIM und verbindet sich erfolgreich, aber die automatische Umschaltung, die Modem-Wiederherstellung, signalbasierte Entscheidungen und eine saubere Failover-Logik erfordern noch eingehendere Tests.

Zuverlässigkeit von KI-Agenten: Warum die endgültige Antwort nicht ausreicht
Korrekte Ausgabe beweist weder korrektes Denken, sichere Ausführung noch ein vertrauenswürdiges System.
Unternehmensfähige mandantenfähige Architektur für eine internationale Plattform
Loving Rocks ist eine Hochzeitsplattform auf Unternehmensniveau, konzipiert mit einer echten Mehrmandantenarchitektur, isolierten Datenbanken pro Mandant und integrierter Internationalisierung für globale Skalierbarkeit, Sicherheit und langfristige Betriebsstabilität.
Google I/O 2026: Agentische Produkte in Search, Workspace und Shopping
Google I/O 2026 zeigte, dass sich agentenbasierte KI über Modelldemos und Entwicklertools hinaus in alltägliche Produktoberflächen bewegt. Dieser Artikel schlüsselt auf, wie Search, Workspace, Gemini Spark und Universal Cart auf ein neues Produktmodell hinweisen, bei dem Google-Agenten Nutzern helfen, über vernetzte Dienste hinweg zu recherchieren, zu arbeiten, einzukaufen und zu agieren.
npm ERESOLVE-Abhängigkeitskonflikte verstehen und lösen
Lösen Sie npm ERESOLVE Peer-Dependency-Konflikte auf die richtige Weise: Identifizieren Sie den tatsächlichen Mismatch, gleichen Sie Versionen an, verwenden Sie Overrides sicher und wissen Sie, wann pnpm oder Yarn besser geeignet sind.

Computer-Use-Agenten: Warum eine erfolgreiche Demo dennoch ein unzuverlässiges System sein kann
Computer-Use-Agenten können mittlerweile beeindruckende Browser- und Desktop-Workflows abschließen, aber ein erfolgreicher Durchlauf beweist Fähigkeit—nicht Zuverlässigkeit. Dieser Artikel zeigt, wie man Wiederholbarkeit, Umgebungsrobustheit, Steuerung über lange Zeithorizonte, Zustandsbewusstsein, Ergebnisüberprüfung und sichere Zielhandhabung testet.
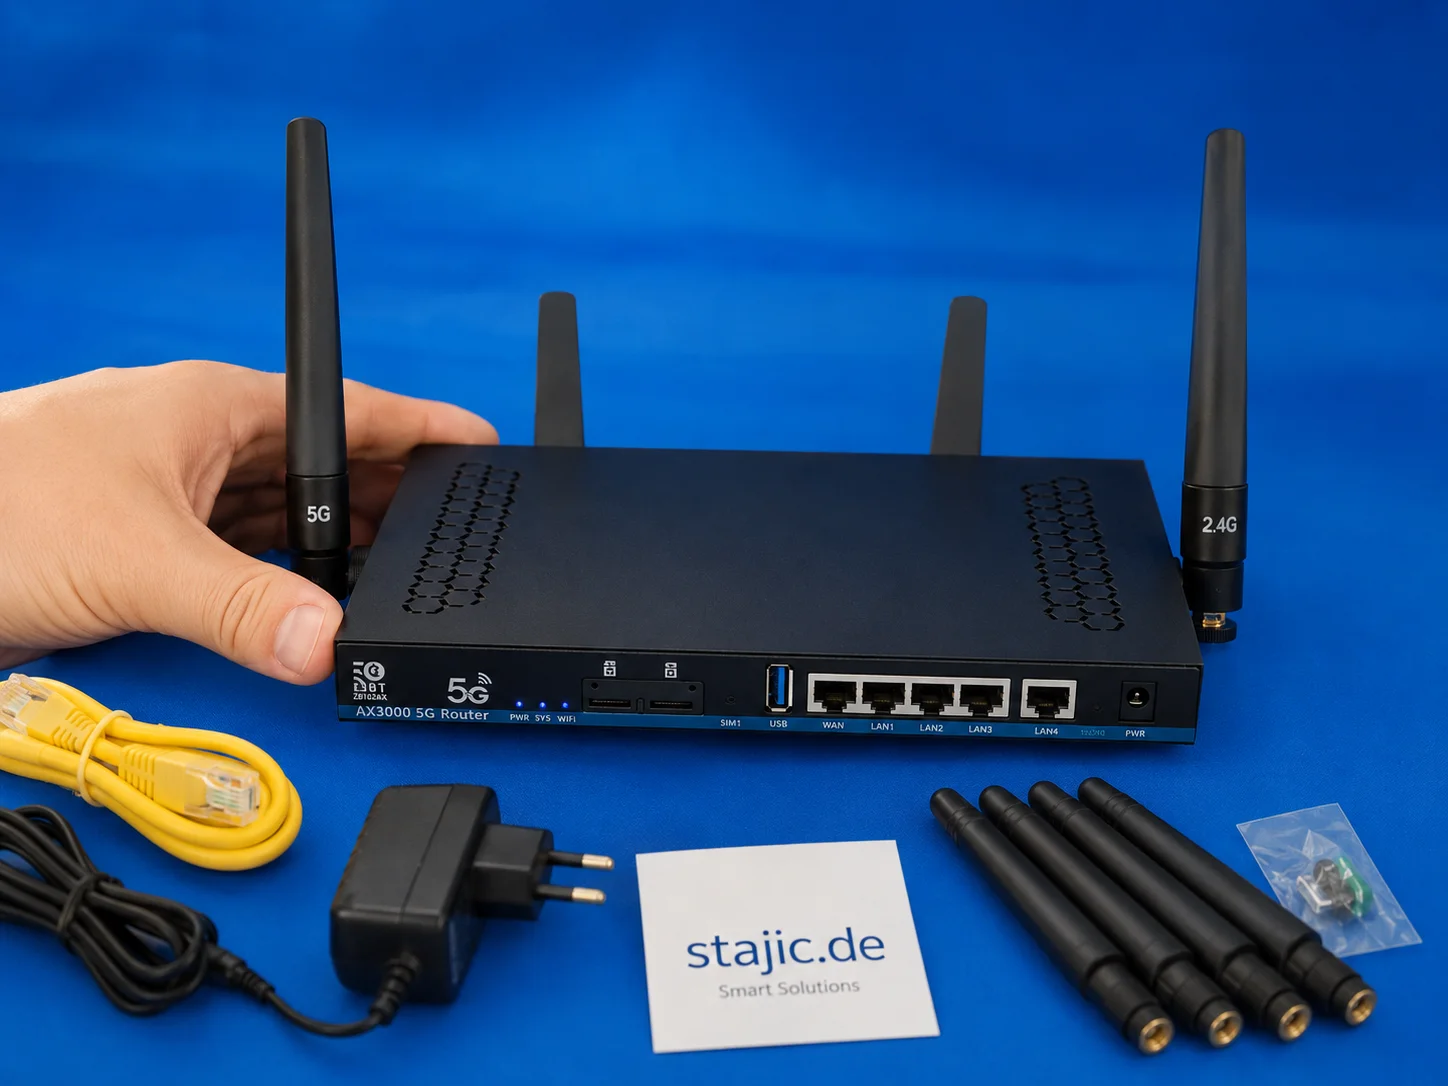
Der nächste OpenWrt-5G-Router: Warum Wi-Fi 7, eine stärkere CPU und bessere Firmware wichtig sind
Der ZBT Z8102AX ist ein nützliches erstes Sample, aber der nächste Schritt sollte stärker sein: Wi-Fi 7, eine leistungsstärkere Vier-Kern-Plattform, mehr Klarheit bei der Firmware, eine verbesserte Verpackung und eine stabilere Preispolitik. Das Ziel ist nicht nur ein weiterer 5G-Router, sondern ein besser konfiguriertes, OpenWrt-basiertes Prosumer-Gerät.
Qwen 3.6 in der Produktion: Release-Runbook, KI-Rollback und LLMOps-Versionierung
Qwen 3.6 ist nicht nur ein weiteres Modell-Upgrade. Es ist gleichzeitig ein Release-Ereignis, ein Rollback-Szenario und ein Versionierungsproblem. Dieser Artikel erklärt, wie Qwen 3.6 in der Produktion durch LLMOps-Disziplin, Prompt- und Modell-Rückverfolgbarkeit, kontrollierten Rollout und evidenzbasierte Rollback-Bereitschaft gehandhabt werden sollte.
Google I/O 2026: Architektonische Neuausrichtungen, agentische KI und der Realitätscheck des einheitlichen Ökosystems
Die Google I/O 2026 war nicht nur ein Modell-Event. Sie zeigte eine tiefgreifendere Plattformverschiebung über Gemini-Modelle, Entwicklertools, mit Android verknüpfte Oberflächen und intelligente Geräte hinweg. Dieser Artikel schlüsselt die Keynote als Hub-Story für Ingenieure, Architekten und Produktteams auf, die reale Laufzeitauswirkungen vom Hype auf der Bühne trennen müssen.