
Drag-and-Drop mit JavaScript: Eine tiefgehende Analyse der nativen API für interaktive Menüstrukturen
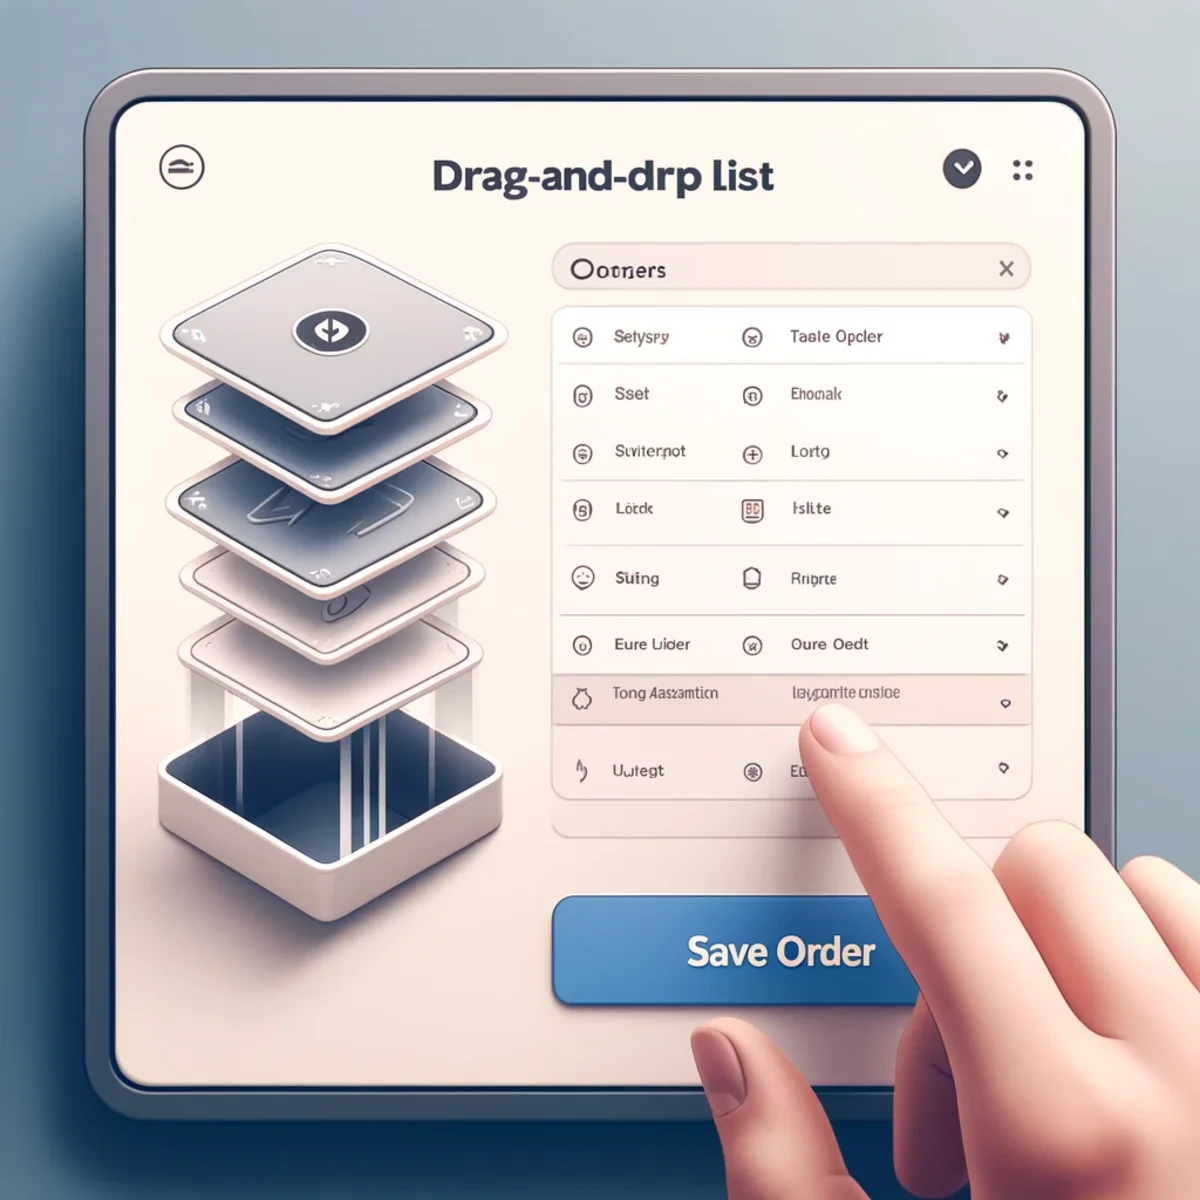
Einführung in das native Drag-and-Drop in JavaScript
Interaktive Benutzeroberflächen (UIs) sind ein fundamentaler Bestandteil moderner Webanwendungen. Die Möglichkeit, Elemente per Drag-and-Drop zu verschieben, verbessert die Benutzererfahrung signifikant, insbesondere bei der Verwaltung von Listen, Menüs oder der Organisation von Inhalten. Während in der Vergangenheit oft komplexe Bibliotheken oder Frameworks zur Implementierung dieser Funktionalität notwendig waren, bietet die native HTML5 Drag-and-Drop API eine standardisierte, leistungsstarke Lösung, die direkt in Vanilla JavaScript genutzt werden kann.
Dieser Artikel dient als technische Analyse und Demonstration der Prinzipien, die hinter der Implementierung von Drag-and-Drop-Funktionalität in JavaScript stehen. Der Fokus liegt auf der präzisen Steuerung des Datenflusses und der Event-Behandlung, die notwendig ist, um beispielsweise eine dynamische Menüstruktur neu anzuordnen.
Grundlagen des HTML5 Drag-and-Drop API
Die native Drag-and-Drop API basiert auf einer Reihe von DOM-Ereignissen und dem globalen Attribut `draggable`. Um ein Element verschiebbar zu machen, muss dieses Attribut auf `true` gesetzt werden. Die Interaktion gliedert sich in zwei Hauptbereiche: das ziehende Element (Drag Source) und das ablegbare Ziel (Drop Target).
Der Prozess des Ziehens und Ablegens wird durch eine definierte Kette von Ereignissen gesteuert, die präzise behandelt werden müssen, um die gewünschte Funktionalität zu gewährleisten. Insbesondere die korrekte Behandlung des `dragover`-Ereignisses ist entscheidend, da Browser standardmäßig das Ablegen von Elementen verhindern.
Vorteile der nativen Implementierung
Die Entscheidung für die native HTML5 API gegenüber externen Bibliotheken bietet mehrere technische und architektonische Vorteile:
- Standardisierung und Browser-Kompatibilität: Die API ist ein Webstandard, der von allen modernen Browsern nativ unterstützt wird, was die Notwendigkeit von Polyfills reduziert.
- Performance: Da die Funktionalität nativ im Browser implementiert ist, ist die Performance in der Regel höher als bei JavaScript-basierten Emulationen.
- Barrierefreiheit (Accessibility): Die native Implementierung kann besser mit assistierenden Technologien interagieren, sofern die entsprechenden ARIA-Attribute korrekt gesetzt werden.
- Datenübertragung (Data Transfer): Die API bietet ein dediziertes `DataTransfer`-Objekt, das es ermöglicht, MIME-typisierte Daten (z. B. Text, URLs oder benutzerdefinierte Daten) während des Ziehvorgangs zu speichern und am Zielort abzurufen.
Technische Details und Event-Handling
Die Implementierung erfordert die Überwachung und Steuerung von mindestens sechs zentralen Ereignissen. Das Herzstück der Funktionalität ist das `DataTransfer`-Objekt, das über die Ereignisobjekte zugänglich ist und als temporärer Speicher für die zu verschiebenden Informationen dient.
Die Schlüsselereignisse des Drag-and-Drop-Zyklus
1. dragstart: Dieses Ereignis wird ausgelöst, sobald der Benutzer beginnt, das Element zu ziehen. Hier muss die zu übertragende Information im `dataTransfer`-Objekt gespeichert werden, typischerweise unter Verwendung von `event.dataTransfer.setData(format, data)`. Für die Neuanordnung eines Menüs könnte dies die ID des gezogenen Elements sein.
2. dragover: Dieses Ereignis wird kontinuierlich ausgelöst, während das gezogene Element über ein potenzielles Ziel bewegt wird. Um das Ablegen zu ermöglichen, muss die Standardaktion des Browsers explizit unterdrückt werden, meist durch `event.preventDefault()`. Dies signalisiert dem Browser, dass die Zone ein gültiges Drop-Target ist.
3. drop: Dieses Ereignis tritt ein, wenn das Element erfolgreich über dem Ziel losgelassen wird. Hier wird die im `dragstart` gespeicherte Information mittels `event.dataTransfer.getData(format)` abgerufen. Anschließend erfolgt die eigentliche DOM-Manipulation, beispielsweise das Verschieben des Menüpunkts an die neue Position in der Liste.
4. dragend: Dieses Ereignis wird ausgelöst, wenn der Ziehvorgang abgeschlossen ist, unabhängig davon, ob das Ablegen erfolgreich war oder abgebrochen wurde. Es dient primär zur Bereinigung, wie dem Zurücksetzen von visuellen Zuständen oder dem Entfernen temporärer Klassen.
Einsatz von TypeScript
Bei der Arbeit mit komplexen Event-Systemen, wie dem Drag-and-Drop API, bietet TypeScript erhebliche Vorteile. Die korrekte Typisierung der Ereignisobjekte (z. B. `DragEvent` anstelle des generischen `Event`) stellt sicher, dass Entwickler direkt auf das `dataTransfer`-Objekt zugreifen können, ohne Laufzeitfehler zu riskieren. Dies erhöht die Codequalität und die Wartbarkeit, insbesondere in größeren Projekten, die auf Vanilla JavaScript basieren.
Anwendungsfälle: Interaktive Menüs und mehr
Die Fähigkeit, Elemente dynamisch neu anzuordnen, ist für viele moderne Webanwendungen unerlässlich. Das Beispiel der Menüstruktur ist hierbei ein klassischer Anwendungsfall. Wenn ein Content-Management-System (CMS) die Bearbeitung der Navigationsreihenfolge zulässt, wird Drag-and-Drop verwendet, um die Reihenfolge der Listenelemente (Menüpunkte) visuell zu manipulieren.
Weitere typische Anwendungen umfassen:
- Kanban-Boards: Verschieben von Aufgabenkarten zwischen verschiedenen Spalten (Statusänderung).
- Dateimanager: Verschieben von Dateien oder Ordnern zwischen Verzeichnissen.
- E-Commerce-Konfiguratoren: Anordnen von Produktkomponenten oder Personalisierungselementen.
- Playlist-Editoren: Ändern der Wiedergabereihenfolge von Mediendateien.
In all diesen Szenarien ist die JavaScript-Logik nach dem `drop`-Ereignis dafür verantwortlich, nicht nur das DOM zu aktualisieren, sondern auch die zugrunde liegenden Datenstrukturen (z. B. ein Array oder eine Datenbank) zu synchronisieren, um die Persistenz der neuen Anordnung zu gewährleisten.
Fazit und Ausblick
Die native HTML5 Drag-and-Drop API bietet eine robuste und performante Grundlage für die Implementierung komplexer Interaktionen in JavaScript. Obwohl die API eine präzise Steuerung des Event-Flusses erfordert – insbesondere die Unterdrückung der Standardaktion bei `dragover` und die Nutzung des `DataTransfer`-Objekts – liefert sie die notwendigen Werkzeuge, um interaktive Elemente wie dynamische Menüstrukturen effizient zu realisieren.
Die Beherrschung des `DataTransfer`-Objekts und der korrekten Event-Kette ist der Schlüssel zur erfolgreichen Implementierung von nativem Drag-and-Drop in modernen Webanwendungen.— Technische Schlussfolgerung
Related Articles
Optimierung der Codequalität: Testen mit ESLint und Prettier
Dieser Artikel beschreibt die Integration von ESLint und Prettier in moderne Entwicklungs- und Test-Workflows und konzentriert sich auf die praktische Umsetzung für eine konsistente Codequalität und einen einheitlichen Stil.
npm ERESOLVE-Abhängigkeitskonflikte verstehen und lösen
Lösen Sie npm ERESOLVE Peer-Dependency-Konflikte auf die richtige Weise: Identifizieren Sie den tatsächlichen Mismatch, gleichen Sie Versionen an, verwenden Sie Overrides sicher und wissen Sie, wann pnpm oder Yarn besser geeignet sind.

Wie man erkennt, ob ein KI-Agent tatsächlich die richtigen Belege verwendet hat
Ein KI-Agent kann Quellen zitieren und trotzdem die falschen Belege verwenden. Dieser Artikel stellt eine praktische Methode zur Überprüfung der Belegung von Behauptungen, der Quellenautorität, der Anwendbarkeit, der Herkunft sowie der Frage vor, ob die Belege die Antwort tatsächlich beeinflusst haben.

RAG fehlgeschlagen – aber welche Ebene ist tatsächlich fehlgeschlagen? Eine diagnostische Methode
Wenn eine RAG-Antwort falsch ist, ist es zu vage, das Retrieval oder das Modell verantwortlich zu machen. Diese Diagnosemethode isoliert Quellenabdeckung, Query-Konstruktion, Retrieval, Ranking, Kontextzusammenstellung, Generierung, Evidenzzuordnung und Aktualität – sodass der tatsächliche Fehler reproduziert und behoben werden kann.
Falsifikation für KI-Schlussfolgern: Von Antworten zu getesteten Hypothesen
KI-Modelle können überzeugende Belege für nahezu jede plausible Hypothese generieren. Eine zuverlässigere Methodik stellt die entgegengesetzte Frage: Welche Belege würden die Schlussfolgerung abschwächen, ihr widersprechen oder uns zwingen, sie aufzugeben? Dieser Artikel entwickelt eine falsifikationsorientierte Argumentation für LLMs mithilfe konkurrierender Hypothesen, diskriminierender Tests, Gegenbelegen und expliziter Ablehnungskriterien.

Warum mehr Kontext KI-Antworten verschlechtern kann
Ein größeres Kontextfenster garantiert keine bessere Antwort. Dieser Artikel erklärt, wie Signalverwässerung, widersprüchliche Belege, veralteter Zustand, Positionssensitivität und verlustbehaftete Kompression die KI-Zuverlässigkeit verringern können—und stellt einen praktischen Context Pressure Test vor.

Was sollte ein KI-Agent behalten, vergessen, neu berechnen oder erneut abrufen?
Langlaufende Agenten sollten sich nicht alles merken. Dieser Artikel bietet ein praktisches Lebenszyklusmodell für die Entscheidung, was in den dauerhaften Speicher gehört, was erneut abgerufen werden sollte, was sicherer neu zu berechnen ist und was ablaufen oder ersetzt werden sollte.

KI-Agenten-Gedächtnis ist kein RAG: Wie man Gedächtnis, Retrieval, Zustand und Kontext voneinander trennt
Agentengedächtnis, RAG, Zustand und Kontext werden oft so verwendet, als wären sie austauschbar. Das sind sie nicht. Dieses praktische Architekturmodell trennt die vier Schichten, zeigt, wohin jede gehört, und erklärt, was kaputtgeht, wenn Systeme sie zu einer einzigen zusammenfassen.
Managed Agent Harness vs. Self-Hosted Agent Loop: Was Sie gewinnen, was Sie verlieren
“Selbst gehosteter Agent” kann sehr unterschiedliche Architekturen bedeuten. Dieser Leitfaden unterscheidet zwischen dem Managed Harness, der selbst gehosteten Ausführungsumgebung und dem vollständig selbst betriebenen Agent-Loop—und zeigt, welche Kontrollgrenze Teams tatsächlich benötigen.
Aufkommende Linux-Trends 2026: Die Zukunft der Serverinfrastruktur gestalten
Entdecken Sie die wichtigsten Linux-Trends von 2026, von der Kubernetes-Dominanz und unveränderlichen Distributionen bis hin zur KI-Integration und eBPF-Sicherheit.
Umfassender Leitfaden für Test DEv Enterprise Stajic.de: Architektur und Best Practices
Entdecken Sie die Architekturprinzipien, Vorteile und technischen Details der Verwaltung einer Entwicklungs- und Testumgebung der Enterprise-Klasse mit Test DEv Enterprise Stajic.de.

Migration vom OpenAI Agents SDK zur Agents API: Was ändert sich tatsächlich architektonisch?
Die Migration vom OpenAI Agents SDK zur neuen Agents API ist keine reine Umbenennung von Imports. Die Laufzeitgrenze verschiebt sich: Die Agent-Schleife, die dauerhafte Sitzung, die Orchestrierung, die Kontextkomprimierung und die Wiederherstellung bewegen sich in Richtung einer verwalteten Harness. Dieser Leitfaden zeigt, was verschoben werden sollte, was in Ihrer Anwendung bleiben sollte und wie Sie die Migration vor dem Cutover nachweisen können.