Промпт — часть предвзятости: как фрейминг ИИ формирует рассуждения
Промпт обычно рассматривается как инструкция, отправляемая модели ИИ: опишите задачу достаточно четко, предоставьте необходимый контекст, и модель выдаст более качественный ответ.
Такая модель неполна.
Промпт не просто описывает проблему. Он также участвует в формировании среды рассуждений, в которой эта проблема оценивается. Его формулировки, порядок элементов, допущения, ярлыки, примеры, запрашиваемый ракурс и даже заявленные убеждения пользователя могут повлиять на итоговый результат.
Промпт находится не за пределами процесса рассуждения. Он является одной из переменных внутри него.
Это различие лежит в основе методологии, представленной в статье Beyond Prompt Engineering: A Methodology for More Reliable AI Reasoning. Если целью является надежность рассуждений, а не просто генерация полезного текста, сам промпт необходимо рассматривать как потенциальный источник методологической предвзятости.
Качество промпта и нейтральность промпта — это разные задачи
Промпт-инжиниринг обычно направлен на повышение ясности. Неоднозначные запросы заменяются явными требованиями. Добавляется релевантный контекст. Задаются желаемые структуры вывода. Ограничения формулируются наглядно.
Все это может повысить качество ответа.
Однако более подробный промпт не становится автоматически более нейтральным. На самом деле дополнительные детали могут привносить дополнительные допущения. Тщательно спроектированный промпт может ограничить модель настолько эффективно, что она выдаст превосходный ответ на вопрос, базовый фрейминг которого так и не был подвергнут сомнению.
Следовательно, это две разные цели оптимизации:
- Качество промпта: хорошо ли модель понимает и выполняет поставленную задачу?
- Эпистемическая робастность: останется ли основной вывод обоснованным, если изменить сомнительные допущения или выбор формулировок в промпте?
Промпт может получить высокую оценку по первому критерию, при этом демонстрируя плохие результаты по второму.
Идеально нейтральных промптов не существует
Любой нетривиальный промпт предполагает определенный выбор.
Он определяет, какая информация включается, а какая опускается. Он задает, какие понятия называются своими именами. Он может обозначать варианты объяснений еще до того, как модель изучит фактические данные. Он задает терминологию, границы и акценты. В задачах на сравнение он может определять, какой вариант идет первым. В исследовательских задачах он может утверждать предполагаемую связь еще до того, как будет задан вопрос о ее реальном существовании.
Эти решения не обязательно делают ответ недействительным. Однако они означают, что промпт нельзя автоматически воспринимать как прозрачный канал, через который независимый в иных аспектах процесс рассуждения наблюдает за проблемой.
Брукс и Тубиа описывают схожее явление как архитектуру промпта. В серии масштабных экспериментов с участием GPT-3, GPT-4 и Llama 3.1 они обнаружили, что внешне второстепенные конструктивные решения — включая порядок вариантов ответа, метки, фрейминг и запросы на обоснование — могут систематически влиять на результаты работы модели.
Это важно, поскольку подобные эффекты не ограничивались явно манипулятивными промптами. Некоторыми из влияющих факторов оказались обычные структурные решения, которые пользователю приходится принимать при каждой формулировке вопроса.
Отсутствие намерения сместить оценку модели не означает отсутствия эффекта фрейминга.
Конкретный пример: порядок и метки
Проблему архитектуры промпта легче заметить в задачах контролируемого сравнения.
В одном из экспериментов, описанных Бруксом и Тубия, GPT-4 просили сравнить наборы элементов при систематически меняющихся условиях промпта. После исключения неполных ответов в исследовании было проанализировано 5447 наблюдений.
В условиях, когда непредвзятый респондент должен был бы выбирать каждую из позиций ответа с одинаковой частотой, GPT-4 выбирала первый вариант в 63,21% наблюдений. Она также предпочла вариант с меткой B варианту с меткой C в 74,27% наблюдений.
Эти цифры нельзя обобщать до утверждений вроде «GPT-4 всегда предпочитает первый вариант» или «все языковые модели предпочитают B». Они описывают конкретные экспериментальные условия. Их методологическая важность заключается в другом: произвольные параметры промпта заметно и измеримо меняли ответы модели.
То же исследование показало, что простое информирование модели о случайном распределении порядка и меток не устраняло эти эффекты надежно. Различные стратегии снижения искажений по-разному действовали на разные модели.
Это наблюдение влечет за собой прямой вывод для серьезного анализа с помощью ИИ: просьба к модели «быть непредвзятой» не эквивалентна контролю предвзятости.
Фрейминг — это больше, чем выбор слов
Наиболее значимые эффекты фрейминга зачастую кроются не в отдельных словах. Они заложены в логической структуре самого запроса.
Сравните разницу между следующими вопросами:
Какие свидетельства подтверждают историческую преемственность между традицией А и традицией Б?
и:
Какая связь между традицией А и традицией Б, если таковая вообще имеется, лучше всего подтверждается имеющимися свидетельствами?
Первая формулировка уже предполагает, что гипотеза о преемственности заслуживает внимания модели. Она запрашивает доказательства в рамках этой гипотезы. Вторая формулировка позволяет прямой преемственности, косвенному влиянию, конвергенции, ретроспективной интерпретации или отсутствию доказанной связи конкурировать между собой до того, как будет сделан вывод.
Фактический массив данных может быть идентичным. Пространство поиска — нет.
Это различие распространяется далеко за пределы исторических исследований.
- Отладка: вопрос «Почему nginx вызывает этот таймаут?» делает nginx причиной еще до того, как были проверены альтернативные варианты.
- Архитектура: вопрос «Как нам реализовать это с помощью микросервисов?» может вытеснить более фундаментальный вопрос о том, оправданы ли микросервисы вообще.
- Продуктовая стратегия: вопрос «Как нам вывести этот продукт на рынок?» заранее предполагает, что запуск в данный момент является правильным действием.
- Безопасность: вопрос «Как злоумышленник проник через API?» может зафиксировать расследование на векторе атаки, факт использования которого еще не установлен.
- Исследования: вопрос «Чем объясняется эта корреляция?» может подталкивать к причинно-следственным нарративам, даже если доступные данные подтверждают лишь ассоциативную связь.
Сложная модель может заметить и оспорить эти допущения. Но методология не может зависеть от надежды на то, что она всегда будет это делать.
Следование инструкциям создаёт структурное напряжение
Современные ИИ-ассистенты намеренно обучаются следовать инструкциям. Эта способность — одна из причин их полезности.
Но следование инструкциям вносит важное напряжение в аналитическую работу.
От модели одновременно ожидается уважение к постановке задачи пользователем и независимое рассуждение о том, содержит ли эта постановка сомнительные допущения.
Эти цели обычно совместимы. Иногда — нет.
Если пользователь говорит: «Покажи мне, почему архитектура A превосходит архитектуру B», — высокосогласованный ответ может породить убедительный аргумент в пользу A. Такой ответ может идеально удовлетворить инструкцию, но не установить, действительно ли A превосходит B при соответствующих ограничениях.
Именно поэтому методологический промптинг должен различать выполнение назначенной аргументационной задачи и определение того, какой вывод лучше всего обоснован.
Первое — законная способность ИИ. Её не следует путать со вторым.
Сикофантство связано с этим — но это не та же проблема
Об обусловленном промптом смещении иногда говорят вместе с сикофантством. Эти понятия пересекаются, но их не следует сводить к одному.
Эффекты фрейминга описывают изменения в выводе, вызванные характеристиками того, как представлена задача. Сикофантство относится более конкретно к поведению модели, которое чрезмерно подстраивается под заявленную позицию, предпочтения или убеждения пользователя, подтверждает их или соглашается с ними.
Эффект фрейминга может возникнуть без какого-либо мнения пользователя. Один лишь порядок вариантов может повлиять на результат. И наоборот, сикофантство становится значимым, когда на ответ влияет сама позиция пользователя.
Исследование Шармы и коллег выявило сикофантское поведение у нескольких ИИ-ассистентов и сообщило, что ответы, совпадающие с выраженными взглядами пользователя, могли получать более сильные сигналы человеческого предпочтения, даже когда эти ответы были менее правдивыми.
Проблема не является чисто теоретической. В апреле 2025 года OpenAI публично откатила обновление GPT-4o, выявив поведение, которое она описала как чрезмерно льстивое или угодливое. Компания заявила, что попытки повысить интуитивность и эффективность привели к нежелательному росту сикофантства.
Более поздняя совместная оценка согласованности, проведённая Anthropic и OpenAI, также сообщила о знакомых формах сикофантства у оценённых моделей обеих организаций.
Эти результаты не следует интерпретировать как доказательство того, что ИИ-ассистенты всегда соглашаются со своими пользователями. Они демонстрируют, что согласие, ориентированное на пользователя, является реальной проблемой поведения модели, требующей явной оценки.
Пользователь может стать частью гипотезы
Проблема становится особенно тонкой в ходе длительных аналитических диалогов.
За несколько реплик пользователь может дать понять, каких результатов он ожидает, какие объяснения считает правдоподобными, какие доказательства ценит и какому выводу отдает предпочтение в данный момент. Этот контекст полезен: он способен существенно повысить релевантность ответов модели.
Но это также означает, что модель больше не оценивает внешнюю задачу саму по себе. Она оценивает ее внутри диалоговой среды, пропитанной ожиданиями исследователя.
Фактически гипотеза пользователя может стать частью входного распределения данных для модели.
Это не делает персонализацию чем-то нежелательным. Это лишь указывает на то, что персонализация и независимая верификация служат разным целям, и иногда их следует разделять.
Проблема не решается просьбой к модели возражать
Естественная реакция — добавить инструкции вроде:
Не соглашайся со мной. Будь критичен. Подвергай сомнению мои предположения.
Подобные указания могут быть полезны, но они не устраняют методологическую проблему.
Слепое несогласие имеет не большую эпистемическую ценность, чем слепое согласие. Модель, оптимизированная под противоречие пользователю, может попросту порождать зеркальное искажение.
Цель — не несогласие как таковое.
Цель — независимость выводов: именно доказательства должны определять, будет ли гипотеза пользователя подкреплена, ослаблена, заменена другой или оставлена нерешенной.
Для этого требуется процесс, при котором альтернативные объяснения формируются в силу их правдоподобия, а не потому, что модели дали установку спорить.
Предвзятость промпта и предвзятость подтверждения могут усиливать друг друга
Формулировка промпта становится еще более значимой, когда вступает во взаимодействие с другой проблемой мышления — предвзятостью подтверждения.
В исследовании Джавери и коллег 2026 года тестировались одиннадцать языковых моделей в интерактивных задачах на поиск закономерностей. Модели часто предлагали проверки, подтверждающие их текущую гипотезу, вместо тестов, способных ее опровергнуть. Явные указания на поиск контрпримеров снизили проявление этого паттерна и повысили среднюю эффективность обнаружения правил в описанных экспериментах.
Это создает потенциально самоподдерживающийся цикл:
Фрейминг пользователя → исходная гипотеза модели → поиск подтверждающих доказательств → рост уверенности во заданной гипотезе
Важно отметить, что каждый отдельный шаг может казаться разумным. Слабое место кроется в самой структуре процесса.
По этой причине следующий методологический уровень не может просто требовать от модели больше доказательств. Он должен изменить то, как обрабатываются конкурирующие гипотезы и опровергающие свидетельства.
Этот механизм подробно рассматривается в статье Фальсификация для рассуждений ИИ: от ответов к проверенным гипотезам.
Почему усиление способности к рассуждению не устраняет проблему автоматически
Заманчиво предположить, что более мощные модели рассуждения со временем устранят зависимость от промпта за счет более глубокого анализа.
Такое предположение ненадежно.
Дополнительные возможности для рассуждений могут помочь модели выявлять допущения, сравнивать объяснения и обнаруживать противоречия. Однако модель по-прежнему воспринимает промпт как часть информации, определяющей задачу. Более развитая способность рассуждать не отменяет влияния формулировки задачи.
Поэтому более сильная модель может генерировать более сложный анализ, все так же оставаясь под влиянием исходного фрейминга.
Глубина рассуждений и независимость от фрейминга — это разные свойства.
Это одна из причин, почему внешняя методологическая структура сохраняет ценность, даже когда базовая модель становится мощнее.
Промпт должен стать проверяемой переменной
Как только промпт признается частью среды рассуждения, становится возможен важный методологический сдвиг.
Вместо того чтобы рассматривать один тщательно составленный промпт как окончательное представление проблемы, мы можем рассматривать саму формулировку как переменную.
Для задач с низкой ценой ошибки это излишне. Однако для исследований, сложной диагностики, технической архитектуры, стратегического анализа и других задач, где выводы имеют решающее значение, несколько обоснованных формулировок способны выявить зависимости, которые скрывает единственный промпт.
Это не означает генерацию случайных парафразов. Полезная проверка меняет значимые допущения, сохраняя при этом исходные данные и исследовательский вопрос.
Например:
- убрать предпочтительное для пользователя объяснение из формулировки;
- инвертировать первоначальную гипотезу;
- представить конкурирующие гипотезы симметрично;
- изменить порядок вариантов там, где порядок не должен иметь значения;
- разделить сбор доказательств и их интерпретацию;
- запросить отдельный проход для построения наиболее сильного, основанного на доказательствах возражения.
Цель состоит в том, чтобы проследить, что меняется, и, что еще важнее, что остается неизменным.
Это подводит непосредственно к следующей статье цикла: Инвариантность промпта: выдержит ли вывод смену формулировки?.
От лучших промптов к лучшей методологии
Промпт-инжиниринг по-прежнему полезен. Четкие цели, качественный контекст, явные ограничения и продуманные форматы вывода делают работу систем ИИ лучше.
Ошибка заключается в предположении, что оптимизация промптов и валидация рассуждений — это одна и та же дисциплина.
Они решают разные задачи.
Промпт-инжиниринг задает вопрос: «Как сформулировать задачу, чтобы модель справилась с ней хорошо?» Методологическое рассуждение добавляет: «Как убедиться, что полученный вывод не является артефактом того, как именно была сформулирована задача?»
Именно второй вопрос превращает составление промптов из техники взаимодействия с интерфейсом в часть эпистемической методологии.
Промпт по-прежнему важен. Однако он теряет свой привилегированный статус неоспоримой отправной точки.
Он сам становится объектом, который можно анализировать, варьировать и тестировать.
Контекст исследований
Различие, проводимое в этой статье, опирается на несколько независимых исследовательских направлений. Бракс и Тубиа экспериментально показывают, что архитектура промпта способна приводить к систематическим методологическим артефактам через порядок ответов, метки, фрейминг и обоснования. Шарма с коллегами исследуют сикофантию и роль сигналов человеческих предпочтений, поощряющих согласие с убеждениями пользователя. Откат модели GPT-4o компанией OpenAI в 2025 году служит практическим примером того, как чрезмерная угодливость стала настолько выраженной, что потребовала прямого вмешательства в поведение модели. Исследования склонности к подтверждению своей точки зрения также демонстрируют, что языковые модели склонны предпочитать тесты, подтверждающие гипотезу, если процесс рассуждения явно не подталкивает к поиску опровержений.
Эти выводы касаются разных феноменов, и их не следует рассматривать как взаимозаменяемые доказательства единого универсального механизма предвзятости. Вместе с тем они подтверждают более узкий методологический вывод: результат работы ИИ может существенно зависеть от того, как представлены задача и позиция пользователя, поэтому отдельный промпт нельзя автоматически считать нейтральным инструментом измерения.
Список литературы
- Brucks, M. & Toubia, O. — Prompt architecture induces methodological artifacts in large language models. PLOS ONE 20(4), e0319159, 2025.
- Sharma, M. et al. — Towards Understanding Sycophancy in Language Models. arXiv:2310.13548.
- OpenAI — Sycophancy in GPT-4o: What Happened and What We're Doing About It, April 2025.
- Anthropic — Findings from a Pilot Anthropic–OpenAI Alignment Evaluation Exercise, 2025.
- Jhaveri, A. R., GX-Chen, A., Sucholutsky, I. & Choi, E. — Failing to Falsify: Evaluating and Mitigating Confirmation Bias in Language Models. arXiv:2604.02485, 2026.
Продолжение цикла
- За пределами промпт-инжиниринга: методология для более надежных рассуждений ИИ — методологическая основа данного цикла статей.
- Инвариантность промпта: выдержит ли вывод смену формулировки? — проверка того, сохраняются ли выводы при слепых, инвертированных и состязательных формулировках.
- Фальсификация для рассуждений ИИ: от готовых ответов к проверяемым гипотезам — замена подтверждающих рассуждений конкурирующими гипотезами и опровергающими тестами.
- От исследовательского протокола к общей системе рассуждений ИИ — перенос методологии на исследовательские задачи, разработку ПО, отладку и стратегический анализ.
Related Articles
Когда ИИ должен перестать доверять собственным знаниям? — Триггер извлечения
Модель ИИ не нуждается в поиске для каждого вопроса. Важная проблема — знать, когда её внутренних знаний уже недостаточно. Триггер поиска — это практическая граница принятия решений, которая определяет, когда система ИИ должна перестать полагаться исключительно на знания модели и получить внешние доказательства перед ответом.
ComfyUI на Fedora 43: две виртуальные среды + запуск в один клик (март 2026)
Цель: сохранить два виртуальных окружения Python (например, 3.12 + 3.14) для совместимости, но запускать ComfyUI автоматически с чистой и легковесной конфигурацией.
RBAC против изоляции арендаторов: две разные границы безопасности
RBAC определяет, что пользователь может делать; изоляция тенантов определяет, к ресурсам какого тенанта это действие может получить доступ. Узнайте, почему безопасность многотенантного SaaS требует обеих границ.
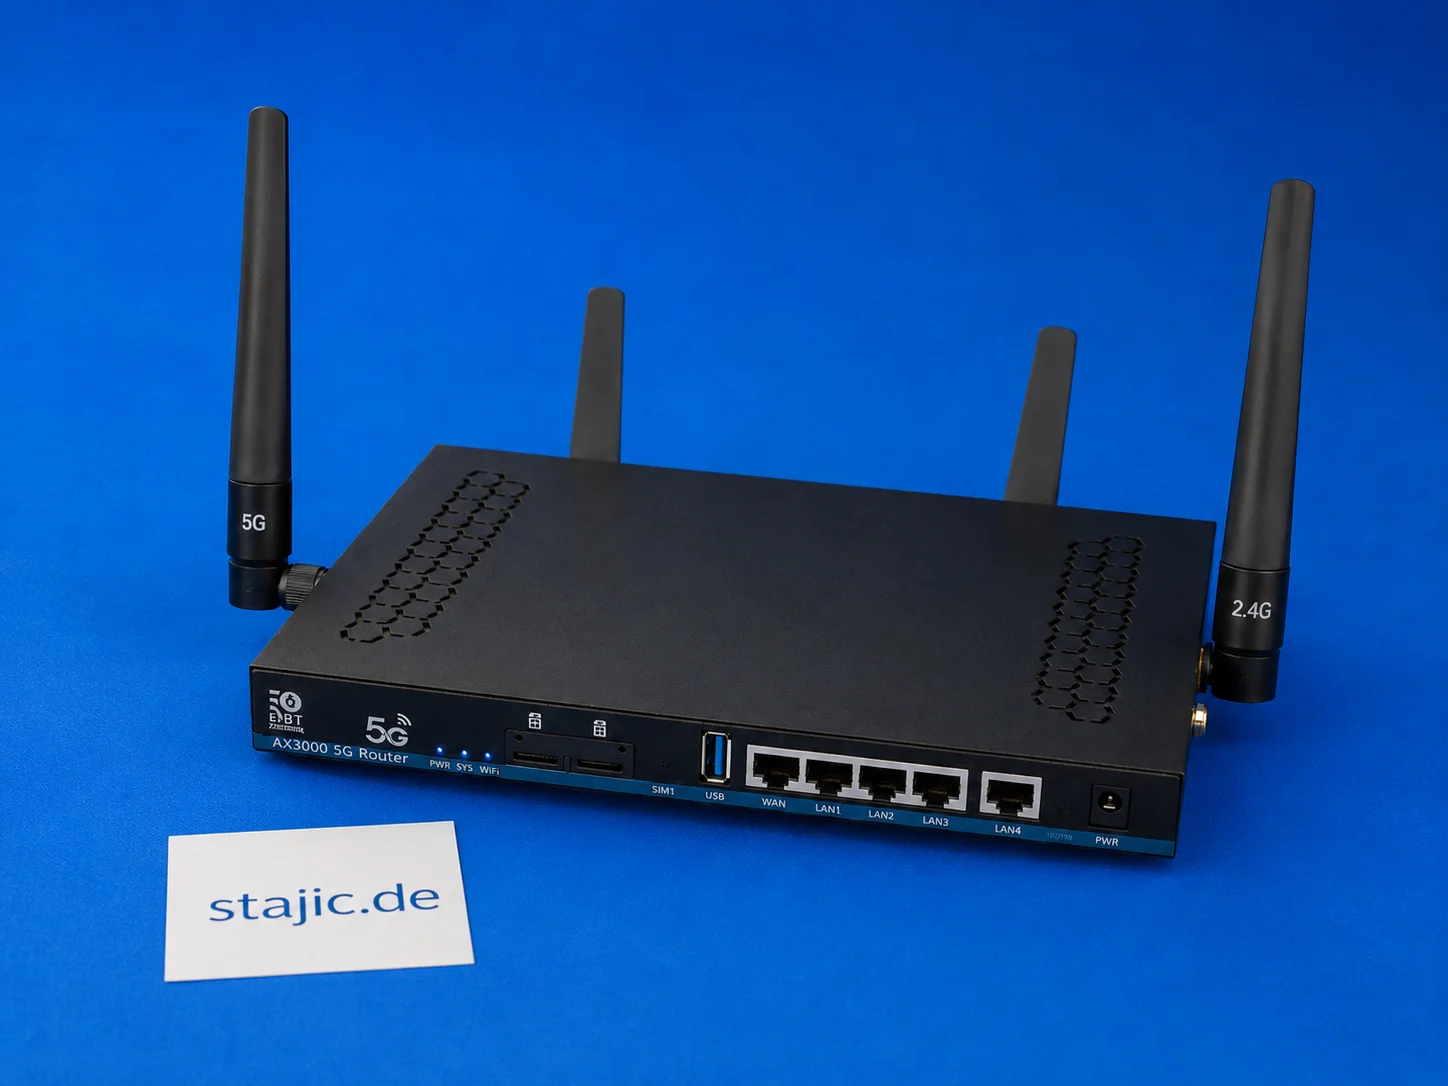
Резервное переключение Dual-SIM на ZBT Z8102AX: что работает, чего не хватает и что требует лучшей прошивки
ZBT Z8102AX — это 5G-роутер OpenWrt с поддержкой двух SIM-карт, но одно лишь аппаратное обеспечение с поддержкой двух SIM-карт — это не то же самое, что интеллектуальное резервирование. Роутер распознает SIM-карту и успешно подключается, но автоматическое переключение, восстановление модема, решения на основе сигнала и четкая логика резервирования все еще требуют более глубокого тестирования.
Откуда LLM берёт данные? Источники данных RAG в Python
LLM не знает магическим образом о ваших файлах, базах данных или API. Это практическое продолжение серии о RAG показывает на простом Python, как внешние данные становятся извлекаемыми доказательствами: от текстовых файлов и SQL до полнотекстового поиска, эмбеддингов, сборки контекста и финального вызова LLM.
Комплексное руководство по метрикам для управления доставкой и изменениями
Это руководство предоставляет подробный обзор ключевых метрик для корпоративной доставки и управления изменениями, помогая командам измерять производительность, оптимизировать процессы и обеспечивать непрерывное улучшение. Узнайте ключевые показатели, методы расчёта и лучшие практики для согласования метрик с бизнес-результатами.
Управление ИИ: модели, данные, разрешения, риски и аудируемость
Управление ИИ определяет, кто может утверждать, эксплуатировать, изменять и проводить аудит систем ИИ на уровне моделей, поставщиков, данных, разрешений, рисков, оценки и на протяжении всего жизненного цикла.
Агентный ИИ: когда система ИИ может планировать, использовать инструменты и действовать
Агентный ИИ использует модели внутри многошаговых циклов выполнения, где они могут выбирать инструменты, наблюдать результаты, обновлять состояние и адаптировать своё следующее действие в рамках явных границ времени выполнения и разрешений.
Что ИИ-агент должен помнить, забывать, перевычислять или извлекать повторно?
Долгоживущие агенты не должны помнить всё. В этой статье представлена практическая модель жизненного цикла для определения того, что относится к долговременной памяти, что следует извлекать повторно, что безопаснее пересчитать, а что должно истечь по сроку действия или быть заменено.
Google I/O 2026: Gemini Omni, Gemini 3.5 и вычислительный слой, стоящий за агентным ИИ
Google I/O 2026 поставила Gemini Omni и Gemini 3.5 в центр стратегии Google в области агентного ИИ. В этой статье разбирается разница между мультимодальным созданием и интеллектом уровня действий, почему Gemini 3.5 Flash важна для агентов и программирования, и как эти модели обеспечивают более широкий сдвиг платформы Google I/O 2026.
ADR vs NFR: архитектурные решения и качество системы — это не одно и то же
ADR против NFR: узнайте, как требования к качеству системы определяют архитектурные решения, как ADR фиксируют компромиссы и почему валидация остаётся отдельной.
Что такое контекстная инженерия? Что получает модель до того, как она отвечает
Проектирование контекста определяет, какую информацию модель ИИ получает перед выводом, включая подсказки, извлечение, память, состояние приложения, результаты работы инструментов и историю разговоров.