
Фальсификация для ИИ-рассуждений: от ответов к проверяемым гипотезам
Языковая модель может предоставить подтверждающие доказательства для удивительно большого числа правдоподобных объяснений.
Эта способность полезна для исследования, но опасна как метод проверки. Если модель начинает с гипотезы и задача состоит просто в том, чтобы объяснить, почему она может быть верной, связный ответ может появиться задолго до того, как гипотеза выдержит серьёзную проверку.
Таким образом, надёжное рассуждение ИИ требует более сильного вопроса:
Какие доказательства заставили бы эту гипотезу потерпеть неудачу?
В этой статье развивается ориентированное на фальсификацию рассуждение как следующий слой методологии, представленной в Beyond Prompt Engineering: A Methodology for More Reliable AI Reasoning. Предыдущая статья, Prompt Invariance: Does the Conclusion Survive the Prompt?, проверяет, выдерживает ли вывод изменения в формулировке. Фальсификация решает другую проблему: выдерживает ли гипотеза доказательства, которые могли бы свидетельствовать против неё.
Инвариантность к промпту проверяет зависимость от формулировки. Фальсификация проверяет уязвимость к доказательствам.
Почему подтверждение слишком легко
Предположим, системе ИИ дана гипотеза и задан вопрос, определить, является ли она правдоподобной.
Модель может искать в своих знаниях, предоставленных документах или извлечённых источниках наблюдения, совместимые с этой гипотезой. Если найдено достаточно совместимых наблюдений, полученное объяснение может становиться всё более убедительным.
Но совместимость — слабое доказательство, когда несколько конкурирующих гипотез предсказывают одно и то же наблюдение.
Рассмотрим абстрактный случай:
Наблюдение E совместимо с гипотезой H1.
Это утверждение само по себе не устанавливает H1. Если H2, H3 и H4 также предсказывают E, то E мало что даёт для различения между ними.
Доказательства становятся более информативными, когда конкурирующие объяснения делают разные предсказания о том, что мы должны наблюдать.
Это смещает процесс рассуждения от сбора подтверждающих фактов к разработке различающих проверок.
Классическая идея, лежащая в основе фальсификации
Фальсификационизм Карла Поппера подчёркивал асимметрию между верификацией и опровержением. Повторяющиеся наблюдения, совместимые с универсальным утверждением, не могут логически доказать его истинность, тогда как подлинное несовместимое наблюдение может напрямую противоречить ему.
В упрощённой логической форме:
Если H истинна, должно наблюдаться наблюдение O. O не наблюдается. Следовательно, H в том виде, как она сформулирована в условиях теста, ставится под сомнение.
Полезная гипотеза должна идти на риск: некоторые возможные данные должны быть менее совместимы с ней, чем с её альтернативами.
Фальсификация на практике сложнее
H + A1 + A2 + A3 → ожидаемое наблюдение O
Ориентированное на фальсификацию рассуждение для LLM
Не спрашивайте только о том, что поддерживает H. Спрашивайте о том, что должно существовать, если H истинна, что должно быть трудно объяснить, если H истинна, и какая альтернатива лучше объясняет те же данные.
Шаг 1 — Сформулируйте гипотезу точно
Гипотезу невозможно осмысленно проверить, если она настолько расплывчата, что может объяснить любой исход.
Сравните:
Система нестабильна, потому что что-то не так в сетевом уровне.— Слабая гипотеза
с:
Периодические сбои API вызваны тем, что обратный прокси закрывает восходящие соединения при превышении настроенного тайм-аута.— Проверяемая гипотеза
Второе утверждение допускает конкретные проверки. Мы можем изучить значения тайм-аутов, длительность соединений, логи прокси, поведение восходящего сервиса и сбои, происходящие ниже настроенного порога.
Чем точнее гипотеза определяет предполагаемую связь, тем легче определить, какие доказательства будут свидетельствовать против неё.
Шаг 2 — Создайте настоящие конкурирующие гипотезы
Проверка одной гипотезы изолированно слаба, потому что почти любое наблюдение интерпретируется относительно чего-то ещё.
Поэтому система должна сформулировать правдоподобные альтернативы до оценки доказательств.
Для того же сбоя API возможные объяснения могут включать:
- H1: тайм-аут обратного прокси;
- H2: сбой или перезапуск восходящего приложения;
- H3: исчерпание соединений с базой данных;
- H4: сетевое прерывание или потеря пакетов;
- H5: тайм-аут на стороне клиента;
- H6: взаимодействие нескольких уровней, а не одна изолированная причина.
Альтернативы должны быть достаточно правдоподобными, чтобы конкурировать. Создание заведомо слабых альтернатив лишь создаёт видимость критического мышления.
Гипотеза не прошла проверку на конкуренцию, если альтернативы были созданы для того, чтобы проиграть.
Шаг 3 — Выведите ожидаемые наблюдения
Для каждой серьёзной гипотезы модель должна вывести наблюдения, ожидаемые при таком объяснении.
Если H1 — это гипотеза о тайм-ауте обратного прокси, ожидаемые наблюдения могут включать сбои, сгруппированные вокруг определённой длительности, соответствующие сообщения о тайм-ауте в логах прокси, работоспособные восходящие процессы во время сбоя и исчезновение сбоя после контролируемого изменения тайм-аута.
Для H2, гипотезы о перезапуске приложения, мы ожидали бы иную картину: перезапуски процессов, исключения, отсутствие доступности приложения, исчерпание ресурсов или коррелированные события контейнеров.
Важный шаг — сформулировать эти ожидания до того, как интерпретировать любое доступное наблюдение как подтверждение.
Шаг 4 — Определите потенциальные опровергающие свидетельства
Для каждой гипотезы спросите, какие свидетельства существенно её ослабят.
Что мы не ожидали бы наблюдать, если бы эта гипотеза была основным объяснением?
Для гипотезы о тайм-ауте прокси примеры включают сбои, происходящие значительно ниже настроенного порога, идентичные сбои при обходе прокси, отсутствие соответствующего события на стороне прокси или свидетельства того, что вышестоящее приложение первым разрывает соединение.
Это меняет цель поиска модели.
Поиск подтверждений: найдите свидетельства, совместимые с H1. Поиск опровержений: найдите наблюдения, которые H1 предсказывает плохо или которые H2 предсказывает существенно лучше.
Шаг 5 — Предпочитайте различающие проверки
Не каждая проверка одинаково информативна.
Предположим, H1 и H2 обе предсказывают повышенный уровень ошибок. Наблюдение ещё одной ошибки даёт мало для различения.
Лучшая проверка ищет наблюдение, на котором их предсказания расходятся.
Хорошая проверка: наблюдение, вероятное при H1, но маловероятное при H2, или наоборот.
При отладке обход подозреваемого прокси может быть различающим. В историческом исследовании демонстрация хронологии, делающей прямую передачу невозможной, может быть сильно различающей. В продуктовом анализе наблюдение того же снижения спроса на контрольном рынке, не затронутом предполагаемой причиной, может ослабить причинное объяснение.
Таким образом, методология ценит свидетельства не только по надёжности, но и по их способности различать конкурирующие объяснения.
Шаг 6 — Активно ищите контрсвидетельства
Как только потенциальные фальсификаторы и различающие наблюдения определены, система должна активно их искать.
Это требование важно, потому что сами языковые модели могут демонстрировать проверку гипотез с предвзятостью подтверждения.
В 2026 году Джавери, GX-Chen, Сухолутский и Чой адаптировали классическую задачу на открытие правил для одиннадцати языковых моделей из разных семейств и масштабов. Модели часто предлагали примеры, которые подтверждали их текущее правило, а не примеры, предназначенные для его опровержения.
Последствие было практическим: ориентированное на подтверждение исследование приводило к более медленному и менее успешному открытию скрытого правила.
Когда исследователи явно поощряли рассмотрение контрпримеров, средний успех в открытии правил вырос с 42% до 56% в описанных экспериментах.
Модели не нужна была новая база знаний. Ей нужна была лучшая стратегия проверки гипотез.
Это напрямую относится к более широкой методологии: качество рассуждения может улучшиться, когда процесс вывода меняется с поиска подтверждений на исследование, ориентированное на опровержение.
Шаг 7 — Отделите противоречие от отвержения
Обнаружение доказательств против гипотезы не всегда оправдывает немедленное отвержение.
Система должна сначала оценить качество контрдоказательств:
- Надёжно ли наблюдение?
- Является ли источник первичным или косвенным?
- Могут ли ошибка измерения или поиска объяснить конфликт?
- Действительно ли гипотеза предсказывает спорное наблюдение?
- Зависит ли противоречие от вспомогательного допущения?
- Подтверждаются ли контрдоказательства независимо?
- Объясняет ли конкурирующая гипотеза доказательства более успешно?
Только после этой оценки модель должна определить, ослаблена ли гипотеза, существенно пересмотрена или отвергнута.
Шаг 8 — Предотвратите ad hoc спасение
Гипотеза может стать фактически неопровержимой, если каждое противоречащее наблюдение порождает новое исключение.
Шаблон выглядит так:
Предсказание не удаётся → добавить исключение → предсказание снова не удаётся → добавить ещё одно исключение → сохранять исходный вывод бесконечно
Не каждая модификация является неправомерной. Научный и технический прогресс часто происходит потому, что неожиданные доказательства выявляют отсутствующую переменную или неверное вспомогательное допущение.
Методологическое различие состоит в том, создаёт ли пересмотр новые проверяемые следствия или лишь защищает предпочтительный вывод от провала.
Продуктивный пересмотр повышает объяснительную и предсказательную точность. Ad hoc спасение лишь уменьшает вероятность того, что гипотеза когда-либо сможет проиграть.
Шаг 9 — Обновляйте уверенность вместо защиты первоначального ответа
Результат рассуждения, ориентированного на фальсификацию, не обязательно должен быть бинарным.
Возможные состояния включают:
- Уверенно подтверждена: выдерживает серьёзные различающие проверки, а конкурирующие объяснения работают существенно хуже.
- Предварительно подтверждена: лучшее из доступных объяснений, но сохраняются важные неопределённости.
- Ослаблена: существуют значимые контрдоводы, но они не являются решающими.
- Недоопределена: несколько гипотез объясняют имеющиеся данные одинаково хорошо.
- Отвергнута: надёжные данные противоречат центральному предсказанию, а альтернативные объяснения работают лучше.
- Непроверяема на доступных данных: текущий корпус не позволяет содержательно различить утверждения.
Центральное правило просто: уверенность должна следовать за результатами проверок, а не за риторической привязанностью модели к своему первому ответу.
Матрица фальсификации
Для комплексного анализа гипотезы можно привести к матрице сравнения.
| Измерение | H1 | H2 | H3 |
| Основное утверждение | Определить точно | Определить точно | Определить точно |
| Ожидаемые данные | Перечислить предсказания | Перечислить предсказания | Перечислить предсказания |
| Потенциальные контрданные | Определить | Определить | Определить |
| Различающая проверка | Указать | Указать | Указать |
| Подтверждающие наблюдения | Зафиксировать | Зафиксировать | Зафиксировать |
| Противоречащие наблюдения | Зафиксировать | Зафиксировать | Зафиксировать |
| Вспомогательные допущения | Раскрыть | Раскрыть | Раскрыть |
| Текущий статус | Переоценить | Переоценить | Переоценить |
Матрица предотвращает распространённый сбой: применение строгой проверки к альтернативам при сохранении предпочтительной гипотезы в расплывчатом виде.
Негативные данные требуют особой осторожности
Отсутствие ожидаемых данных может ослабить гипотезу, но только при определённых условиях.
Утверждение «мы не нашли данных в пользу X» не эквивалентно утверждению «X не имело места».
Негативные данные становятся информативными, когда есть обоснованное ожидание, что при истинности гипотезы эти данные, вероятно, были бы наблюдаемы, сохранены, зарегистрированы, задокументированы или измеримы.
Отсутствие данных имеет наибольшее значение тогда, когда данных не должно было бы отсутствовать.
При отладке отсутствие обязательного события в журнале может быть значимым, если известно, что журналирование ведётся полностью. В историческом исследовании отсутствие в фрагментарном архиве обычно гораздо менее значимо. В анализе безопасности отсутствие оповещения мало что значит, если соответствующая телеметрия вообще не собиралась.
Поэтому модель должна оценивать как отсутствующие данные, так и вероятность того, что такие данные сохранились бы или были бы наблюдаемы.
Историческое исследование: передача versus сходство
Историческое исследование показывает, почему рассуждение, ориентированное на фальсификацию, должно учитывать специфику предметной области.
Предположим, две традиции содержат концептуально сходные идеи, и первоначальная гипотеза предполагает прямую передачу.
Подтверждающего сходства недостаточно. Гипотеза должна порождать дополнительные ожидания: хронологическую совместимость, правдоподобный географический контакт, посредников, текстовые или терминологические следы, документальные свидетельства или картину трансформации, согласующуюся с передачей.
Потенциально разрушительные наблюдения могут включать хронологию, обращающую предложенное направление, географическую изоляцию, несовместимую с заявленным механизмом, более ранние независимые примеры в обеих традициях или свидетельства того, что предполагаемая общая черта появилась только в гораздо более поздних переосмыслениях.
Ни одно отдельное отсутствие само по себе не обязательно опровергает историческую передачу. Но несколько независимых неудач могут уменьшить её объяснительное преимущество по сравнению с конвергенцией или косвенным наследованием.
Отладка программного обеспечения: от подозреваемого к первопричине
Отладка естественно выигрывает от фальсификации, потому что цель не в том, чтобы создать правдоподобное повествование вокруг сообщения об ошибке. Она в том, чтобы изолировать механизм, вызывающий сбой.
Полезный цикл отладки таков:
Симптом → возможные причины → предсказанные наблюдения → различающий тест → устранение причин → воспроизведение → первопричина
Гипотеза становится сильнее не потому, что в её пользу можно написать больше текста, а потому, что реалистичные альтернативы не проходят тесты, которые она проходит.
Архитектура программного обеспечения: фальсификация проектного решения
Архитектурные решения обычно нельзя фальсифицировать в строгом научном смысле, но их можно подвергнуть анализу, ориентированному на фальсификацию.
Предположим, гипотеза такова:
Микросервисная архитектура необходима для удовлетворения требований системы к масштабируемости и организационных требований.
Вместо перечисления преимуществ микросервисов анализ должен спросить, что сделало бы это утверждение ненужным.
Если реалистичное нагрузочное тестирование показывает, что модульный монолит удовлетворяет ожидаемому масштабу, если независимость развёртывания не требуется и если операционная сложность становится доминирующей стоимостью, исходное утверждение было существенно ослаблено.
Цель не в том, чтобы фальсифицировать микросервисы как технологию. Она в том, чтобы проверить конкретное архитектурное утверждение в рамках ограничений проекта.
Стратегия: что сделало бы бизнес-тезис ошибочным?
Бизнес-стратегия часто страдает от подтверждения, потому что доказательства можно интерпретировать постфактум.
Более сильный процесс определяет критерии неудачи до выполнения.
Если продуктовый тезис предсказывает, что целевой сегмент будет платить за определённую возможность, методология должна определить, какое наблюдаемое поведение ослабило бы это утверждение: низкая конверсия после квалифицированного контакта, повторный отказ по одной и той же причине, неспособность удержать целевую цену или свидетельства того, что клиенты решают проблему через альтернативный рабочий процесс.
Стратегия становится более проверяемой, когда её критерии успеха сопровождаются явными критериями неудачи.
Фальсификация — это не то же самое, что адвокат дьявола
Модель, которой поручено «аргументировать против этого вывода», всегда может сгенерировать возражения.
Это ещё не фальсификация.
Адвокат дьявола оптимизирует возражения. Рассуждение, ориентированное на фальсификацию, оптимизирует информативные проверки.
Хороший контраргумент звучит правдоподобно. Хороший тест на фальсификацию даёт результат, который меняет то, во что нам следует верить.
Это различие не позволяет процессу верификации деградировать до искусственного спора, в котором одна модель аргументирует за позицию, а другая автоматически аргументирует против неё.
Фальсификация и инвариантность к промпту работают вместе
Инвариантность к промпту и фальсификация проверяют разные зависимости.
| Метод | Основной вопрос | Обнаруживает |
| Инвариантность к промпту | Сохраняется ли вывод при альтернативных допустимых формулировках? | Зависимость от формулировки промпта |
| Фальсификация | Выдерживает ли гипотеза доказательства, предназначенные для её оспаривания? | Зависимость от подтверждения и слабого тестирования |
Гипотеза может пройти одну проверку и не пройти другую.
Модель может воспроизвести один и тот же неверный вывод при нескольких формулировках промпта, обеспечивая высокую устойчивость к формулировке, но низкую доказательную валидность. И наоборот, сильная гипотеза может казаться нестабильной, потому что разные промпты выявляют разные подмножества неполных доказательств.
Сочетание обоих методов создаёт более сильную последовательность:
Вариация формулировок → конкурирующие гипотезы → ожидаемые наблюдения → контрдоказательства → различающие тесты → обновление уверенности
Не позволяйте одному и тому же агенту некритично оценивать собственный тест
Есть ещё одна архитектурная проблема.
Если одна и та же модель генерирует гипотезу, разрабатывает тест, интерпретирует доказательства и решает, выжила ли гипотеза, её ошибки могут распространяться через каждый этап.
Это не делает процесс бесполезным, но мотивирует разделение ролей.
Генератор гипотез → разработчик тестов → сборщик доказательств → критик → верификатор → финальный синтезатор
Эти роли не обязательно требуют шести разных моделей. Они могут быть реализованы как изолированные проходы вывода с отдельным контекстом, контролируемыми доказательствами и структурированными выходами.
Важное свойство — процедурная независимость: последующие этапы не должны просто наследовать риторическую приверженность исходному ответу.
Это становится технической темой Проектирование слоя эпистемической верификации для LLM.
Общий ориентированный на фальсификацию рабочий процесс ИИ
Проблема → нормализация доказательств → конкурирующие гипотезы → предсказания → потенциальные фальсификаторы → различающие тесты → поиск контрдоказательств → проверка вспомогательных допущений → сравнение гипотез → перекалибровка уверенности → заключение
Этот рабочий процесс не требует, чтобы каждая задача вела себя как лабораторная наука.
Вместо этого он извлекает общий эпистемический принцип из фальсификации: объяснения должны подвергаться условиям, при которых они могут потерпеть неудачу.
Точный валидатор затем меняется в зависимости от области.
Исторический анализ проверяет хронологию, происхождение и передачу. Отладка проверяет наблюдаемое поведение системы. Архитектура проверяет требования и ограничения. Стратегия проверяет рыночные допущения и предопределённые критерии отказа.
Это доменно-независимое ядро и его доменно-специфичные валидаторы развиваются дальше в От исследовательского протокола к общему фреймворку рассуждений ИИ.
Чего фальсификация не может сделать
- Она не может сделать неполные доказательства полными.
- Она не может гарантировать, что была сгенерирована правильная альтернативная гипотеза.
- Она не может устранить ошибки, общие для модели, источников и процесса оценки.
- Она не может превратить по своей сути интерпретационные утверждения в лабораторные эксперименты.
- Она не может рассматривать каждое отсутствующее наблюдение как доказательство против гипотезы.
- Она не может автоматически определить, какое вспомогательное допущение оказалось несостоятельным, когда предсказание опровергнуто.
- Она не может доказать истинность выжившей гипотезы.
- Она не может заменить эксперименты, первоисточники, предметную экспертизу или эмпирические измерения там, где они необходимы.
Гипотезу, которая выживает после повторных попыток фальсификации, лучше описывать как подтверждённую проведёнными тестами, чем как доказанную.
Центральный принцип
Генеративный ИИ делает подтверждение дешёвым.
При достаточно правдоподобном утверждении мощная языковая модель обычно может создать вокруг него аргументы, аналогии, подтверждающие факты и связные нарративы.
Именно поэтому подтверждение не должно быть окончательной проверкой.
Надёжный процесс рассуждения не должен спрашивать только о том, почему гипотеза может быть верной. Он также должен определять, как гипотеза может быть ошибочной.
Таким образом, качество вывода ИИ зависит не только от того, сколько подтверждающих доказательств система может найти, но и от того, была ли у конкурирующих объяснений возможность победить.
Это меняет роль модели.
Она больше не является просто генератором ответов.
Она становится участником контролируемого процесса, в котором её собственное первоначальное объяснение является предварительным, проверяемым и заменяемым.
Самый сильный ответ ИИ — не тот, у которого больше всего подтверждающих аргументов. Это тот, чьим сильнейшим альтернативам была предоставлена справедливая возможность опровергнуть его.
Контекст исследования
Методология в этой статье адаптирует идеи из философии науки и современных эмпирических исследований рассуждений языковых моделей. Фальсификационизм Карла Поппера подчёркивал, что научные утверждения должны подвергать себя возможным наблюдениям, которые противоречат им, в то время как более поздняя философия науки ясно показала, что практическая фальсификация сложнее, чем простое отвержение гипотезы после одного аномального наблюдения.
Это различие важно для систем ИИ, потому что реальные проверки обычно зависят от вспомогательных допущений, качества доказательств и интерпретации. Поэтому рассуждения ИИ, ориентированные на фальсификацию, используют логику опровержения, не притворяясь, что каждое сложное аналитическое утверждение можно свести к одному решающему эксперименту.
Исследование 2026 года Джавери, GX-Chen, Сухолутского и Чоя даёт прямую эмпирическую мотивацию для этого дизайна. На одиннадцати LLM авторы обнаружили подтверждающе-смещённое исследование гипотез в интерактивной задаче открытия правил. Подсказка моделям рассматривать контрпримеры последовательно уменьшала это смещение и увеличивала средние показатели открытия правил с 42% до 56%.
Эти результаты не демонстрируют, что полная методология, предложенная здесь, была экспериментально подтверждена как единая структура. Они поддерживают более узкое и важное утверждение: явные вмешательства в сторону опровергающих доказательств могут улучшить исследование гипотез LLM.
Избранные ссылки
- Поппер, К. Р. — Логика научного исследования. Английское издание, 1959.
- Поппер, К. Р. — Предположения и опровержения: Рост научного знания. 1963.
- Стэнфордская философская энциклопедия — Научный метод, разделы о гипотетико-дедуктивной проверке и фальсификационизме.
- Стэнфордская философская энциклопедия — Карл Поппер, обсуждение базовых утверждений, фальсифицируемости и практических сложностей фальсификации.
- Джавери, А. Р., GX-Chen, А., Сухолутский, И. и Чой, Э. — Неспособность фальсифицировать: Оценка и смягчение предвзятости подтверждения в языковых моделях. arXiv:2604.02485, 2026.
Продолжить серию
- За пределами промпт-инжиниринга: методология для более надёжных рассуждений ИИ — полная методологическая структура.
- Промпт — часть предвзятости — почему формулировка и предположения пользователя могут влиять на рассуждения ИИ.
- Инвариантность промпта: выживает ли вывод при изменении промпта? — проверка того, выживают ли выводы при слепых, инвертированных и состязательных формулировках.
- От исследовательского протокола к общей структуре рассуждений ИИ — преобразование методологии в независимый от предметной области процесс рассуждения.
Related Articles
ComfyUI на Fedora 43: две виртуальные среды + запуск в один клик (март 2026)
Цель: сохранить два виртуальных окружения Python (например, 3.12 + 3.14) для совместимости, но запускать ComfyUI автоматически с чистой и легковесной конфигурацией.
Резервное переключение Dual-SIM на ZBT Z8102AX: что работает, чего не хватает и что требует лучшей прошивки
ZBT Z8102AX — это 5G-роутер OpenWrt с поддержкой двух SIM-карт, но одно лишь аппаратное обеспечение с поддержкой двух SIM-карт — это не то же самое, что интеллектуальное резервирование. Роутер распознает SIM-карту и успешно подключается, но автоматическое переключение, восстановление модема, решения на основе сигнала и четкая логика резервирования все еще требуют более глубокого тестирования.
Комплексное руководство по триггерам отката в корпоративных AI-ранбуках
Это руководство рассматривает триггеры отката, важные механизмы в корпоративных AI-ранбуках, которые автоматически обнаруживают аномалии и инициируют откаты для поддержания стабильности системы. Узнайте, как настраивать, отслеживать и оптимизировать эти триггеры для надежных AI-развертываний.
Повышение производительности с ERP-системами: Тематическое исследование по реляционным базам данных
Ollama — это не продукт: создание готовых к продакшену приложений на базе открытых LLM
Запустить локальную модель с Ollama просто. Создать готовое к продакшену Open-LLM-приложение сложнее: для этого требуются RAG, контроль доступа, абстракция провайдеров, оценка, логирование, дисциплина развертывания и контролируемый уровень приложения вокруг модели.
Освоение рабочего процесса SEO: Основные стратегии оптимизации для органического роста
Структурированный рабочий процесс SEO крайне важен для устойчивого органического роста. Изучите десять основополагающих стратегий, от исследования ключевых слов и технической оптимизации до качества контента и анализа производительности.
Техники создания хешей паролей SHA512 с использованием doveadm
Подробная инструкция по безопасному созданию хешей паролей SHA512 с помощью командной строки с использованием инструмента doveadm для Dovecot. Этот article предназначен для системных администраторов и разработчиков.
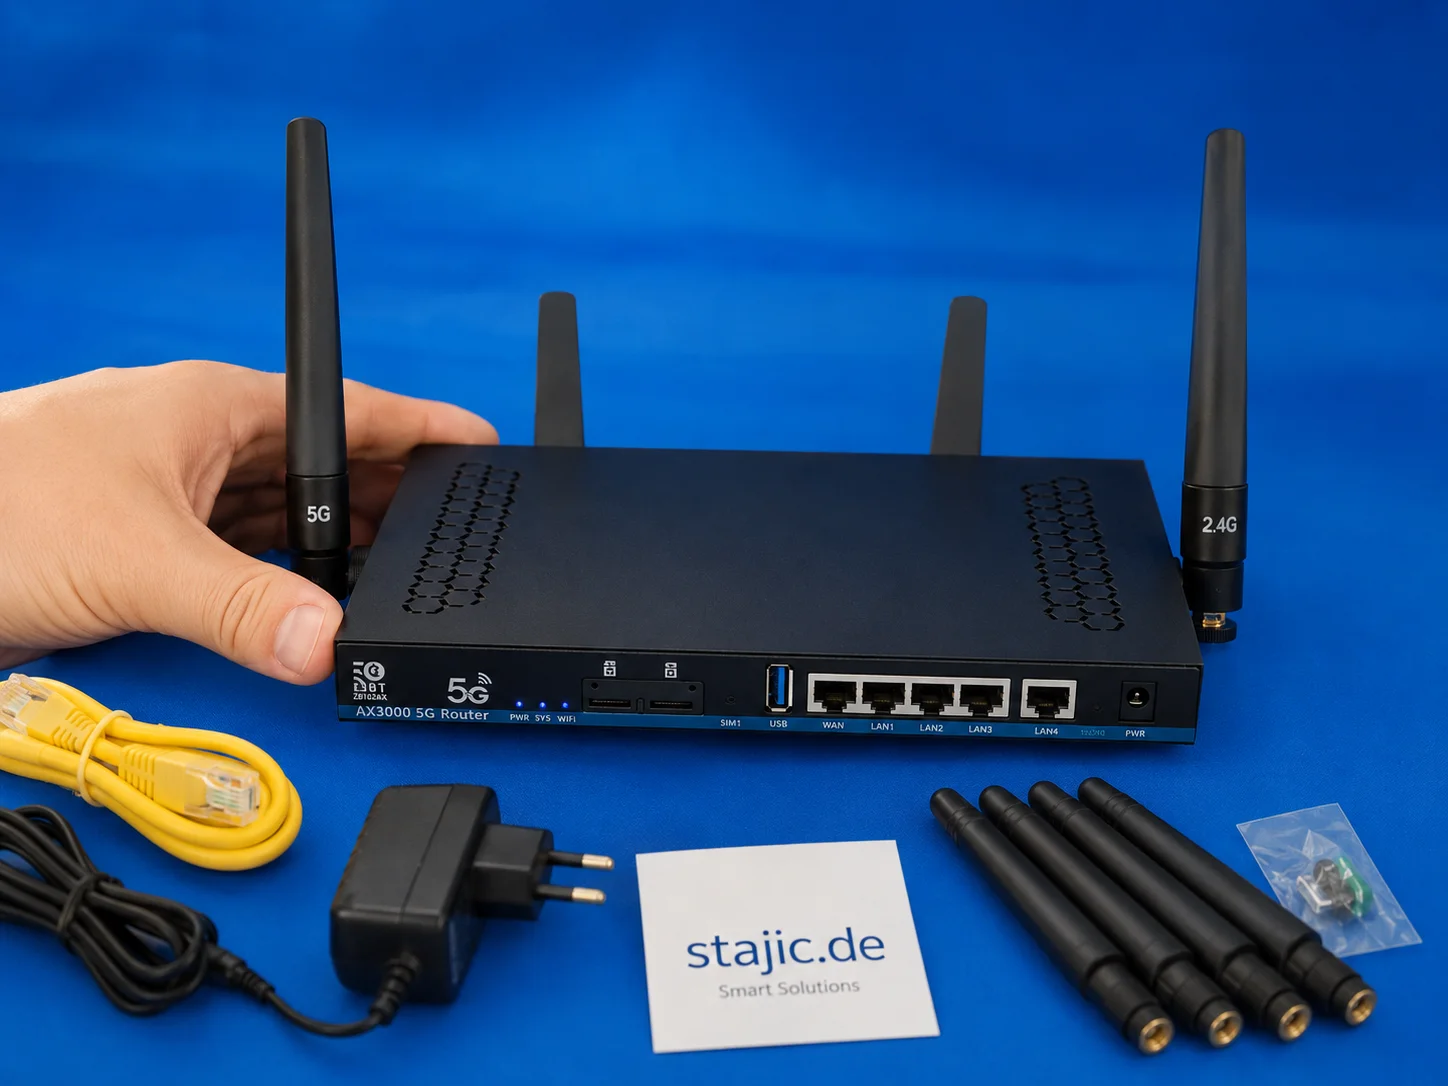
Обзор 5G-роутера ZBT Z8102AX на OpenWrt: две SIM-карты, RM500U-EA и честная оценка
ZBT Z8102AX — это необычный 5G-роутер на базе OpenWrt, с концепцией двух SIM-карт и модемом Quectel RM500U-EA. В ходе тестирования он демонстрирует явные сильные стороны в гибкости, интерфейсах и мобильной связи, но также и типичные недостатки модифицированной производителем сборки OpenWrt.
Фронтенд- и бэкенд-разработка
Фронтенд- и бэкенд-разработка является неотъемлемой частью веб-разработки и включает в себя создание веб-приложений и веб-сайтов. Фронтенд-разработка сосредоточена на пользовательском интерфейсе, в то время как бэкенд-разработка отвечает за программирование и управление серверной частью.
Enterprise Start Here: Your Gateway to Operational Excellence
New to our enterprise platform? This guide provides a structured onboarding path, from foundational reference models to actionable playbooks, runbooks, and assessments designed for seamless implementation.
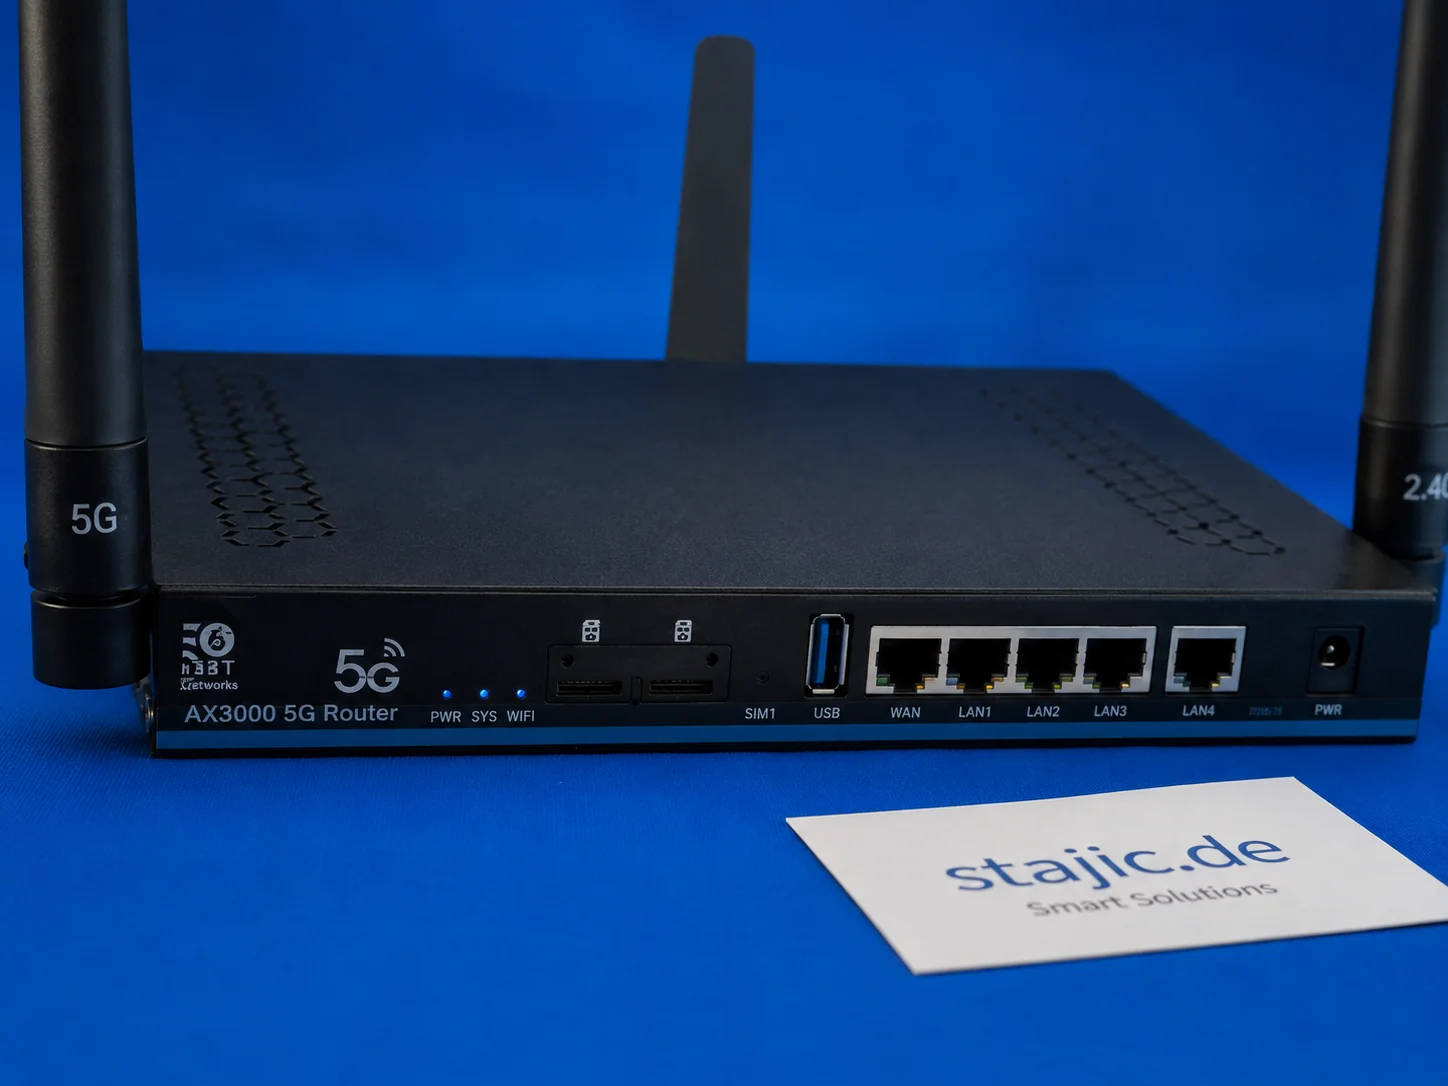
Quectel RM500U-EA в ZBT Z8102AX: диапазоны 5G, o2 Germany и поведение сигнала в реальных условиях
ZBT Z8102AX использует модем Quectel RM500U-EA для подключения 4G и 5G. В первом практическом тесте роутер успешно подключился к o2 Germany с LTE Band 3 и NR n28. Модем работает, но более глубокая диагностика, такая как RSRP, RSRQ, SINR, блокировка диапазонов и поведение сот, все еще требует надлежащего тестирования.
Маркетинг баз данных: современный подход к взаимоотношениям с клиентами
Маркетинг баз данных имеет решающее значение для современного управления взаимоотношениями с клиентами. Узнайте, как стратегическое использование данных, техническая экспертиза и инновации способствуют персонализированным взаимодействиям с клиентами и устойчивому росту.