
Комплексное руководство по метрикам для управления доставкой и изменениями
# Полное руководство по метрикам для управления доставкой и изменениями
В корпоративных средах эффективное управление доставкой и изменениями опирается на аналитику, основанную на данных. Метрики служат основой для оценки производительности, выявления узких мест и обеспечения соответствия стратегическим целям. Это руководство охватывает ключевые метрики в конвейерах доставки, процессах изменений и общей реализации ценности, а также практические шаги по внедрению.
## Почему метрики важны при управлении доставкой и изменениями
Метрики превращают субъективные мнения в объективные данные, позволяя командам: - Отслеживать прогресс в достижении целей - Прогнозировать и снижать риски - Оптимизировать распределение ресурсов - Демонстрировать ROI заинтересованным сторонам
Без надежных метрик организации рискуют разрозненными усилиями, длительными простоями и провалами трансформаций.
## Основные метрики доставки
### 1. Частота развертываний Измеряет, как часто код развертывается в продакшен. - **Цель**: Ежедневно или несколько раз в день для элитных исполнителей (стандарты DORA) - **Расчет**: Количество развертываний в день/неделю/месяц - **Практические шаги**: 1. Интегрировать отслеживание развертываний в CI/CD-конвейер 2. Сегментировать по средам (dev/staging/prod) 3. Сравнивать с отраслевыми стандартами
### 2. Время выполнения изменений Время от коммита до развертывания в продакшен. - **Цель**: Менее одного дня - **Расчет**: Среднее время по всем изменениям - **Практические шаги**: 1. Использовать инструменты вроде GitHub Actions или Jenkins для автоматического логирования 2. Выявлять задержки на этапах ревью, тестирования или согласования 3. Автоматизировать процессы, где возможно, чтобы снизить человеческие узкие места
### 3. Частота провалов изменений Процент развертываний, вызвавших сбои в продакшене. - **Цель**: 0-15% - **Расчет**: (Проваленные изменения / Всего изменений) × 100 - **Практические шаги**: 1. Определить понятие «провал» (например, откат, хотфикс, деградация сервиса >1 ч) 2. Внедрять canary-релизы и feature flags 3. Проводить постмортемы после сбоев
### 4. Среднее время восстановления (MTTR) Среднее время восстановления сервиса после сбоя. - **Цель**: Менее одного часа - **Расчет**: Общее время простоя / Количество инцидентов - **Практические шаги**: 1. Настроить оповещения с PagerDuty или Opsgenie 2. Автоматизировать процедуры отката 3. Проводить учения по chaos engineering
## Ключевые метрики управления изменениями
### 1. Успешность изменений Доля изменений, реализованных без проблем. - **Цель**: >85% - **Расчет**: (Успешные изменения / Всего изменений) × 100 - **Практические шаги**: 1. Стандартизировать шаблоны запросов на изменения 2. Требовать оценки рисков и рецензирования 3. Отслеживать через ITSM-инструменты, такие как ServiceNow
### 2. Объём изменений и бэклог Количество обработанных изменений по сравнению с ожидающими. - **Цель**: Бэклог <10% от месячного объёма - **Расчет**: Ожидающие изменения / Всего поданных - **Практические шаги**: 1. Приоритизировать с помощью метода MoSCoW 2. Внедрять change advisory boards (CAB) 3. Отслеживать время цикла от запроса до одобрения
### 3. Доля экстренных изменений Соотношение срочных изменений к общему количеству. - **Цель**: <10% - **Расчет**: (Экстренные изменения / Всего) × 100 - **Практические шаги**: 1. Анализировать коренные причины экстренных ситуаций 2. Переходить к проактивному обслуживанию 3. Обеспечивать пост-рецензирование изменений
## Метрики реализации ценности
### 1. Доставленная бизнес-ценность Количественная оценка влияния изменений на ключевые результаты. - **Примеры**: Рост выручки, экономия затрат, вовлечённость пользователей - **Расчет**: Дельта KPI до/после изменения - **Практические шаги**: 1. Помечать изменения ожидаемыми бизнес-результатами 2. Использовать фреймворки OKR для согласования 3. Отчитываться ежеквартальными карточками ценности
### 2. Удовлетворённость клиентов (CSAT) Обратная связь по реализованным изменениям. - **Цель**: >4/5 баллов - **Расчет**: Средняя оценка опроса после развертывания - **Практические шаги**: 1. Автоматизировать опросы NPS/CSAT 2. Коррелировать с метриками развертываний 3. Итеративно улучшать на основе качественной обратной связи
## Внедрение фреймворка метрик
1. **Выбор метрик**: Начните с четырёх ключевых метрик DORA, затем добавьте метрики, специфичные для изменений. 2. **Инструменты**: Используйте платформы наблюдаемости (Datadog, New Relic), интегрированные с ITSM. 3. **Дашборды**: Создавайте представления в реальном времени в Grafana или Tableau. 4. **Бенчмаркинг**: Сравнивайте с отраслевыми аналогами по отчёту Accelerate State of DevOps. 5. **Частота обзоров**: Еженедельные командные обзоры, ежемесячные обновления для руководства. 6. **Циклы действий**: Связывайте метрики с ретроспективами и планированием PI.
## Распространённые ошибки и лучшие практики
- **Ошибка**: Метрики тщеславия (например, строки кода) – фокусируйтесь на результатах. - **Лучшая практика**: Контекст имеет значение; сегментируйте по команде/сервису. - **Ошибка**: Перегрузка метриками – ограничьтесь 7–10 ключевыми. - **Лучшая практика**: Автоматизируйте сбор данных для обеспечения точности.
Регулярно уточняйте свои метрики, чтобы отражать меняющиеся приоритеты. Для успеха в масштабе предприятия интегрируйте их в ваши референсные модели поставки и изменений.
Related Articles
Ollama — это не продукт: создание готовых к продакшену приложений на базе открытых LLM
Запустить локальную модель с Ollama просто. Создать готовое к продакшену Open-LLM-приложение сложнее: для этого требуются RAG, контроль доступа, абстракция провайдеров, оценка, логирование, дисциплина развертывания и контролируемый уровень приложения вокруг модели.
Google I/O 2026: Android XR, интеллектуальные очки и эмбиентный ИИ-интерфейс
Google I/O 2026 продвинула Android XR и умные очки от концепта к направлению реальной платформы. В этой статье разбираются аудиоочки, очки с дисплеем, контекстная осведомленность на базе Gemini, последствия для разработчиков, риски для конфиденциальности, а также то, почему носимый ИИ — это не столько замена телефонов, сколько создание поверхностей фоновой помощи.
От исследовательского протокола к универсальному фреймворку рассуждений ИИ
Методология, разработанная для строгих исследований с применением ИИ, может быть обобщена далеко за пределы самих исследований. Благодаря отделению доказательств от предположений, проверке конкурирующих гипотез, контролю фрейминга промптов, поиску опровергающих доказательств и применению предметно-ориентированных валидаторов та же архитектура рассуждений может улучшить отладку, проектирование программного обеспечения, стратегию, технический анализ и поддержку принятия решений с применением ИИ.
MLOps против LLMOps: что меняется, когда модель — это LLM
MLOps управляет системами машинного обучения; LLMOps распространяет эти практики на промпты, контекст, извлечение, провайдеров, инструменты, оценки и поведение во время выполнения вокруг больших языковых моделей.
OpenAI Agents API против Agents SDK против Responses API: на чем вам стоит разрабатывать в 2026 году?
Стек агентов OpenAI изменился в сентябре 2026 года. Это архитектурное руководство разделяет Agents API, Agents SDK, Responses API и Codex SDK по владению средой выполнения — чтобы команды могли выбрать правильную границу контроля вместо сравнения названий продуктов.
Google I/O 2026: Antigravity, AI Studio и переход к агентным DevTools
Google I/O 2026 ясно дала понять инженерам одну вещь: ИИ-инструменты выходят за рамки автодополнения и переходят к управляемому агентному выполнению. В этой статье подробно разбираются Antigravity 2.0, растущая роль Google AI Studio, Gemini 3.5 Flash, а также реальные компромиссы, связанные с оркестрацией, привязкой к платформе, верификацией и проектированием рабочих процессов разработчиков.
Что такое контекстная инженерия? Что получает модель до того, как она отвечает
Проектирование контекста определяет, какую информацию модель ИИ получает перед выводом, включая подсказки, извлечение, память, состояние приложения, результаты работы инструментов и историю разговоров.
Что такое архитектор ИИ-решений? Границы системы, обязанности и компромиссы
Архитектор решений ИИ превращает бизнес-требования в готовую к производству систему ИИ, охватывающую данные, модели, инструменты, безопасность, среду выполнения, оценку и операции.
Google I/O 2026: Архитектурные сдвиги, агентный ИИ и проверка единой экосистемы реальностью
Google I/O 2026 была не просто событием, посвященным моделям. Она продемонстрировала более глубокий платформенный сдвиг, охватывающий модели Gemini, инструменты для разработчиков, связанные с Android интерфейсы и интеллектуальные устройства. Эта статья разбирает ключевой доклад как центральный материал для инженеров, архитекторов и продуктовых команд, которым необходимо отделить реальные последствия для среды выполнения от хайпа со сцены.
GPU — не продукт: перспективная архитектура приватного ИИ
Инфраструктура приватного ИИ не должна проектироваться вокруг одного GPU или одной модели. Более устойчивый подход объединяет быстрые GPU для инференса, ИИ-системы с большим объемом памяти, узлы физического ИИ и опциональные передовые облачные модели за уровнем маршрутизации, учитывающим возможности.
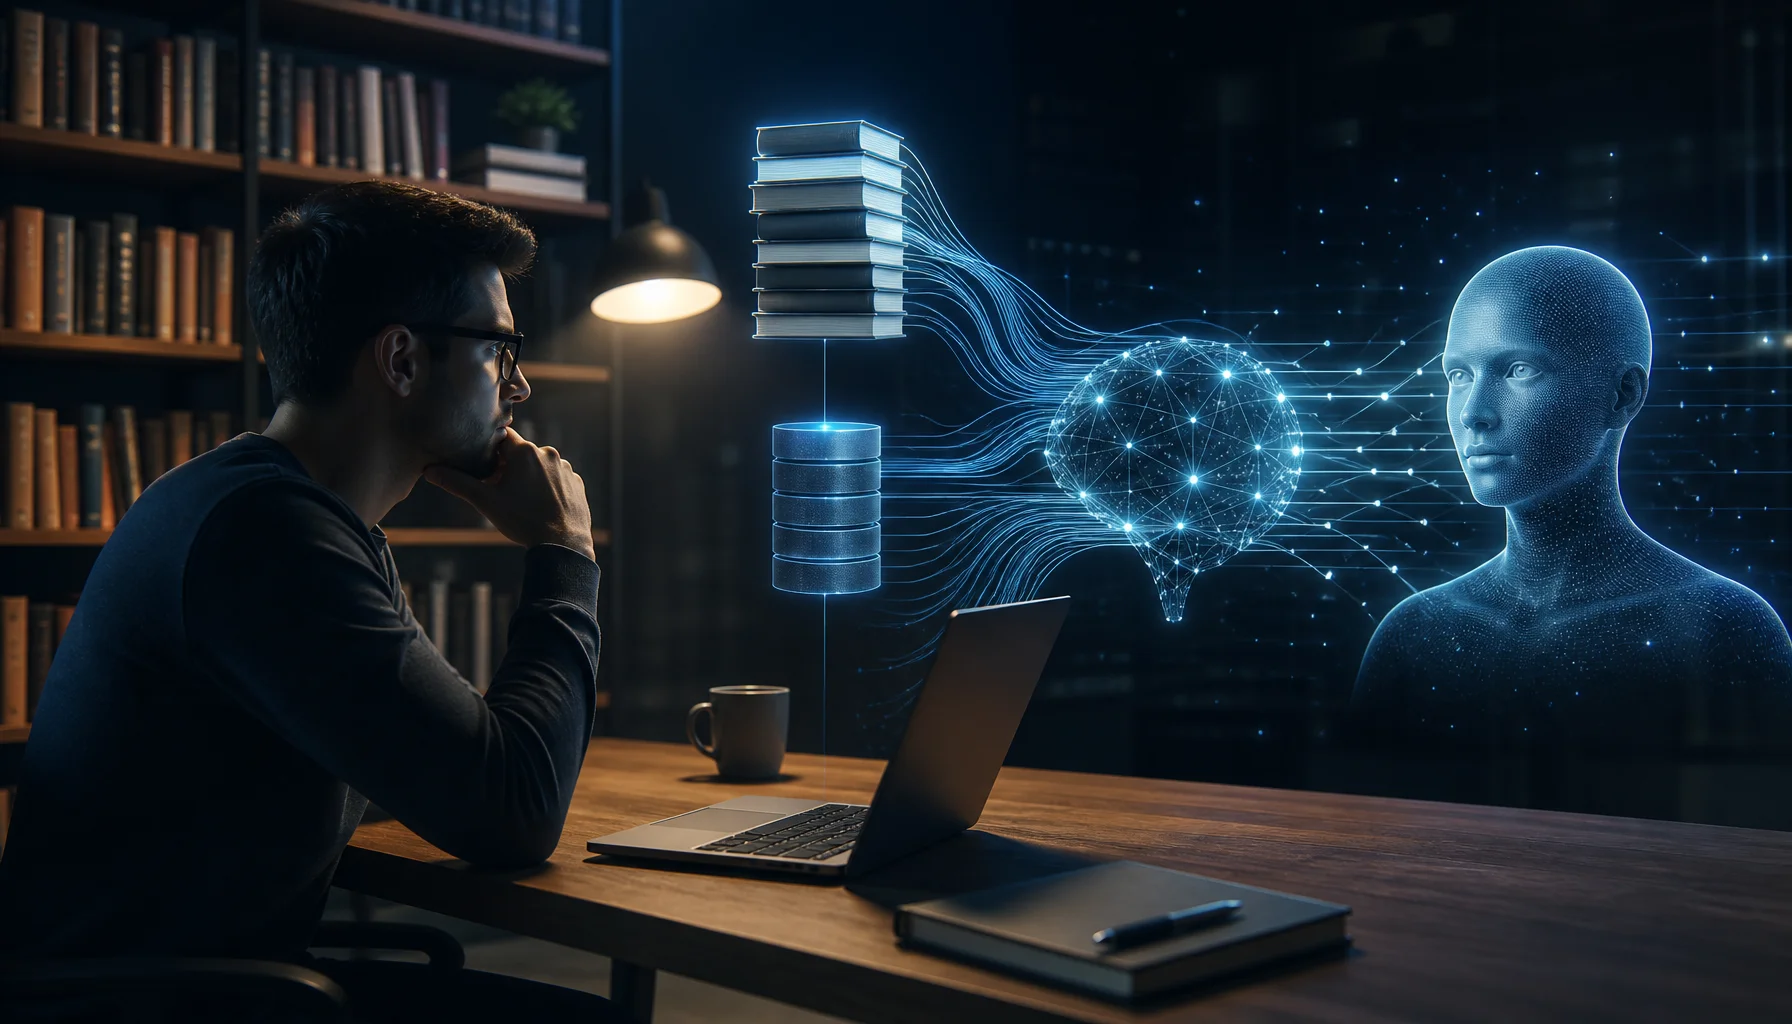
Что такое RAG? Самое простое объяснение того, как это работает
RAG звучит сложно, но идея проста: прежде чем ИИ ответит, он сначала находит полезную информацию из источника знаний и передаёт эту информацию языковой модели. В этом руководстве объясняются RAG, LLM, состояние, память и инструменты с помощью одной простой ментальной модели.
Обзор прошивки ZBT Z8102AX OpenWrt 21.02: достаточно стабильна, но готова ли она к будущему?
ZBT Z8102AX работает под управлением модифицированной производителем сборки OpenWrt 21.02 с ядром 5.4.246. В ходе практического тестирования прошивка работала успешно и обеспечивала стабильную работу роутера в течение нескольких дней, но устаревшая база вызывает важные вопросы о безопасности, управлении модемом, путях обновления и долгосрочной поддержке.