Комплексное руководство по триггерам отката в корпоративных AI-ранбуках
# Руководство по триггерам отката
## Введение в триггеры отката
В корпоративных AI-ранбуках триггеры отката служат автоматическими защитными механизмами, которые обнаруживают проблемы развертывания и возвращают к стабильной предыдущей версии. Эти триггеры критически важны для минимизации простоев, защиты пользовательского опыта и обеспечения соответствия требованиям в высоконагруженных AI-средах. Определяя точные условия для отката, команды могут реагировать на сбои за секунды, а не за часы.
Триггеры отката бесшовно интегрируются с CI/CD-конвейерами, инструментами мониторинга и AI-специфичными метриками, такими как дрейф модели или всплески задержки инференса.
## Ключевые преимущества триггеров отката
- **Быстрое восстановление**: Автоматически отменять изменения в течение секунд после обнаружения проблем. - **Снижение человеческого фактора**: Устраняет необходимость ручного вмешательства в панических ситуациях. - **Обеспечение соответствия**: Регистрирует все события триггеров для аудиторских журналов. - **Экономия затрат**: Предотвращает длительное воздействие неисправных моделей, вызывающих высокие вычислительные затраты. - **Масштабируемость**: Легко обрабатывает тысячи микросервисов или вариантов моделей.
## Типы триггеров отката
### 1. Триггеры на основе метрик
Мониторинг количественных KPI, таких как: - Частота ошибок превышает 5%. - Задержка увеличивается свыше 200 мс по p95. - Использование CPU/памяти превышает 90%.
### 2. Триггеры обнаружения аномалий
Использование AI-управляемого обнаружения аномалий: - Внезапное падение точности модели. - Необычные паттерны трафика, указывающие на сбои A/B-тестов. - Показатели дрейфа данных, превышающие предопределенные пороги.
### 3. Триггеры Canary и Blue-Green
Триггеры, специфичные для развертывания: - Сбой канареечного развертывания (например, <80% здоровых экземпляров). - Обратное переключение Blue-Green при расхождениях в теневом трафике.
### 4. Ручные и внешние триггеры
- API-эндпоинты для откатов по требованию. - Интеграция с PagerDuty или Slack для ручного переопределения.
## Настройка триггеров отката: пошагово
### Шаг 1: Определение условий триггера
В YAML-конфигурации вашего ранбука:
- Установите пороги: `error_rate > 0.05 for 2m`. - Укажите окна оценки: Скользящие 5-минутные средние. - Добавьте гистерезис для предотвращения флаппинга: `>5% up, <3% down`.
### Шаг 2: Выберите область отката
Выберите уровень детализации: - **Model-Level**: Откат конкретных версий ИИ-моделей. - **Service-Level**: Откат всего микросервиса. - **Cluster-Level**: Откат развёртываний Kubernetes.
### Шаг 3: Интегрируйте мониторинг
Подключитесь к инструментам вроде Prometheus, Datadog или кастомным платформам наблюдаемости ИИ:
- Экспортируйте метрики через эндпоинт `/metrics`. - Определяйте алерты с помощью запросов `PromQL`. - Включите уведомления через вебхуки для внешних систем.
### Шаг 4: Протестируйте триггеры
- **Dry-Run Mode**: Симулируйте сбои без реальных откатов. - **Chaos Engineering**: Внедряйте сбои с помощью инструментов вроде Gremlin. - **Historical Replay**: Тестируйте на данных прошлых инцидентов.
### Шаг 5: Развёртывание и мониторинг
- Развёртывайте через GitOps (ArgoCD, Flux). - Настройте дашборды для истории срабатываний триггеров. - Еженедельно анализируйте ложные срабатывания.
## Лучшие практики для эффективных триггеров отката
- **Multi-Trigger Logic**: Используйте комбинации AND/OR (например, высокая ошибка И задержка). - **Grace Periods**: Давайте 30–60 с на прогрев после развёртывания. - **Version Pinning**: Всегда откатывайтесь к известным стабильным версиям, а не к последним. - **Alert Fatigue Prevention**: Группируйте связанные метрики в составные триггеры. - **Post-Rollback Analysis**: Автоматически генерируйте отчёты об инцидентах.
## Распространённые ошибки и решения
| Проблема | Решение | |--------|----------| | Ложные срабатывания | Увеличьте окно оценки и добавьте несколько условий. | | Медленное обнаружение | Используйте интервалы опроса менее минуты. | | Неполные откаты | Проверяйте успешность отката с помощью health checks. | | Слишком агрессивные триггеры | Внедряйте поэтапные откаты (50% -> 100%). |
## Продвинутые возможности
- **ML-Optimized Triggers**: Автоматически настраивайте пороги с помощью reinforcement learning. - **Federated Triggers**: Координируйте откаты в мультиоблачных средах. - **Predictive Triggers**: Используйте прогнозирование временных рядов для предотвращения проблем.
## Мониторинг и обслуживание
Отслеживайте эти KPI: - Частота срабатывания триггеров (цель: <1% развёртываний). - Среднее время до отката (цель: <30 с). - Успешность откатов (цель: 99.9%).
Регулярно проводите аудит конфигураций во время спринт-ревью.
## Заключение
Триггеры отката превращают развертывание ИИ из рискованных экспериментов в надежные производственные системы. Проактивно определяя и совершенствуя эти механизмы, корпоративные команды достигают беспрецедентной стабильности и скорости. Начните с базовых метрических триггеров и перейдите к обнаружению аномалий на основе ИИ для достижения оптимальных результатов.
Related Articles
ADR vs NFR: архитектурные решения и качество системы — это не одно и то же
ADR против NFR: узнайте, как требования к качеству системы определяют архитектурные решения, как ADR фиксируют компромиссы и почему валидация остаётся отдельной.
Насколько утверждение об ИИ далеко от доказательств? — Дистанция доказательств
Не все поддерживаемые ответы одинаково близки к своим доказательствам. Дистанция доказательств — это практичный способ описать, сколько преобразований, обобщений, допущений и шагов вывода отделяют утверждение ИИ от непосредственно проверяемых доказательств.
Граница достоверности ответа: недостающий слой между релевантностью и надёжными ответами ИИ
Источник может быть релевантным, авторитетным и при этом неверным для задаваемого вопроса. Недостающий слой — применимость: условия, при которых ответ остаётся в силе, и изменения, вынуждающие пересмотреть его. В этой статье вводится понятие «Граница действительности ответа» как паттерн проектирования источников для людей, ИИ-поиска и RAG-систем.
RAG не сработал — но какой именно слой на самом деле отказал? Метод диагностики
Когда ответ RAG неверен, обвинять поиск или модель — слишком расплывчато. Этот диагностический метод изолирует покрытие источников, построение запроса, поиск, ранжирование, сборку контекста, генерацию, атрибуцию доказательств и актуальность — так что фактический сбой можно воспроизвести и исправить.
Каноническая архитектура, Дизайн URL, Логика резолвера, Спецификация API и масштабируемости
Геоориентированная архитектура обнаружения для мультитенантных порталов. Определяет канонические URL-адреса, логику разрешения, стратегию кэширования и гео-модель чтения без привязки к CMS или рефакторинга базы данных. Разработано для стабильности SEO, масштабируемости и будущих расширений, таких как бронирование и карты.
Новые тренды Linux в 2026 году: формирование будущего серверной инфраструктуры
Изучите ключевые тренды Linux 2026 года: от доминирования Kubernetes и неизменяемых дистрибутивов до интеграции ИИ и безопасности eBPF.
Агенты для управления компьютером: почему успешная демонстрация всё ещё может быть ненадёжной системой
Агенты для управления компьютером теперь могут выполнять впечатляющие рабочие процессы в браузере и на рабочем столе, но один успешный запуск доказывает способность—а не надежность. В этой статье показано, как проверять повторяемость, устойчивость к условиям среды, управление на длинном горизонте, осведомленность о состоянии, верификацию результатов и безопасную обработку целей.
Когда ИИ должен перестать доверять собственным знаниям? — Триггер извлечения
Модель ИИ не нуждается в поиске для каждого вопроса. Важная проблема — знать, когда её внутренних знаний уже недостаточно. Триггер поиска — это практическая граница принятия решений, которая определяет, когда система ИИ должна перестать полагаться исключительно на знания модели и получить внешние доказательства перед ответом.
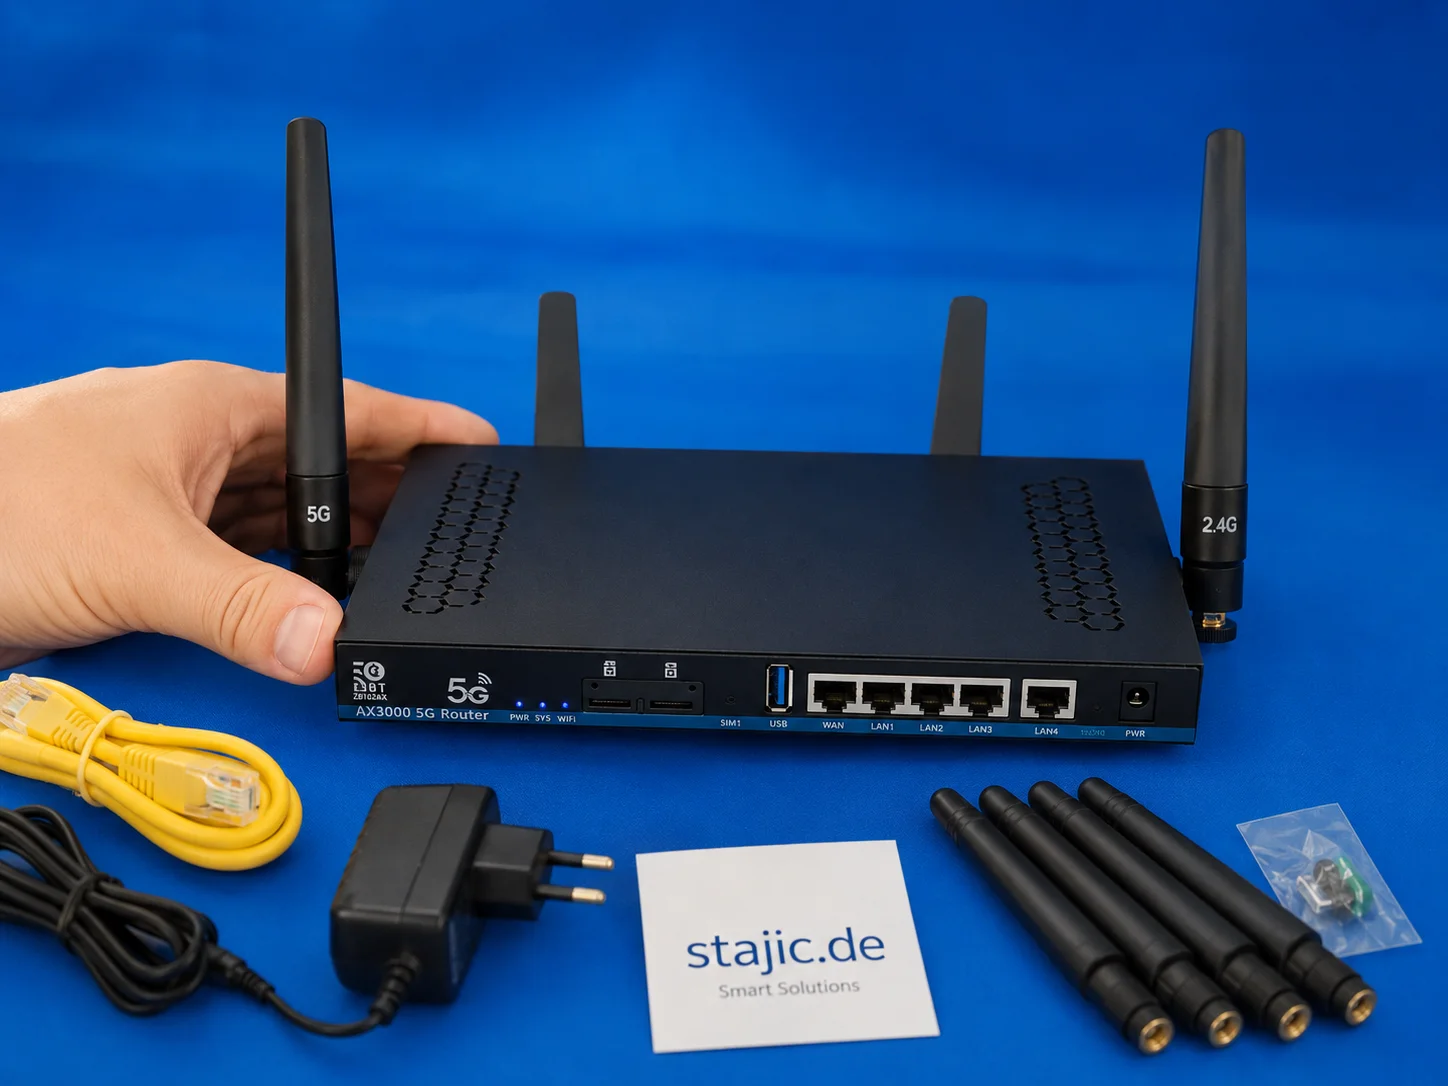
Следующий 5G-роутер OpenWrt: почему важны Wi-Fi 7, более мощный процессор и улучшенная прошивка
ZBT Z8102AX — полезный первый образец, но следующий шаг должен быть сильнее: Wi-Fi 7, более мощная четырёхъядерная платформа, лучшая ясность прошивки, улучшенная упаковка и более стабильная ценовая политика. Цель — не просто ещё один 5G-маршрутизатор, а лучше настроенное устройство на базе OpenWrt для продвинутых пользователей.
Управление ИИ: модели, данные, разрешения, риски и аудируемость
Управление ИИ определяет, кто может утверждать, эксплуатировать, изменять и проводить аудит систем ИИ на уровне моделей, поставщиков, данных, разрешений, рисков, оценки и на протяжении всего жизненного цикла.
Google I/O 2026: Архитектурные сдвиги, агентный ИИ и проверка единой экосистемы реальностью
Google I/O 2026 была не просто событием, посвященным моделям. Она продемонстрировала более глубокий платформенный сдвиг, охватывающий модели Gemini, инструменты для разработчиков, связанные с Android интерфейсы и интеллектуальные устройства. Эта статья разбирает ключевой доклад как центральный материал для инженеров, архитекторов и продуктовых команд, которым необходимо отделить реальные последствия для среды выполнения от хайпа со сцены.
За пределами промпт-инжиниринга: методология для более надёжного рассуждения ИИ
Большие языковые модели не обязательно терпят неудачу из-за отсутствия способности к рассуждению. Они часто терпят неудачу потому, что процесс рассуждения недостаточно ограничен, оспорен или проверен. В этой статье представлена не зависящая от предметной области методология, которая превращает промптинг в структурированный эпистемический процесс: отделение фактов от предположений, генерация конкурирующих гипотез, проверка контрдоказательств, применение фальсификации и проверка того, остаются ли выводы устойчивыми при альтернативных формулировках. Цель не в том, чтобы заставить модель «меньше соглашаться», а в том, чтобы сделать её выводы менее зависимыми от исходной формулировки пользователя.