
Ultimate Guide to Acceptance Criteria for LLM Adoption in Enterprise Playbooks
# Полное руководство по критериям приёмки для внедрения LLM в корпоративные playbook
## Введение в критерии приёмки
Критерии приёмки (AC) — это чёткие условия, которые должны быть выполнены, чтобы функциональность, пользовательская история или результат проекта считались завершёнными. В контексте внедрения LLM (больших языковых моделей) в корпоративные playbook AC служат основой для оценки успеха, снижения рисков и обеспечения согласованности между техническими, операционными и бизнес-командами.
В отличие от размытых требований, AC конкретны, проверяемы и бинарны — либо выполнены, либо нет. Они соединяют высокоуровневые цели и детальную реализацию, что особенно важно для сложных AI-интеграций, где результаты могут быть непредсказуемыми.
### Почему критерии приёмки важны для внедрения LLM - **Снижение рисков**: LLM вносят вариативность в результаты; чёткие AC предотвращают расширение области и сбои при развёртывании. - **Согласованность стейкхолдеров**: Обеспечивает общее понимание у владельцев продукта, разработчиков, QA-команд и руководства. - **Измеримый прогресс**: Позволяет итеративную разработку в agile-playbook. - **Соответствие и управление**: Критично для предприятий, работающих с конфиденциальными данными в рамках GDPR или HIPAA.
## Основные принципы написания эффективных критериев приёмки
Следуйте этим базовым принципам, чтобы создавать AC, которые продвигают LLM-проекты:
1. **Конкретность**: Используйте точный язык, избегая неоднозначности (например, «95% точности» вместо «хорошей производительности»). 2. **Проверяемость**: Каждый критерий должен быть верифицируем через автоматизированные тесты, ручные проверки или метрики. 3. **Независимость**: Критерии должны существовать самостоятельно без зависимостей от других. 4. **Полнота**: Охватывать функциональные, нефункциональные требования, граничные случаи и сценарии отказов. 5. **Приоритизация**: Разделять must-have (формат Gherkin Given-When-Then) и nice-to-have.
## Стандартные форматы критериев приёмки
### 1. Формат Gherkin (BDD) Идеален для LLM-playbook благодаря читаемости и совместимости с инструментами автоматизации, такими как Cucumber.
**Пример для ответа LLM на запрос**:
Given пользователь вводит запрос на финансовый анализ When LLM обрабатывает его с корпоративными данными Then ответ должен: - Не содержать галлюцинаций (проверяется через fact-checking API) - Достигать >90% семантического сходства с ground truth - Отвечать менее чем за 5 секунд - Автоматически скрывать PII
### 2. Формат чек-листа Простые маркированные списки для быстрой валидации.
**Пример для дообучения LLM**: - Perplexity модели снижена на 20% после дообучения - Показатель bias < 0.05 по демографическим группам - Стоимость инференса на запрос < $0.01 - 99.9% доступности в staging-среде
### 3. Формат на основе правил Для сложных корпоративных сценариев.
**Правило**: IF запрос содержит проприетарные данные AND confidence score < 0.8 THEN направить на проверку человеку ELSE автоматически одобрить.
## Шаблоны критериев приёмки для этапов внедрения LLM
### Этап 1: Proof of Concept (PoC) Фокус на feasibility.
- LLM генерирует ответы, соответствующие 80% тестовых кейсов бенчмарка - Интеграция с внутренними API успешна в 95% вызовов - Сканирование на утечку данных проходит без утечек - Команда проводит демо с <5% нерешённых вопросов
### Этап 2: Пилотное развёртывание Акцент на масштабируемость и обратную связь пользователей.
- 100 одновременных пользователей со средней задержкой <2 с - Оценка удовлетворённости пользователей >4/5 по результатам 50+ опросов - Кастомный RAG (Retrieval-Augmented Generation) возвращает релевантные документы в топ-3 результатах в 85% случаев - Процедура отката успешно протестирована дважды
### Этап 3: Полноценный запуск в продакшен Приоритет — устойчивость и ROI.
- Стоимость за 1K токенов ниже порога предприятия - A/B-тест показывает рост продуктивности на 25% - Автоматический мониторинг уведомляет об отклонениях/аномалиях в течение 1 минуты - Аудит соответствия сертифицирован третьей стороной
## Практические шаги по определению и реализации AC
1. **Совместная работа на сессиях уточнения**: Привлекайте инженеров LLM, экспертов предметной области и конечных пользователей к воркшопам продолжительностью 1 час. 2. **Связь с бизнес-KPI**: Привязывайте AC к метрикам, таким как время до инсайта или снижение ошибок. 3. **Используйте инструменты**: - Jira/Confluence для документирования - LangSmith или Weights & Biases для трассировки LLM - Prometheus/Grafana для мониторинга производительности 4. **Тестируйте рано и часто**: Встраивайте AC в CI/CD-пайплайны с unit-тестами для промптов и оценок. 5. **Проводите обзоры и итерации**: Ретроспективы после спринта для уточнения AC на основе полученного опыта. 6. **Документируйте граничные случаи**: Явно определяйте поведение при галлюцинациях, смещениях или запросах вне домена.
## Распространённые ошибки и как их избежать
- **Слишком жёсткие AC**: Балансируйте точность и гибкость с учётом вероятностной природы ИИ — используйте пороги, а не абсолюты. - **Игнорирование нефункциональных требований**: Всегда включайте безопасность, производительность и поддерживаемость. - **Пренебрежение персонами пользователей**: Адаптируйте AC под роли (например, руководителям нужны краткие сводки; аналитикам — подробные трассировки). - **Размытие границ**: Используйте метод MoSCoW (Must, Should, Could, Won't) для приоритизации.
| Проблема | Симптом | Решение | |--------|---------|-----| | Нечёткие метрики | "Достаточно быстро" | Определите: <3 с p95 latency | | Отсутствие сценариев отказов | Предполагает идеальные входные данные | Добавьте: Корректную обработку adversarial-промптов | | Несогласованность команды | Споры на демо | Предварительное согласование со стейкхолдерами |
## Реальные примеры из плейбуков enterprise LLM
### Кейс: Автоматизация поддержки клиентов **Пользовательская история**: Как агент поддержки, я хочу, чтобы LLM сортировал тикеты, чтобы я мог сосредоточиться на кейсах с высокой ценностью.
**AC**: - Классифицировать срочность тикета с F1-score 92% - Предлагать 3 шага решения с цитатами - Точно эскалировать 10% кейсов людям - Вести аудиторский лог каждого взаимодействия для соответствия требованиям
**Результат**: Ускорение разрешения на 40%, рост CSAT на 15%.
### Кейс: Внутренний поиск знаний **Пользовательская история**: Как новый сотрудник, я хочу запрашивать документы через LLM для онбординга.
**AC**: - Извлекать из 10K+ документов с recall@5 88% - Обрабатывать многоязычные запросы - Блокировать запросы к конфиденциальным разделам - Цикл обратной связи улучшает модель еженедельно
## Измерение успеха за пределами AC
AC — это контрольные точки, а не конечные цели. Отслеживайте долгосрочные метрики: - **Уровень внедрения**: % сотрудников, использующих инструменты LLM - **ROI**: (Созданная ценность - Затраты) / Затраты - **Здоровье модели**: Обнаружение дрейфа, A/B-тестирование
Регулярно проводите аудит и совершенствуйте критерии приёмки в вашем playbook, чтобы адаптироваться к развитию LLM, таким как мультимодальные модели или агентные рабочие процессы.
## Заключение
Надёжные критерии приёмки превращают внедрение LLM из экспериментального в корпоративный уровень. Встраивая их в ваши playbook, вы обеспечиваете надёжный, масштабируемый ИИ, который приносит ощутимую пользу. Начните с шаблонов, постоянно совершенствуйте и наблюдайте за успехом ваших инициатив.
Related Articles
Разработка портала: Масштабируемая платформа для производительности, многоязычной поддержки и расширяемости
Разрабатывается веб-портал с акцентом на чистую архитектуру, высокую производительность,

Как узнать, действительно ли ИИ-агент использовал правильные доказательства
ИИ-агент может ссылаться на источники и при этом использовать неверные доказательства. В этой статье представлен практический метод проверки обоснованности утверждений, авторитетности источников, применимости, происхождения и того, действительно ли доказательства повлияли на ответ.
Snap-пакеты: Почему они не дотягивают для продвинутых инструментов, таких как DBeaver
Пакеты Snap вводят ограничительную песочницу, которая нарушает расширенные рабочие процессы. В этой статье объясняется, почему DBeaver испытывает трудности с туннелированием SSH под Snap и почему Flatpak или нативные пакеты являются лучшими альтернативами.

MCP vs A2A vs UCP vs AP2 vs A2UI: разбор стека протоколов агентов
MCP, A2A, UCP, AP2 и A2UI часто представляют как конкурирующие агентские стандарты. В основном они решают разные проблемы интероперабельности. Это руководство сопоставляет каждый протокол с границей, которую он фактически стандартизирует,—и показывает, как они могут работать вместе в одной промышленной системе.

Миграция с OpenAI Agents SDK на Agents API: что на самом деле меняется архитектурно?
Переход с OpenAI Agents SDK на новый Agents API — это не просто переименование импорта. Меняется граница среды выполнения: цикл агента, долговечная сессия, оркестрация, сжатие контекста и восстановление смещаются в сторону управляемой обвязки. Это руководство показывает, что следует перенести, что должно остаться в вашем приложении и как подтвердить миграцию до переключения.
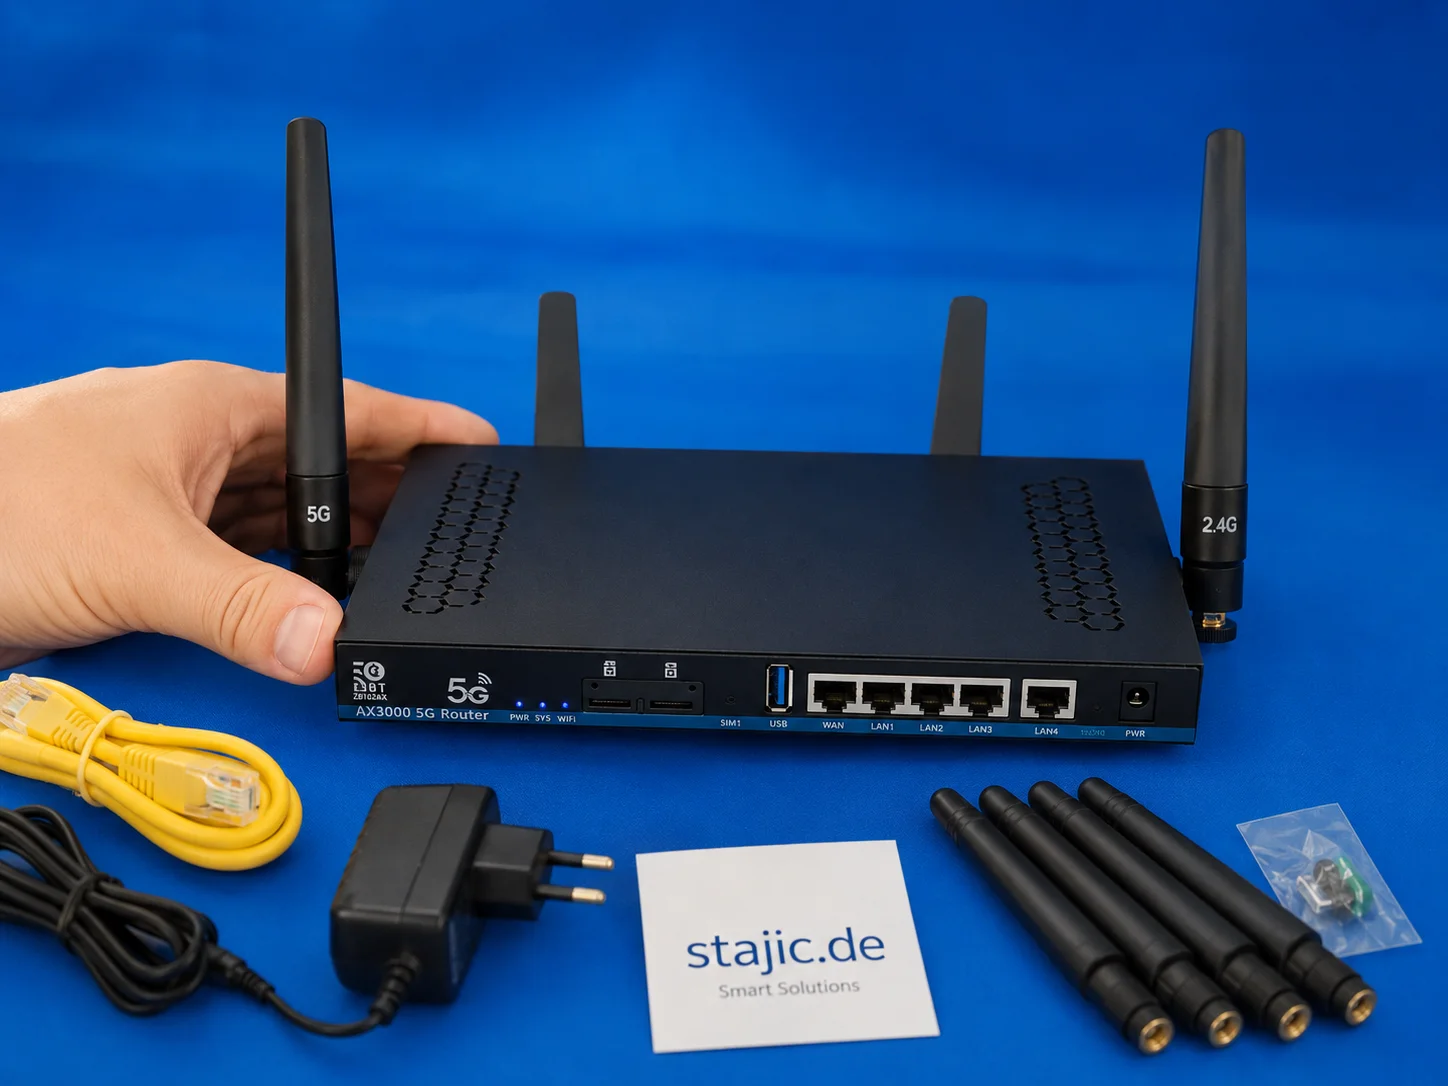
Обзор 5G-роутера ZBT Z8102AX на OpenWrt: две SIM-карты, RM500U-EA и честная оценка
ZBT Z8102AX — это необычный 5G-роутер на базе OpenWrt, с концепцией двух SIM-карт и модемом Quectel RM500U-EA. В ходе тестирования он демонстрирует явные сильные стороны в гибкости, интерфейсах и мобильной связи, но также и типичные недостатки модифицированной производителем сборки OpenWrt.

Почему больше контекста может ухудшить ответы ИИ
Большее контекстное окно не гарантирует более качественного ответа. В этой статье объясняется, как размывание сигнала, противоречивые данные, устаревшее состояние, чувствительность к позиции и сжатие с потерями могут снизить надежность ИИ — и предлагается практический стресс-тест контекста.
Полное руководство по Test DEv Enterprise Stajic.de: архитектура и лучшие практики
Изучите архитектурные принципы, преимущества и технические детали управления средой разработки и тестирования корпоративного уровня с помощью Test DEv Enterprise Stajic.de.
Qwen 3.6 в продакшене: ранбук релиза, откат ИИ и версионирование LLMOps
Qwen 3.6 — это не просто очередное обновление модели. Это одновременно событие релиза, сценарий отката и проблема версионирования. В этой статье объясняется, как следует работать с Qwen 3.6 в продакшене, используя дисциплину LLMOps, прослеживаемость промптов и моделей, контролируемое развертывание и готовность к откату на основе фактических данных.
Google I/O 2026: Архитектурные сдвиги, агентный ИИ и проверка единой экосистемы реальностью
Google I/O 2026 была не просто событием, посвященным моделям. Она продемонстрировала более глубокий платформенный сдвиг, охватывающий модели Gemini, инструменты для разработчиков, связанные с Android интерфейсы и интеллектуальные устройства. Эта статья разбирает ключевой доклад как центральный материал для инженеров, архитекторов и продуктовых команд, которым необходимо отделить реальные последствия для среды выполнения от хайпа со сцены.
Новый Qwen 3.5-Plus: Open-source ИИ — теперь всё серьезно
Откройте для себя революционные функции и преимущества Qwen 3.5-Plus от Alibaba — меняющего правила игры ИИ с открытым исходным кодом для разработчиков.
Laravel 12 Пользовательская CMS с Filament 3: Экспертный рабочий процесс
Подробный обзор синергии между Laravel 12 и Filament 3 для создания индивидуальных систем управления контентом. Эксперты анализируют инновационный рабочий процесс, преимущества, недостатки и вызов рабочего процесса Jetstream.