От исследовательского протокола к универсальному фреймворку рассуждений ИИ
Методология, разработанная в этой серии публикаций, началась с исследовательской проблемы: как модель ИИ может помочь в изучении сложного вопроса, не подкрепляя просто предположения, уже заложенные в промпте пользователя?
Поначалу кажется, что эта проблема относится к историческим или академическим исследованиям. На самом деле она гораздо шире.
Отладка программного обеспечения, архитектурные решения, техническая диагностика, анализ безопасности, продуктовая стратегия и многие формы поддержки принятия решений имеют одинаковую базовую структуру. Задана проблема. Доступны некоторые свидетельства. Одно или несколько объяснений выглядят правдоподобно. В анализ проникают предположения. Система должна определить, какой вывод имеет наилучшее обоснование.
Предметная область меняется. Эпистемическая проблема зачастую остается прежней.
Поэтому в данной статье делается следующий шаг: исследовательский протокол, разработанный в предыдущих публикациях, преобразуется в общий фреймворк рассуждений для аналитической работы с поддержкой ИИ.
Фреймворк напрямую опирается на четыре предыдущих уровня: статья «За рамками промпт-инжиниринга: методология для более надежных рассуждений ИИ» определяет общую методологическую проблему; «Промпт как источник предвзятости» рассматривает фрейминг и зависимость от формулировки запроса; «Инвариантность к промпту: выдерживает ли вывод смену формулировки?» вводит проверку на устойчивость к фреймингу; а «Фальсификация для рассуждений ИИ: от ответов к проверяемым гипотезам» добавляет систематическое опровержение и конкурирующие гипотезы.
Ключевое обобщение
Обобщение не означает, что к каждой задаче следует подходить как к историческому исследованию.
Это было бы ошибкой категории.
Исторические исследования зависят от хронологии, происхождения источников, передачи свидетельств, источниковедческой критики и полноты архивов. Отладка ПО опирается на логи, конфигурацию, воспроизводимость, состояние выполнения и контролируемые тесты. Архитектура основывается на требованиях, ограничениях, интерфейсах, качественных характеристиках и эксплуатационных компромиссах.
Обобщить можно сам процесс рассуждения, выстроенный вокруг этих специфичных для предметной области свидетельств.
Фреймворк по своей сути не зависит от предметной области, но никогда не бывает оторван от нее.
Это различие принципиально. Универсальная методология рассуждений не может заменить профильные знания. Вместо этого она способна определить, как следует работать со свидетельствами, предположениями, гипотезами, противоречиями и неопределенностью до того, как предметная экспертиза сформирует окончательное суждение.
Независимое от предметной области ядро рассуждений
В различных аналитических сферах может применяться одна и та же высокоуровневая последовательность:
Проблема → декомпозиция → свидетельства → предположения → конкурирующие гипотезы → прогнозы → контрсвидетельства → разграничивающие тесты → валидация в предметной области → рекалибровка уверенности → вывод
Этот процесс намеренно не позволяет первому связному объяснению модели автоматически стать окончательным ответом по умолчанию.
Вместо этого первое объяснение рассматривается лишь как кандидат.
1. Определите реальную проблему
Прежде чем генерировать решение, система должна определить, о чем на самом деле идет речь в запросе.
Запросы пользователей часто содержат как саму проблему, так и предполагаемый диагноз:
Почему nginx вызывает сбои подключения к моему API?
Реальная проблема может заключаться в следующем:
Что вызывает сбои подключения к API?
Разница лингвистически невелика, но методологически огромна.
Первая формулировка содержит в себе причинно-следственную гипотезу. Вторая подвергает эту гипотезу конкурентной проверке.
Именно эта проблема фрейминга рассматривается в статье The Prompt Is Part of the Bias.
2. Разделяйте факты, допущения и неизвестные
Надежный процесс рассуждения должен предотвращать незаметное смешение наблюдений и интерпретаций.
- Факт: напрямую подтверждается имеющимися доказательствами.
- Интерпретация: объяснение, выведенное из фактов.
- Допущение: утверждение, необходимое для текущей логики рассуждений, но не подтвержденное независимо.
- Неизвестное: информация, необходимая для более точной дифференциации, но в данный момент недоступная.
Такая классификация может показаться элементарной, однако она устраняет распространенную ошибку в анализе, генерируемом ИИ: допущения встраиваются в связный текст и впоследствии воспринимаются так, будто они уже доказаны.
Прослеживаемость начинается с предотвращения ситуации, когда умозаключение маскируется под доказательство.
3. Генерируйте конкурирующие объяснения
Потенциальное объяснение не должно оцениваться изолированно, если существуют правдоподобные альтернативы.
Поэтому системе следует сгенерировать несколько правдоподобных гипотез, прежде чем останавливаться на одной из них.
Цель состоит не в искусственном мозговом штурме. Альтернативы должны представлять собой принципиально разные механизмы, способные объяснить имеющиеся наблюдения.
Предпочтительная гипотеза не победила, если к проверке не был допущен ни один серьезный конкурент.
Эта концепция занимает центральное место в статье Фальсификация для рассуждений ИИ, где гипотезы оцениваются на основе ожидаемых наблюдений, контрсвидетельств и разграничивающих проверок, а не накопленных подтверждающих рассуждений.
4. Сохраняйте происхождение доказательств
Доказательства должны оставаться отслеживаемыми до своего первоисточника.
Вывод → интерпретация → наблюдение → источник
Строка лога, официальная техническая спецификация, эксперимент, первоисточник исторического документа, экспертная интерпретация и сгенерированная ИИ сводка не обладают одинаковым доказательным статусом.
Поэтому фреймворк не просто хранит информацию. Он должен сохранять достаточно метаданных, чтобы понимать, откуда взялось утверждение и насколько окончательный вывод далек от исходного наблюдения.
5. Формулируйте прогнозы до объяснения результатов
Как только гипотезы сформулированы, каждая из них должна порождать определенные ожидания.
Если гипотеза верна, что мы должны наблюдать?
Если верна альтернатива, что должно отличаться?
Формулирование ожиданий до интерпретации всех имеющихся доказательств помогает предотвратить подгонку каждого наблюдения под предпочтительный нарратив.
6. Ищите контрсвидетельства
Генеративная модель от природы эффективна в выстраивании связных подтверждений правдоподобной идеи. Это делает опровержение особенно важным.
Система должна прямо ставить вопросы:
- Какое наблюдение существенно ослабило бы это объяснение?
- Какие данные эта гипотеза объясняет плохо?
- Какая альтернатива объясняет те же наблюдения с меньшим количеством допущений?
- Какие ожидаемые наблюдения отсутствуют?
- Может ли кажущееся подтверждение объясняться другим механизмом?
Этот принцип подробно рассмотрен в материале Фальсификация для рассуждений ИИ: от ответов к проверенным гипотезам.
7. Проверяйте зависимость от промпта
Одна лишь проверка доказательств не позволяет определить, остается ли анализ модели чрезмерно зависимым от формулировки пользователя.
Поэтому для достаточно важных задач вывод можно перепроверить в рамках альтернативных обоснованных формулировок.
- Исходная: сохраняется формулировка пользователя.
- Слепая: удаляется предпочтительный вывод.
- Инвертированная: на передний план выдвигается наиболее сильная альтернатива.
- Состязательная: целенаправленно ищется наиболее веский контраргумент, основанный на доказательствах.
Это метод инвариантности к промпту, представленный в статье Prompt Invariance: Does the Conclusion Survive the Prompt?.
Его задача состоит не в том, чтобы доказать истинность устойчивого ответа. Его задача — выявить выводы, которые меняются главным образом из-за смены формулировки вопроса.
8. Применяйте предметно-ориентированные валидаторы
Именно на этом этапе общий фреймворк осознанно перестает быть универсальным.
Каждая область требует собственных правил для определения того, действительно ли объяснение заслуживает доверия.
| Область | Типичные валидаторы |
| Исторические исследования | Хронология, провенанс, географическое правдоподобие, каналы передачи, первоисточники, историография |
| Отладка ПО | Логи, воспроизведение, состояние среды выполнения, конфигурация, контролируемые изменения, корреляция ошибок |
| Архитектура ПО | Требования, ограничения, масштабируемость, поддерживаемость, безопасность, эксплуатационная пригодность, стоимость |
| Анализ безопасности | Телеметрия, вектор атаки, права доступа, наблюдаемые индикаторы, воспроизводимость, модель угроз |
| Продуктовая стратегия | Данные о пользователях, поведение в отношении цен, конверсия, альтернативы, рыночные ограничения, критерии неудачи |
| Управление проектами | Содержание, зависимости, ресурсы, риски, критерии приемки, контрольные точки, ограничения стейкхолдеров |
| Научный анализ | План эксперимента, качество измерений, контрольные группы, воспроизводимость, статистическая значимость, альтернативные объяснения |
Фреймворк управляет обработкой утверждений. Валидаторы предметной области определяют, выдерживают ли эти утверждения проверку реальностью.
9. Перекалибруйте уверенность
Окончательный вывод не должен автоматически сохранять уровень уверенности первоначального ответа.
Уверенность следует пересчитывать после того, как были рассмотрены альтернативы, контраргументы, вариации промпта и предметная валидация.
Таким образом, полезный результат может оставаться неопределенным.
- убедительно обоснован;
- предварительно обоснован;
- слабо обоснован;
- недоопределен;
- существенно опровергнут;
- не подлежит проверке при имеющихся данных.
Неопределенность не является ошибкой рассуждений, когда сами доказательства неоднозначны.
Один и тот же фреймворк в различных областях
Самый простой способ понять общий фреймворк — понаблюдать за тем, как та же самая архитектура рассуждений ведет себя при смене предметной области.
Историческое исследование
Проблема: определить, свидетельствуют ли сходства между двумя интеллектуальными традициями об исторической преемственности.
- Отделить задокументированные сходства от интерпретационных параллелей.
- Сравнить прямую передачу, косвенное наследование, конвергенцию и ретроспективную интерпретацию.
- Проверить хронологию и географические контакты.
- Найти документальные или терминологические следы.
- Определить свидетельства, ожидаемые при прямой передаче.
- Найти более ранние независимые примеры, которые ослабляют эту гипотезу.
- Переформулировать вопрос без предпочтительной генеалогии.
- Делать выводы только на том уровне достоверности, который подкреплен сохранившимися доказательствами.
Отладка программного обеспечения
Проблема: определить, почему API-соединение периодически дает сбой.
- Отделить наблюдаемые сбои от предполагаемой разработчиком причины.
- Сформулировать гипотезы на уровне прокси, приложения, базы данных, сети и клиента.
- Определить, какие логи и поведение среды выполнения предсказывает каждая гипотеза.
- Провести тесты, способные провести различие между ними.
- Попытаться воспроизвести сбой, последовательно исключая уровни.
- Отбросить объяснения, противоречащие контролируемым наблюдениям.
- Выявить первый подтвержденный механизм сбоя, а не наиболее убедительное повествование.
Архитектура программного обеспечения
Проблема: выбрать архитектуру для новой платформы.
- Отделить требования от предпочтений в реализации.
- Сравнить модульный монолит, сервисы и гибридные альтернативы.
- Проверить каждый вариант на масштабируемость, структуру команды, развертывание, операционную сложность и стоимость.
- Определить, какое требование действительно требует архитектурного усложнения.
- Найти более простые проектные решения, способные удовлетворить те же ограничения.
- Рассматривать технологические предпочтения как предположение, а не как требование.
Продуктовая стратегия
Проблема: определить, следует ли коммерциализировать возможность продукта.
- Отделить техническую возможность от подтвержденного спроса.
- Определить альтернативные проблемы клиентов и альтернативные решения.
- Выявить наблюдаемое поведение рынка, прогнозируемое бизнес-тезисом.
- Определить критерии неудачи до интерпретации результатов.
- Искать доказательства того, что клиенты решают проблему иначе.
- Различать интерес, готовность тестировать и готовность платить.
Анализ проектов и поставки
Проблема: определить, почему проект не достигает запланированных результатов.
- Отделить симптомы, такие как задержки, от их предполагаемых причин.
- Сопоставить объем работ, зависимости, ресурсы, требования, процессы управления и технические риски.
- Проследить фактические данные через планы, решения, изменения и критерии приемки.
- Проверить, направлены ли корректирующие действия на реальный механизм, а не на видимый симптом.
- Переоценивать проектную гипотезу по мере появления новых свидетельств о ходе поставки.
Почему это больше, чем промпт-инжиниринг
Промпт-инжиниринг меняет инструкцию, предоставляемую модели.
Фреймворк рассуждений меняет процесс, посредством которого ответ получает право стать выводом.
Промпт-инжиниринг оптимизирует вызов. Фреймворк рассуждений управляет процессом инференса.
Это различие приобретает решающее значение по мере того, как системы ИИ переходят от диалоговых интерфейсов к агентам, RAG-конвейерам, автоматизированным исследованиям, инструментам разработки и системам поддержки принятия решений.
Один тщательно продуманный промпт может улучшить результат одного вызова модели. Фреймворк рассуждений способен определить, как взаимодействуют множество вызовов, извлеченные данные, результаты работы инструментов и этапы валидации, прежде чем система сформирует окончательный ответ.
Фреймворк связан с существующими методами рассуждений LLM, но отличается от них
В сфере современных исследований уже существует ряд важных подходов, демонстрирующих, что эффективность LLM повышается, когда инференс организован как структурированный процесс, а не как единичная генерация.
ReAct объединяет логические рассуждения с действиями и наблюдениями во внешней среде. Вместо того чтобы полагаться исключительно на внутренние знания, модель может совершать действия, наблюдать за новой информацией и корректировать свой следующий шаг.
Self-Refine использует итеративную генерацию, обратную связь и доработку, показывая, что исходный ответ LLM часто можно улучшить за счет явного самоанализа без дополнительного дообучения модели.
Reflexion задействует текстовую обратную связь и эпизодическую память, позволяя языковым агентам учиться на предыдущих попытках и корректировать дальнейшее поведение.
Tree of Thoughts исследует множество путей рассуждения вместо того, чтобы сразу следовать одной линейной цепочке, что позволяет выполнять поиск, оценку и возврат к предыдущим шагам среди возможных вариантов решения.
Эти методы существенно различаются по целям и реализации, однако они подтверждают важный общий принцип: структура процесса на этапе инференса способна существенно изменить эффективность модели.
Фреймворк, предлагаемый в этой серии материалов, решает другую основную задачу.
Цель состоит не просто в том, чтобы заставить модель дольше искать, больше размышлять или генерировать более качественный ответ. Цель — сделать путь от доказательств к выводу более устойчивым к формулировкам, предвзятости подтверждения и необоснованным предположениям.
Таким образом, инвариантность к промптам, тестирование на фальсифицируемость и предметная валидация выступают в роли эпистемического контроля, а не типовых методов расширения инференса.
Многоуровневый взгляд на качество рассуждений ИИ
Полученную систему можно представить в виде нескольких уровней.
| Уровень | Вопрос |
| Понимание задачи | Какую проблему мы на самом деле решаем? |
| Доказательства | Что нам достоверно известно? |
| Предположения | Что мы в данный момент принимаем на веру? |
| Гипотезы | Какие правдоподобные механизмы могут объяснить имеющиеся доказательства? |
| Фальсификация | Какие свидетельства способны опровергнуть или ослабить каждое из объяснений? |
| Инвариантность к промптам | Не зависит ли вывод чрезмерно от формулировки вопроса? |
| Предметная валидация | Соответствует ли объяснение правилам и законам соответствующей дисциплины? |
| Калибровка уверенности | Насколько можно доверять итоговому подтвержденному выводу? |
Ответ может оказаться ошибочным на любом из уровней.
Он может правильно ответить на неверно поставленный вопрос. Он может логически корректно рассуждать на основе ложных фактов. Он может найти верные данные, но выбрать ошибочное причинно-следственное объяснение. Он может предложить убедительное объяснение, которое рушится при малейшем изменении формулировки промпта. Наконец, он может пройти все общие проверки логики, но нарушить строгое ограничение предметной области.
Корректность — это не отдельное свойство. Это результат одновременного сохранения нескольких зависимостей.
Качество рассуждений в сравнении с возможностями модели
Это возвращает нас к одной из центральных идей этой серии.
Более мощная модель не означает автоматически, что при каждом вызове ее возможности будут задействованы максимально строгим образом.
Модель может обладать способностью генерировать альтернативы, проверять логи, искать источники, подвергать сомнению предположения и пересматривать выводы. Произойдут ли все эти операции на самом деле, зависит от задачи, промптинга, доступных инструментов, контекста и окружающей архитектуры системы.
Поэтому фреймворк разделяет два вопроса:
- Возможности: на что способна модель?
- Методологическая дисциплина: какие из этих возможностей должны быть задействованы, прежде чем система примет вывод?
Это различие послужило отправной точкой статьи Beyond Prompt Engineering и становится еще более важным, когда методология обобщается за пределы исследований.
Не каждой задаче требуется полный фреймворк
Фреймворк не должен становиться обязательными накладными расходами при каждом взаимодействии с ИИ.
Многие задачи обладают низкой эпистемической сложностью:
- отформатировать этот JSON;
- перевести это предложение;
- конвертировать эти единицы измерения;
- переписать это сообщение;
- извлечь эти поля;
- обобщить этот предоставленный текст.
Запуск четырех вариантов промпта, трех конкурирующих гипотез и этапа фальсификации для таких задач увеличил бы затраты без пропорциональной ценности.
Полный метод становится более ценным, когда:
- ответ зависит от интерпретации, а не от прямого извлечения информации;
- у пользователя уже есть предпочтительное объяснение;
- правдоподобны несколько причинно-следственных механизмов;
- доказательства неполны или противоречивы;
- решение влечет за собой значительные технические, финансовые или исследовательские последствия;
- ожидается, что система ИИ будет действовать на основе сделанного вывода автономно.
Следовательно, методологическая глубина должна масштабироваться в зависимости от эпистемического риска.
От статического промпта к адаптивной политике рассуждений
После обобщения фреймворку больше не требуется существовать в виде одного огромного промпта.
Практичная система способна динамически определять, какие механизмы контроля требуются для конкретной задачи.
Простая задача → прямой ответ Аналитическая задача → структурированная проверка доказательств Задача с высокой неопределенностью → конкурирующие гипотезы Чувствительная к формулировке задача → Prompt Invariance Гипотеза с высокими последствиями → фальсификация и предметная валидация
Это превращает методологию из фиксированного шаблона промпта в адаптивную политику рассуждения.
Система не всегда рассуждает на пределе возможностей. Она рассуждает ровно настолько строго, насколько того требует задача.
Практический общий фреймворк
Полный процесс можно свести к следующим шагам:
- Нормализуйте проблему. Удалите заранее заложенные выводы из формулировки задачи, где это уместно.
- Определите доказательства. Отделите наблюдения от интерпретаций.
- Выявите допущения. Зафиксируйте утверждения, которые еще не были обоснованы.
- Сгенерируйте серьезные альтернативы. Не позволяйте первой гипотезе конкурировать только со слабыми «соломенными чучелами».
- Сохраняйте происхождение данных. Обеспечьте отслеживаемость утверждений до их источников.
- Сформулируйте следствия. Определите, какие прогнозы дает каждая гипотеза.
- Ищите опровергающие доказательства. Целенаправленно ищите наблюдения, которые сложно объяснить с позиции предпочтительной гипотезы.
- Проведите дискриминационные тесты. Отдавайте предпочтение свидетельствам, позволяющим различить конкурирующие объяснения.
- Проверьте зависимость от формулировки. Применяйте Prompt Invariance, если фрейминг пользователя может повлиять на результат.
- Используйте предметные валидаторы. Применяйте специализированные критерии, относящиеся к данной предметной области.
- Перекалибруйте уверенность. Позвольте выводу ослабнуть, остаться неразрешенным или измениться.
- Сохраняйте прослеживаемость. Сделайте путь от вывода обратно к доказательствам доступным для проверки.
На что фреймворк не претендует
- Он не гарантирует истинность выдачи.
- Он не устраняет галлюцинации полностью.
- Он не превращает LLM в эксперта предметной области.
- Он не доказывает, что устойчивые выводы являются верными.
- Он не устраняет искажения, общие для всех итераций рассуждения.
- Он не заменяет эксперименты, измерения или первоисточники.
- Он не гарантирует, что были сформулированы абсолютно все релевантные гипотезы.
- Он не подразумевает, что больший объем рассуждений всегда лучше.
- Он не утверждает, что данный фреймворк в полном объеме уже прошел валидацию как стандартизированная академическая методология.
Его цель более узкая и обоснованная: аналитические системы ИИ можно сделать методологически надежнее, если допущения, фрейминг, конкурирующие объяснения, опровергающие свидетельства и валидация предметной областью обрабатываются явно, а не отдаются целиком на откуп единичной неограниченной генерации.
Четыре статьи объединяются в одну систему рассуждения
Предыдущие статьи теперь можно рассматривать не как разрозненные техники составления промптов, а как компоненты единой архитектуры рассуждения.
| Статья | Функция во фреймворке |
| Beyond Prompt Engineering | Задает переход от генерации ответов к методологическому рассуждению. |
| The Prompt Is Part of the Bias | Рассматривает формулировку пользователя как возможный источник когнитивных искажений в рассуждении. |
| Prompt Invariance | Проверяет, сохраняется ли вывод при значимых изменениях фрейминга. |
| Falsification for AI Reasoning | Проверяет, выдерживают ли гипотезы опровергающие свидетельства и сильные альтернативы. |
| From Research Protocol to a General AI Reasoning Framework | Объединяет механизмы контроля в независимое от домена ядро со специализированной валидацией. |
Вместе они описывают переход:
Промпт → ответ превращается в Проблема → доказательства → гипотезы → критика → валидация → выверенный вывод
Главный принцип
Методология началась с простого наблюдения: если задать вопрос мощной модели рассуждения, это вовсе не гарантирует, что будут задействованы все полезные мыслительные способности, доступные модели.
Решение заключается не в том, чтобы навязывать максимальную глубину рассуждения в каждом взаимодействии.
Решение состоит в том, чтобы определить, какие механизмы контроля рассуждений имеют значение для конкретной задачи, и сделать их явными.
Качественная методология ИИ не диктует модели, к какому выводу прийти. Она определяет, какие проверки должен выдержать вывод, прежде чем быть принятым.
Этот принцип универсален.
В исторических исследованиях вывод должен выдерживать проверку хронологией и критику источников. В отладке — воспроизведение и дифференцирующие тесты. В архитектуре — требования и эксплуатационные ограничения. В стратегии — рыночные данные и критерии несостоятельности.
Инструменты валидации меняются.
Методологическая дисциплина остается прежней.
Цель состоит не в том, чтобы заставить модель рассуждать дольше. Цель — создать систему, которая понимает, когда ответ еще не обоснован.
Контекст исследований
Полный фреймворк, описанный в этой серии публикаций, представляет собой методологический синтез, а не устоявшийся стандартизированный бенчмарк для LLM. Тем не менее ряд смежных направлений исследований подтверждает его центральную архитектурную предпосылку: качество инференса способно существенно меняться, когда решение задач языковой моделью организовано как итеративный или многоэтапный процесс, а не как единичная генерация.
ReAct сочетает рассуждение с действиями и внешними наблюдениями, демонстрируя преимущества в задачах ответов на вопросы, верификации фактов и интерактивного принятия решений. Tree of Thoughts исследует множество потенциальных путей рассуждения с оценкой и возвратом назад вместо того, чтобы сразу привязываться к одной цепочке. Self-Refine показал улучшения в различных задачах за счет итераций между генерацией, обратной связью и уточнением. Reflexion продемонстрировал, что языковые агенты могут использовать текстовую обратную связь из предыдущих попыток для улучшения последующих решений без обновления весов модели.
Эти подходы не реализуют инвариантность к промпту (Prompt Invariance) или предложенный здесь ориентированный на фальсификацию фреймворк. Однако они служат независимым подтверждением более широкой идеи о том, что процедура во время инференса имеет решающее значение: потенциал модели и процесс, через который этот потенциал реализуется, не тождественны.
Вклад этой серии заключается в систематизации этого понимания вокруг эпистемических контролей: разделения доказательств, отслеживания допущений, анализа формулировки промпта, конкурирующих гипотез, фальсификации, происхождения данных, доменной валидации и калиброванной неопределенности.
Избранные источники
- Yao, S. et al. — ReAct: Synergizing Reasoning and Acting in Language Models. ICLR, 2023.
- Yao, S. et al. — Tree of Thoughts: Deliberate Problem Solving with Large Language Models. NeurIPS, 2023.
- Madaan, A. et al. — Self-Refine: Iterative Refinement with Self-Feedback. NeurIPS, 2023.
- Shinn, N. et al. — Reflexion: Language Agents with Verbal Reinforcement Learning. NeurIPS, 2023.
- Jhaveri, A. R., GX-Chen, A., Sucholutsky, I. & Choi, E. — Failing to Falsify: Evaluating and Mitigating Confirmation Bias in Language Models. 2026.
- Brucks, M. S. & Toubia, O. — Prompt Architecture Induces Methodological Artifacts in Large Language Models. PLOS ONE, 2025.
Серия статей о методологии рассуждений ИИ
- За пределами промпт-инжиниринга: методология более надежных рассуждений ИИ — почему одних возможностей модели недостаточно.
- Промпт как источник предвзятости — как формулировка задачи влияет на среду рассуждений.
- Инвариантность к промпту: выдерживает ли вывод смену формулировки? — проверка устойчивости выводов при различных способах постановки задачи.
- Фальсификация для рассуждений ИИ: от ответов к проверенным гипотезам — конкурирующие гипотезы, контрсвидетельства и дифференцирующие тесты.
- От исследовательского протокола к общему фреймворку рассуждений ИИ — интеграция методологии в универсальное доменно-независимое ядро рассуждений.
- Практическое применение этого же фреймворка рассуждений в игровом ИИ — включая игровых ассистентов, автономных агентов, учет изменений в патчах и валидацию состояния игры в реальном времени — рассматривается в статье When Gaming AI Sounds Right but Isn't: The Reasoning Problem Behind Game Assistants and Agents на figure.rocks.
Related Articles
Каноническая архитектура, Дизайн URL, Логика резолвера, Спецификация API и масштабируемости
Геоориентированная архитектура обнаружения для мультитенантных порталов. Определяет канонические URL-адреса, логику разрешения, стратегию кэширования и гео-модель чтения без привязки к CMS или рефакторинга базы данных. Разработано для стабильности SEO, масштабируемости и будущих расширений, таких как бронирование и карты.
Инвариантность к промптам: переживёт ли вывод промпт?
Практическая методология проверки того, зависит ли вывод ИИ от того, как была сформулирована задача. Инвариантность промпта сравнивает исходные, слепые, инвертированные и состязательные формулировки, сохраняя контроль над структурой доказательств.
Комплексное руководство по триггерам отката в корпоративных AI-ранбуках
Это руководство рассматривает триггеры отката, важные механизмы в корпоративных AI-ранбуках, которые автоматически обнаруживают аномалии и инициируют откаты для поддержания стабильности системы. Узнайте, как настраивать, отслеживать и оптимизировать эти триггеры для надежных AI-развертываний.
Исчерпывающее руководство по Evaluation Harness: освоение оценки производительности LLM
Это руководство содержит подробный обзор Evaluation Harness — важного фреймворка для строгой оценки возможностей больших языковых моделей (LLM) в корпоративных конвейерах LLMOps. Узнайте о настройке, лучших практиках и продвинутых методах для обеспечения надежного бенчмаркинга и оптимизации моделей.
Мультитенантная архитектура корпоративного уровня для международной платформы
Loving Rocks является корпоративной свадебной платформой, разработанной с истинной многоарендной архитектурой, изолированными базами данных для каждого арендатора и встроенной интернационализацией для глобальной масштабируемости, безопасности и долгосрочной операционной стабильности.
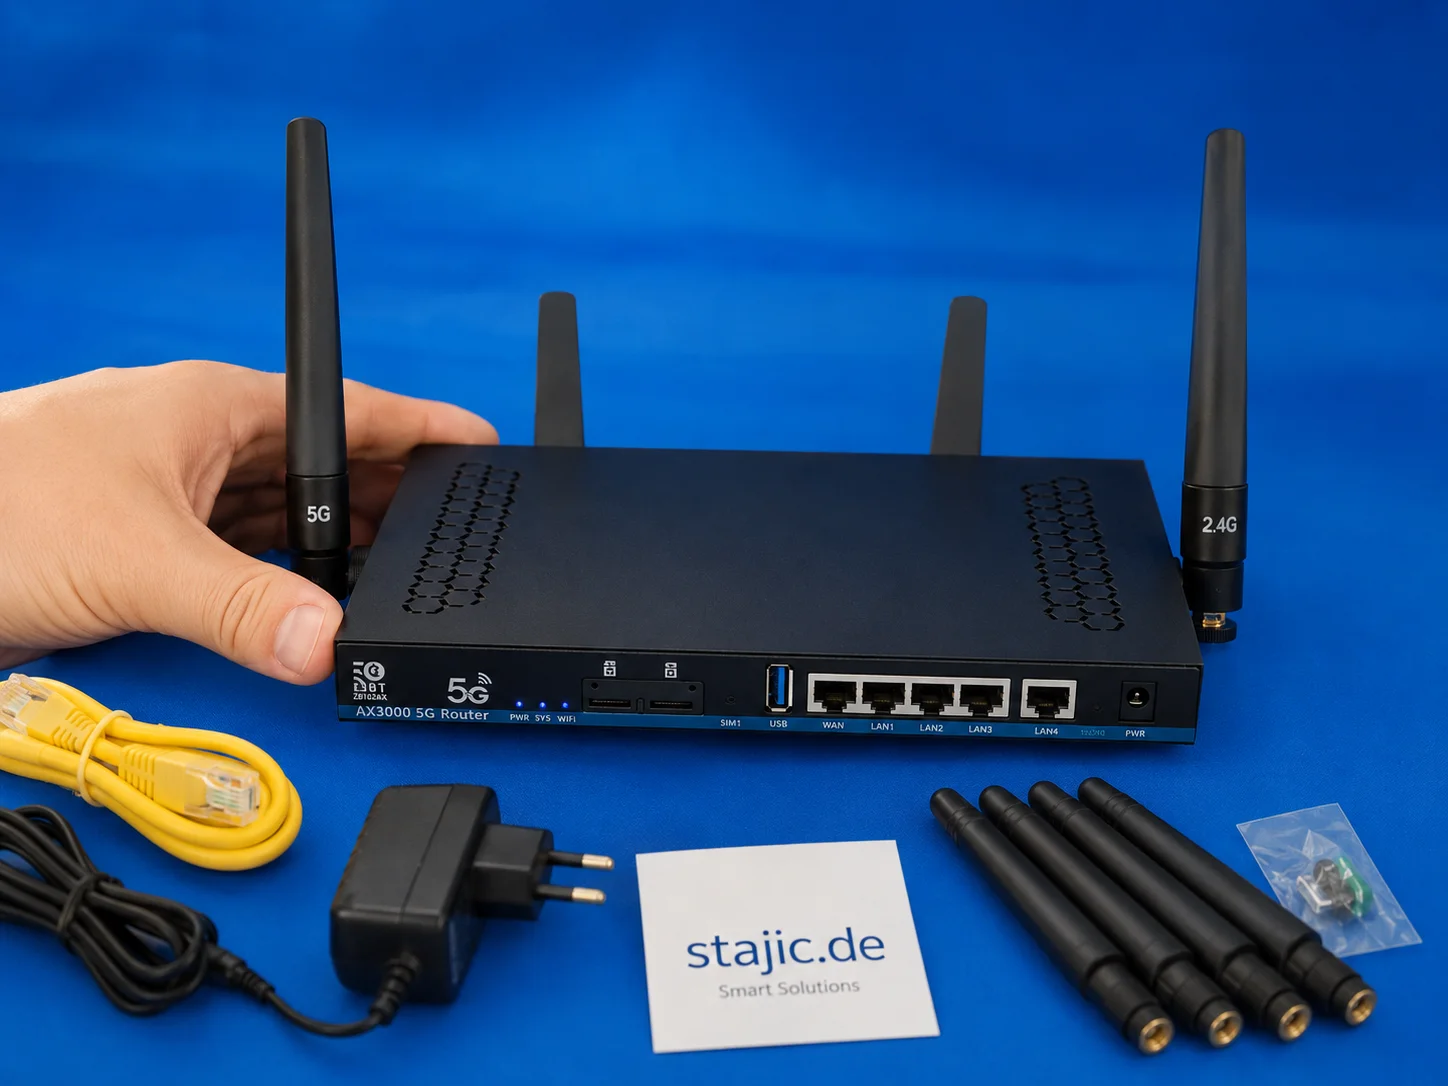
Обзор 5G-роутера ZBT Z8102AX на OpenWrt: две SIM-карты, RM500U-EA и честная оценка
ZBT Z8102AX — это необычный 5G-роутер на базе OpenWrt, с концепцией двух SIM-карт и модемом Quectel RM500U-EA. В ходе тестирования он демонстрирует явные сильные стороны в гибкости, интерфейсах и мобильной связи, но также и типичные недостатки модифицированной производителем сборки OpenWrt.
Надёжность ИИ-агентов: почему финального ответа недостаточно
Правильный вывод не доказывает правильность рассуждений, безопасность выполнения или надежность системы.
За пределами промпт-инжиниринга: методология для более надёжного рассуждения ИИ
Большие языковые модели не обязательно терпят неудачу из-за отсутствия способности к рассуждению. Они часто терпят неудачу потому, что процесс рассуждения недостаточно ограничен, оспорен или проверен. В этой статье представлена не зависящая от предметной области методология, которая превращает промптинг в структурированный эпистемический процесс: отделение фактов от предположений, генерация конкурирующих гипотез, проверка контрдоказательств, применение фальсификации и проверка того, остаются ли выводы устойчивыми при альтернативных формулировках. Цель не в том, чтобы заставить модель «меньше соглашаться», а в том, чтобы сделать её выводы менее зависимыми от исходной формулировки пользователя.
Промпт — часть предвзятости: как фрейминг ИИ формирует рассуждения
Формулировка промпта не нейтральна. Узнайте, как фрейминг, допущения, следование инструкциям и сикофантия могут формировать рассуждения ИИ — и почему для получения надежных выводов требуется тестирование за рамками исходного промпта.
Ollama — это не продукт: создание готовых к продакшену приложений на базе открытых LLM
Запустить локальную модель с Ollama просто. Создать готовое к продакшену Open-LLM-приложение сложнее: для этого требуются RAG, контроль доступа, абстракция провайдеров, оценка, логирование, дисциплина развертывания и контролируемый уровень приложения вокруг модели.
tensorflow