
GPU — не продукт: перспективная архитектура приватного ИИ

Обсуждение локальной инфраструктуры для ИИ часто начинается с неправильного вопроса:
Какой GPU мне купить?
Более правильный вопрос:
Какие типы рабочих нагрузок ИИ мне необходимо выполнять и где должна работать каждая из них?
Это различие становится все более важным по мере того, как инфраструктура ИИ разделяется на несколько совершенно разных классов оборудования. Потребительский графический процессор топового уровня может обеспечить исключительную скорость инференса, но при этом обладает относительно ограниченным объемом памяти. Компактная ИИ-система способна предложить значительно больший объем памяти при более низком энергопотреблении, однако с гораздо меньшей пропускной способностью памяти. Пограничные платформы (Edge) добавляют обработку данных с датчиков, видео в реальном времени и физические интерфейсы, для работы с которыми традиционные рабочие станции с GPU попросту не предназначены.
В результате одного идеального компьютера для ИИ больше может не существовать. Вместо этого оптимальным решением может стать идеальная вычислительная фабрика ИИ.
Разное оборудование решает разные задачи
Рассмотрим несколько актуальных классов платформ NVIDIA. Это не просто более быстрые или более медленные версии одной и той же системы. Они представляют собой разные профили возможностей.
GeForce RTX 5090 спроектирована с упором на чрезвычайно высокую вычислительную производительность и пропускную способность памяти. Благодаря 32 ГБ памяти GDDR7 и очень высокой пропускной способности она отлично подходит для инференса, чувствительного к задержкам, при условии, что модель целиком помещается в память GPU.
DGX Spark предлагает прямо противоположный компромисс. Она сочетает 128 ГБ когерентной унифицированной памяти с пропускной способностью 273 ГБ/с и относительно низким энергопотреблением. Ее главное преимущество — не максимальная скорость генерации токенов, а возможность удерживать в памяти существенно более крупные модели и контексты.
Jetson AGX Thor также предлагает архитектуру с большим объемом унифицированной памяти, но ее назначение иное. Она разработана для физического ИИ: потоков с камер, звука, слияния данных датчиков, робототехники и других задач, где ИИ должен взаимодействовать с физической средой в режиме реального времени.
В профессиональном сегменте RTX PRO 6000 Blackwell сочетает 96 ГБ памяти GDDR7 ECC со сверхвысокой пропускной способностью памяти. Этот класс ускорителей особенно интересен для коммерческого многопользовательского инференса, поскольку сочетает в себе гораздо большую емкость памяти с производительностью уровня рабочих станций.
Задержка, емкость и физический ИИ
Полезная модель инфраструктуры разделяет рабочие нагрузки на три основных класса.
Инференс, ориентированный на задержку
Короткие диалоги, помощь в написании кода, классификация, извлечение данных, небольшие RAG-запросы и интерактивные рабочие нагрузки выигрывают от высокой пропускной способности памяти и высокой вычислительной производительности. Высокопроизводительная система RTX особенно хорошо подходит для этой роли.
Инференс, ориентированный на объем памяти
Большие модели, длинные контексты, логический анализ больших документов, пакетный анализ и комбинации моделей часто требуют гораздо больше памяти, чем может предоставить обычный потребительский GPU. Такие системы, как DGX Spark, жертвуют чистой пропускной способностью ради значительно большего пула объединенной памяти.
Физический ИИ
Потоки с камер, аудиоконвейеры, распознавание жестов, робототехника и объединение данных датчиков требуют возможностей, выходящих за рамки обычного обслуживания LLM. Jetson Thor относится именно к этой категории, поскольку вычислительные ресурсы в нем интегрированы с интерфейсами, разработанными для систем, работающих в физическом мире.
Поэтому важный архитектурный шаг заключается не в выборе между этими платформами. Он заключается в том, чтобы позволить им взаимодействовать.
Маршрутизатор ИИ становится настоящей платформой
Представьте, что каждое приложение отправляет запросы на одну логическую конечную точку. Клиенту не нужно знать, где именно выполняется задача: на рабочей станции RTX, узле Spark, граничной системе или во внешней передовой модели.
Уровень маршрутизации может оценивать длину контекста, модальность, требования к задержке, политику конфиденциальности, возможности модели, приоритет клиента и текущую загрузку оборудования, прежде чем принять решение о том, где должен выполняться запрос.
- Короткий запрос к внутреннему разделу FAQ может быть направлен на быструю локальную модель на GPU RTX.
- Запрос, охватывающий сотни документов, может быть перенаправлен на узел Spark с большим объемом памяти.
- Рабочая нагрузка, связанная с камерами или датчиками, может быть отправлена на Thor.
- Особенно сложный запрос на логический вывод может быть при необходимости передан передовой облачной модели, если это разрешено политикой клиента.
В таком случае инфраструктура перестает быть модель-ориентированной и становится ориентированной на возможности.
Это различие важно, поскольку модели меняются намного быстрее, чем архитектура корпоративных приложений. Модель, используемая сегодня, может быть заменена в следующем году без изменения контракта API, используемого клиентом. То же самое справедливо и для аппаратного обеспечения.
Будущее поколение GPU можно просто внедрить как еще один вычислительный узел, в то время как окружающая платформа останется неизменной.
Многомодельное обслуживание — это не то же самое, что распределенный инференс
Распространено предположение, что кластер ИИ должен постоянно перемещать огромные объемы данных между всеми узлами. Это верно лишь для определенных архитектур.
Если одна очень большая модель разделена между несколькими машинами, пропускная способность межузлового соединения становится критически важной, поскольку тензорные данные должны непрерывно перемещаться между устройствами.
Поэтому DGX Spark включает сетевые интерфейсы ConnectX-7, предназначенные для высокоскоростного обмена данными в кластере, включая пропускную способность до 200 Гбит/с на каждый поддерживаемый интерфейс.
Документация по кластеризации NVIDIA DGX Spark
Но частному ИИ-сервису не обязательно распределять каждую модель. Вместо этого он может размещать различные модели на разных узлах на постоянной основе.
- Один узел может обслуживать быструю диалоговую модель.
- Другой может содержать крупную модель для рассуждений (reasoning).
- Третий может выполнять эмбеддинги и реранкинг.
- Thor может обрабатывать задачи реального времени для компьютерного зрения, аудио и сенсоров.
В такой архитектуре по сети передаются запросы и ответы, а не внутренние тензоры модели. Это мультимодельное обслуживание (multi-model serving), а не распределенный инференс модели.
Для многих коммерческих внедрений это проще, дешевле и легче масштабируется.

Один кластер может обслуживать множество компаний
Емкость инфраструктуры нельзя измерить простым подсчетом количества компаний-клиентов.
Двадцать компаний не обязательно создают двадцать одновременных рабочих нагрузок инференса. Компания из тридцати сотрудников может генерировать лишь несколько параллельных запросов в ходе обычной офисной работы, тогда как один клиент с масштабной автоматизацией может поддерживать десятки непрерывно работающих агентов.
Поэтому актуальными метриками емкости являются параллелизм, количество токенов в секунду, размер контекста, количество запросов в минуту и приоритет обслуживания.
Это создает возможность для статистического мультиплексирования: клиенты редко используют свою максимальную законтрактованную мощность одновременно.
Следовательно, гетерогенный кластер может обслуживать множество небольших организаций, сохраняя при этом зарезервированные мощности для клиентов с более строгими требованиями к задержке или доступности.
Коммерческий продукт — это не аренда времени GPU
Напрямую конкурировать с гиперскейл-провайдерами аренды GPU сложно. Их экономика оптимизирована под утилизацию инфраструктуры и масштаб.
Более устойчивым и защищенным продуктом является управляемая платформа приватного ИИ.
- Приватный инференс
- Генерация с расширенным поиском (RAG)
- Изоляция тенантов
- Ролевое управление доступом (RBAC)
- Журналирование аудита
- Маршрутизация моделей
- Загрузка и обработка документов
- Коннекторы и API
- Оценка и мониторинг
- Выделенные или зарезервированные мощности
Клиент платит главным образом не за доступ к GPU. Клиент платит за контролируемый прикладной уровень ИИ.
Локальным моделям не требуется превосходить передовой ИИ
Ещё одна архитектурная ошибка — относиться к моделям с открытыми весами как к прямой замене передовых систем (frontier models).
В этом нет никакой необходимости.
Компании, которая задаёт вопрос «Какой срок расторжения указан в этом договоре?», вовсе не обязательно требуется самая мощная модель общего назначения.
Ей необходимы надёжный приём данных, корректный поиск, доступ с учётом прав, подтверждённое происхождение источников и модель с достаточным уровнем возможностей.
Для значительной доли корпоративных задач качество окружающей прикладной инфраструктуры играет не меньшую роль, чем используемая LLM.
Поэтому платформа может использовать локальные модели для конфиденциальных и объёмных рабочих нагрузок, сохраняя передовые модели для относительно небольшого процента запросов, которым они действительно необходимы.
Так формируется схема каскадного инференса: недорогие приватные модели обрабатывают основную массу запросов, тогда как более затратные мощности задействуются исключительно по мере необходимости.
Задел на будущее не означает предотвращение устаревания
Ни один AI-ускоритель не защищён от морального устаревания в буквальном смысле. Новое оборудование всегда будет становиться быстрее.
Разумная инженерная цель заключается скорее в том, чтобы снизить риск технологического устаревания.
GPU, служащий сегодня основным устройством инференса, позже может стать сервером для эмбеддингов, пакетным обработчиком, узлом генерации изображений или вторичным пулом вывода.
Система с большим объёмом памяти, на которой ранее разворачивалась самая крупная из доступных моделей, со временем может стать выделенным узлом для RAG, работы с длинным контекстом или пакетного анализа.
Новое оборудование должно расширять платформу, а не делать её неактуальной.
Для этого необходимо отделить уровень исполнения от уровня приложений.
Долгосрочную ценность представляют не сами GPU. Ею обладают API-контракты, логика маршрутизации, мультитенантная модель, правила безопасности, конвейеры документов, RAG-архитектура, система валидации, мониторинг и клиентские интеграции.
Оборудование становится заменяемой инфраструктурой.
Настоящий продукт
Поэтому наиболее надёжная и долговечная архитектура приватного ИИ напоминает скорее компактное облако, чем отдельную рабочую станцию.
- Различные пулы аппаратных ресурсов предоставляют разные возможности.
- Уровень планирования определяет, куда направляется каждая рабочая нагрузка.
- Локальные модели обрабатывают конфиденциальные и объемные запросы.
- Аппаратное обеспечение для физического ИИ работает с датчиками и средами реального времени.
- Передовые сервисы остаются доступными в качестве контролируемых путей эскалации.
- Новые ускорители могут внедряться без необходимости для клиентов изменять свои приложения.
С этой точки зрения главный вопрос больше не заключается в том:
Какой GPU должен обеспечивать работу системы?
Он звучит иначе:
Сможет ли платформа продолжать предоставлять тот же уровень сервиса при смене GPU, модели или поставщика?
Если ответ положительный, инфраструктура достигла чего-то гораздо более ценного, чем просто владение быстрым оборудованием.
Она превратила вычисления в заменяемый уровень выполнения.
И именно тогда частная ИИ-система начинает становиться платформой.
Related Articles
Комплексное руководство по триггерам отката в корпоративных AI-ранбуках
Это руководство рассматривает триггеры отката, важные механизмы в корпоративных AI-ранбуках, которые автоматически обнаруживают аномалии и инициируют откаты для поддержания стабильности системы. Узнайте, как настраивать, отслеживать и оптимизировать эти триггеры для надежных AI-развертываний.
Практическая архитектура монорепозитория с Next.js, Fastify, Prisma и NGINX
Исследуйте практическую архитектуру монорепозитория с использованием Next.js, Fastify, Prisma и NGINX, подчеркивающую реальную интеграцию и рабочий процесс.
Постgresql 14 Убунту Сервер 23.04
Постgresql 14 Убунту Сервер 23.04
Резервное переключение Dual-SIM на ZBT Z8102AX: что работает, чего не хватает и что требует лучшей прошивки
ZBT Z8102AX — это 5G-роутер OpenWrt с поддержкой двух SIM-карт, но одно лишь аппаратное обеспечение с поддержкой двух SIM-карт — это не то же самое, что интеллектуальное резервирование. Роутер распознает SIM-карту и успешно подключается, но автоматическое переключение, восстановление модема, решения на основе сигнала и четкая логика резервирования все еще требуют более глубокого тестирования.
Понимание и разрешение конфликтов зависимостей npm ERESOLVE
Разрешайте конфликты peer-зависимостей npm ERESOLVE правильно: выявляйте реальное несоответствие, согласовывайте версии, безопасно используйте overrides и знайте, когда pnpm или Yarn подходят лучше.
Исчерпывающее руководство по Evaluation Harness: освоение оценки производительности LLM
Это руководство содержит подробный обзор Evaluation Harness — важного фреймворка для строгой оценки возможностей больших языковых моделей (LLM) в корпоративных конвейерах LLMOps. Узнайте о настройке, лучших практиках и продвинутых методах для обеспечения надежного бенчмаркинга и оптимизации моделей.
PostfixAdmin: Управление корпоративного уровня для почтовых систем Postfix — Anno 2026
PostfixAdmin — это ориентированный на базу данных интерфейс администрирования, разработанный для профессиональных почтовых систем Postfix. Вместо того чтобы скрывать сложность, он обеспечивает точный контроль над доменами, почтовыми ящиками, псевдонимами и разрешениями отправителей. В этой статье объясняется, почему PostfixAdmin остается надежным корпоративным решением в 2026 году и как он вписывается в современные, ориентированные на безопасность почтовые инфраструктуры.
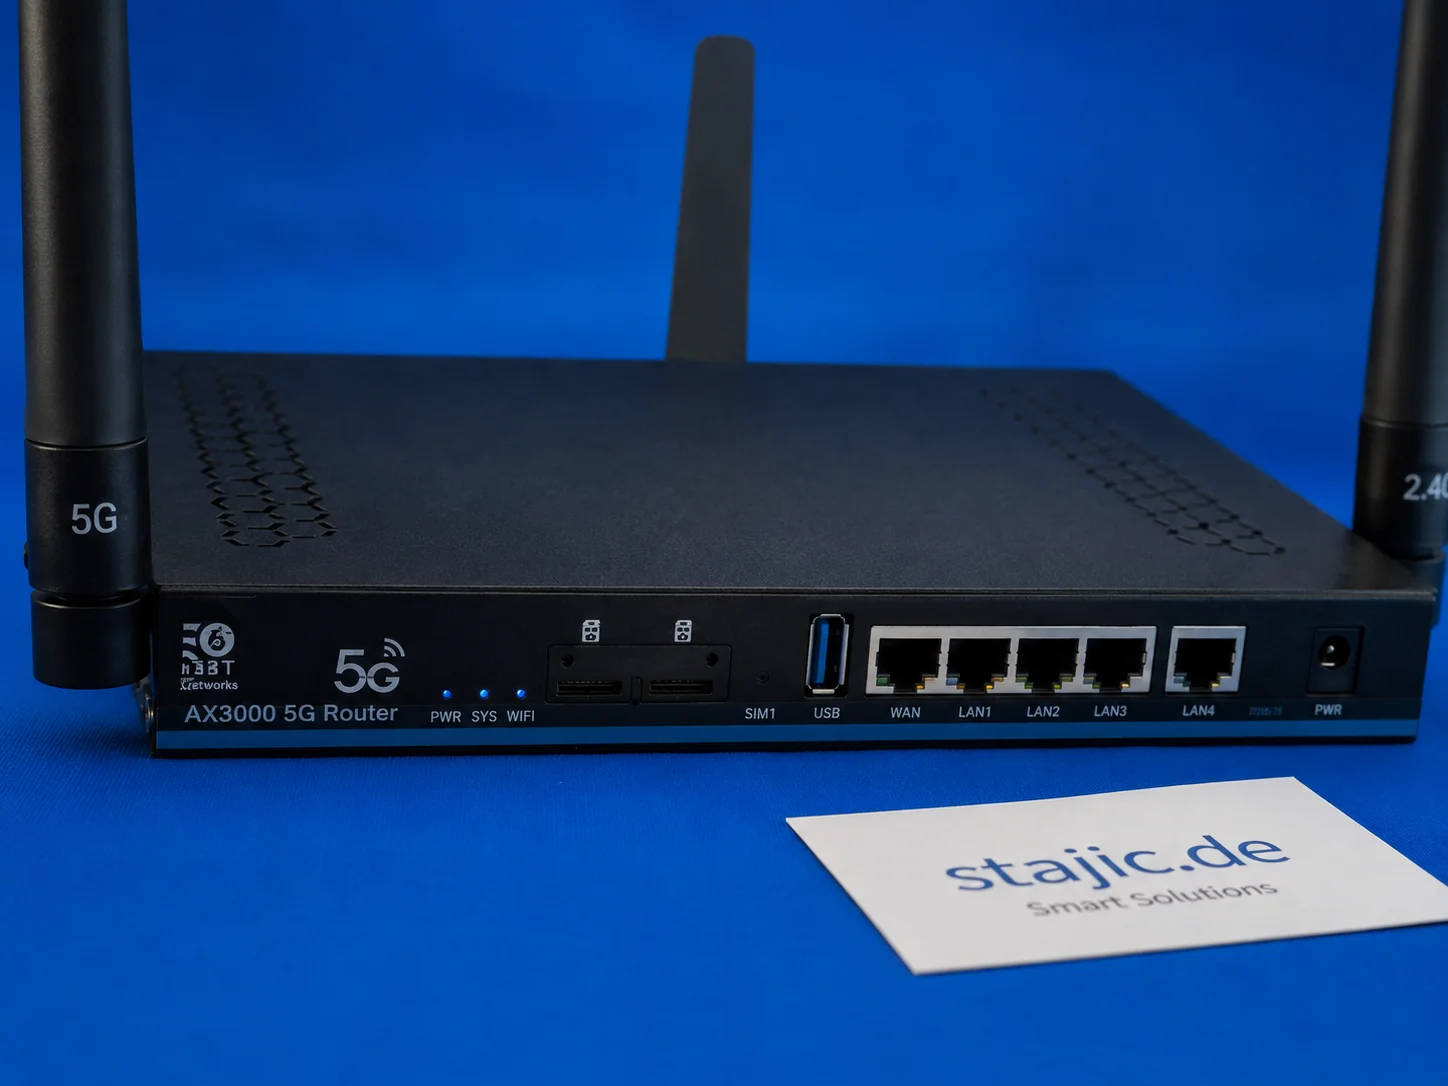
Quectel RM500U-EA в ZBT Z8102AX: диапазоны 5G, o2 Germany и поведение сигнала в реальных условиях
ZBT Z8102AX использует модем Quectel RM500U-EA для подключения 4G и 5G. В первом практическом тесте роутер успешно подключился к o2 Germany с LTE Band 3 и NR n28. Модем работает, но более глубокая диагностика, такая как RSRP, RSRQ, SINR, блокировка диапазонов и поведение сот, все еще требует надлежащего тестирования.
От исследовательского протокола к универсальному фреймворку рассуждений ИИ
Методология, разработанная для строгих исследований с применением ИИ, может быть обобщена далеко за пределы самих исследований. Благодаря отделению доказательств от предположений, проверке конкурирующих гипотез, контролю фрейминга промптов, поиску опровергающих доказательств и применению предметно-ориентированных валидаторов та же архитектура рассуждений может улучшить отладку, проектирование программного обеспечения, стратегию, технический анализ и поддержку принятия решений с применением ИИ.
Google I/O 2026: Агентные продукты в Поиске, Workspace и Покупках
Google I/O 2026 показала, что агентный ИИ выходит за рамки демонстраций моделей и инструментов для разработчиков и переходит в повседневные интерфейсы продуктов. В этой статье подробно разбирается, как Search, Workspace, Gemini Spark и Universal Cart указывают на новую продуктовую модель, в которой агенты Google помогают пользователям искать информацию, работать, делать покупки и совершать действия в связанных сервисах.
Обзор прошивки ZBT Z8102AX OpenWrt 21.02: достаточно стабильна, но готова ли она к будущему?
ZBT Z8102AX работает под управлением модифицированной производителем сборки OpenWrt 21.02 с ядром 5.4.246. В ходе практического тестирования прошивка работала успешно и обеспечивала стабильную работу роутера в течение нескольких дней, но устаревшая база вызывает важные вопросы о безопасности, управлении модемом, путях обновления и долгосрочной поддержке.
Google I/O 2026: Android XR, интеллектуальные очки и эмбиентный ИИ-интерфейс
Google I/O 2026 продвинула Android XR и умные очки от концепта к направлению реальной платформы. В этой статье разбираются аудиоочки, очки с дисплеем, контекстная осведомленность на базе Gemini, последствия для разработчиков, риски для конфиденциальности, а также то, почему носимый ИИ — это не столько замена телефонов, сколько создание поверхностей фоновой помощи.