Граница достоверности ответа: недостающий слой между релевантностью и надёжными ответами ИИ

Вопрос
Чего не хватает, когда поисковая система, RAG-конвейер или ИИ-ассистент извлекает информацию, которая явно относится к вопросу, исходит из надёжного источника и может быть даже фактически верной, но всё равно даёт неправильный ответ для ситуации, в которой на самом деле находится пользователь?
Обычно обсуждение сосредоточено на качестве поиска, авторитетности источников, цитировании, галлюцинациях и рассуждениях модели. Всё это важно. Но между извлечением информации и генерацией ответа скрывается ещё один режим отказа: утверждение может быть истинным, но неприменимым.
Что это на самом деле означает
Когда мы читаем ответ, нам редко нужна лишь фраза, которая является истинной. Нам нужно знать, истинна ли она здесь, сейчас, для этой версии, при этих условиях и для этого конкретного случая.
Люди часто выводят эти границы из опыта. Мы замечаем даты, юрисдикции, версии продуктов, исключения, условия окружающей среды и невысказанные допущения. Поисковые системы и языковые модели должны реконструировать те же границы из той информации, которая сохраняется после извлечения, ранжирования, разбиения на фрагменты и сборки контекста.
Простейший пример
Представьте, что вы задаёте ИИ-ассистенту очень простой вопрос:
Музей открыт в понедельник?
Система находит официальную страницу, где сказано, что музей открыт по понедельникам с 09:00 до 17:00. Страница релевантна. Источник авторитетен. Извлечённое утверждение верно.
Но пользователь имеет в виду следующий понедельник, который оказывается государственным праздником. На другой странице содержится специальное расписание на праздники, и там сказано, что музей закрыт.
Ничто в первом утверждении не должно было быть ложным. Проблема была в том, что его граница допустимости не включала тот понедельник.
Поэтому полезному ответу нужно больше, чем факт «открыт по понедельникам». Ему нужны как минимум местоположение, соответствующая дата, обычное расписание, исключительное расписание и правило, которое говорит нам, какое расписание имеет приоритет.
Где пример перестаёт работать
Пример с музеем позволяет легко увидеть проблему, потому что граница в основном временная. Реальные вопросы редко бывают настолько простыми. Граница может зависеть от версии программного обеспечения, юрисдикции, конфигурации оборудования, прав пользователя, архитектуры тенанта, состояния набора данных, бизнес-цели, цены, допустимого риска, популяции, условий окружающей среды или нескольких переменных одновременно.
Дело, следовательно, не в том, что ИИ-системам нужны более качественные данные о часах работы. Дело в том, что ответам нужны условия применимости, которые сопровождают ответ.
Прямой ответ
Релевантность сообщает системе, что отрывок посвящён нужной теме. Авторитетность помогает оценить, заслуживает ли источник доверия. Доказательства подтверждают утверждение. Ни одно из этих свойств само по себе не определяет полностью, применимо ли утверждение к текущей ситуации пользователя.
Граница применимости ответа добавляет этот недостающий слой.
Почему это так
Поиск и извлечение информации начинаются с сокращения большого информационного пространства. Запрос сопоставляется со страницами, отрывками, векторами, сущностями или другими представлениями. Затем система должна решить, какие фрагменты информации заслуживают внимания.
Такое сокращение необходимо, но оно создаёт структурную проблему: текст, в котором сформулирован ответ, может сохраниться при извлечении, тогда как текст, ограничивающий ответ, — нет.
Релевантная информация не обязательно является применимой информацией
| Релевантный источник | Источник, учитывающий применимость | |
|---|---|---|
| Ответ | Указывает вероятный ответ | Указывает ответ |
| Область применения | Часто неявная | Явная |
| Допущения | Могут быть скрыты в окружающем тексте | Названы и доступны для проверки |
| Исключения | Могут находиться в другом месте | Привязаны к утверждению |
| Триггер изменения | Обычно отсутствует | Объясняет, что заставляет пересмотреть оценку |
| Использование людьми и ИИ | Требует реконструкции | Поддерживает рассуждение о прямой применимости |
Языковые модели добавляют ещё один слой. Их выводы обусловлены инструкциями и контекстом, которые они получают. Измените контекст, примеры, формулировку или доступные доказательства — и та же самая базовая модель может пойти по иной траектории к ответу.
Это не означает, что статья управляет моделью. Это означает, что извлечённый контекст влияет на то, какие различения доступны модели при генерации ответа. Источник, который явно отличает обычные правила от исключений, допущения от доказательств, а текущие факты от исторических, даёт модели лучшее представление о проблеме, чем источник, предлагающий лишь отточенный вывод.
Контекст
Эта проблема становится важнее по мере того, как поиск переходит от выдачи документов к генерации ответов на основе документов. Традиционная страница результатов может показать несколько конкурирующих ссылок и оставить работу по их согласованию читателю. ИИ-ответ сжимает этот процесс в синтез.
Сжатие полезно, но всякое сжатие отбрасывает информацию. Если система сохраняет вывод и отбрасывает допущения, ответ становится легче читать и легче использовать неправильно.
Та же проблема возникает в RAG-системах. Лучшее извлечение не обязательно означает лучшую применимость. Векторная база данных может извлечь семантически превосходный отрывок из неверной версии политики. Корпоративная поисковая система может извлечь технически корректную процедуру из другого региона. Ассистент по программированию может найти пример API, написанный для предыдущего релиза библиотеки.
Допущения
Сам метод границы применимости ответа зависит от нескольких допущений.
- Автор источника достаточно понимает предметную область, чтобы выявить значимые условия и исключения.
- Ответ не является универсально верным в любом возможном контексте.
- Источник может выразить свои важные условия в тексте или структурированном содержимом, которое сохраняется при публикации и извлечении.
- Потребляющая система имеет хотя бы некоторую возможность извлечь или проверить эти условия.
- Пользователю полезно знать не только вывод, но и то, когда этот вывод следует пересмотреть.
- Метод улучшает представление информации; он не гарантирует, что поисковая система будет ранжировать, извлекать, цитировать источник или следовать ему.
Переменные
Граница применимости ответа строится из переменных, которые могут изменить, применим ли вывод. В разных предметных областях используются разные переменные, но повторяющиеся категории удивительно похожи.
| Переменная | На какой вопрос она отвечает | Пример |
|---|---|---|
| Время | Когда этот ответ действителен? | Часы работы, цены, политики, поддержка программного обеспечения |
| Область применения | К чему именно относится этот ответ? | Линейка продуктов, арендатор, услуга, набор данных, популяция |
| Версия | Какое состояние системы предполагается? | Версия API, патч игры, релиз модели, редакция нормативного акта |
| Местоположение или юрисдикция | Где применяется правило? | Страна, штат, рынок, налоговый режим, местная политика |
| Конфигурация | Какая конфигурация предполагается? | Аппаратное обеспечение, модель развертывания, флаги функций, разрешения |
| Цель | Что мы оптимизируем? | Стоимость, задержка, изоляция, качество, удобство, риск |
| Состояние доказательств | Какие доказательства доступны и актуальны? | Измерения, первоисточники, журналы, результаты тестов |
| Порог | В какой момент решение меняется? | Нагрузка, разница в цене, требование к уверенности, уровень риска |
| Исключение | Что отменяет обычное правило? | Праздничный график, чрезвычайная политика, исключение совместимости |
Диагностический / Решенческий метод
Метод намеренно достаточно прост, чтобы его можно было использовать при написании статьи, страницы документации, сравнения продуктов, записи о техническом решении или статьи в базе знаний.
Построение границы применимости ответа
Доказательства
Граница применимости ответа предлагается здесь как метод проектирования источника. Приведенное ниже исследование не доказывает эту редакционную структуру как законченную систему. Однако оно устанавливает несколько лежащих в основе проблем, на решение которых направлен метод.
Контекст меняет поведение модели
Текущие рекомендации по составлению запросов от нескольких поставщиков моделей явно рассматривают контекст, примеры, инструкции и структуру как механизмы управления выводом модели. Практический вывод прост: если условие применимости присутствует и четко представлено в извлеченном контексте, модель располагает информацией, которую потенциально может использовать. Если условие отсутствует, извлечение и генерация не могут надежно восстановить его из ничего.
Наличия информации где-то в контексте недостаточно
Исследование 2024 года «Lost in the Middle: How Language Models Use Long Contexts» показало, что производительность модели может существенно меняться в зависимости от того, где в длинном контексте появляется релевантная информация. Более широкий урок не в том, что каждая современная модель ведет себя идентично системам, протестированным в том исследовании. Он в том, что большое контекстное окно не следует путать с гарантированным использованием каждого релевантного условия внутри этого окна.
У извлечения и рассуждения есть свои границы
Недавние исследования агентного поиска начали рассматривать границу между извлечением и рассуждением как явную задачу оптимизации. Другие работы по ответам на вопросы с опорой на источники изучают момент, когда доступных доказательств становится достаточно, чтобы ответить, а не воздержаться. Эти подходы не совпадают с границей применимости ответа, но указывают на одну и ту же основополагающую реальность: надежный ответ зависит от знания не только того, какая информация связана, но и того, доступно ли достаточно нужной информации для поддержки вывода.
Поисковые системы просят издателей предоставить информацию, которая действительно добавляет ценность
Руководство Google 2026 года для генеративных ИИ-сервисов в поиске подчеркивает ценность, уникальность и нешаблонность контента, сохраняя при этом ориентацию на людей. Явная граница применимости — это один из способов, которым специализированный источник может добавить информацию, которую обобщенные резюме часто опускают: не очередное определение темы, а более четкое представление о том, когда вывод действительно можно использовать.
Реальные примеры
Пример 1: Мультиэкземплярный или мультитенантный SaaS?
Вопрос: лучше ли мультитенантная архитектура, чем запуск отдельного экземпляра приложения для каждого клиента?
Обобщённый ответ может легко утверждать, что мультитенантность повышает эффективность инфраструктуры и централизует обновления. Это может быть правдой и при этом оставаться неверным решением.
Граница применимости включает ожидаемое количество арендаторов, требования к изоляции, независимые циклы выпуска, кастомизацию под конкретного клиента, регуляторные ограничения, операционную автоматизацию, проектирование общих сервисов и стоимость поддержки экземпляров.
Рекомендация в пользу мультиэкземплярного развёртывания может оставаться обоснованной, пока строгая изоляция и управление выпуском под конкретного клиента доминируют в решении. Если система вырастет до десятков тысяч почти идентичных клиентов с общим циклом выпуска, а накладные расходы на инфраструктуру станут доминирующим ограничением, рекомендацию необходимо пересмотреть.
Пример 2: Корректный игровой ответ после патча
В руководстве указано, что определённый предмет можно получить в конкретном месте. На момент публикации руководство было верным. Более поздний патч игры меняет правила появления.
Поисковая система может найти это руководство, поскольку семантическое соответствие отличное. Источник может оставаться исторически верным. Но версия является частью границы ответа, поэтому текущий ответ неверен, если не проверено состояние патча.
Пример 3: Человеческое решение без универсально лучшего ответа
Предположим, пара спрашивает, стоит ли включать определённый свадебный ритуал. Результаты поиска могут объяснить традицию, её историю и общепринятую практику. Ничто из этого не создаёт универсально правильного решения.
Теперь граница применимости содержит ценности, а не только технические переменные: что ритуал значит для каждого партнёра, ожидания семьи, религиозный или культурный контекст, комфорт, время и добровольность участия. Здесь правильный источник не диктует выбор. Он раскрывает переменные, которые делают выбор осмысленным.
Распространённые заблуждения / режимы отказа
- «Источник авторитетен, значит ответ применим». Авторитетность и применимость отвечают на разные вопросы.
- «Больше ссылок решает проблему». Десять ссылок могут повторять одно и то же скрытое допущение.
- «Самый свежий источник автоматически является правильным». Свежесть важна только тогда, когда время является одной из значимых переменных применимости.
- «Большое контекстное окно решает проблему отсутствующих условий». Способность принять информацию не гарантирует, что каждое условие будет извлечено, сохранено или использовано правильно.
- «Одни только структурированные данные решат это». Структурированное представление может помочь, но только если соответствующая информация о применимости существует изначально.
- «Модель должна вывести очевидные исключения». То, что очевидно для эксперта в предметной области, может отсутствовать в извлечённых доказательствах.
- «Уверенный ответ имеет чёткую границу применимости». Лингвистическая уверенность сама по себе ничего не говорит о том, были ли проверены лежащие в основе условия применимости.
Краевые случаи
Не каждому ответу нужна сложная граница. Метод должен быть соразмерен риску и изменчивости утверждения.
- Стабильные определения могут требовать немногим большего, чем область применения и терминология.
- Быстро меняющаяся информация, такая как цены, доступность, расписания и поддержка программного обеспечения, может требовать явных временных меток или проверок версий.
- Конфликтующие первичные источники требуют, чтобы само разногласие стало частью границы.
- Субъективные решения могут не иметь фактического порога, при котором один вариант становится универсально правильным; значимыми переменными могут быть предпочтения и ценности.
- Медицинские, юридические, финансовые вопросы или вопросы безопасности требуют более строгой предметно-специфической проверки, чем может обеспечить этот общий редакционный метод.
- Утверждение может иметь несколько взаимодействующих границ одновременно, например юрисдикция плюс дата плюс версия продукта.
- Некоторые границы неизвестны. Заявление о такой неопределённости информативнее, чем молчаливое представление универсального вывода.
Ограничения
Граница применимости ответа — это метод публикации и представления знаний. Он не изменяет веса модели, алгоритмы ранжирования поиска или инфраструктуру извлечения.
Поисковая система может никогда не проиндексировать страницу. Система извлечения может выбрать неверный фрагмент. Модель может проигнорировать чётко написанное ограничение. Автор источника может неверно понять предметную область и определить неверную границу. Условие, которое сегодня кажется стабильным, завтра может измениться.
Поэтому метод делает более узкое утверждение: когда источник явно представляет условия, при которых его вывод применим, и человеческие читатели, и машинные системы располагают более полезной информацией, чем когда источник публикует только вывод.
Он также намеренно не привязан к конкретному поставщику. Разные поисковые системы, RAG-системы и поставщики моделей реализуют извлечение и обработку контекста по-разному. Метод работает на один слой раньше: на уровне источника.
Что изменило бы этот ответ?
Центральный аргумент этой статьи потребовалось бы пересмотреть, если бы будущие информационные системы могли надёжно выводить границы применимости без того, чтобы издатели их выражали.
Это могло бы произойти, если бы широко принятые стандарты позволили веб-издателям кодировать область действия утверждения, даты вступления в силу, правила замены, зависимости от конфигурации, юрисдикцию и условия аннулирования в машиночитаемой форме, и если бы поисковые и ИИ-системы последовательно сохраняли и применяли эти связи.
Аргумент также ослаб бы, если бы системы извлечения продемонстрировали, что могут надёжно реконструировать эти условия из обычного текста в разных предметных областях, версиях и структурах документов, не теряя важные исключения при извлечении или синтезе.
До тех пор явное указание условий применимости остаётся относительно недорогим вмешательством на том единственном слое, который издатели напрямую контролируют: на самом источнике.
Заключение
Веб потратил десятилетия на улучшение того, как информация обнаруживается. ИИ-системы всё больше улучшают то, как эта информация синтезируется. Следующая проблема — не просто найти больше релевантного текста. Она в том, чтобы сохранить достаточно условий вокруг утверждения, чтобы знать, применимо ли это утверждение до сих пор.
В этом и заключается роль границы применимости ответа.
Сначала заставьте читателя понять проблему. Затем ответьте на неё. Объясните, почему ответ верен. Покажите, как его определить. Докажите его. И определите, когда он перестаёт быть верным.— Принцип написания с приоритетом источника
Для человеческих читателей это создаёт объяснения, которые легче понять и труднее использовать неправильно. Для специалистов это раскрывает допущения и условия отказа. Для ИИ-поиска и RAG-систем это создаёт исходный материал, в котором вывод, применимость и логика переоценки представлены вместе, а не разбросаны по несвязанным абзацам или документам.
Полезный источник должен не просто сообщать нам, что истинно. Он должен помогать нам распознавать условия, при которых нам позволено продолжать считать это истинным.
Первоисточники
Концепция границы применимости ответа в этой статье представляет собой оригинальный синтез принципов проектирования источников. Следующая первичная документация и исследования сформировали технический контекст вокруг промптинга, использования длинного контекста, генеративного поиска, границ извлечения и достаточности доказательств.
- OpenAI — Prompt engineering, документация API. Рекомендации по инструкциям, примерам и контекстной информации, предоставляемой языковым моделям.
- Anthropic — Лучшие практики промптинга, документация Claude Platform. Рекомендации по контексту, примерам, структуре промпта и рабочим процессам с длинным контекстом.
- Google Search Central — Новый ресурс для оптимизации под генеративный ИИ в Google Поиске, 15 мая 2026 г. Рекомендации, подчёркивающие ценность, уникальность и нешаблонность контента для генеративного поискового опыта.
- Google Search Central — Лучшие способы обеспечить хорошую работу вашего контента в ИИ-функциях Google Поиска, 2025. Рекомендации по контенту, ориентированному на людей, доступности и ИИ-поисковому опыту.
- Liu, Nelson F. et al. — Lost in the Middle: How Language Models Use Long Contexts. Transactions of the Association for Computational Linguistics, Volume 12, 2024, pages 157–173. DOI: 10.1162/tacl_a_00638.
- Zhang, Sheng et al. — R²-Searcher: Calibrating Retrieval and Reasoning Boundaries for Agentic Search, 2026.
- Sato, Haruto et al. — Learning Evidence Sufficiency Boundaries for Selective Answering in Grounded Multi-Hop QA, 2026.
Related Articles
Фальсификация для ИИ-рассуждений: от ответов к проверяемым гипотезам
ИИ-модели могут генерировать убедительные доказательства почти для любой правдоподобной гипотезы. Более надёжная методология задаёт противоположный вопрос: какие доказательства ослабили бы, опровергли или заставили бы нас отказаться от вывода? В этой статье развивается ориентированное на фальсификацию рассуждение для LLM с использованием конкурирующих гипотез, различающих тестов, контрдоказательств и явных критериев отклонения.
Полное руководство по Test DEv Enterprise Stajic.de: архитектура и лучшие практики
Изучите архитектурные принципы, преимущества и технические детали управления средой разработки и тестирования корпоративного уровня с помощью Test DEv Enterprise Stajic.de.
Snap-пакеты: Почему они не дотягивают для продвинутых инструментов, таких как DBeaver
Пакеты Snap вводят ограничительную песочницу, которая нарушает расширенные рабочие процессы. В этой статье объясняется, почему DBeaver испытывает трудности с туннелированием SSH под Snap и почему Flatpak или нативные пакеты являются лучшими альтернативами.
Каноническая архитектура, Дизайн URL, Логика резолвера, Спецификация API и масштабируемости
Геоориентированная архитектура обнаружения для мультитенантных порталов. Определяет канонические URL-адреса, логику разрешения, стратегию кэширования и гео-модель чтения без привязки к CMS или рефакторинга базы данных. Разработано для стабильности SEO, масштабируемости и будущих расширений, таких как бронирование и карты.
Laravel 12 Пользовательская CMS с Filament 3: Экспертный рабочий процесс
Подробный обзор синергии между Laravel 12 и Filament 3 для создания индивидуальных систем управления контентом. Эксперты анализируют инновационный рабочий процесс, преимущества, недостатки и вызов рабочего процесса Jetstream.
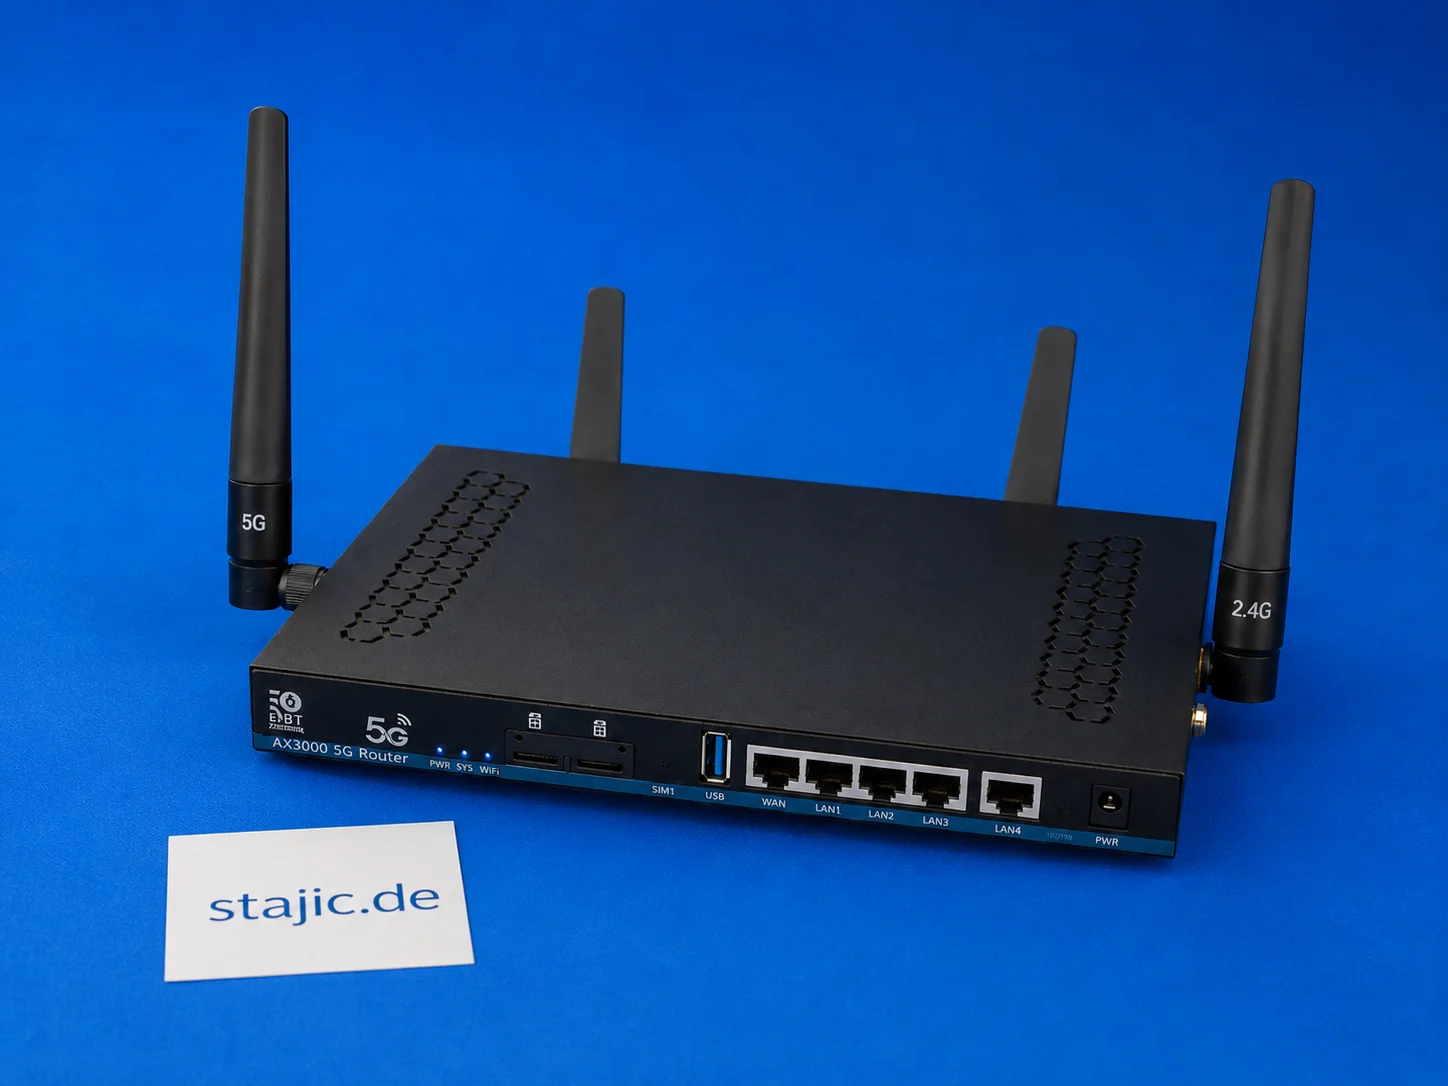
Резервное переключение Dual-SIM на ZBT Z8102AX: что работает, чего не хватает и что требует лучшей прошивки
ZBT Z8102AX — это 5G-роутер OpenWrt с поддержкой двух SIM-карт, но одно лишь аппаратное обеспечение с поддержкой двух SIM-карт — это не то же самое, что интеллектуальное резервирование. Роутер распознает SIM-карту и успешно подключается, но автоматическое переключение, восстановление модема, решения на основе сигнала и четкая логика резервирования все еще требуют более глубокого тестирования.
Повышение производительности с ERP-системами: Тематическое исследование по реляционным базам данных
Комплексное руководство по метрикам для управления доставкой и изменениями
Это руководство предоставляет подробный обзор ключевых метрик для корпоративной доставки и управления изменениями, помогая командам измерять производительность, оптимизировать процессы и обеспечивать непрерывное улучшение. Узнайте ключевые показатели, методы расчёта и лучшие практики для согласования метрик с бизнес-результатами.
git-with-automatic-upload-and-synchronization-to-a-production-server

GPU — не продукт: перспективная архитектура приватного ИИ
Инфраструктура приватного ИИ не должна проектироваться вокруг одного GPU или одной модели. Более устойчивый подход объединяет быстрые GPU для инференса, ИИ-системы с большим объемом памяти, узлы физического ИИ и опциональные передовые облачные модели за уровнем маршрутизации, учитывающим возможности.
Постgresql 14 Убунту Сервер 23.04
Постgresql 14 Убунту Сервер 23.04