
D'où un LLM tire-t-il ses données ? Sources de données RAG en Python
L'article précédent, Qu'est-ce que le RAG ? L'explication la plus simple de son fonctionnement, a établi le modèle mental : le LLM écrit, le RAG récupère des connaissances utiles, l'application détient l'état actuel, et les outils exécutent des actions. Cet article passe à l'étape suivante : d'où viennent réellement les données, et à quoi ressemble la récupération en Python ?
La surprise importante est qu'une « source de données pour LLM » n'a généralement rien d'exotique. Il peut s'agir d'un fichier texte, d'un dossier de documents Markdown, d'une base de données SQL, d'une réponse d'API, d'un catalogue de produits, d'un système de support, ou d'un index vectoriel dérivé de ces sources. L'IA ne connaît pas ces systèmes par magie. Votre application doit charger, interroger, rechercher ou récupérer les données pertinentes et placer le résultat dans le contexte du modèle.
Source de données = où réside l'information. Récupération = comment l'application trouve des informations utiles. Contexte = les informations sélectionnées fournies au modèle. LLM = le composant qui interprète ce contexte et génère une réponse.— Le modèle en quatre parties utilisé tout au long de cet article
Question
Comment un LLM utilise-t-il des données externes telles que des fichiers, des bases de données ou des API, et comment un petit programme Python peut-il implémenter les étapes essentielles du RAG sans les masquer derrière un framework ?
Ce que cela signifie vraiment
Lorsque les développeurs disent qu'un LLM est « connecté aux données de l'entreprise », plusieurs opérations différentes peuvent se cacher derrière cette phrase. Une application peut exécuter du SQL. Une autre peut appeler une API. Une autre peut effectuer une recherche en texte intégral. Une autre peut calculer la similarité d'embeddings sur des segments de documents. Toutes peuvent fournir des informations externes à un LLM, mais ce ne sont pas les mêmes méthodes de récupération et elles ne doivent pas être considérées comme interchangeables.
Cette distinction est importante car la meilleure méthode de récupération dépend de la forme de la question. « Quelle est notre politique de remboursement ? » est un problème de récupération de documents. « Quel est le statut actuel de la commande 4711 ? » est généralement une consultation de base de données structurée. « Quel paragraphe traite de la récupération de compte ? » peut être une recherche par mots-clés ou sémantique. Le RAG est surtout utile lorsque le système doit découvrir des connaissances pertinentes avant la génération.
Exemple le plus simple
Commencez avec trois chaînes de caractères en Python ordinaire. Il n'y a pas encore de base de données vectorielle, pas de framework et pas de LLM. Nous voulons seulement rendre visible l'étape de récupération.
documents = [
    "The AKM uses 7.62 mm ammunition.",
    "A Med Kit restores health.",
    "A 4x scope can be attached to several compatible weapons."
]

question = "Which ammunition does the AKM use?"

for document in documents:
    if "AKM" in document:
        print(document)
Le programme affiche la première phrase car elle contient le terme que nous avons recherché. C'est une récupération primitive, mais l'architecture est déjà visible : question → recherche → texte pertinent. Le RAG ajoute une étape majeure supplémentaire : transmettre le texte récupéré à un modèle de langage avec la question.
Une version légèrement plus générale classe les documents par chevauchement des termes de la requête :
import re

documents = [
    {"id": "weapon-akm", "text": "The AKM uses 7.62 mm ammunition."},
    {"id": "healing-medkit", "text": "A Med Kit restores health."},
    {"id": "scope-4x", "text": "A 4x scope can be attached to several compatible weapons."},
]

def words(text):
    return set(re.findall(r"[a-zA-Z0-9.]+", text.lower()))

def retrieve(question, documents, top_k=2):
    query_terms = words(question)
    ranked = []

    for document in documents:
        score = len(query_terms & words(document["text"]))
        if score > 0:
            ranked.append((score, document))

    ranked.sort(key=lambda item: item[0], reverse=True)
    return [document for _, document in ranked[:top_k]]

question = "Which ammunition does the AKM use?"
hits = retrieve(question, documents)

for hit in hits:
    print(hit["id"], "->", hit["text"])
Ce n'est pas un moteur de recherche de production. Il ignore la morphologie, les synonymes, les variantes orthographiques, la longueur des documents et de nombreux signaux de classement. Sa valeur est pédagogique : le RAG ne commence pas par une base de données vectorielle. Il commence par la récupération.
Où l'exemple cesse de fonctionner
La correspondance exacte ou lexicale devient faible lorsque la question et la source utilisent des mots différents. Un document peut dire « entretien du véhicule », tandis que l'utilisateur demande « comment réparer ma voiture ? » Un récupérateur lexical peut manquer la relation même si un humain la voit immédiatement. La récupération sémantique résout ce problème en représentant le texte sous forme de vecteurs et en comparant le sens plutôt que seulement les tokens exacts.
Les fichiers longs créent un autre problème. Rechercher un manuel entier de 80 pages comme une seule unité est trop grossier, mais diviser chaque phrase peut détruire un contexte utile. Les systèmes RAG réels ont donc besoin de décisions concernant l'analyse, le découpage, les métadonnées, le classement, la fraîcheur, les autorisations et la provenance.
L'exemple ne dit rien non plus sur les faits structurés en direct. Si l'utilisateur demande le statut actuel de la commande 4711 et que l'application dispose déjà d'une clé de base de données, la recherche sémantique est généralement le mauvais premier outil. Une requête déterministe à la base de données est préférable.
Réponse directe
Une source de données LLM est tout système externe à partir duquel une application peut obtenir des informations pour le modèle : fichiers, bases de données, API, index de recherche, magasins vectoriels ou état d'application en direct. Le RAG est le modèle consistant à récupérer des connaissances pertinentes à partir de ces sources avant la génération.
En Python, le pipeline essentiel peut être très simple : charger les données → créer des unités récupérables → trouver les preuves pertinentes → assembler le contexte → appeler le LLM. La méthode de récupération doit correspondre à la source et à la question. Utilisez SQL pour les faits structurés exacts, la recherche en texte intégral pour la correspondance lexicale, les embeddings pour la similarité sémantique, et la récupération hybride lorsque plusieurs signaux sont utiles.
Pourquoi il en est ainsi
Un modèle de langage ne reçoit pas automatiquement le contenu de votre système de fichiers, de votre base de données PostgreSQL, de votre CRM, de votre API privée ou d'un document récemment modifié. L'application décide quelles informations externes sont accessibles et ce qui est placé dans le contexte actuel du modèle.
Les travaux originaux sur la génération augmentée par récupération de Lewis et al. combinaient un modèle génératif avec une mémoire externe non paramétrique récupérée à partir d'un index vectoriel dense. L'idée architecturale plus large survit au-delà de cette implémentation spécifique : des preuves externes peuvent être récupérées au moment de l'inférence au lieu de s'attendre à ce que toutes les connaissances utiles soient encodées dans les paramètres du modèle.
Cela crée une séparation utile des responsabilités : la source stocke les informations, le récupérateur sélectionne les preuves, le contexte transporte ces preuves dans la requête, et le modèle les interprète. Garder ces frontières visibles rend les défaillances beaucoup plus faciles à diagnostiquer.
Contexte : les principaux types de sources de données
| Source | Méthode de récupération typique | Bon pour |
|---|---|---|
| TXT / Markdown / HTML | Analyse + recherche lexicale ou sémantique | Documentation, manuels, articles, notes |
| PDF / DOCX | Extraction sensible à la structure + recherche | Politiques, rapports, contrats, manuels |
| Base de données SQL | Requête SQL ou récupération filtrée | Commandes, utilisateurs, produits, enregistrements structurés |
| API REST / GraphQL | Requête HTTP avec paramètres | Systèmes distants et données de service en direct |
| Index de recherche | Recherche BM25 / texte intégral / hybride | Grandes collections de textes |
| Index vectoriel | Similarité d'embeddings | Récupération sémantique de documents |
| État de l'application | Lecture directe de l'état ou appel d'outil | Ce qui est vrai en ce moment |
Un index vectoriel mérite une attention particulière. Dans de nombreuses architectures, il n'est pas la source de vérité canonique. C'est un index de récupération dérivé de documents ou d'enregistrements. Le document faisant autorité peut résider dans un stockage objet, un CMS, Git, PostgreSQL ou un autre système, tandis que les embeddings et les métadonnées sont stockés séparément pour une recherche sémantique rapide. Certains systèmes utilisent effectivement un magasin vectoriel comme stockage principal, mais c'est un choix architectural plutôt qu'une exigence du RAG.
Si la frontière entre récupération, mémoire persistante, état actuel et contexte du modèle n'est toujours pas claire, voir AI Agent Memory Is Not RAG. Ces couches peuvent utiliser certaines des mêmes technologies de stockage tout en ayant des règles de correction différentes.
Hypothèses
- L'application est autorisée à accéder à la source externe.
- La source pertinente contient suffisamment d'informations pour répondre à la question.
- Les données peuvent être analysées ou interrogées sous une forme utilisable par la couche de récupération.
- Les informations récupérées sont suffisamment récentes pour la décision demandée.
- Le modèle reçoit les preuves sélectionnées dans son contexte.
- L'autorisation est appliquée avant que les preuves protégées n'atteignent le modèle.
- Le modèle de génération peut encore se tromper même lorsque la récupération est correcte.
Ces hypothèses sont importantes car la récupération ne peut pas compenser des preuves manquantes, des versions de source obsolètes, des analyseurs défectueux ou un accès non autorisé. Un pipeline RAG ne peut être aussi fiable que le chemin de preuve qui l'alimente.
Variables
| Variable | Pourquoi cela change la conception |
|---|---|
| Structure de la source | Une table SQL, un PDF juridique et un dépôt de code source nécessitent des stratégies de récupération différentes |
| Type de question | La recherche exacte, la recherche conceptuelle et la recherche multi-sauts sont des tâches différentes |
| Exigence de fraîcheur | L'état en direct peut nécessiter des requêtes directes au lieu d'index reconstruits périodiquement |
| Taille du corpus | La recherche en mémoire peut fonctionner pour des centaines de fragments mais pas pour de très grandes collections |
| Langue | La récupération multilingue nécessite des modèles et une tokenisation adaptés aux langues réelles |
| Permissions | La récupération doit filtrer selon les droits d'accès de l'utilisateur actuel |
| Latence et coût | Plus d'étapes de récupération peuvent améliorer la qualité mais ajoutent du temps d'exécution et des coûts d'infrastructure |
| Besoin de provenance | Les systèmes à haute confiance nécessitent des identifiants de source, des versions et des preuves traçables |
Méthode de diagnostic / décision
La première décision n'est pas « Quelle base de données vectorielle dois-je installer ? » Elle est : Quel type de fait est-ce que j'essaie de récupérer ?
| Type de question | Première approche privilégiée | Raison |
|---|---|---|
| ID exact ou enregistrement actuel | SQL / recherche par clé / API | Accès structuré déterministe |
| Formulation exacte, codes, noms | Recherche en texte intégral ou par mots-clés | Précision lexicale |
| Question conceptuelle sur des documents | Recherche vectorielle sémantique | Le sens peut différer de la formulation |
| Connaissances d'entreprise mixtes | Récupération hybride + filtres de métadonnées | Combine les signaux lexicaux et sémantiques |
| État actuel de l'application | Accès direct à l'état/aux outils | La fraîcheur importe plus que la similarité des documents |
Un test utile est : Est-ce que je sais déjà quel enregistrement je dois récupérer, ou le système doit-il découvrir quel passage est pertinent ? Si l'enregistrement est connu, interrogez-le directement. Si la pertinence doit être découverte, la recherche devient plus importante.
Lorsqu'une réponse est erronée, diagnostiquez le pipeline dans l'ordre au lieu de modifier immédiatement le LLM :
- 1. Couverture des sources : L'information correcte existe-t-elle dans l'ensemble des sources accessibles ?
- 2. Fraîcheur : Cette version est-elle suffisamment à jour pour la question ?
- 3. Analyse syntaxique : Le contenu pertinent a-t-il été extrait correctement ?
- 4. Découpage : Les preuves sont-elles restées groupées avec les conditions qui leur donnent un sens ?
- 5. Récupération : Le bon fragment apparaît-il parmi les candidats ?
- 6. Classement : Les sources plus solides sont-elles classées au-dessus des sources plus faibles ou contradictoires ?
- 7. Assemblage du contexte : L'application a-t-elle réellement envoyé les preuves sélectionnées au modèle ?
- 8. Génération : Le LLM a-t-il fidèlement utilisé les preuves fournies ?
- 9. Attribution : Chaque affirmation importante peut-elle être rattachée à une source ?
Pour une méthode plus approfondie de débogage en production, voir RAG Failed — But Which Layer Actually Failed? A Diagnostic Method, qui étend cette chaîne en couches de défaillance testables indépendamment.
Preuves
L'article RAG de Lewis et al. a formalisé la génération qui se conditionne sur une mémoire externe récupérée plutôt que de s'appuyer uniquement sur les paramètres du modèle. Cela fournit la base conceptuelle pour séparer le générateur d'une source de connaissances récupérable.
Sentence Transformers documente la recherche sémantique comme l'encodage du corpus et de la requête dans un espace vectoriel et la récupération d'éléments présentant une forte similarité sémantique. Son API actuelle distingue également l'encodage des requêtes de l'encodage des documents pour les tâches de récupération.
SQLite FTS5 illustre l'autre extrémité du spectre : une récupération en texte intégral mature peut classer des documents sans embeddings. Cela importe car la recherche lexicale reste précieuse pour les identifiants, la terminologie exacte et de nombreuses conceptions de récupération hybride.
La documentation d'OpenAI sur les embeddings décrit les embeddings comme des représentations vectorielles numériques utilisées pour la parenté et la recherche. Il s'agit d'une voie d'implémentation pour la récupération sémantique, et non de la définition du RAG lui-même.
Exemple réel 1 : un dossier de fichiers texte
Supposons qu'un répertoire nommé knowledge/ contienne des fichiers texte ordinaires. Python peut les charger sans aucune bibliothèque d'IA.
from pathlib import Path

def load_text_files(folder="knowledge"):
    documents = []

    for path in Path(folder).glob("*.txt"):
        documents.append({
            "source": path.name,
            "text": path.read_text(encoding="utf-8")
        })

    return documents

documents = load_text_files()

for document in documents:
    print(document["source"], len(document["text"]))
Le système de fichiers est la source de données. La question suivante est de savoir quelle quantité de texte doit devenir une unité récupérable. Pour les documents longs, rechercher un fichier complet est souvent trop grossier. C'est pourquoi les pipelines RAG créent couramment des fragments.
Un découpeur très simple
def chunk_text(text, max_chars=800):
    paragraphs = [p.strip() for p in text.split("\n\n") if p.strip()]

    chunks = []
    current = ""

    for paragraph in paragraphs:
        candidate = f"{current}\n\n{paragraph}".strip()

        if current and len(candidate) > max_chars:
            chunks.append(current)
            current = paragraph
        else:
            current = candidate

    if current:
        chunks.append(current)

    return chunks
Cet exemple regroupe les paragraphes jusqu'à atteindre une limite approximative de caractères. Il est intentionnellement compréhensible plutôt qu'optimal. Les systèmes de production découpent souvent par tokens, titres, sections, limites de phrases ou structure du document. Les tableaux, le code source, les contrats et la documentation d'API peuvent nécessiter des stratégies différentes.
Préserver la provenance lors du découpage
def build_chunks(documents):
    chunks = []

    for document in documents:
        for index, text in enumerate(chunk_text(document["text"])):
            chunks.append({
                "id": f'{document["source"]}:{index}',
                "source": document["source"],
                "chunk": index,
                "text": text,
            })

    return chunks
Un segment utile transporte plus que du texte. Le nom de la source, l'identifiant du document, l'URL, l'horodatage, la version ou la section peuvent ensuite servir à la citation, au débogage et aux vérifications de fraîcheur. Si la provenance est perdue lors de l'ingestion, il devient beaucoup plus difficile d'expliquer pourquoi une réponse particulière a été produite.
Exemple réel 2 : Données structurées — utilisez SQL quand SQL est l'outil approprié
Tous les faits externes ne doivent pas passer par la recherche sémantique. Si la question demande un enregistrement actuel exact, une requête directe à la base de données est généralement plus claire et plus déterministe.
import sqlite3

def get_order_status(order_id):
    connection = sqlite3.connect("shop.db")
    cursor = connection.cursor()

    cursor.execute(
        "SELECT status, total, currency FROM orders WHERE id = ?",
        (order_id,)
    )

    row = cursor.fetchone()
    connection.close()

    if row is None:
        return None

    return {
        "order_id": order_id,
        "status": row[0],
        "total": row[1],
        "currency": row[2],
    }

print(get_order_status(4711))
Si l'application sait déjà que l'utilisateur pose une question sur la commande 4711, intégrer toute la table des commandes et demander à la recherche sémantique de redécouvrir cette ligne ajoute généralement de la complexité sans bénéfice. Une règle de conception solide est : récupérez les faits structurés avec des requêtes structurées ; récupérez les connaissances non structurées avec la recherche.
La ligne de base de données renvoyée peut toujours être placée dans le contexte du modèle afin que le LLM puisse l'expliquer en langage naturel. Mais l'accès direct à un état ou à un enregistrement est conceptuellement différent de la recherche dans un corpus de connaissances.
Exemple réel 3 : Recherche en texte intégral avant les embeddings
Entre une boucle Python naïve et la recherche vectorielle se trouve une classe mature de systèmes de recherche lexicale. SQLite inclut FTS5 pour la recherche en texte intégral, y compris le classement BM25.
import sqlite3

connection = sqlite3.connect("knowledge.db")
cursor = connection.cursor()

cursor.execute(
    "CREATE VIRTUAL TABLE IF NOT EXISTS docs USING fts5(title, body)"
)

cursor.execute(
    "INSERT INTO docs(title, body) VALUES (?, ?)",
    ("AKM", "The AKM uses 7.62 mm ammunition.")
)

connection.commit()

query = "AKM ammunition"

rows = cursor.execute(
    "SELECT title, body, bm25(docs) AS score "
    "FROM docs WHERE docs MATCH ? "
    "ORDER BY score LIMIT 5",
    (query,)
).fetchall()

for row in rows:
    print(row)

connection.close()
La recherche lexicale est particulièrement utile lorsque la terminologie exacte, les codes produit, les noms, les identifiants ou les mots spécifiques au domaine importent. La recherche sémantique n'est pas automatiquement meilleure. Les systèmes de production combinent souvent les deux signaux.
Exemple réel 4 : Récupération sémantique avec des embeddings
Les embeddings transforment le texte en vecteurs numériques afin que des passages sémantiquement liés puissent être comparés même lorsqu'ils n'utilisent pas une formulation identique. Sentence Transformers fournit une implémentation locale simple.
# pip install sentence-transformers

from sentence_transformers import SentenceTransformer, util

documents = [
    "The AKM uses 7.62 mm ammunition.",
    "A Med Kit restores health.",
    "Vehicle maintenance includes checking oil, brakes and tires.",
    "Account recovery requires access to the registered email address."
]

model = SentenceTransformer(
    "sentence-transformers/multi-qa-mpnet-base-cos-v1"
)

document_embeddings = model.encode_document(
    documents,
    convert_to_tensor=True
)

question = "How do I repair my car?"

query_embedding = model.encode_query(
    question,
    convert_to_tensor=True
)

hits = util.semantic_search(
    query_embedding,
    document_embeddings,
    top_k=2
)[0]

for hit in hits:
    print(round(float(hit["score"]), 3), documents[hit["corpus_id"]])
La requête ne contient pas l'expression « entretien du véhicule », mais un modèle sémantique peut tout de même classer ce passage haut, car les concepts sont liés. C'est la raison pratique pour laquelle les embeddings sont courants dans les systèmes RAG.
Pour les petites collections, les embeddings peuvent rester en mémoire. Les systèmes plus grands les persistent généralement dans un index ou une base de données compatible avec les vecteurs et y effectuent une recherche des plus proches voisins. Le stockage change, mais la logique reste : encoder la question, trouver les représentations de documents pertinentes, renvoyer les meilleures preuves.
Exemple réel 5 : Construire le contexte pour le LLM
Un récupérateur doit renvoyer des preuves. Le LLM doit ensuite recevoir la question plus ces preuves. Garder la récupération et la génération séparées rend les deux plus faciles à inspecter et à tester.
def build_prompt(question, retrieved_documents):
    context = "\n\n".join(
        f'[{doc["id"]}] {doc["text"]}'
        for doc in retrieved_documents
    )

    return f"""
Answer the question using the supplied context.

Rules:
- Do not invent facts that are not supported by the context.
- If the context is insufficient, say so.
- Cite the source IDs you used.

Question:
{question}

Context:
{context}
""".strip()
L'instruction ne rend pas le modèle infaillible. Elle crée simplement une frontière explicite de preuves. Le modèle peut encore mal comprendre de bonnes preuves, ignorer une condition ou généraliser à l'excès. C'est pourquoi la qualité de la récupération et la qualité de la génération doivent être évaluées séparément.
Exemple réel 6 : un pipeline minimal complet
def answer_question(question, all_documents, call_llm):
    # 1. Retrieve evidence
    retrieved = retrieve(question, all_documents, top_k=3)

    # 2. Build model context
    prompt = build_prompt(question, retrieved)

    # 3. Generate the answer
    answer = call_llm(prompt)

    return {
        "answer": answer,
        "sources": [doc["id"] for doc in retrieved]
    }
La fonction reçoit call_llm comme dépendance à dessein. La récupération ne devrait pas se soucier de savoir si la génération est effectuée par un modèle cloud, un modèle local ou un autre fournisseur. Le chemin de données appartient à l'application.
Générateur optionnel : API OpenAI Responses
Un générateur possible est l'API OpenAI Responses. Conserver le nom du modèle dans une variable d'environnement évite de coder en dur un modèle particulier dans l'architecture RAG.
# pip install openai

import os
from openai import OpenAI

client = OpenAI()

def call_llm(prompt):
    response = client.responses.create(
        model=os.environ["OPENAI_MODEL"],
        input=prompt,
    )
    return response.output_text
Le même pipeline de récupération peut être connecté à un serveur d'inférence local. C'est un point architectural important : le RAG n'appartient pas au fournisseur de LLM. L'application possède la source, la récupération et l'assemblage du contexte.
Toute l'architecture en une vue
USER QUESTION
     |
     v
+-------------+
|  Retriever  |
+-------------+
   |       |
   |       +----> SQL / API / state query
   |
   +------------> keyword / full-text search
   |
   +------------> embedding / vector search
                     |
                     v
              relevant evidence
                     |
                     v
+-----------------------------------+
| question + evidence + instructions |
+-----------------------------------+
                     |
                     v
                   LLM
                     |
                     v
                  answer
Ce modèle de flux de données est plus durable que la mémorisation d'un framework. Les bibliothèques, les bases de données et les fournisseurs de modèles changeront ; les frontières de responsabilité demeurent.
Idées fausses courantes et modes de défaillance
« RAG signifie base de données vectorielle. »
Non. La recherche vectorielle est une méthode de récupération. Le RAG peut utiliser la recherche en texte intégral, SQL, des API, des graphes de connaissances, la recherche vectorielle ou des combinaisons de ceux-ci. Le modèle déterminant est la récupération d'informations externes pour la génération.
« Si les données sont dans PostgreSQL, je dois intégrer toute la base de données. »
Non. Les enregistrements structurés devraient généralement rester interrogeables en tant qu'enregistrements structurés. Les embeddings sont utiles pour la pertinence sémantique, pas comme remplacement des requêtes déterministes.
« Plus de segments signifie une meilleure réponse. »
Pas nécessairement. Un contexte supplémentaire peut introduire du bruit, des versions contradictoires et des éléments non pertinents. La récupération doit optimiser pour des preuves utiles, et non pour un volume maximal.
« Un score de similarité élevé prouve la réponse. »
Non. La similarité mesure la pertinence, pas la vérité ni l'applicabilité. Un passage très similaire peut être obsolète, provenir d'une mauvaise version du produit ou n'être valable que dans des conditions qui ne correspondent pas à la question.
« Une fois le bon segment récupéré, l'hallucination est résolue. »
Non. La récupération améliore l'ancrage mais ne garantit pas un raisonnement fidèle. La génération nécessite toujours une évaluation, et les flux de travail à haut risque peuvent exiger une validation déterministe ou une révision humaine.
« Le modèle a échoué, donc changeons de modèle. »
Pas nécessairement. La source correcte peut avoir été manquante, mal analysée, mal découpée, filtrée, classée trop bas ou omise du contexte assemblé. Le remplacement du modèle ne devrait pas être la première étape de diagnostic.
Cas limites
- Documents contradictoires : deux sources peuvent diverger parce que les versions, les juridictions ou les produits diffèrent.
- Faits sensibles au temps : une source sémantiquement pertinente peut déjà être obsolète.
- Autorisations : un système de récupération ne doit pas renvoyer des documents auxquels l'utilisateur actuel n'est pas autorisé à accéder.
- Collections multilingues : le modèle d'embedding et la stratégie de récupération doivent prendre en charge les langues réellement utilisées.
- Tableaux et code source : un découpage en paragraphes simples peut détruire une structure essentielle à la réponse.
- Identifiants très courts : la récupération sémantique peut être plus faible que la correspondance exacte pour les SKU, les identifiants, les codes d'erreur ou les acronymes.
- Questions longues nécessitant plusieurs faits : la récupération peut nécessiter une décomposition, plusieurs recherches ou un reranking plutôt qu'une seule requête top-k.
- Hiérarchie des sources : une politique officielle actuelle peut devoir primer sur un document de discussion plus ancien mais sémantiquement plus proche.
Limites
Les exemples Python optimisent intentionnellement la transparence, et non l'échelle. Le récupérateur par mots-clés est naïf, le découpeur utilise la longueur en caractères, les exemples SQLite n'incluent pas de gestion des connexions en production, et l'exemple sémantique conserve tous les embeddings en mémoire.
Un système de production peut nécessiter des index vectoriels, des rerankers, une récupération hybride, des analyseurs de documents, de la mise en cache, de l'indexation incrémentielle, du versionnage des sources, des filtres de contrôle d'accès, de l'observabilité, des jeux de données d'évaluation et une gestion des défaillances. Aucun de ces ajouts ne change l'architecture de base ; ils rendent chaque frontière plus fiable.
Le RAG ne peut pas non plus créer des preuves absentes de l'ensemble des sources. Si la source est erronée, incomplète ou obsolète, un meilleur modèle d'embedding ne peut pas la transformer en connaissance faisant autorité.
Qu'est-ce qui changerait cette réponse ?
L'architecture change lorsque la tâche nécessite plus qu'une simple recherche de connaissances. Un statut de commande en direct nécessite l'état actuel. Un calcul financier peut nécessiter du code déterministe. Une tâche de recherche web peut nécessiter une recherche active. Un flux de travail peut nécessiter des outils capables d'écrire des données dans un autre système. Un agent autonome peut nécessiter la planification, les autorisations et le contrôle de l'exécution en plus de la récupération.
Le RAG est donc mieux compris comme une couche d'acquisition de preuves au sein d'un système d'IA plus vaste. Il est puissant précisément parce qu'il a un rôle étroit : trouver des informations externes utiles et les placer dans le contexte de travail du modèle.
Conclusion
Le RAG devient beaucoup plus facile à comprendre lorsque les noms des technologies sont retirés. Un fichier est une source. Une base de données est une source. Une API est une source. Une fonction de recherche récupère des preuves. Un prompt transporte ces preuves jusqu'au modèle. Le LLM les interprète ensuite et produit du langage.
La partie difficile du RAG en production n'est pas d'appeler un modèle d'embedding. C'est de construire un chemin de preuve fiable depuis la source originale jusqu'à l'affirmation finale : préserver la provenance, sélectionner la bonne méthode de récupération, maintenir l'information à jour, contrôler l'accès, évaluer la récupération séparément de la génération, et savoir quand un appel direct à une base de données ou à un outil est préférable à une recherche sémantique.
C'est la continuation pratique du modèle RAG de base : comprendre d'abord les rôles, puis rendre le chemin des données explicite.
Sources primaires
- Lewis et al. — Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks — l'article de 2020 introduisant la formulation du RAG qui combine la génération avec une mémoire non paramétrique récupérée.
- Sentence Transformers — Semantic Search — documentation officielle pour la récupération sémantique, les embeddings de requêtes et les embeddings de documents.
- OpenAI — Vector Embeddings — documentation officielle décrivant les embeddings comme des représentations numériques utilisées pour la similarité et la recherche.
- SQLite — FTS5 Extension — documentation officielle pour la recherche en texte intégral et le classement BM25 dans SQLite.
- OpenAI — SDKs and CLI — exemple officiel du SDK Python pour l'API Responses utilisé dans l'exemple optionnel de générateur.
- What Is RAG? The Simplest Explanation of How It Works — la première partie conceptuelle de cette série.
Related Articles
Google I/O 2026 : Android XR, lunettes intelligentes et l'interface d'IA ambiante
Google I/O 2026 a fait passer Android XR et les lunettes intelligentes du concept vers une véritable orientation de plateforme. Cet article décrypte les lunettes audio, les lunettes à affichage, la conscience contextuelle alimentée par Gemini, les implications pour les développeurs, les risques pour la vie privée, et pourquoi l'IA portable consiste moins à remplacer les téléphones qu'à créer des surfaces d'assistance ambiante.
ComfyUI sur Fedora 43 : Deux environnements virtuels + Démarrage en un clic (mars 2026)
Objectif : Conserver deux venvs Python (ex. 3.12 + 3.14) pour la compatibilité, mais lancer ComfyUI automatiquement avec une configuration propre et légère.
Google I/O 2026 : Antigravity, AI Studio et la transition vers les DevTools agentiels
Google I/O 2026 a rendu une chose claire pour les ingénieurs : les outils d'IA vont désormais au-delà de l'autocomplétion pour passer à une exécution agentique gérée. Cet article décrypte Antigravity 2.0, le rôle croissant de Google AI Studio, Gemini 3.5 Flash et les véritables compromis autour de l'orchestration, du verrouillage, de la vérification et de la conception des workflows de développement.
Booster la productivité grâce aux systèmes ERP : Une étude de cas sur les bases de données relationnelles
L'intégration des systèmes ERP et des bases de données relationnelles augmente la productivité. Une étude

Le GPU n'est pas le produit : architecture d'IA privée pérenne
Une infrastructure d'IA privée ne devrait pas être conçue autour d'un seul GPU ou d'un seul modèle. Une approche plus résiliente combine des GPU d'inférence rapides, des systèmes d'IA riches en mémoire, des nœuds d'IA physique et des modèles cloud de pointe optionnels derrière une couche de routage prenant en compte les capacités.
Enterprise-Grade Multi-Tenant Architecture for an International Platform
Loving Rocks is an enterprise-grade wedding platform designed with a true multi-tenant architecture, isolated databases per tenant, and built-in internationalization for global scalability, security, and long-term operational stability.
Le prompt fait partie du biais : comment le cadrage de l'IA façonne le raisonnement
La formulation d'un prompt n'est pas neutre. Explorez comment le cadrage, les présupposés, le suivi des instructions et la sycophancie peuvent façonner le raisonnement de l'IA—et pourquoi des conclusions fiables nécessitent des tests au-delà du prompt initial.

Migration du SDK OpenAI Agents vers l'API Agents : qu'est-ce qui change réellement sur le plan architectural ?
La migration du SDK OpenAI Agents vers la nouvelle API Agents n'est pas un simple renommage d'import. La frontière d'exécution change : la boucle d'agent, la session durable, l'orchestration, la compaction du contexte et la récupération se déplacent vers un harnais managé. Ce guide montre ce qui doit être déplacé, ce qui doit rester dans votre application, et comment prouver la migration avant le basculement.
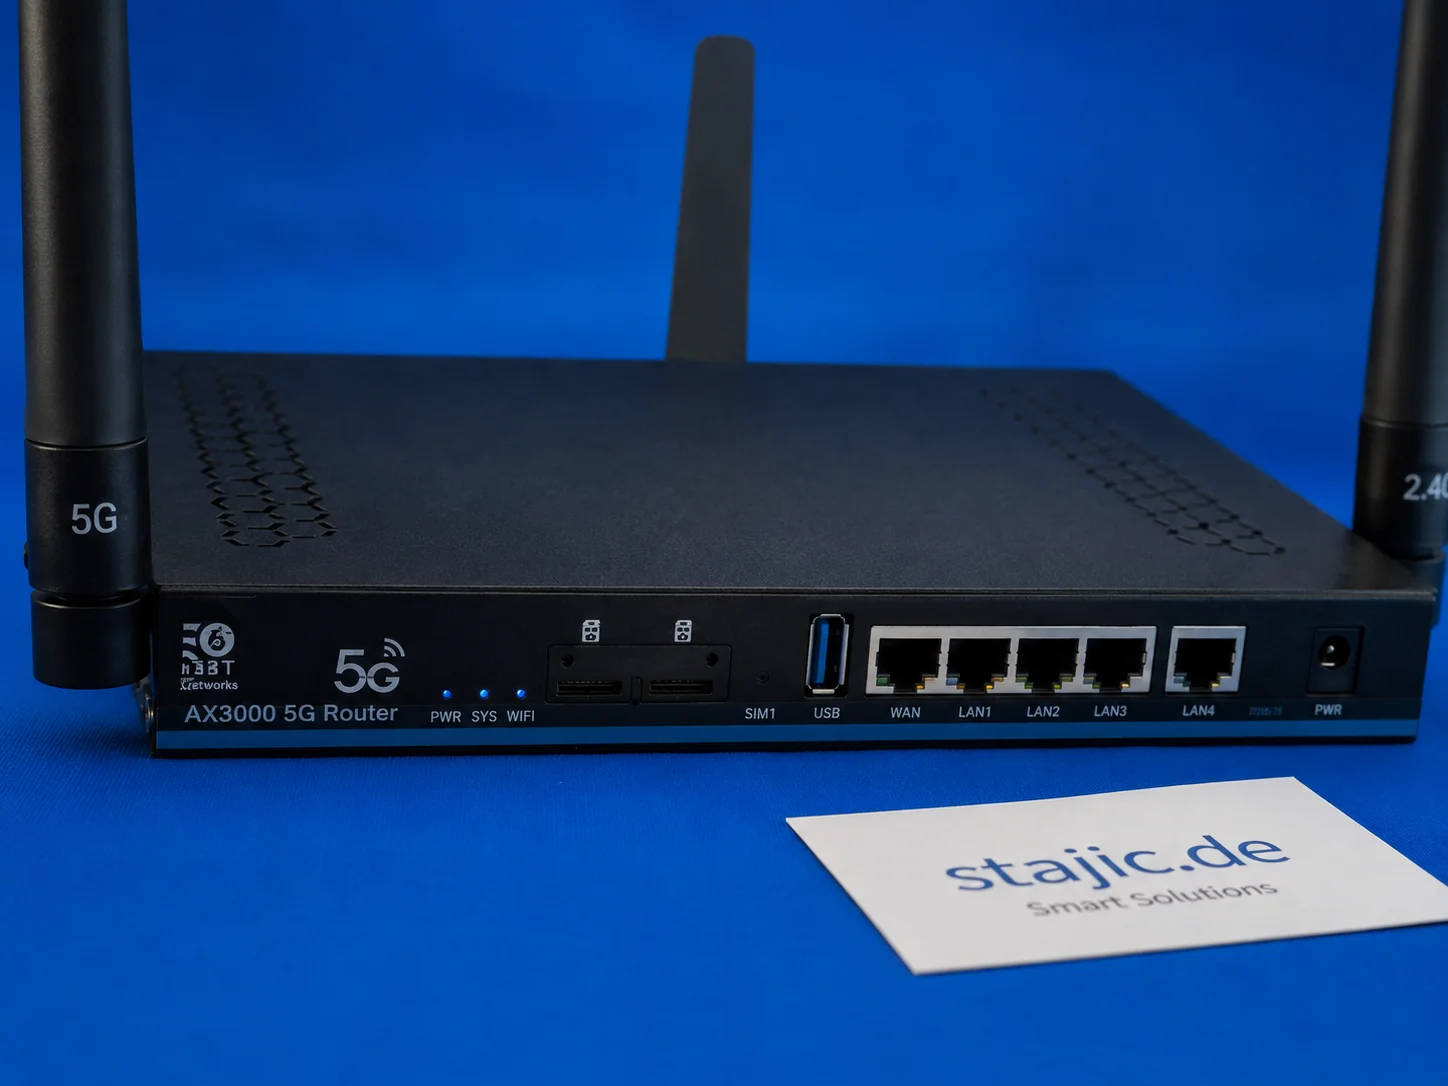
Quectel RM500U-EA dans le ZBT Z8102AX : bandes 5G, o2 Allemagne et comportement du signal en conditions réelles
Le ZBT Z8102AX utilise un modem Quectel RM500U-EA pour la connectivité 4G et 5G. Lors du premier test pratique, le routeur s'est connecté avec succès à o2 Germany avec la bande LTE 3 et la NR n28. Le modem fonctionne, mais des diagnostics plus approfondis tels que le RSRP, le RSRQ, le SINR, le verrouillage de bande et le comportement des cellules nécessitent encore des tests appropriés.
Welcome to NuxtWP Multilang Theme
Introduction to the NuxtWP Multilang Theme - a modern multilingual CMS built with Nuxt 4.
Paquets Snap : Pourquoi ils ne sont pas à la hauteur pour les outils avancés comme DBeaver
Les paquets Snap introduisent un bac à sable restrictif qui perturbe les flux de travail avancés. Cet article explique pourquoi DBeaver rencontre des difficultés avec le tunneling SSH sous Snap et pourquoi les paquets Flatpak ou natifs sont de meilleures alternatives.
Test du routeur 5G OpenWrt ZBT Z8102AX : Double SIM, RM500U-EA et une évaluation honnête
Le ZBT Z8102AX est un routeur 5G atypique avec une base OpenWrt, un concept double SIM et un modem Quectel RM500U-EA. Lors des tests, il montre des points forts évidents en matière de flexibilité, d'interfaces et de connectivité mobile, mais aussi les faiblesses typiques d'une version d'OpenWrt modifiée par le fabricant.