
Le GPU n'est pas le produit : architecture d'IA privée pérenne

La discussion autour de l'infrastructure IA locale commence souvent par la mauvaise question :
Quel GPU devrais-je acheter ?
Une meilleure question est la suivante :
Quels types de charges de travail d'IA dois-je exécuter, et où chacune d'elles devrait-elle tourner ?
Cette distinction devient de plus en plus importante à mesure que l'infrastructure IA se divise en plusieurs catégories de matériel très différentes. Un GPU grand public haut de gamme peut offrir une vitesse d'inférence exceptionnelle mais une mémoire relativement limitée. Un système IA compact peut offrir beaucoup plus de mémoire avec une consommation d'énergie réduite, tout en proposant une bande passante mémoire bien plus faible. Les plateformes Edge ajoutent quant à elles le traitement des capteurs, la vidéo en temps réel et des interfaces physiques que les stations de travail GPU conventionnelles n'ont jamais été conçues pour gérer.
Le résultat est qu'il n'existe peut-être plus un seul ordinateur IA idéal. Il pourrait plutôt y avoir une trame d'exécution IA idéale.
Différents matériels résolvent différents problèmes
Examinons plusieurs catégories actuelles de plateformes NVIDIA. Elles ne sont pas simplement des versions plus ou moins rapides d'une même machine. Elles représentent des profils de capacités différents.
La GeForce RTX 5090 est conçue autour d'un débit de calcul et d'une bande passante mémoire extrêmement élevés. Avec 32 Go de mémoire GDDR7 et une bande passante très élevée, elle est particulièrement bien adaptée à l'inférence sensible à la latence lorsque le modèle tient aisément dans la mémoire du GPU.
Spécifications de la NVIDIA RTX 5090
Le DGX Spark fait presque le compromis inverse. Il associe 128 Go de mémoire unifiée cohérente à une bande passante mémoire de 273 Go/s et une enveloppe énergétique relativement faible. Son principal avantage n'est pas le débit maximal de tokens, mais la capacité de conserver des modèles et des contextes nettement plus volumineux résidents en mémoire.
Le Jetson AGX Thor propose également une vaste architecture de mémoire unifiée, mais son objectif est différent. Il est conçu pour l'IA physique : flux de caméras, audio, fusion de capteurs, robotique et autres charges de travail où l'IA doit interagir avec l'environnement physique en temps réel.
À l'extrémité professionnelle du spectre, la RTX PRO 6000 Blackwell associe 96 Go de mémoire GDDR7 ECC à une bande passante mémoire extrêmement élevée. Cette catégorie d'accélérateur est particulièrement intéressante pour l'inférence commerciale mutualisée car elle associe une capacité mémoire bien plus importante à un débit de classe station de travail.
Latence, capacité et IA physique
Un modèle d'infrastructure utile divise les charges de travail en trois grandes catégories.
Inférence orientée latence
Les conversations courtes, l'assistance au code, la classification, l'extraction, les petites requêtes RAG et les charges de travail interactives tirent profit d'une bande passante mémoire élevée et d'un débit de calcul important. Un système RTX haut de gamme est particulièrement adapté à ce rôle.
Inférence orientée capacité
Les grands modèles, les contextes longs, le raisonnement sur des documents volumineux, l'analyse par lots et les combinaisons de modèles nécessitent souvent bien plus de mémoire que ce qu'un GPU grand public classique peut fournir. Des systèmes tels que le DGX Spark échangent de la bande passante brute contre un pool de mémoire unifiée bien plus étendu.
IA physique
Les flux de caméras, les pipelines audio, la reconnaissance gestuelle, la robotique et la fusion de capteurs nécessitent des capacités allant au-delà du service de LLM ordinaire. Jetson Thor appartient à cette catégorie car le calcul y est intégré à des interfaces conçues pour les systèmes opérant dans le monde physique.
L'étape architecturale importante ne consiste donc pas à choisir entre ces plateformes. Elle consiste à leur permettre de coopérer.
Le routeur d'IA devient la véritable plateforme
Imaginez que chaque application envoie ses requêtes à un point de terminaison logique unique. Le client n'a pas besoin de savoir si l'exécution s'effectue sur une station de travail RTX, un nœud Spark, un système edge ou un modèle frontière externe.
Une couche de routage peut évaluer la longueur du contexte, la modalité, les exigences de latence, la politique de confidentialité, la capacité du modèle, la priorité du locataire et l'utilisation actuelle du matériel avant de décider où une requête doit s'exécuter.
- Une courte requête de FAQ interne peut être dirigée vers un modèle local rapide sur un GPU RTX.
- Une requête impliquant des centaines de documents peut être acheminée vers un nœud Spark riche en mémoire.
- Une charge de travail liée à une caméra ou à des capteurs peut être attribuée à Thor.
- Une requête de raisonnement particulièrement difficile peut éventuellement être transmise à un modèle frontière dans le cloud si la politique du locataire le permet.
L'infrastructure cesse alors d'être centrée sur le modèle pour devenir centrée sur les capacités.
Cette distinction a son importance car les modèles évoluent bien plus vite que l'architecture des applications d'entreprise. Un modèle utilisé aujourd'hui peut être remplacé l'année prochaine sans changer le contrat d'API utilisé par le client. Il en va de même pour le matériel.
Une future génération de GPU peut simplement être introduite en tant que nœud d'exécution supplémentaire pendant que la plateforme environnante reste inchangée.
Le service multimodèle n'est pas équivalent à l'inférence distribuée
On suppose couramment qu'un cluster d'IA doit constamment déplacer d'énormes quantités de données entre chaque nœud. Cela n'est vrai que pour certaines architectures.
Si un très grand modèle est réparti sur plusieurs machines, la bande passante inter-nœuds devient critique car les données tensorielles doivent circuler continuellement entre les appareils.
DGX Spark intègre par conséquent des composants réseau ConnectX-7 conçus pour des communications de cluster à haut débit, offrant jusqu'à 200 Gb/s de connectivité par interface prise en charge.
Documentation sur le clustering NVIDIA DGX Spark
Mais un service d'IA privée n'a pas nécessairement besoin de distribuer chaque modèle. Il peut plutôt conserver différents modèles résidents sur différents nœuds.
- Un nœud peut héberger le modèle conversationnel rapide.
- Un autre peut héberger un grand modèle de raisonnement.
- Un troisième peut exécuter les embeddings et le reranking.
- Thor peut traiter les charges de travail de vision, d'audio et de capteurs en temps réel.
Dans cette architecture, ce sont les requêtes et les réponses qui transitent sur le réseau plutôt que les tenseurs internes des modèles. Il s'agit d'un service multi-modèles, et non d'une inférence de modèle distribué.
Pour de nombreux déploiements commerciaux, c'est plus simple, plus économique et plus facile à faire évoluer.

Un seul cluster peut servir plusieurs entreprises
La capacité de l'infrastructure ne peut pas être mesurée simplement par le nombre d'entreprises clientes.
Vingt entreprises ne génèrent pas nécessairement vingt charges de travail d'inférence simultanées. Une entreprise de trente employés peut ne créer que quelques requêtes simultanées pendant les heures normales de bureau, tandis qu'un seul client fortement automatisé peut maintenir des dizaines d'agents en continu.
Les métriques de capacité pertinentes sont donc la simultanéité, les jetons par seconde, la taille du contexte, les requêtes par minute et la priorité du service.
Cela crée une opportunité de multiplexage statistique : les clients consomment rarement leur capacité maximale souscrite de manière simultanée.
Un cluster hétérogène peut donc desservir de nombreuses petites organisations tout en réservant de la capacité pour les clients ayant des exigences plus strictes en matière de latence ou de disponibilité.
Le produit commercial n'est pas le temps GPU
Concurrencer directement les fournisseurs de location de GPU à grande échelle est difficile. Leur modèle économique est optimisé autour de l'utilisation des infrastructures et de l'effet d'échelle.
Un produit plus facilement défendable est une plateforme d'IA privée gérée.
- Inférence privée
- Génération augmentée par récupération
- Isolation des locataires
- Contrôle d'accès basé sur les rôles
- Journalisation des audits
- Routage de modèles
- Ingestion de documents
- Connecteurs et API
- Évaluation et surveillance
- Capacité dédiée ou réservée
Le client ne paie pas principalement pour accéder à un GPU. Le client paie pour une couche applicative d'IA maîtrisée.
Les modèles locaux n'ont pas besoin de surpasser les modèles de pointe
Une autre erreur architecturale consiste à traiter les modèles à poids ouverts comme des remplaçants directs des systèmes frontières les plus performants.
Ils n'ont pas besoin de l'être.
Une entreprise demandant : « Quel délai de résiliation est défini dans ce contrat ? » n'a pas nécessairement besoin du modèle de raisonnement généraliste le plus puissant disponible.
Elle a besoin d'une ingestion fiable, d'une récupération précise, d'un contrôle d'accès respectant les permissions, de la traçabilité des sources et d'un modèle suffisamment performant.
Pour une grande partie des charges de travail d'entreprise, la qualité de la couche applicative environnante peut compter autant que le LLM sous-jacent.
La plateforme peut donc utiliser des modèles locaux pour les charges de travail sensibles à la confidentialité et à volume élevé, tout en réservant les modèles frontières au pourcentage relativement faible de requêtes qui le nécessitent réellement.
Cela crée une forme d'inférence en cascade : des modèles privés peu coûteux traitent la majorité des requêtes, tandis que des capacités plus onéreuses ne sont sollicitées qu'en cas de nécessité.
Pérenniser ne signifie pas empêcher l'obsolescence
Aucun accélérateur d'IA n'est pérenne au sens littéral. Le nouveau matériel sera toujours plus rapide.
L'objectif d'ingénierie utile consiste plutôt à réduire le risque d'obsolescence technologique.
Un GPU qui constitue aujourd'hui le dispositif d'inférence principal peut devenir plus tard un serveur d'embeddings, un worker de traitement par lots, un nœud de génération d'images ou un pool d'inférence secondaire.
Un système doté d'une mémoire généreuse ayant hébergé le plus grand modèle disponible peut devenir ultérieurement un nœud dédié au RAG, au contexte long ou à l'analyse par lots.
Le nouveau matériel doit étendre la plateforme plutôt que de la rendre obsolète.
Cela nécessite de séparer la couche d'exécution de la couche applicative.
Les actifs durables ne sont pas les GPU eux-mêmes. Ce sont les contrats d'API, la logique de routage, le modèle multi-tenant, les règles de sécurité, les pipelines documentaires, l'architecture RAG, le système d'évaluation, l'observabilité et les intégrations client.
Le matériel devient une infrastructure remplaçable.
Le véritable produit
L'architecture d'IA privée la plus durable ressemble donc moins à une station de travail qu'à un cloud miniature.
- Différents pools de matériel offrent des capacités différentes.
- Une couche d'ordonnancement détermine la destination de chaque charge de travail.
- Les modèles locaux traitent les requêtes privées et à volume élevé.
- Le matériel d'IA physique prend en charge les capteurs et les environnements en temps réel.
- Les services de pointe restent disponibles en tant que voies d'escalade contrôlées.
- De nouveaux accélérateurs peuvent être introduits sans contraindre les clients à modifier leurs applications.
De ce point de vue, la question centrale n'est plus :
Quel GPU doit alimenter le système ?
Elle devient :
La plateforme peut-elle continuer à fournir le même service lorsque le GPU, le modèle ou le fournisseur change ?
Si la réponse est oui, l'infrastructure a accompli quelque chose de bien plus précieux que de simplement posséder du matériel rapide.
Elle a transformé le calcul en une couche d'exécution remplaçable.
Et c'est là qu'un système d'IA privé commence à devenir une plateforme.
Related Articles
tensorflow
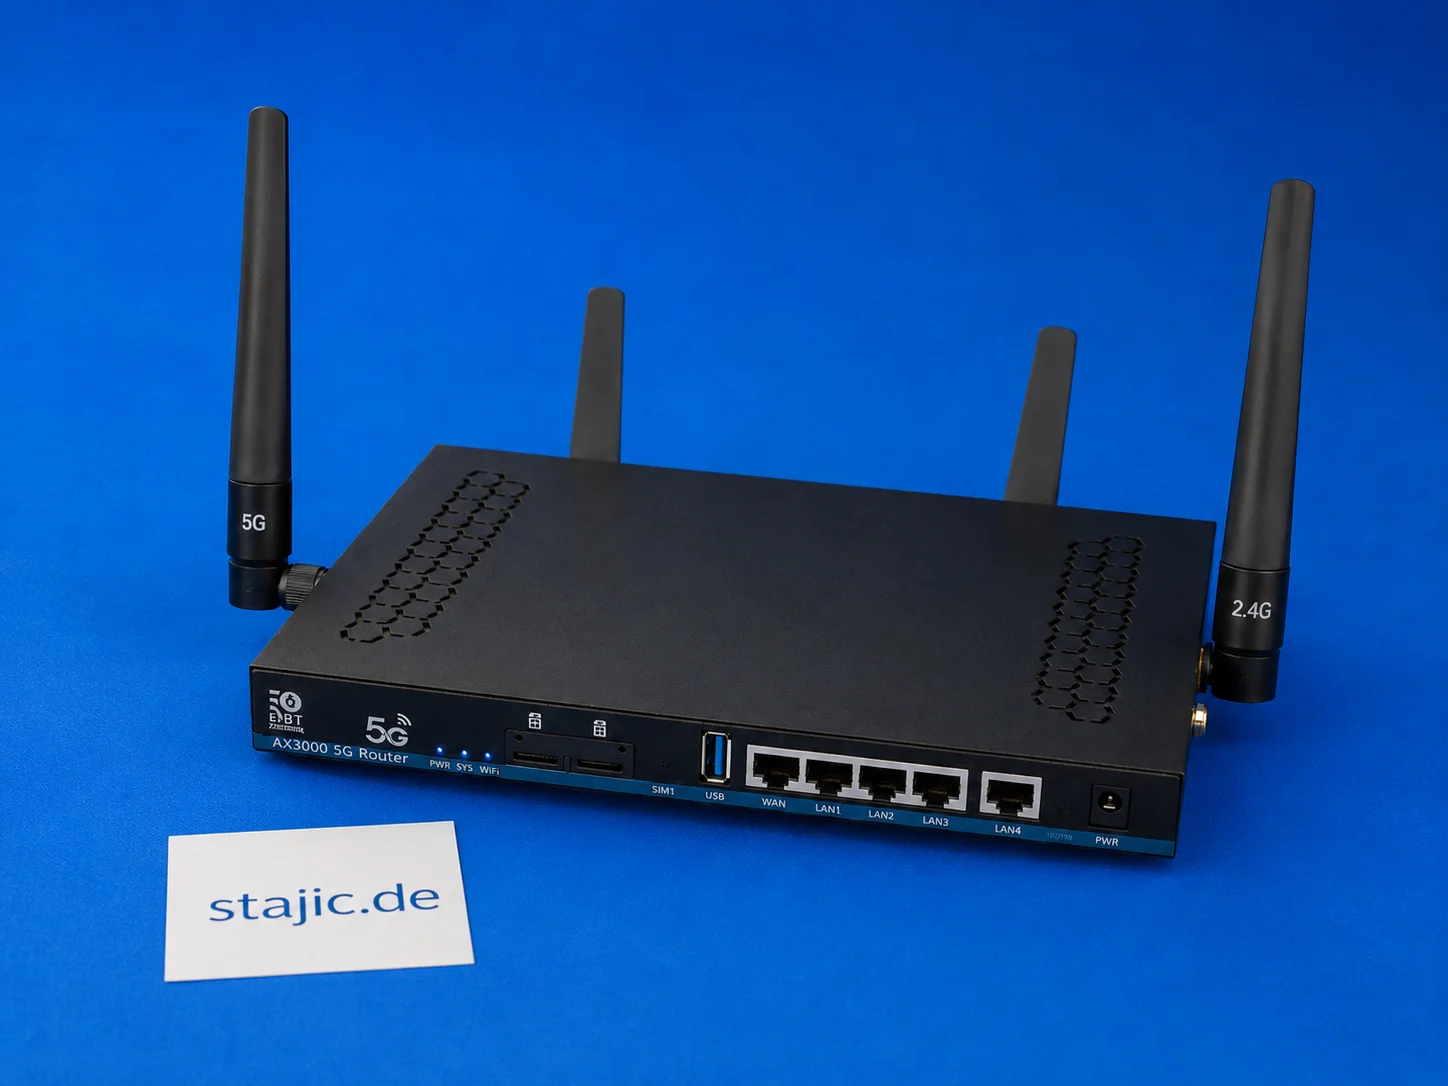
Basculement double SIM du ZBT Z8102AX : ce qui fonctionne, ce qui manque et ce qui nécessite un meilleur firmware
Le ZBT Z8102AX est un routeur OpenWrt 5G double SIM, mais le matériel double SIM à lui seul n'est pas la même chose qu'un basculement intelligent. Le routeur reconnaît la carte SIM et se connecte avec succès, mais la commutation automatique, la récupération du modem, les décisions basées sur le signal et une logique de basculement propre nécessitent encore des tests plus approfondis.
force-install-package-in-virtualenv
Comment installer PHP 8.3 sur Ubuntu 22.04
Guide à jour sur l'installation de PHP 8.3 sur Ubuntu 22.04, incluant l'intégration d'Apache et Nginx (PHP-FPM), les extensions, et l'exécution de plusieurs versions de PHP côte à côte.
PostfixAdmin : Gestion de niveau entreprise pour les systèmes de messagerie Postfix — Anno 2026
PostfixAdmin est une interface d'administration centrée sur une base de données conçue pour les systèmes de messagerie Postfix professionnels. Plutôt que de masquer la complexité, il offre un contrôle précis sur les domaines, les boîtes aux lettres, les alias et les permissions d'expéditeur. Cet article explique pourquoi PostfixAdmin reste une solution d'entreprise fiable en 2026 et comment il s'intègre dans les infrastructures de messagerie modernes et axées sur la sécurité.
Quectel RM500U-EA dans le ZBT Z8102AX : bandes 5G, o2 Allemagne et comportement du signal en conditions réelles
Le ZBT Z8102AX utilise un modem Quectel RM500U-EA pour la connectivité 4G et 5G. Lors du premier test pratique, le routeur s'est connecté avec succès à o2 Germany avec la bande LTE 3 et la NR n28. Le modem fonctionne, mais des diagnostics plus approfondis tels que le RSRP, le RSRQ, le SINR, le verrouillage de bande et le comportement des cellules nécessitent encore des tests appropriés.
How to Scan and Clean Your Cloud Linux Server from Malware
Développement front-end et back-end
Le développement front-end et back-end est une partie essentielle du développement web et implique la création d'applications web et de sites web. Le développement front-end se concentre sur l'interface utilisateur, tandis que le développement back-end est responsable de la programmation et de la gestion côté serveur.
Paquets Snap : Pourquoi ils ne sont pas à la hauteur pour les outils avancés comme DBeaver
Les paquets Snap introduisent un bac à sable restrictif qui perturbe les flux de travail avancés. Cet article explique pourquoi DBeaver rencontre des difficultés avec le tunneling SSH sous Snap et pourquoi les paquets Flatpak ou natifs sont de meilleures alternatives.
Welcome to NuxtWP Multilang Theme
Introduction to the NuxtWP Multilang Theme - a modern multilingual CMS built with Nuxt 4.
Qwen 3.6 en production : Runbook de déploiement, Rollback IA et Versionnage LLMOps
Qwen 3.6 n'est pas seulement une autre mise à jour de modèle. C'est à la fois un événement de déploiement, un scénario de rollback et un problème de versionnage. Cet article explique comment Qwen 3.6 doit être géré en production à travers la discipline LLMOps, la traçabilité des prompts et des modèles, le déploiement contrôlé et une préparation au rollback basée sur des preuves.
Falsification pour le raisonnement de l'IA : des réponses aux hypothèses testées
Les modèles d’IA peuvent générer des preuves convaincantes pour presque toute hypothèse plausible. Une méthodologie plus fiable pose la question inverse : quelles preuves affaibliraient, contrediraient ou nous forceraient à abandonner la conclusion ? Cet article développe un raisonnement orienté vers la falsification pour les LLM en utilisant des hypothèses concurrentes, des tests discriminants, des contre-preuves et des critères de rejet explicites.