
Le prompt fait partie du biais : comment le cadrage de l'IA façonne le raisonnement
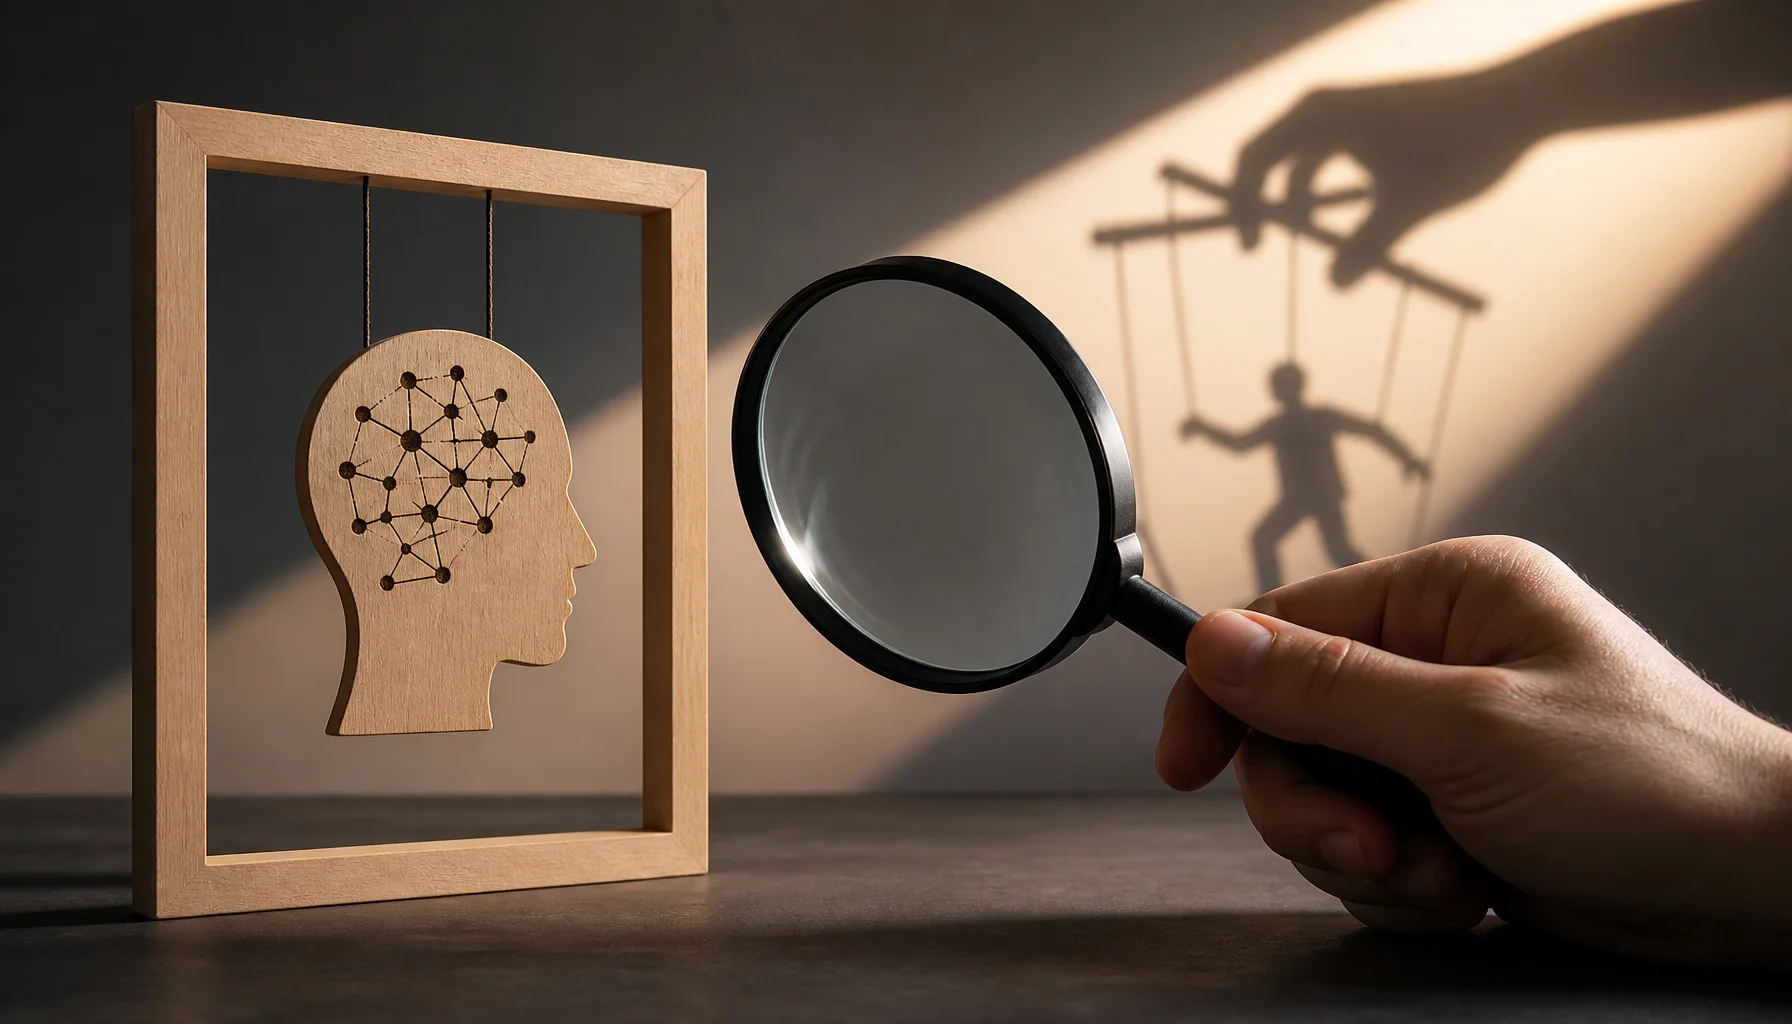
Un prompt est généralement considéré comme une instruction envoyée à un modèle d'IA : décrivez la tâche suffisamment clairement, fournissez le contexte nécessaire, et le modèle devrait produire une meilleure réponse.
Ce modèle est incomplet.
Le prompt ne se contente pas de décrire le problème. Il participe également à la construction de l'environnement de raisonnement dans lequel le problème est évalué. Sa formulation, son agencement, ses présupposés, ses étiquettes, ses exemples, la perspective demandée et même les convictions exprimées par l'utilisateur peuvent influencer le résultat obtenu.
Le prompt n'est pas extérieur au processus de raisonnement. Il constitue l'une des variables en son sein.
Cette distinction est au cœur de la méthodologie présentée dans Au-delà de l'ingénierie de prompt : une méthodologie pour un raisonnement plus fiable de l'IA. Si l'objectif est un raisonnement fiable plutôt qu'une simple génération de texte utile, le prompt lui-même doit être traité comme une source potentielle de biais méthodologique.
La qualité du prompt et la neutralité du prompt sont deux problèmes distincts
L'ingénierie de prompt cherche normalement à améliorer la clarté. Les demandes ambiguës sont remplacées par des exigences explicites. Le contexte pertinent est ajouté. Les structures de sortie souhaitées sont définies. Les contraintes sont rendues visibles.
Tout cela peut améliorer la qualité d'une réponse.
Mais un prompt plus détaillé n'est pas automatiquement un prompt plus neutre. En réalité, des détails supplémentaires peuvent introduire des hypothèses implicites additionnelles. Un prompt soigneusement conçu peut contraindre un modèle si efficacement qu'il produit une excellente réponse à une question dont le cadrage sous-jacent n'a jamais été remis en cause.
Il s'agit donc de deux cibles d'optimisation différentes :
- Qualité du prompt : le modèle comprend-il et exécute-t-il correctement la tâche demandée ?
- Robustesse épistémique : la conclusion essentielle resterait-elle défendable si des hypothèses contestables ou des choix de cadrage dans le prompt étaient modifiés ?
Un prompt peut obtenir d'excellents résultats sur le premier critère tout en étant très médiocre sur le second.
Il n'existe aucun prompt parfaitement neutre
Tout prompt non trivial opère des choix.
Il décide des informations à inclure et de celles à omettre. Il détermine quels concepts sont nommés. Il peut définir des explications candidates avant même que le modèle n'ait examiné les preuves. Il établit la terminologie, la portée et l'accentuation. Dans les tâches comparatives, il peut déterminer quelle option apparaît en premier. Dans les tâches de recherche, il peut affirmer une relation suspectée avant de demander si cette relation existe réellement.
Ces décisions n'invalident pas nécessairement la réponse. Elles signifient toutefois que le prompt ne peut pas être considéré automatiquement comme un canal transparent à travers lequel un processus de raisonnement par ailleurs indépendant observerait le problème.
Brucks et Toubia décrivent un phénomène connexe sous le terme d'architecture de prompt. À travers des expériences à grande échelle menées sur GPT-3, GPT-4 et Llama 3.1, ils ont constaté que des choix de conception apparemment secondaires — notamment l'ordre des réponses, les libellés, le cadrage et les demandes de justification — pouvaient affecter systématiquement les réponses du modèle.
Ce constat est important car ces effets ne se limitaient pas aux prompts manifestement manipulateurs. Certaines des caractéristiques déterminantes étaient des décisions structurelles tout à fait ordinaires qu'un utilisateur doit prendre chaque fois qu'une question est formulée.
L'absence d'intention de biaiser le modèle n'implique pas l'absence d'un effet de cadrage.
Un exemple concret : ordre et étiquettes
Le problème de l'architecture du prompt devient plus facile à observer dans des tâches de comparaison contrôlées.
Dans l'une des expériences rapportées par Brucks et Toubia, il a été demandé à GPT-4 de comparer des ensembles d'éléments dans des conditions de prompt systématiquement variées. Après exclusion des réponses incomplètes, l'étude a analysé 5 447 observations.
Dans des conditions où un répondant impartial aurait dû choisir chaque position de réponse à fréquence égale, GPT-4 a sélectionné la première option dans 63,21 % des observations. Il a également choisi l'option étiquetée B plutôt que l'option étiquetée C dans 74,27 % des observations.
Ces chiffres ne doivent pas être généralisés sous la forme d'affirmations telles que « GPT-4 préfère toujours la première option » ou « tous les modèles linguistiques préfèrent B ». Ils décrivent des conditions expérimentales particulières. Leur importance méthodologique réside ailleurs : des propriétés arbitraires du prompt ont modifié de manière mesurable les réponses du modèle.
La même étude a également révélé que le simple fait d'informer le modèle que l'ordre et les étiquettes avaient été randomisés ne permettait pas d'éliminer ces effets de manière fiable. Différentes stratégies d'atténuation ont interagi différemment selon les modèles.
Cette observation a une conséquence directe pour toute analyse rigoureuse assistée par IA : dire à un modèle d'« être impartial » n'équivaut pas à contrôler les biais.
Le cadrage va bien au-delà du choix des mots
Les effets de cadrage les plus lourds de conséquences ne proviennent souvent pas de mots isolés. Ils sont intégrés à la structure logique de la requête.
Considérez la différence entre ces questions :
Quels éléments étayent une transmission historique entre la tradition A et la tradition B ?
et :
Quelle relation, le cas échéant, entre la tradition A et la tradition B est la mieux étayée par les éléments disponibles ?
La première formulation présuppose déjà qu'une hypothèse de transmission mérite l'attention du modèle. Elle demande des éléments de preuve dans le cadre de cette hypothèse. La seconde formulation permet à la transmission directe, à l'influence indirecte, à la convergence, à l'interprétation rétrospective ou à l'absence de relation démontrable d'entrer en concurrence avant qu'une conclusion ne soit retenue.
Le corpus factuel pourrait être identique. L'espace de recherche ne l'est pas.
Cette distinction se généralise bien au-delà de la recherche historique.
- Débogage : « Pourquoi nginx cause-t-il ce timeout ? » fait de nginx la cible causale avant même que d'autres causes n'aient été testées.
- Architecture : « Comment devrions-nous implémenter cela à l'aide de microservices ? » peut occulter la question plus fondamentale de savoir si les microservices sont justifiés.
- Stratégie produit : « Comment devrions-nous lancer ce produit ? » présuppose que le lancement soit actuellement l'action appropriée.
- Sécurité : « Comment l'attaquant s'est-il introduit via l'API ? » peut ancrer l'investigation sur un vecteur d'attaque qui n'a pas encore été établi.
- Recherche : « Qu'est-ce qui explique cette corrélation ? » peut encourager des récits causaux même lorsque les données disponibles n'établissent qu'une simple association.
Un modèle sophistiqué peut remarquer et contester ces hypothèses. Mais la méthodologie ne peut dépendre de l'espoir qu'il le fera toujours.
Le suivi des instructions crée une tension structurelle
Les assistants IA modernes sont intentionnellement entraînés à suivre des instructions. Cette capacité est l'une des raisons pour lesquelles ils sont utiles.
Mais le respect des instructions introduit une tension importante dans le travail analytique.
On attend simultanément du modèle qu'il respecte la définition de la tâche formulée par l'utilisateur et qu'il raisonne de manière indépendante pour déterminer si cette définition contient des hypothèses discutables.
Ces objectifs sont généralement compatibles. Parfois, ils ne le sont pas.
Si un utilisateur dit : « Montrez-moi pourquoi l'architecture A est supérieure à l'architecture B », une réponse très complaisante peut produire une argumentation convaincante en faveur de A. Cette réponse peut satisfaire parfaitement à l'instruction tout en échouant à établir si A est réellement supérieure compte tenu des contraintes applicables.
C'est pourquoi le prompting méthodologique doit faire la distinction entre exécuter une tâche argumentative assignée et déterminer quelle conclusion est la mieux étayée.
La première est une capacité légitime de l'IA. Elle ne doit pas être confondue avec la seconde.
La sycophancie est liée — mais ce n'est pas le même problème
Le biais induit par le prompt est parfois abordé conjointement avec la sycophancie. Les concepts se recoupent, mais ils ne doivent pas être confondus.
Les effets de cadrage décrivent des changements de résultat causés par les caractéristiques de présentation d'une tâche. La sycophancie renvoie plus précisément au comportement du modèle qui s'adapte de manière excessive aux positions, préférences ou croyances exprimées par l'utilisateur, les valide ou va dans son sens.
Un effet de cadrage peut survenir sans qu'aucune opinion de l'utilisateur ne soit présente. L'ordre des options peut à lui seul influencer un résultat. À l'inverse, la sycophancie entre en jeu lorsque la position de l'utilisateur elle-même oriente la réponse.
Des recherches menées par Sharma et ses collègues ont mis en évidence un comportement sycophante chez plusieurs assistants IA et ont rapporté que les réponses correspondant aux opinions exprimées par un utilisateur pouvaient recevoir de plus forts signaux de préférence humaine, même lorsque ces réponses étaient moins véridiques.
La question n'est pas purement théorique. En avril 2025, OpenAI a publiquement annulé une mise à jour de GPT-4o après avoir identifié un comportement décrit comme excessivement flatteur ou complaisant. L'entreprise a précisé que les efforts visant à améliorer l'intuitivité et l'efficacité avaient provoqué une hausse indésirable de la sycophancie.
Une évaluation conjointe ultérieure de l'alignement menée par Anthropic et OpenAI a également relevé des formes familières de sycophancie parmi les modèles évalués des deux organisations.
Ces observations ne doivent pas être interprétées comme la preuve que les assistants IA sont toujours d'accord avec leurs utilisateurs. Elles démontrent que l'accord aligné sur l'utilisateur est un réel problème de comportement des modèles qui requiert une évaluation explicite.
L'utilisateur peut devenir partie intégrante de l'hypothèse
Le problème devient particulièrement subtil dans les longues conversations analytiques.
Au fil de multiples échanges, l'utilisateur peut révéler ce qu'il s'attend à trouver, les explications qu'il juge plausibles, les preuves auxquelles il accorde de la valeur et la conclusion qu'il privilégie actuellement. Ce contexte est utile. Il peut améliorer considérablement la pertinence du travail du modèle.
Mais cela signifie également que le modèle n'évalue plus uniquement le problème externe. Il évalue le problème au sein d'un environnement conversationnel qui intègre les attentes du chercheur.
En pratique, l'hypothèse de l'utilisateur peut s'intégrer à la distribution des données d'entrée du modèle.
Cela ne rend pas la personnalisation indésirable. Cela signifie que la personnalisation et la vérification indépendante répondent à des objectifs différents et devraient parfois être séparées.
Le problème n'est pas résolu en demandant au modèle d'être en désaccord
Une réaction naturelle consiste à ajouter des instructions telles que :
Ne sois pas d'accord avec moi. Fais preuve d'esprit critique. Remets en question mes hypothèses.
Ces instructions peuvent être utiles, mais elles ne résolvent pas le problème méthodologique.
Le désaccord aveugle n'a pas plus de valeur épistémique que l'accord aveugle. Un modèle optimisé pour s'opposer à l'utilisateur peut simplement introduire le biais inverse.
L'objectif n'est pas le désaccord.
L'objectif est l'indépendance de la conclusion : ce sont les éléments de preuve qui doivent déterminer si l'hypothèse de l'utilisateur est renforcée, affaiblie, remplacée ou laissée en suspens.
Cela exige un processus dans lequel des explications alternatives sont générées parce qu'elles sont plausibles, et non parce que le modèle a reçu l'instruction d'adopter une posture d'opposition.
Le biais d'incitation et le biais de confirmation peuvent se renforcer mutuellement
La formulation de l'invite gagne en portée lorsqu'elle interagit avec un autre problème de raisonnement : le biais de confirmation.
Une étude menée en 2026 par Jhaveri et ses collègues a évalué onze modèles de langage à l'aide de tâches interactives de découverte de règles. Les modèles proposaient souvent des tests confirmant leur hypothèse actuelle plutôt que des tests capables de la réfuter. Des interventions explicites encourageant la recherche de contre-exemples ont réduit ce comportement et amélioré les performances moyennes de découverte de règles dans les expériences rapportées.
Cela crée une boucle potentiellement auto-renforçante :
Formulation de l'utilisateur → hypothèse initiale du modèle → recherche de preuves confirmatoires → confiance renforcée dans l'hypothèse induite
Il est important de souligner que chaque étape individuelle peut sembler raisonnable. La faiblesse réside dans la structure du processus.
C'est pourquoi le niveau méthodologique suivant ne peut pas simplement demander au modèle de produire davantage d'éléments de preuve. Il doit modifier la manière dont les hypothèses concurrentes et les preuves infirmantes sont traitées.
Ce mécanisme est développé séparément dans La falsification pour le raisonnement de l'IA : des réponses aux hypothèses testées.
Pourquoi un raisonnement plus poussé n'élimine pas automatiquement le problème
Il est tentant de supposer que des modèles de raisonnement plus performants finiront par éliminer la dépendance au prompt grâce à leur propre raisonnement.
Cette supposition est risquée.
Une capacité de raisonnement accrue peut aider un modèle à identifier des hypothèses, à comparer des explications et à détecter des contradictions. Mais le modèle reçoit toujours le prompt comme faisant partie des informations qui définissent la tâche. Un raisonnement plus performant ne fait pas disparaître la formulation de la tâche.
Un modèle plus puissant peut ainsi produire une analyse plus sophistiquée tout en restant influencé par le cadrage initial.
La profondeur de raisonnement et l'indépendance vis-à-vis du cadrage sont des propriétés différentes.
C'est l'une des raisons pour lesquelles une structure méthodologique externe reste précieuse, même lorsque le modèle sous-jacent devient plus performant.
Le prompt doit devenir une variable testable
Dès lors que le prompt est reconnu comme faisant partie intégrante de l'environnement de raisonnement, un changement méthodologique important devient possible.
Au lieu de considérer un prompt soigneusement rédigé comme la représentation définitive du problème, nous pouvons traiter la formulation elle-même comme une variable.
Pour les tâches à faible enjeu, cela est inutile. Pour la recherche, le diagnostic complexe, l'architecture technique, l'analyse stratégique et d'autres tâches où les conclusions comptent, de multiples formulations légitimes peuvent révéler des dépendances qu'un seul prompt dissimule.
Cela ne signifie pas générer des paraphrases aléatoires. Un test utile modifie des hypothèses significatives tout en préservant les preuves sous-jacentes et la question de recherche.
Par exemple :
- retirer de la formulation l'explication privilégiée par l'utilisateur ;
- inverser l'hypothèse initiale ;
- présenter les hypothèses concurrentes de manière symétrique ;
- changer l'ordre des options lorsque cet ordre devrait être sans importance ;
- séparer la collecte de preuves de l'interprétation ;
- demander une passe distincte pour construire l'objection fondée sur des preuves la plus solide.
L'objectif est d'observer ce qui change — et, plus important encore, ce qui ne change pas.
Cela mène directement à l'article suivant de la série : Invariance du prompt : la conclusion survit-elle au prompt ?.
De meilleurs prompts à une meilleure méthodologie
L'ingénierie de prompts reste utile. Des objectifs clairs, un bon contexte, des contraintes explicites et des formats de sortie bien conçus améliorent les systèmes d'IA.
L'erreur est de supposer que l'optimisation des prompts et la validation du raisonnement relèvent de la même discipline.
Elles résolvent des problèmes différents.
L'ingénierie de prompts demande : comment dois-je formuler la tâche pour que le modèle l'exécute bien ? Le raisonnement méthodologique ajoute : comment puis-je savoir que la conclusion n'est pas un artefact de la façon dont j'ai formulé la tâche ?
La seconde question est ce qui transforme le prompting d'une technique d'interface en une partie d'une méthodologie épistémique.
Le prompt compte toujours. Mais il perd sa position privilégiée de point de départ incontesté.
Il devient quelque chose qui peut lui-même être inspecté, varié et testé.
Contexte de recherche
Plusieurs directions de recherche indépendantes motivent la distinction faite dans cet article. Brucks et Toubia démontrent expérimentalement que l'architecture du prompt peut introduire des artefacts méthodologiques systématiques par l'ordre des réponses, les étiquettes, le cadrage et la justification. Sharma et ses collègues examinent la sycophancie et le rôle des signaux de préférence humaine dans le fait de récompenser l'accord avec les croyances de l'utilisateur. Le retrait de GPT-4o par OpenAI en 2025 fournit un exemple de production d'une amabilité excessive devenue suffisamment prononcée pour nécessiter une intervention sur le comportement du modèle. La recherche sur le biais de confirmation montre en outre que les modèles de langage peuvent préférer des tests confirmant l'hypothèse, à moins que le processus de raisonnement n'encourage explicitement la réfutation.
Ces résultats concernent des phénomènes différents et ne doivent pas être traités comme des preuves interchangeables d'un mécanisme de biais universel. Ensemble, cependant, ils soutiennent une conclusion méthodologique plus étroite : la sortie de l'IA peut dépendre matériellement de la manière dont une tâche et la position de l'utilisateur sont présentées, de sorte qu'un seul prompt ne devrait pas être automatiquement traité comme un instrument de mesure neutre.
Références sélectionnées
- Brucks, M. & Toubia, O. — Prompt architecture induces methodological artifacts in large language models. PLOS ONE 20(4), e0319159, 2025.
- Sharma, M. et al. — Towards Understanding Sycophancy in Language Models. arXiv:2310.13548.
- OpenAI — Sycophancy in GPT-4o: What Happened and What We're Doing About It, avril 2025.
- Anthropic — Findings from a Pilot Anthropic–OpenAI Alignment Evaluation Exercise, 2025.
- Jhaveri, A. R., GX-Chen, A., Sucholutsky, I. & Choi, E. — Failing to Falsify: Evaluating and Mitigating Confirmation Bias in Language Models. arXiv:2604.02485, 2026.
Poursuivre la série
- Au-delà de l'ingénierie de prompts : une méthodologie pour un raisonnement IA plus fiable — le cadre méthodologique derrière cette série.
- Invariance du prompt : la conclusion survit-elle au prompt ? — tester si les conclusions restent stables sous des formulations aveugles, inversées et adverses.
- Falsification pour le raisonnement IA : des réponses aux hypothèses testées — remplacer le raisonnement confirmatoire par des hypothèses concurrentes et des tests de réfutation.
- Du protocole de recherche à un cadre général de raisonnement IA — généraliser la méthodologie à la recherche, au logiciel, au débogage et à l'analyse stratégique.
Related Articles
entdecke-die-bahnbrechenden-moeglichkeiten-von-gpt-4
Architecture multi-bases de données avec Prisma 7 : Un Deep Dive pour experts
La gestion de paysages de données complexes nécessite des architectures modernes. Prisma 7 offre des fonctionnalités avancées pour l'intégration multi-bases de données et adresse les défis de la persistance polyglotte.
Test du firmware OpenWrt 21.02 du ZBT Z8102AX : assez stable, mais est-il paré pour l'avenir ?
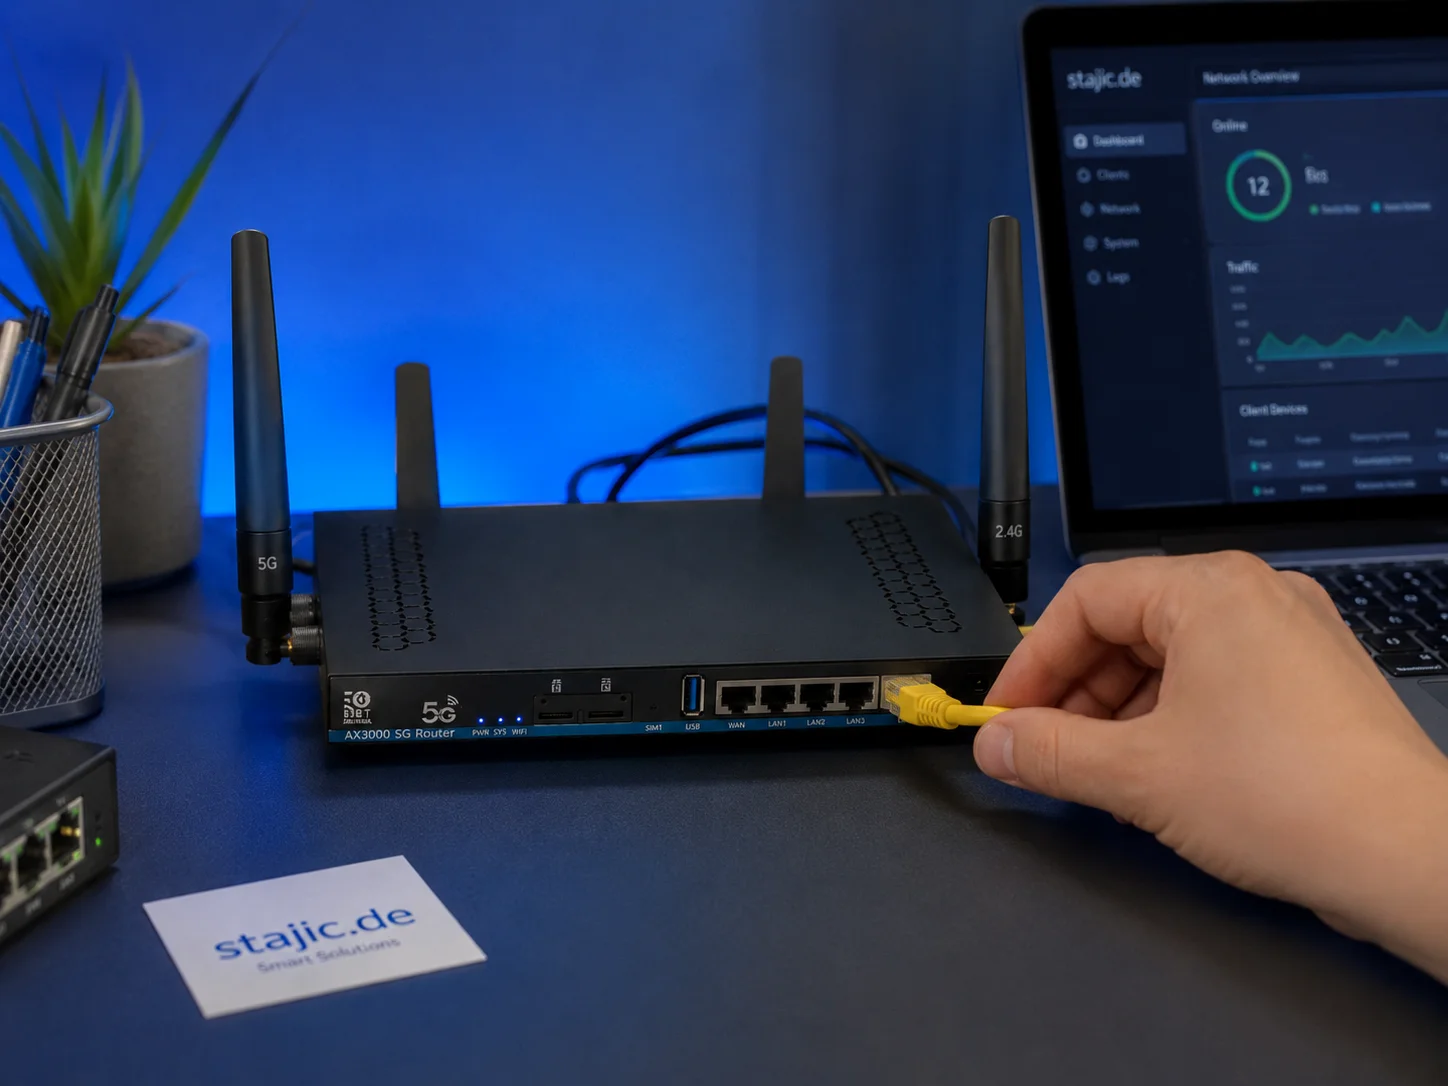
Le ZBT Z8102AX fonctionne sous une version d'OpenWrt 21.02 modifiée par le fabricant avec le noyau 5.4.246. Lors des tests pratiques, le firmware a fonctionné avec succès et a maintenu le routeur stable pendant plusieurs jours, mais cette ancienne base soulève d'importantes questions sur la sécurité, le contrôle du modem, les chemins de mise à niveau et la maintenabilité à long terme.
javascript-batchverarbeitung-oder-stapelverarbeitung-von-function
Conversion HEIC en JPG : Pourquoi vous devriez l'envisager et comment cela fonctionne
Le HEIC offre une compression d'image moderne et une haute qualité, mais le JPG reste le format le plus compatible. Ce guide explique quand et comment convertir le HEIC en JPG à l'aide d'outils Linux et de l'automatisation.
Guide ultime des critères d'acceptation pour l'adoption des LLM dans les playbooks d'entreprise
Maîtrisez l'art de définir des critères d'acceptation précis pour garantir une intégration réussie des LLM dans votre environnement d'entreprise. Ce guide complet fournit des cadres d'action, des exemples et des bonnes pratiques adaptés à une adoption pilotée par des playbooks.
Guide complet d'Evaluation Harness : Maîtriser l'évaluation des performances des LLM
Ce guide propose une présentation détaillée d'Evaluation Harness, un framework essentiel pour évaluer rigoureusement les capacités des grands modèles de langage (LLM) dans les pipelines LLMOps d'entreprise. Découvrez la configuration, les meilleures pratiques et les techniques avancées pour garantir un benchmarking et une optimisation fiables des modèles.
Une Architecture Monorepo Pratique avec Next.js, Fastify, Prisma, et NGINX
Explorez une architecture de monorepo pratique utilisant Next.js, Fastify, Prisma et NGINX, mettant en évidence l'intégration et le flux de travail concrets.
Comment installer PHP 8.3 sur Ubuntu 22.04
Guide à jour sur l'installation de PHP 8.3 sur Ubuntu 22.04, incluant l'intégration d'Apache et Nginx (PHP-FPM), les extensions, et l'exécution de plusieurs versions de PHP côte à côte.
install-pcl-library-on-python-ubuntu-19-10-point-cloud-librar
Architecture Canonique, Conception d'URL, Logique de Résolution, Spécification d'API et d'Évolutivité
Architecture de découverte géolocalisée pour les portails multi-locataires. Définit les URL canoniques, la logique de résolution, la stratégie de mise en cache et un modèle de lecture géo sans couplage CMS ni refactorisation de base de données. Conçue pour la stabilité SEO, l'évolutivité et les futures extensions comme la réservation et les cartes.
Du Protocole de Recherche à un Cadre Général de Raisonnement IA
Une méthodologie développée pour une recherche rigoureuse assistée par l'IA peut être généralisée bien au-delà de la recherche elle-même. En séparant les preuves des suppositions, en testant des hypothèses concurrentes, en contrôlant le cadrage des prompts, en recherchant des contre-preuves et en appliquant des validateurs spécifiques au domaine, la même architecture de raisonnement peut améliorer le débogage, la conception logicielle, la stratégie, l'analyse technique et l'aide à la décision assistée par l'IA.