
Invariance du prompt : la conclusion survit-elle au prompt ?
Si le prompt lui-même peut influencer le raisonnement d'un modèle d'IA, alors évaluer une conclusion produite par un seul prompt laisse une variable majeure non maîtrisée.
Une réaction naturelle consiste à réécrire le prompt et à réessayer. Mais la simple répétition ne suffit pas. Une formulation différente peut générer des termes différents tout en conservant le même raisonnement, et des conclusions identiques peuvent persister d'un prompt à l'autre pour de mauvaises raisons.
Ce qu'il faut, c'est un test structuré permettant de déterminer si la conclusion essentielle dépend excessivement du cadrage qui l'a produite.
J'utilise le terme d'Invariance au Prompt pour désigner un test de robustesse pratique : la conclusion essentielle reste-t-elle défendable lorsque le même problème et les mêmes éléments de preuve sont examinés sous des cadrages légitimes matériellement différents ?
L'Invariance au Prompt n'est pas proposée ici comme une métrique académique établie, un invariant mathématique ou une preuve de la véracité d'une réponse. Il s'agit d'une méthodologie opérationnelle visant à détecter une faiblesse particulière du raisonnement assisté par l'IA : des conclusions qui dépendent trop fortement de la manière dont l'utilisateur initial a formulé le problème.
Elle prolonge le cadre introduit dans Au-delà de l'ingénierie de prompt : une méthodologie pour un raisonnement d'IA plus fiable et s'attaque directement au problème de dépendance au prompt analysé dans Le prompt fait partie du biais.
Le problème : un seul prompt produit un résultat conditionnel
Une réponse d'IA n'est pas générée à partir de la seule question. Elle découle d'un contexte d'inférence complet : la formulation de la question, la conversation précédente, les données fournies, les instructions système, les exemples, l'ordre de présentation, les étiquettes, la perspective demandée et la configuration du modèle.
La réponse doit donc être comprise comme étant conditionnée par cet environnement.
Réponse = Modèle(problème | cadrage, contexte, éléments probants, instructions)
Pour des tâches ordinaires, cette distinction peut sembler superflue. S'il s'agit de résumer un paragraphe ou de convertir une unité, construire plusieurs environnements de raisonnement indépendants n'apporte généralement que peu de valeur.
Pour la recherche, le diagnostic technique complexe, les choix d'architecture, l'analyse stratégique et d'autres tâches où le raisonnement lui-même compte, la donne change. Une conclusion devrait idéalement être étayée par les faits plutôt que par une propriété accidentelle du prompt qui les a introduits.
L'Invariance au Prompt n'est pas une cohérence textuelle
La première distinction est fondamentale : l'Invariance au Prompt n'exige pas que le modèle produise le même texte.
Deux réponses peuvent employer des formulations totalement différentes tout en parvenant à la même conclusion fondée sur des preuves. À l'inverse, deux réponses peuvent comporter des conclusions presque identiques tout en reposant sur des hypothèses divergentes ou des éléments incompatibles.
L'objet pertinent n'est donc pas la similarité lexicale, mais la stabilité de la structure de raisonnement.
- Stabilité des faits : quelles conclusions factuelles clés résistent aux différentes formulations ?
- Stabilité des preuves : quelles sources ou observations demeurent déterminantes ?
- Stabilité des hypothèses : quelles explications concurrentes restent plausibles ou sont rejetées ?
- Stabilité de la conclusion : la même conclusion générale reste-t-elle la mieux étayée ?
- Stabilité de la confiance : le niveau de certitude estimé de la conclusion varie-t-il de façon substantielle ?
- Stabilité causale : les mêmes liens de causalité ou de transmission subsistent-ils lorsque le cadrage change ?
Cette distinction permet également d'éviter une erreur méthodologique mise en évidence dans des recherches récentes sur la sensibilité aux prompts. Une sensibilité apparente peut parfois être exagérée par des méthodes d'évaluation trop rigides, qui classent comme différentes des réponses sémantiquement équivalentes simplement parce qu'elles adoptent des modes d'expression distincts.
L'unité de comparaison devrait donc être le sens et la structure probante de la réponse, et non l'équivalence exacte des chaînes de caractères.
Un test d'invariance des requêtes en quatre passes
La méthode de base utilise quatre passes de raisonnement intentionnellement différentes sur la même question de recherche sous-jacente.
Passe 1 — Originale
La première passe conserve la formulation originale de l'utilisateur, y compris son hypothèse lorsqu'elle a été explicitement énoncée.
Son but n'est pas seulement de générer une réponse initiale. Elle établit également la référence à laquelle les passes ultérieures pourront être comparées.
Exemple : Quels éléments de preuve soutiennent l'hypothèse selon laquelle la tradition A a influencé la tradition B ?— Formulation originale
Cette formulation est légitime si la tâche de recherche consiste explicitement à examiner cette hypothèse. Mais elle oriente déjà l'attention vers une relation particulière.
Passe 2 — À l'aveugle
La passe à l'aveugle supprime la conclusion attendue par l'utilisateur de la définition de la tâche.
Exemple : Sur la base des preuves disponibles, quelle relation, le cas échéant, entre la tradition A et la tradition B est la mieux étayée ?— Formulation à l'aveugle
Les preuves n'ont pas changé. Ce qui change, c'est l'allocation initiale de l'attention.
L'influence directe, l'influence indirecte, la convergence indépendante, la réinterprétation tardive et l'absence de relation démontrable peuvent désormais entrer dans l'analyse sans que l'une d'entre elles ne reçoive un statut privilégié de la part de l'utilisateur.
Passe 3 — Inversée
La passe inversée attribue délibérément à une explication alternative solide la position précédemment occupée par l'hypothèse privilégiée par l'utilisateur.
Exemple : Testez l'hypothèse selon laquelle les similitudes entre la tradition A et la tradition B se sont développées de manière indépendante plutôt que par transmission directe.— Formulation inversée
Le but n'est pas de pousser le modèle à se contredire. L'alternative n'est pas non plus présumée exacte.
Le but est la symétrie : si positionner une hypothèse comme proposition de départ lui confère un avantage artificiel, donner ce même avantage à l'alternative la plus solide peut mettre en évidence cette dépendance.
Passe 4 — Contradictoire
La passe contradictoire commence après qu'une conclusion provisoire a déjà émergé.
Construisez la contestation fondée sur des preuves la plus solide possible contre la conclusion provisoire. Identifiez les hypothèses non étayées, les preuves contradictoires, les explications causales alternatives et les observations que l'explication actuelle prend mal en compte.— Formulation contradictoire
Il ne s'agit pas d'un esprit de contradiction générique. La passe contradictoire doit rester ancrée dans les preuves.
Une objection prend de la valeur parce qu'elle met en lumière une faiblesse probante, et non simplement parce qu'elle est en désaccord avec la réponse actuelle.
Les preuves doivent être contrôlées
Une complication méthodologique devient critique lorsque le modèle a accès à la recherche sur le Web, au RAG, à des bases de données ou à d'autres systèmes de récupération.
Si chaque prompt récupère un ensemble différent de sources, une conclusion modifiée peut avoir au moins deux explications :
- le raisonnement a changé parce que la formulation du prompt a changé ;
- le raisonnement a changé parce que les informations à la disposition du modèle ont changé.
Ces effets ne doivent pas être confondus.
Pour tester l'invariance des prompts de manière contrôlée, la conception la plus rigoureuse consiste donc à figer le corpus de preuves avant d'exécuter les variantes de formulation.
Même question + mêmes preuves + formulation légitime différente— Invariance contrôlée des prompts
Cela permet d'isoler plus efficacement la sensibilité du raisonnement.
Une seconde expérience peut délibérément laisser la récupération activée. Cela mesure autre chose : la robustesse de l'ensemble du pipeline de recherche de l'IA.
- Invariance à corpus fixe : teste la couche de raisonnement tout en maintenant les preuves constantes.
- Invariance avec récupération intégrée : teste si la formulation modifie à la fois ce que le système récupère et ce qu'il conclut.
Les deux approches sont utiles. Elles répondent à des questions différentes.
Que doit-on comparer ?
Comparer manuellement quatre longues réponses en langage naturel est inefficace et peu fiable. Les sorties doivent donc être normalisées dans une structure analytique commune.
Chaque passage peut renvoyer les mêmes champs :
- Faits établis
- Sources ou observations pertinentes
- Hypothèses préalables
- Hypothèses candidates
- Éléments de preuve étayant chaque hypothèse
- Éléments de preuve contredisant chaque hypothèse
- Questions non résolues
- Conclusion provisoire
- Niveau de confiance et motifs de cette confiance
L'étape de comparaison évalue ensuite la structure plutôt que la prose.
Si les quatre passages utilisent un langage différent mais conservent les mêmes éléments de preuve fondamentaux, éliminent les mêmes alternatives et convergent vers la même conclusion nuancée, le résultat démontre une robustesse de cadrage nettement supérieure à celle d'une conclusion obtenue à partir d'un seul prompt.
Si l'explication privilégiée change à chaque modification du cadrage, la conclusion doit être affaiblie jusqu'à ce que la source de cette instabilité soit comprise.
Quatre formes distinctes de stabilité
L'invariance au prompt devient plus utile lorsque la stabilité n'est pas réduite à un simple résultat binaire par oui ou non.
Invariance des éléments de preuve
Les mêmes éléments de preuve restent-ils importants, quelle que soit l'hypothèse mise en avant par le prompt ?
Si une source n'est jugée décisive que lorsque le prompt favorise une explication, son rôle nécessite un examen plus approfondi.
Invariance des hypothèses
Les mêmes alternatives plausibles émergent-elles d'un passage à l'autre ?
Une hypothèse qui n'apparaît que lorsqu'elle est explicitement fournie par l'utilisateur peut tout de même être correcte, mais son absence lors d'une analyse à l'aveugle est méthodologiquement significative.
Invariance de la conclusion
La même conclusion générale reste-t-elle la meilleure explication après modification du cadrage ?
Cela n'exige pas une formulation identique. « La transmission directe est fortement étayée » et « les données disponibles privilégient la transmission directe plutôt qu'une convergence indépendante » appartiennent à la même catégorie générale de conclusion.
Invariance de la confiance
Le niveau de confiance reste-t-il approximativement stable ?
Un modèle qui exprime 90 % de confiance sous la formulation initiale et qui devient profondément incertain sous une formulation à l'aveugle a révélé quelque chose d'important, même si sa conclusion nominale demeure inchangée.
Une matrice d'invariance des prompts
Pour les investigations complexes, les quatre passes peuvent être résumées dans une matrice simple.
| Dimension | Original | À l'aveugle | Inversé | Adversarial |
|---|---|---|---|---|
| Faits fondamentaux | Enregistrer les constats | Enregistrer les constats | Enregistrer les constats | Contester les faits litigieux |
| Hypothèse principale | Définie par l'utilisateur | Sélectionnée d'après les preuves | Formulation alternative | Conclusion actuelle attaquée |
| Contre-preuves | Enregistrer | Enregistrer | Enregistrer | Prioriser les plus solides |
| Conclusion | Référence | Comparer | Comparer | Réévaluer |
| Confiance | Référence | Comparer | Comparer | Recalibrer |
La matrice n'a pas besoin de produire un score numérique. Sa vocation première est diagnostique : rendre les dépendances visibles.
Une notation numérique pourrait être ajoutée pour les systèmes automatisés, mais de tels scores ne devraient pas être présentés comme des métriques validées scientifiquement à moins d'avoir eux-mêmes été validés empiriquement.
Pourquoi la simple paraphrase ne suffit pas
Des recherches récentes apportent des preuves utiles montrant que des formulations de prompts sémantiquement équivalentes peuvent parfois produire des jugements de modèle différents.
Une étude de 2026 menée par Alhetelah et Ahmad a examiné 200 questions d'opinion, chacune assortie de cinq paraphrases validées par des humains, sur cinq modèles de langage dans des configurations déterministes. Les modèles présentaient des différences quant à la stabilité de leurs décisions face à la paraphrase.
Ce résultat plaide en faveur d'un test de robustesse des prompts, mais l'invariance des prompts va au-delà du simple test de paraphrase.
Une paraphrase préserve idéalement à la fois la sémantique et le cadrage. La méthodologie proposée ici modifie intentionnellement certaines parties du cadrage tout en préservant le problème de recherche sous-jacent.
Le test de paraphrase se demande si une formulation équivalente modifie la réponse. L'invariance des prompts se demande si un changement légitime de perspective modifie ce que le modèle estime être étayé par les preuves.
La seconde approche constitue une intervention méthodologique plus forte.
L'instabilité n'est pas automatiquement une défaillance du modèle
La sensibilité aux prompts doit être interprétée avec précaution.
Hua et ses collègues ont réexaminé la sensibilité aux prompts à travers sept modèles de langage, six benchmarks et douze modèles de prompts. Leur étude de 2025 a révélé qu'une partie de la sensibilité précédemment rapportée pouvait être attribuée à des procédures d'évaluation telles que la correspondance stricte des réponses plutôt qu'à des changements substantiels dans l'exactitude du modèle.
C'est précisément la raison pour laquelle l'invariance des prompts ne doit pas se limiter à comparer la forme de surface.
Une phrase modifiée ne signifie pas nécessairement une conclusion modifiée. Une conclusion modifiée n'est pas non plus nécessairement une erreur.
L'instabilité peut révéler plusieurs situations fondamentalement différentes :
- le prompt initial contenait un biais de cadrage ;
- le problème sous-jacent est véritablement ambigu ;
- les éléments disponibles soutiennent plusieurs interprétations concurrentes ;
- la recherche documentaire a fourni des preuves différentes ;
- la méthode d'évaluation a classé à tort des réponses équivalentes comme étant différentes ;
- la génération stochastique a produit un cheminement de raisonnement différent ;
- un cadrage a révélé une considération pertinente que les autres ont omise.
L'invariance de prompt n'est donc pas un test dans lequel la variation compte automatiquement comme un échec. La variation est un signal de diagnostic qui nécessite une explication.
La stabilité n'est pas automatiquement synonyme de vérité
L'erreur inverse est encore plus importante.
Supposons que les passes initiale, aveugle, inversée et contradictoire convergent toutes vers la même conclusion.
C'est une preuve de robustesse face aux changements de cadrage testés. Ce n'est pas une preuve de vérité.
Toutes les passes peuvent partager le même manque d'information. Le modèle peut présenter la même erreur factuelle à chaque exécution. Le corpus de données peut être incomplet. Différents prompts peuvent activer la même idée reçue apprise. Plusieurs agents reposant sur le même modèle sous-jacent peuvent reproduire la même erreur.
L'invariance de prompt teste la dépendance vis-à-vis du cadrage. Elle ne valide pas le modèle du monde en lui-même.
Les preuves externes, la critique des sources, les mesures, les expérimentations et l'expertise sectorielle restent nécessaires chaque fois que le problème l'exige.
Un exemple technique
Considérons un système en production qui perd par intermittence ses connexions API.
L'hypothèse initiale du développeur est que nginx interrompt les connexions.
Original : Analysez pourquoi nginx interrompt ces connexions API.
Aveugle : Analysez les journaux et la configuration pour déterminer la cause la plus probable des échecs de connexion API.
Inversé : Vérifiez si les échecs de connexion proviennent de l'application, du service en amont ou de la couche réseau plutôt que de nginx.
Contradictoire : Partez du principe que le diagnostic actuel concernant nginx est erroné. Identifiez les éléments les plus probants qui le contredisent ainsi que les observations qu'une autre hypothèse explique mieux.
Si toutes les passes convergent indépendamment vers la même configuration de délai d'attente (timeout) de nginx et les mêmes données de journalisation, la confiance dans le diagnostic augmente.
Si seul le prompt d'origine identifie nginx alors que l'analyse en aveugle pointe vers des réinitialisations en amont, le premier diagnostic ne doit pas être simplement conservé parce qu'il est apparu en premier.
La méthodologie n'a pas résolu le problème de débogage à elle seule. Elle a mis en évidence les points où des tests discriminants supplémentaires sont nécessaires.
Un exemple de recherche historique
La même structure s'applique à la recherche historique, mais les validateurs changent.
Une transmission intellectuelle ou religieuse présumée exige plus qu'une simple similarité thématique. La chronologie, la géographie, les contacts documentés, la dépendance textuelle, les intermédiaires et la provenance peuvent tous avoir leur importance.
Les quatre passes d'invariance de prompt peuvent déterminer si l'hypothèse de transmission reste privilégiée sous un cadrage différent. Elles ne peuvent pas se substituer aux preuves historiques requises pour établir la transmission elle-même.
Cette distinction illustre la relation entre le cadre de raisonnement indépendant du domaine et les validateurs spécifiques au domaine développés plus en détail dans Du protocole de recherche au cadre général de raisonnement pour l'IA.
Invariance de prompt et falsification
L'invariance de prompt et la falsification résolvent des problèmes connexes mais distincts.
L'invariance de prompt pose la question suivante :
La conclusion survit-elle à un changement significatif de cadrage ?
La falsification pose la question suivante :
Quelle preuve ou observation devrait nous amener à rejeter ou à affaiblir substantiellement l'hypothèse ?
Une méthodologie robuste a besoin des deux.
Une hypothèse peut être invariante au prompt parce que le modèle reproduit continuellement la même idée fausse. La falsification introduit une exigence plus stricte : identifier les observations qui iraient à l'encontre de l'hypothèse et les rechercher activement.
Cette étape supérieure est développée dans La falsification pour le raisonnement de l'IA : des réponses aux hypothèses testées.
De quatre prompts à une architecture de vérification
Le processus en quatre passes peut être exécuté manuellement, mais il devient plus intéressant lorsqu'il est intégré au sein d'un système d'IA.
Entrée → normalisation des preuves → passe originale → passe aveugle → passe inversée → passe adversariale → comparaison structurée → recalibrage de la confiance → synthèse finale
Les passes individuelles peuvent utiliser des contextes séparés afin que les analyses ultérieures ne soient pas contaminées par la réponse précédente. Leurs sorties peuvent être stockées sous forme de données structurées plutôt que de prose. Un vérificateur final peut comparer les faits, les preuves, les hypothèses et la confiance avant qu'une réponse destinée à l'utilisateur ne soit générée.
Le résultat n'est plus une réponse unique d'un modèle. C'est un petit processus de vérification.
La mise en œuvre architecturale de cette approche est développée dans Concevoir une couche de vérification épistémique pour les LLM.
Quand l'invariance des invites vaut le coût
Exécuter plusieurs passes analytiques coûte des jetons, de la latence et du calcul supplémentaires. Cela ne devrait pas devenir une surcharge rituelle pour chaque interaction.
La méthode est plus précieuse lorsqu'une ou plusieurs des conditions suivantes s'appliquent :
- l'utilisateur a déjà une hypothèse fortement privilégiée ;
- plusieurs explications plausibles sont en concurrence ;
- la conclusion influencera une décision technique ou stratégique importante ;
- la question de recherche est controversée ou les preuves sont incomplètes ;
- des affirmations causales sont dérivées de preuves indirectes ;
- le modèle agit comme évaluateur, juge ou système d'aide à la décision ;
- le coût d'une réponse confiante mais orientée est matériellement supérieur au coût d'une inférence supplémentaire.
Pour des tâches déterministes simples, le processus supplémentaire peut n'apporter presque aucune valeur.
Le principe méthodologique
Une invite forte reste utile. Mais une invite forte ne doit pas être confondue avec une vérification indépendante de la conclusion qu'elle produit.
L'invariance des invites ajoute un second niveau de questionnement.
Ne demandez pas seulement si la réponse est convaincante. Demandez quelles parties de la réponse survivent lorsque les conditions qui l'ont rendue convaincante sont modifiées.
Si les faits, la structure des preuves et la conclusion survivent à des formulations aveugles, inversées et adversariales, le résultat a démontré une résistance à une source importante d'erreur de raisonnement de l'IA.
S'ils ne survivent pas, la méthodologie a tout de même réussi.
Elle a montré que la conclusion originale dépendait davantage de son cadrage qu'une réponse unique et soignée ne l'aurait révélé.
L'objectif de l'invariance des invites n'est pas l'accord entre les invites. L'objectif est d'exposer quelles conclusions en dépendent.
Contexte de recherche
L'invariance de prompt telle que définie dans cet article est un construit méthodologique proposé, et non un benchmark standardisé issu de la littérature. Elle s'inspire de plusieurs domaines de recherche connexes : l'architecture de prompt, la robustesse aux paraphrases, le biais positionnel et l'évaluation de la sensibilité aux prompts.
Brucks et Toubia ont démontré que l'ordre, les étiquettes, le cadrage et la justification peuvent produire des artefacts méthodologiques systématiques dans les réponses des LLM. Schilcher et ses collègues ont quant à eux examiné les effets positionnels sur plusieurs modèles et ont constaté que l'ordre des entrées peut affecter les caractéristiques structurelles, la cohérence et, pour certains modèles, le comportement d'omission ou de réordonnancement.
Alhetelah et Ahmad ont testé cinq modèles à l'aide de 200 questions d'opinion comportant chacune cinq paraphrases validées par des humains, démontrant des différences significatives de robustesse face à des formulations sémantiquement équivalentes. Hua et ses collègues apportent un contrepoids important : leur évaluation portant sur sept modèles, six benchmarks et douze modèles de prompts a révélé qu'une sensibilité apparente aux prompts peut provenir de la méthodologie d'évaluation plutôt que de véritables changements dans les compétences du modèle.
Ensemble, ces résultats soutiennent la nécessité de tester la robustesse à travers différentes formulations de prompts, tout en exigeant de la rigueur dans la façon dont les différences sont mesurées et interprétées.
Références sélectionnées
- Alhetelah, B. & Ahmad, I. — Measuring LLMs' Sensitivity to Paraphrased Opinion Prompts. WASSA / ACL, 2026.
- Hua, A., Tang, K., Gu, C., Gu, J., Wong, E. & Qin, Y. — Flaw or Artifact? Rethinking Prompt Sensitivity in Evaluating LLMs. EMNLP, 2025.
- Brucks, M. S. & Toubia, O. — Prompt Architecture Induces Methodological Artifacts in Large Language Models. PLOS ONE, 2025.
- Schilcher, P. et al. — Characterizing Positional Bias in Large Language Models: A Multi-Model Evaluation of Prompt Order Effects. Findings of EMNLP, 2025.
- Pezeshkpour, P. & Hruschka, E. — Large Language Models Sensitivity to the Order of Options in Multiple-Choice Questions. Findings of NAACL, 2024.
Poursuivre la série
- Au-delà du prompt engineering : une méthodologie pour un raisonnement de l'IA plus fiable — le cadre méthodologique complet.
- Le prompt fait partie du biais — pourquoi le cadrage, le respect des instructions et les hypothèses de l'utilisateur peuvent influencer le raisonnement de l'IA.
- La falsification pour le raisonnement de l'IA : des réponses aux hypothèses testées — déterminer quels éléments pourraient concrètement affaiblir ou réfuter une hypothèse.
- Du protocole de recherche au cadre général de raisonnement de l'IA — appliquer la méthodologie à la recherche, au débogage, à l'architecture et à la stratégie.
Related Articles
Que devrait mémoriser, oublier, recalculer ou récupérer à nouveau un agent IA ?
Les agents à exécution longue ne devraient pas tout retenir. Cet article propose un modèle de cycle de vie pratique pour décider de ce qui a sa place dans la mémoire durable, de ce qui devrait être récupéré à nouveau, de ce qu'il est plus sûr de recalculer et de ce qui devrait expirer ou être remplacé.
La frontière de validité des réponses : la couche manquante entre la pertinence et les réponses fiables de l'IA
Une source peut être pertinente, faisant autorité et pourtant être erronée pour la question posée. La couche manquante est l'applicabilité : les conditions dans lesquelles une réponse est valable, et les changements qui obligent à la reconsidérer. Cet article présente la Frontière de Validité de la Réponse comme un modèle de conception de source pour les humains, la recherche par IA et les systèmes RAG.
Quectel RM500U-EA dans le ZBT Z8102AX : bandes 5G, o2 Allemagne et comportement du signal en conditions réelles
Le ZBT Z8102AX utilise un modem Quectel RM500U-EA pour la connectivité 4G et 5G. Lors du premier test pratique, le routeur s'est connecté avec succès à o2 Germany avec la bande LTE 3 et la NR n28. Le modem fonctionne, mais des diagnostics plus approfondis tels que le RSRP, le RSRQ, le SINR, le verrouillage de bande et le comportement des cellules nécessitent encore des tests appropriés.
Transition de la pile graphique Ubuntu : Plantages au démarrage avec GPU hybride, risques liés à Wayland et pratiques de déploiement stable
Les mises à niveau du bureau Ubuntu peuvent déclencher des blocages au démarrage, des sessions de connexion manquantes et un rendu instable—surtout sur les systèmes hybrides Intel + NVIDIA. Cet article explique la transition sous-jacente de la pile graphique, pourquoi les régressions se produisent et comment déployer Ubuntu en toute sécurité en utilisant les bases LTS et des stratégies de pilotes validées.
Agents d'utilisation de l'ordinateur : pourquoi une démonstration réussie peut tout de même être un système peu fiable
Les agents d'utilisation de l'ordinateur peuvent désormais accomplir d'impressionnants flux de travail sur navigateur et sur bureau, mais une seule exécution réussie prouve la capacité—non la fiabilité. Cet article montre comment tester la répétabilité, la robustesse environnementale, le contrôle à long horizon, la conscience de l'état, la vérification des résultats et la gestion sécurisée des objectifs.
D'où un LLM tire-t-il ses données ? Sources de données RAG en Python
Un LLM ne connaît pas magiquement vos fichiers, bases de données ou API. Cette suite pratique de la série sur le RAG montre, avec du Python simple, comment des données externes deviennent des preuves récupérables : des fichiers texte et du SQL à la recherche en texte intégral, aux embeddings, à l'assemblage du contexte et à l'appel final au LLM.

IA en environnement isolé : comment les systèmes d’IA fonctionnent sans accès à Internet ni au cloud
L'IA en environnement isolé exécute des modèles, du RAG et des applications d'IA à l'intérieur d'un domaine de sécurité isolé, sans dépendance à Internet ni au cloud. Découvrez comment les modèles, les données, les mises à jour et les outils fonctionnent hors ligne.
Tendances Linux émergentes en 2026 : façonner l'avenir de l'infrastructure serveur
Explorez les principales tendances Linux de 2026, de la domination de Kubernetes et des distributions immuables à l'intégration de l'IA et à la sécurité eBPF.
Qu'est-ce qu'un architecte de solutions IA ? Limites du système, responsabilités et compromis
Un architecte de solutions d'IA transforme les exigences métier en un système d'IA prêt pour la production, couvrant les données, les modèles, les outils, la sécurité, l'exécution, l'évaluation et les opérations.
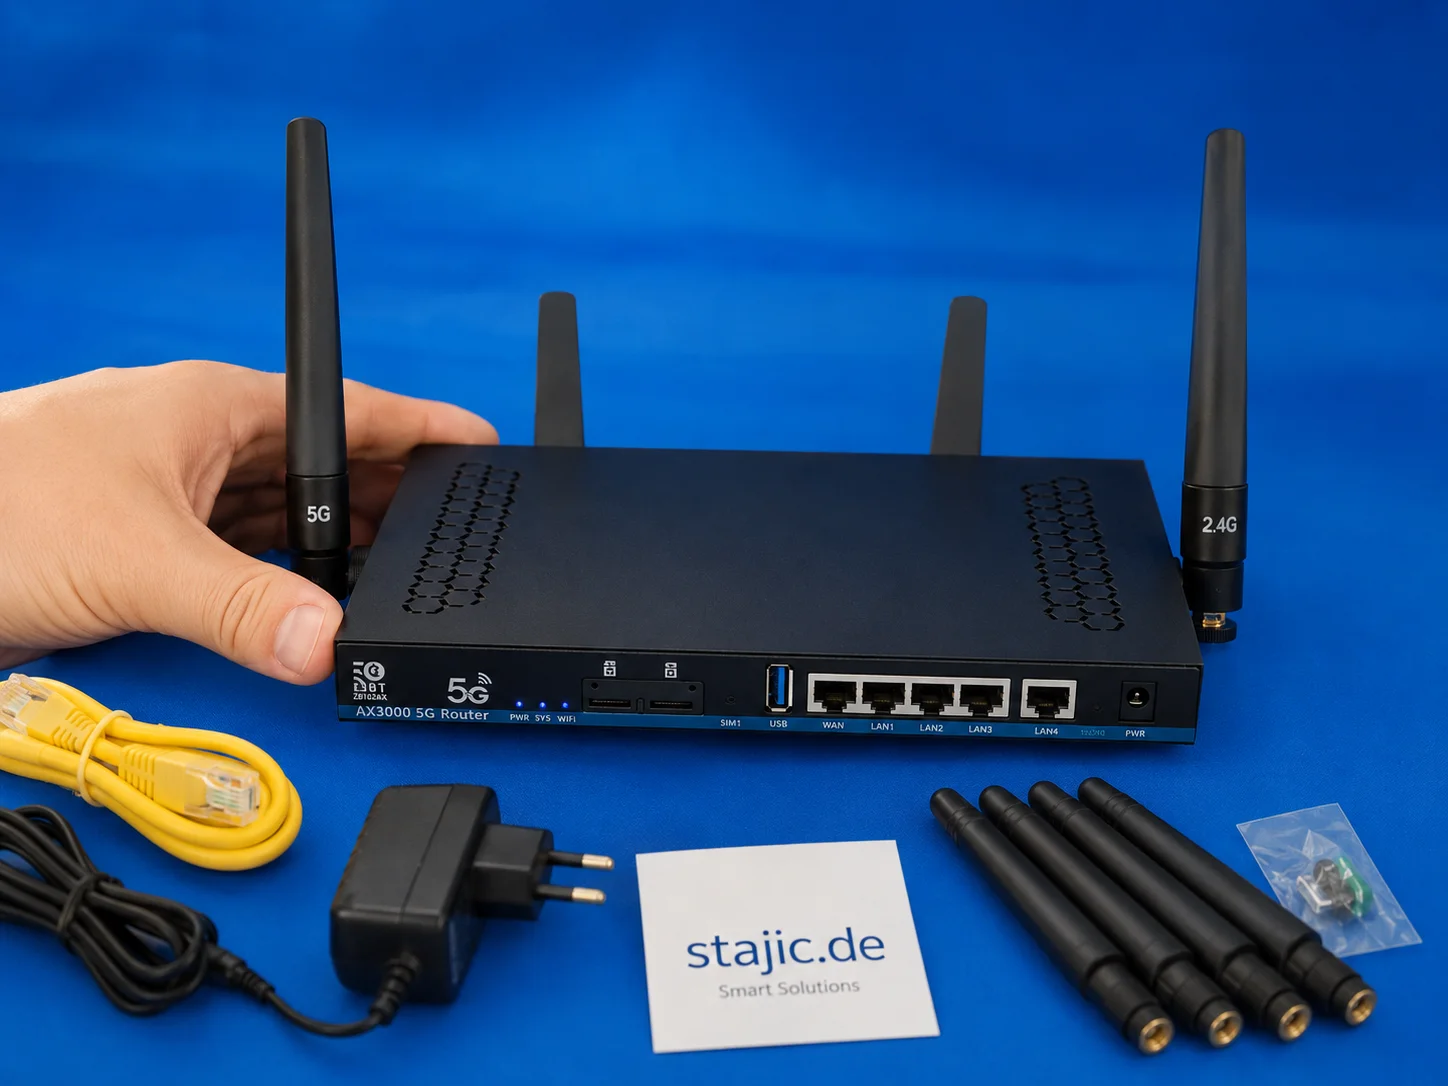
Test du routeur 5G OpenWrt ZBT Z8102AX : Double SIM, RM500U-EA et une évaluation honnête
Le ZBT Z8102AX est un routeur 5G atypique avec une base OpenWrt, un concept double SIM et un modem Quectel RM500U-EA. Lors des tests, il montre des points forts évidents en matière de flexibilité, d'interfaces et de connectivité mobile, mais aussi les faiblesses typiques d'une version d'OpenWrt modifiée par le fabricant.
Qu'est-ce que le RAG ? L'explication la plus simple de son fonctionnement
Le RAG semble compliqué, mais l'idée est simple : avant qu'une IA ne réponde, elle recherche d'abord des informations utiles dans une source de connaissances et transmet ces informations au modèle de langage. Ce guide explique le RAG, les LLM, l'état, la mémoire et les outils à l'aide d'un modèle mental simple.
Quand une IA devrait-elle cesser de faire confiance à ses propres connaissances ? — Le déclencheur de récupération
Un modèle d'IA n'a pas besoin de récupération pour chaque question. Le problème important est de savoir quand ses connaissances internes ne suffisent plus. Le Déclencheur de Récupération est une frontière de décision pratique qui détermine quand un système d'IA devrait cesser de se fier uniquement aux connaissances du modèle et obtenir des preuves externes avant de répondre.