
Falsación para el razonamiento de IA: De respuestas a hipótesis comprobadas
Un modelo de lenguaje puede producir evidencia de apoyo para un número sorprendentemente grande de explicaciones plausibles.
Esa capacidad es útil para la exploración, pero peligrosa como método de validación. Si el modelo parte de una hipótesis y la tarea consiste simplemente en explicar por qué podría ser correcta, puede surgir una respuesta coherente mucho antes de que la hipótesis haya superado una prueba seria.
Por lo tanto, un razonamiento de IA fiable requiere una pregunta más fuerte:
¿Qué evidencia haría fallar esta hipótesis?
Este artículo desarrolla el razonamiento orientado a la falsación como la siguiente capa de la metodología presentada en Más allá de la ingeniería de prompts: una metodología para un razonamiento de IA más fiable. El artículo anterior, Invariancia del prompt: ¿sobrevive la conclusión al prompt?, comprueba si una conclusión sobrevive a cambios en el encuadre. La falsación aborda un problema diferente: si la hipótesis sobrevive a evidencia que podría contar en su contra.
La invariancia del prompt prueba la dependencia del encuadre. La falsación prueba la vulnerabilidad a la evidencia.
Por qué la confirmación es demasiado fácil
Supongamos que se le da a un sistema de IA una hipótesis y se le pide determinar si es plausible.
El modelo puede buscar en su conocimiento, en documentos proporcionados o en fuentes recuperadas observaciones compatibles con esa hipótesis. Si se encuentran suficientes observaciones compatibles, la explicación resultante puede volverse cada vez más persuasiva.
Pero la compatibilidad es evidencia débil cuando varias hipótesis competidoras predicen la misma observación.
Consideremos un caso abstracto:
La observación E es compatible con la hipótesis H1.
Esa afirmación por sí sola no establece H1. Si H2, H3 y H4 también predicen E, entonces E hace poco para distinguir entre ellas.
La evidencia se vuelve más informativa cuando las explicaciones competidoras hacen predicciones diferentes sobre lo que deberíamos observar.
Esto desplaza el proceso de razonamiento desde la recopilación de hechos de apoyo hacia el diseño de pruebas discriminatorias.
La idea clásica detrás de la falsación
El falsacionismo de Karl Popper enfatizó una asimetría entre verificación y refutación. Observaciones repetidas compatibles con una afirmación universal no pueden probar lógicamente que esa afirmación sea verdadera, mientras que una observación genuinamente incompatible puede entrar en conflicto directo con ella.
En forma lógica simplificada:
Si H es verdadera, debería ocurrir la observación O. O no ocurre. Por lo tanto, H, tal como se afirma bajo las condiciones de la prueba, queda cuestionada.
Una hipótesis útil debe asumir un riesgo: alguna evidencia posible debe ser menos compatible con ella que con sus alternativas.
La falsación es más complicada en la práctica
H + A1 + A2 + A3 → observación esperada O
Razonamiento orientado a la falsación para LLM
No preguntes únicamente qué respalda a H. Pregunta qué debería existir si H es verdadera, qué debería ser difícil de explicar si H es verdadera y qué alternativa explica mejor la misma evidencia.
Paso 1 — Formular la hipótesis con precisión
Una hipótesis no puede someterse a una prueba significativa si es lo suficientemente vaga como para absorber cualquier resultado.
Compárese:
El sistema es inestable porque algo en la capa de red está mal.— Hipótesis débil
con:
Los fallos intermitentes de la API son causados por el proxy inverso que cierra las conexiones ascendentes cuando se supera el tiempo de espera configurado.— Hipótesis comprobable
La segunda afirmación se expone a pruebas concretas. Podemos inspeccionar los valores de tiempo de espera, la duración de las conexiones, los registros del proxy, el comportamiento ascendente y los fallos que ocurren por debajo del umbral configurado.
Cuanto más precisamente defina una hipótesis la relación que afirma, más fácil será determinar qué evidencia contaría en su contra.
Paso 2 — Generar hipótesis competidoras genuinas
Probar una sola hipótesis de forma aislada es débil porque casi toda observación se interpreta en relación con algo más.
Por lo tanto, el sistema debería construir alternativas creíbles antes de evaluar la evidencia.
Para el mismo fallo de la API, las explicaciones candidatas podrían incluir:
- H1: tiempo de espera del proxy inverso;
- H2: caída o reinicio de la aplicación ascendente;
- H3: agotamiento de las conexiones a la base de datos;
- H4: interrupción de la red o pérdida de paquetes;
- H5: tiempo de espera del lado del cliente;
- H6: interacción entre varias capas en lugar de una única causa aislada.
Las alternativas deben ser lo suficientemente plausibles como para competir. Generar alternativas obviamente inferiores solo crea la apariencia de un razonamiento crítico.
Una hipótesis no ha sobrevivido a la competencia si las alternativas fueron diseñadas para perder.
Paso 3 — Derivar observaciones esperadas
Para cada hipótesis seria, el modelo debería derivar las observaciones esperadas bajo esa explicación.
Si H1 es la hipótesis del tiempo de espera del proxy inverso, las observaciones esperadas podrían incluir fallos agrupados en torno a una duración específica, mensajes de tiempo de espera correspondientes en los registros del proxy, procesos ascendentes saludables en el momento del fallo y la desaparición del fallo tras un cambio controlado del tiempo de espera.
Para H2, una hipótesis de reinicio de la aplicación, esperaríamos un patrón diferente: reinicios de procesos, excepciones, falta de disponibilidad de la aplicación, agotamiento de recursos o eventos de contenedores correlacionados.
El paso importante es derivar estas expectativas antes de interpretar cada observación disponible como apoyo.
Paso 4 — Definir evidencia potencial de refutación
Para cada hipótesis, preguntar qué evidencia la debilitaría materialmente.
¿Qué esperaríamos no observar si esta hipótesis fuera la explicación principal?
Para la hipótesis del tiempo de espera del proxy, los ejemplos incluyen fallos que ocurren muy por debajo del umbral configurado, fallos idénticos al omitir el proxy, ningún evento relevante del lado del proxy, o evidencia de que la aplicación ascendente termina la conexión primero.
Esto cambia el objetivo de búsqueda del modelo.
Búsqueda de confirmación: Encontrar evidencia compatible con H1. Búsqueda de refutación: Encontrar observaciones que H1 predice mal o que H2 predice sustancialmente mejor.
Paso 5 — Preferir pruebas discriminantes
No todas las pruebas son igualmente informativas.
Supongamos que H1 y H2 predicen ambas tasas de error elevadas. Observar otro error proporciona poca discriminación.
Una mejor prueba busca una observación en la que sus predicciones diverjan.
Buena prueba: una observación probable bajo H1 pero improbable bajo H2, o viceversa.
En depuración, omitir el proxy sospechoso puede ser discriminante. En investigación histórica, demostrar una cronología que haga imposible la transmisión directa puede ser fuertemente discriminante. En análisis de productos, observar la misma disminución de la demanda en un mercado de control no afectado por la causa propuesta puede debilitar una explicación causal.
Por lo tanto, la metodología valora la evidencia no solo por su fiabilidad sino también por su capacidad de distinguir entre explicaciones competidoras.
Paso 6 — Buscar activamente contraevidencia
Una vez definidos los posibles falsadores y las observaciones discriminantes, el sistema debería buscarlos activamente.
Este requisito es importante porque los propios modelos de lenguaje pueden exhibir una prueba de hipótesis sesgada hacia la confirmación.
En 2026, Jhaveri, GX-Chen, Sucholutsky y Choi adaptaron una tarea clásica de descubrimiento de reglas a once modelos de lenguaje de múltiples familias y escalas de modelos. Los modelos con frecuencia proponían ejemplos que confirmarían su regla actual en lugar de ejemplos diseñados para falsificarla.
La consecuencia fue práctica: la exploración orientada a la confirmación produjo un descubrimiento más lento y menos exitoso de la regla oculta.
Cuando los investigadores fomentaron explícitamente la consideración de contraejemplos, el éxito promedio en el descubrimiento de reglas aumentó del 42% al 56% en los experimentos reportados.
El modelo no necesitaba una nueva base de conocimiento. Necesitaba una mejor estrategia de contrastación de hipótesis.
Esto es directamente relevante para la metodología más amplia: la calidad del razonamiento puede mejorar cuando el proceso de inferencia cambia de la búsqueda de confirmación a la exploración orientada a la falsificación.
Paso 7 — Separar la contradicción del rechazo
Encontrar evidencia en contra de una hipótesis no siempre justifica su rechazo inmediato.
El sistema debería evaluar primero la calidad de la contraevidencia:
- ¿Es fiable la observación?
- ¿La fuente es primaria o indirecta?
- ¿Podría un error de medición o de recuperación explicar el conflicto?
- ¿La hipótesis predice realmente la observación en disputa?
- ¿La contradicción depende de una suposición auxiliar?
- ¿La contraevidencia está corroborada de forma independiente?
- ¿Una hipótesis competidora explica la evidencia con más éxito?
Solo después de esta evaluación debería el modelo determinar si la hipótesis queda debilitada, sustancialmente revisada o rechazada.
Paso 8 — Evitar el rescate ad hoc
Una hipótesis puede volverse efectivamente infalsable si cada observación contradictoria produce una nueva excepción.
El patrón es el siguiente:
La predicción falla → añadir excepción → la predicción falla de nuevo → añadir otra excepción → mantener la conclusión original indefinidamente
No toda modificación es ilegítima. El progreso científico y técnico ocurre con frecuencia porque una evidencia inesperada revela una variable faltante o una suposición auxiliar incorrecta.
La distinción metodológica es si la revisión crea nuevas consecuencias contrastables o simplemente protege la conclusión preferida del fracaso.
Una revisión productiva aumenta la precisión explicativa y predictiva. Un rescate ad hoc solo disminuye la probabilidad de que la hipótesis pueda perder alguna vez.
Paso 9 — Actualizar la confianza en lugar de defender la respuesta inicial
El resultado de un razonamiento orientado a la falsación no tiene que ser binario.
Los estados posibles incluyen:
- Fuertemente respaldada: sobrevive a pruebas discriminatorias serias y las explicaciones competidoras rinden sustancialmente peor.
- Provisionalmente respaldada: la mejor explicación disponible, pero persisten incertidumbres importantes.
- Debilitada: existe contraevidencia material, pero no es decisiva.
- Subdeterminada: varias hipótesis explican la evidencia actual igual de bien.
- Rechazada: evidencia fiable entra en conflicto con una predicción central y las explicaciones alternativas rinden mejor.
- No comprobable con la evidencia disponible: el corpus actual no puede discriminar de manera significativa entre las afirmaciones.
La regla central es simple: la confianza debe seguir el resultado de las pruebas en lugar de la inversión retórica del modelo en su primera respuesta.
Una matriz de falsación
Para el análisis complejo, las hipótesis pueden normalizarse en una matriz de comparación.
| Dimensión | H1 | H2 | H3 |
|---|---|---|---|
| Afirmación central | Definir con precisión | Definir con precisión | Definir con precisión |
| Evidencia esperada | Enumerar predicciones | Enumerar predicciones | Enumerar predicciones |
| Contraevidencia potencial | Definir | Definir | Definir |
| Prueba discriminatoria | Especificar | Especificar | Especificar |
| Observaciones de apoyo | Registrar | Registrar | Registrar |
| Observaciones contradictorias | Registrar | Registrar | Registrar |
| Supuestos auxiliares | Exponer | Exponer | Exponer |
| Estado actual | Reevaluar | Reevaluar | Reevaluar |
La matriz evita un modo de fallo común: aplicar un escrutinio riguroso a las alternativas mientras se permite que la hipótesis preferida permanezca vaga.
La evidencia negativa requiere un cuidado especial
La ausencia de la evidencia esperada puede debilitar una hipótesis, pero solo bajo condiciones específicas.
La afirmación 'no encontramos evidencia de X' no equivale a 'X no ocurrió'.
La evidencia negativa se vuelve informativa cuando existe una expectativa justificada de que la evidencia probablemente sería observable, preservada, registrada, documentada o medible si la hipótesis fuera verdadera.
La ausencia de evidencia importa más cuando la evidencia no debería estar ausente.
En la depuración, la ausencia de un evento de registro requerido puede ser significativa si se sabe que el registro está completo. En la investigación histórica, la ausencia en un archivo fragmentario suele ser mucho más débil. En el análisis de seguridad, la ausencia de una alerta tiene poco valor si la telemetría relevante nunca se recopiló.
Por lo tanto, el modelo debe evaluar tanto la evidencia faltante como la probabilidad de que dicha evidencia hubiera sobrevivido o hubiera sido observable.
Investigación histórica: transmisión versus similitud
La investigación histórica ilustra por qué el razonamiento orientado a la falsación debe ser específico de cada dominio.
Supongamos que dos tradiciones contienen ideas conceptualmente similares y la hipótesis inicial propone una transmisión directa.
Apoyar la similitud no es suficiente. La hipótesis debería generar expectativas adicionales: compatibilidad cronológica, contacto geográfico plausible, intermediarios, rastros textuales o terminológicos, evidencia documental o un patrón de transformación consistente con la transmisión.
Las observaciones potencialmente dañinas podrían incluir una cronología que invierta la dirección propuesta, un aislamiento geográfico incompatible con el mecanismo alegado, ejemplos independientes anteriores en ambas tradiciones, o evidencia de que la supuesta característica compartida apareció solo en reinterpretaciones mucho más tardías.
Ninguna ausencia única falsa necesariamente la transmisión histórica. Pero varios fallos independientes pueden reducir su ventaja explicativa en relación con la convergencia o la herencia indirecta.
Depuración de software: del sospechoso a la causa raíz
La depuración se beneficia naturalmente de la falsación porque el objetivo no es crear una narrativa plausible en torno a un mensaje de error. Es aislar el mecanismo que produce el fallo.
Un bucle de depuración útil es:
Síntoma → causas candidatas → observaciones previstas → prueba discriminante → eliminar causas → reproducir → causa raíz
Una hipótesis se vuelve más fuerte no porque se pueda escribir más prosa a su favor, sino porque las alternativas realistas fallan pruebas que ella supera.
Arquitectura de software: falsar una decisión de diseño
Las decisiones de arquitectura generalmente no pueden falsarse en el sentido científico estricto, pero pueden someterse a un análisis orientado a la falsación.
Supongamos que la hipótesis es:
Se requiere una arquitectura de microservicios para satisfacer los requisitos de escalabilidad y organizativos del sistema.
En lugar de enumerar los beneficios de los microservicios, el análisis debería preguntar qué haría innecesaria la afirmación.
Si las pruebas de carga realistas muestran que un monolito modular satisface la escala esperada, si no se requiere independencia de despliegue y si la complejidad operativa se convierte en el costo dominante, la afirmación original se ha debilitado materialmente.
El objetivo no es falsar los microservicios como tecnología. Es probar la afirmación arquitectónica específica bajo las restricciones del proyecto.
Estrategia: ¿Qué haría que la tesis de negocio fuera errónea?
La estrategia de negocio sufre frecuentemente de confirmación porque la evidencia puede interpretarse a posteriori.
Un proceso más sólido define criterios de fracaso antes de la ejecución.
Si una tesis de producto predice que un segmento objetivo pagará por una capacidad particular, la metodología debería definir qué comportamiento observable debilitaría esa afirmación: baja conversión tras una exposición cualificada, rechazo repetido por la misma razón, incapacidad de sostener un precio objetivo o evidencia de que los clientes resuelven el problema mediante un flujo de trabajo alternativo.
Una estrategia se vuelve más comprobable cuando sus criterios de éxito van acompañados de criterios de fracaso explícitos.
La falsación no es lo mismo que abogar por el diablo
Un modelo al que se le instruye 'argumenta en contra de esta conclusión' siempre puede generar objeciones.
Eso aún no es falsación.
Abogar por el diablo optimiza la oposición. El razonamiento orientado a la falsación optimiza las pruebas informativas.
Un buen contraargumento suena plausible. Una buena prueba de falsación tiene un resultado que cambia lo que deberíamos creer.
Esta distinción evita que el proceso de verificación se degrade en un debate artificial en el que un modelo argumenta a favor de una posición y otro automáticamente argumenta en contra.
La falsación y la invariancia de prompt trabajan juntas
La invariancia de prompt y la falsación prueban dependencias diferentes.
| Método | Pregunta principal | Detecta |
|---|---|---|
| Invariancia de prompt | ¿Sobrevive la conclusión a encuadres legítimos alternativos? | Dependencia del encuadre del prompt |
| Falsación | ¿Sobrevive la hipótesis a la evidencia diseñada para desafiarla? | Dependencia de la confirmación y de pruebas débiles |
Una hipótesis puede pasar una prueba y fallar la otra.
Un modelo puede reproducir la misma conclusión incorrecta bajo varias formulaciones de prompt, produciendo una alta estabilidad de encuadre pero una pobre validez probatoria. A la inversa, una hipótesis sólida puede parecer inestable porque diferentes prompts exponen diferentes subconjuntos de evidencia incompleta.
Combinar ambos métodos crea una secuencia más sólida:
Variación de encuadre → hipótesis competidoras → observaciones esperadas → contraevidencia → pruebas discriminantes → actualización de la confianza
No dejes que el mismo agente juzgue su propia prueba sin criterio
Hay otro problema arquitectónico.
Si el mismo modelo genera una hipótesis, diseña la prueba, interpreta la evidencia y decide si la hipótesis sobrevivió, sus errores pueden propagarse por todas las etapas.
Esto no hace que el proceso sea inútil, pero motiva la separación de roles.
Generador de hipótesis → diseñador de pruebas → recuperador de evidencia → crítico → verificador → sintetizador final
Estos roles no requieren necesariamente seis modelos diferentes. Pueden implementarse como pasadas de inferencia aisladas con contexto separado, evidencia controlada y salidas estructuradas.
La propiedad importante es la independencia procedimental: las etapas posteriores no deberían simplemente heredar el compromiso retórico de la respuesta original.
Esto se convierte en el tema técnico de Diseñar una capa de verificación epistémica para LLM.
Un flujo de trabajo de IA orientado a la falsación general
Problema → normalización de evidencia → hipótesis competidoras → predicciones → falsadores potenciales → pruebas discriminantes → búsqueda de contraevidencia → verificación de supuestos auxiliares → comparación de hipótesis → recalibración de confianza → conclusión
Este flujo de trabajo no requiere que cada tarea se comporte como ciencia de laboratorio.
En cambio, extrae un principio epistémico general de la falsación: las explicaciones deben exponerse a condiciones bajo las cuales puedan perder.
El validador exacto entonces cambia según el dominio.
El análisis histórico prueba la cronología, la procedencia y la transmisión. La depuración prueba el comportamiento observable del sistema. La arquitectura prueba requisitos y restricciones. La estrategia prueba supuestos de mercado y criterios de fallo predefinidos.
Este núcleo independiente del dominio y sus validadores específicos de dominio se desarrollan más en Del protocolo de investigación al marco general de razonamiento de IA.
Lo que la falsación no puede hacer
- No puede completar evidencia incompleta.
- No puede garantizar que se haya generado la hipótesis alternativa correcta.
- No puede eliminar errores compartidos por el modelo, las fuentes y el proceso de evaluación.
- No puede convertir afirmaciones inherentemente interpretativas en experimentos de laboratorio.
- No puede tratar cada observación faltante como evidencia en contra de una hipótesis.
- No puede identificar automáticamente qué supuesto auxiliar falló cuando se contradice una predicción.
- No puede probar como verdadera una hipótesis que sobrevive.
- No puede reemplazar experimentos, fuentes primarias, experiencia de dominio o medición empírica donde estos sean necesarios.
Una hipótesis que sobrevive a intentos repetidos de falsación se describe mejor como corroborada por las pruebas realizadas que como probada.
El principio central
La IA generativa abarata la confirmación.
Dada una proposición suficientemente plausible, un modelo de lenguaje potente generalmente puede producir argumentos, analogías, hechos de apoyo y narrativas coherentes en torno a ella.
Esa es exactamente la razón por la que la confirmación no debería ser la prueba final.
Un proceso de razonamiento confiable no debería preguntar solo por qué una hipótesis podría ser correcta. También debe definir cómo podría estar equivocada la hipótesis.
Por lo tanto, la calidad de una conclusión de IA depende no solo de cuánta evidencia de apoyo puede recuperar el sistema, sino de si se permitió que explicaciones competidoras ganaran.
Eso cambia el papel del modelo.
Ya no es meramente un generador de respuestas.
Se convierte en un participante de un proceso controlado en el que su propia primera explicación es provisional, comprobable y reemplazable.
La respuesta de IA más sólida no es la que tiene más argumentos de apoyo. Es aquella cuyas alternativas más fuertes tuvieron una oportunidad justa de derrotarla.
Contexto de la investigación
La metodología de este artículo adapta ideas de la filosofía de la ciencia y la investigación empírica contemporánea sobre el razonamiento de modelos de lenguaje. El falsacionismo de Karl Popper enfatizó que las afirmaciones científicas deben exponerse a posibles observaciones que entren en conflicto con ellas, mientras que la filosofía de la ciencia posterior dejó claro que la falsación práctica es más complicada que el simple rechazo de una hipótesis tras una observación anómala.
La distinción es importante para los sistemas de IA porque las pruebas reales suelen depender de supuestos auxiliares, la calidad de la evidencia y la interpretación. Por lo tanto, el razonamiento de IA orientado a la falsación utiliza la lógica de la desconfirmación sin pretender que toda afirmación analítica compleja pueda reducirse a un único experimento decisivo.
El estudio de 2026 de Jhaveri, GX-Chen, Sucholutsky y Choi proporciona una motivación empírica directa para este diseño. En once LLM, los autores encontraron una exploración de hipótesis sesgada hacia la confirmación en una tarea interactiva de descubrimiento de reglas. Inducir a los modelos a considerar contraejemplos redujo consistentemente este sesgo y aumentó las tasas promedio de descubrimiento de reglas del 42% al 56%.
Estos hallazgos no demuestran que la metodología completa propuesta aquí haya sido validada experimentalmente como un marco unificado. Respaldan una afirmación más estrecha e importante: las intervenciones explícitas hacia evidencia desconfirmatoria pueden mejorar la exploración de hipótesis de los LLM.
Referencias seleccionadas
- Popper, K. R. — La lógica de la investigación científica. Edición en inglés, 1959.
- Popper, K. R. — Conjeturas y refutaciones: El desarrollo del conocimiento científico. 1963.
- Stanford Encyclopedia of Philosophy — Método científico, secciones sobre prueba hipotético-deductiva y falsacionismo.
- Stanford Encyclopedia of Philosophy — Karl Popper, discusión de enunciados básicos, falsabilidad y complicaciones prácticas de la falsación.
- Jhaveri, A. R., GX-Chen, A., Sucholutsky, I. & Choi, E. — Failing to Falsify: Evaluating and Mitigating Confirmation Bias in Language Models. arXiv:2604.02485, 2026.
Continúa la serie
- Más allá de la ingeniería de prompts: Una metodología para un razonamiento de IA más confiable — el marco metodológico completo.
- El prompt es parte del sesgo — por qué el encuadre y los supuestos del usuario pueden influir en el razonamiento de la IA.
- Invariancia del prompt: ¿Sobrevive la conclusión al prompt? — probar si las conclusiones sobreviven a encuadres ciegos, invertidos y adversariales.
- Del protocolo de investigación a un marco general de razonamiento de IA — convertir la metodología en un proceso de razonamiento independiente del dominio.
Related Articles
El límite de validez de la respuesta: la capa faltante entre la relevancia y las respuestas fiables de la IA
Una fuente puede ser relevante, autorizada y aun así ser incorrecta para la pregunta que se plantea. La capa que falta es la aplicabilidad: las condiciones bajo las cuales una respuesta es válida y los cambios que obligan a reconsiderarla. Este artículo presenta el Límite de Validez de la Respuesta como un patrón de diseño de fuentes para personas, sistemas de búsqueda con IA y sistemas RAG.
Enterprise Start Here: Your Gateway to Operational Excellence
New to our enterprise platform? This guide provides a structured onboarding path, from foundational reference models to actionable playbooks, runbooks, and assessments designed for seamless implementation.

MCP explicado: qué conecta, qué no hace y dónde encaja
El Protocolo de Contexto de Modelo conecta aplicaciones de IA con herramientas, recursos y prompts externos a través de un límite estándar cliente-servidor. Aprende qué hace MCP, qué no hace y dónde encaja en la arquitectura de agentes.
Bases de datos vectoriales, embeddings y reranking: tres partes diferentes de la recuperación
Las incrustaciones representan el significado, las bases de datos vectoriales recuperan candidatos y los rerankers refinan los resultados. Aprende en qué se diferencian y cómo trabajan juntas estas tres capas de recuperación en RAG.
La GPU no es el producto: arquitectura de IA privada a prueba de futuro
La infraestructura de IA privada no debe diseñarse en torno a una sola GPU o un solo modelo. Un enfoque más resiliente combina GPUs de inferencia rápida, sistemas de IA ricos en memoria, nodos de IA física y modelos en la nube frontier opcionales detrás de una capa de enrutamiento consciente de las capacidades.
Invarianza del prompt: ¿sobrevive la conclusión al prompt?
Una metodología práctica para comprobar si la conclusión de una IA depende de la forma en que se enmarcó un problema. Prompt Invariance compara formulaciones originales, ciegas, invertidas y adversariales mientras mantiene controlada la estructura de la evidencia.
Transición de la Pila Gráfica de Ubuntu: Fallos de Arranque con GPU Híbrida, Riesgos de Wayland y Prácticas de Despliegue Estable
Las actualizaciones de escritorio de Ubuntu pueden provocar cuelgues de arranque, sesiones de inicio de sesión perdidas y renderizado inestable —especialmente en sistemas híbridos Intel + NVIDIA. Este artículo explica la transición subyacente de la pila de gráficos, por qué ocurren las regresiones y cómo implementar Ubuntu de forma segura utilizando líneas base LTS y estrategias de controladores validadas.
Más allá de la ingeniería de prompts: una metodología para un razonamiento de IA más fiable
Los modelos de lenguaje grandes no necesariamente fallan porque carezcan de capacidad de razonamiento. A menudo fallan porque el proceso de razonamiento no está suficientemente restringido, cuestionado o verificado. Este artículo presenta una metodología independiente del dominio que convierte el prompting en un proceso epistémico estructurado: separar los hechos de las suposiciones, generar hipótesis en competencia, poner a prueba la contraevidencia, aplicar la falsación y comprobar si las conclusiones se mantienen estables bajo enfoques alternativos. El objetivo no es hacer que el modelo "esté menos de acuerdo", sino hacer que sus conclusiones dependan menos del enfoque inicial del usuario.
Arquitectura de IA empresarial: qué cambia cuando la IA entra en una empresa
La arquitectura de IA empresarial explica cómo la IA cambia los sistemas de la empresa en materia de autoridad sobre los datos, identidad, permisos, proveedores, riesgo, gobernanza, evaluación, cumplimiento y operaciones.
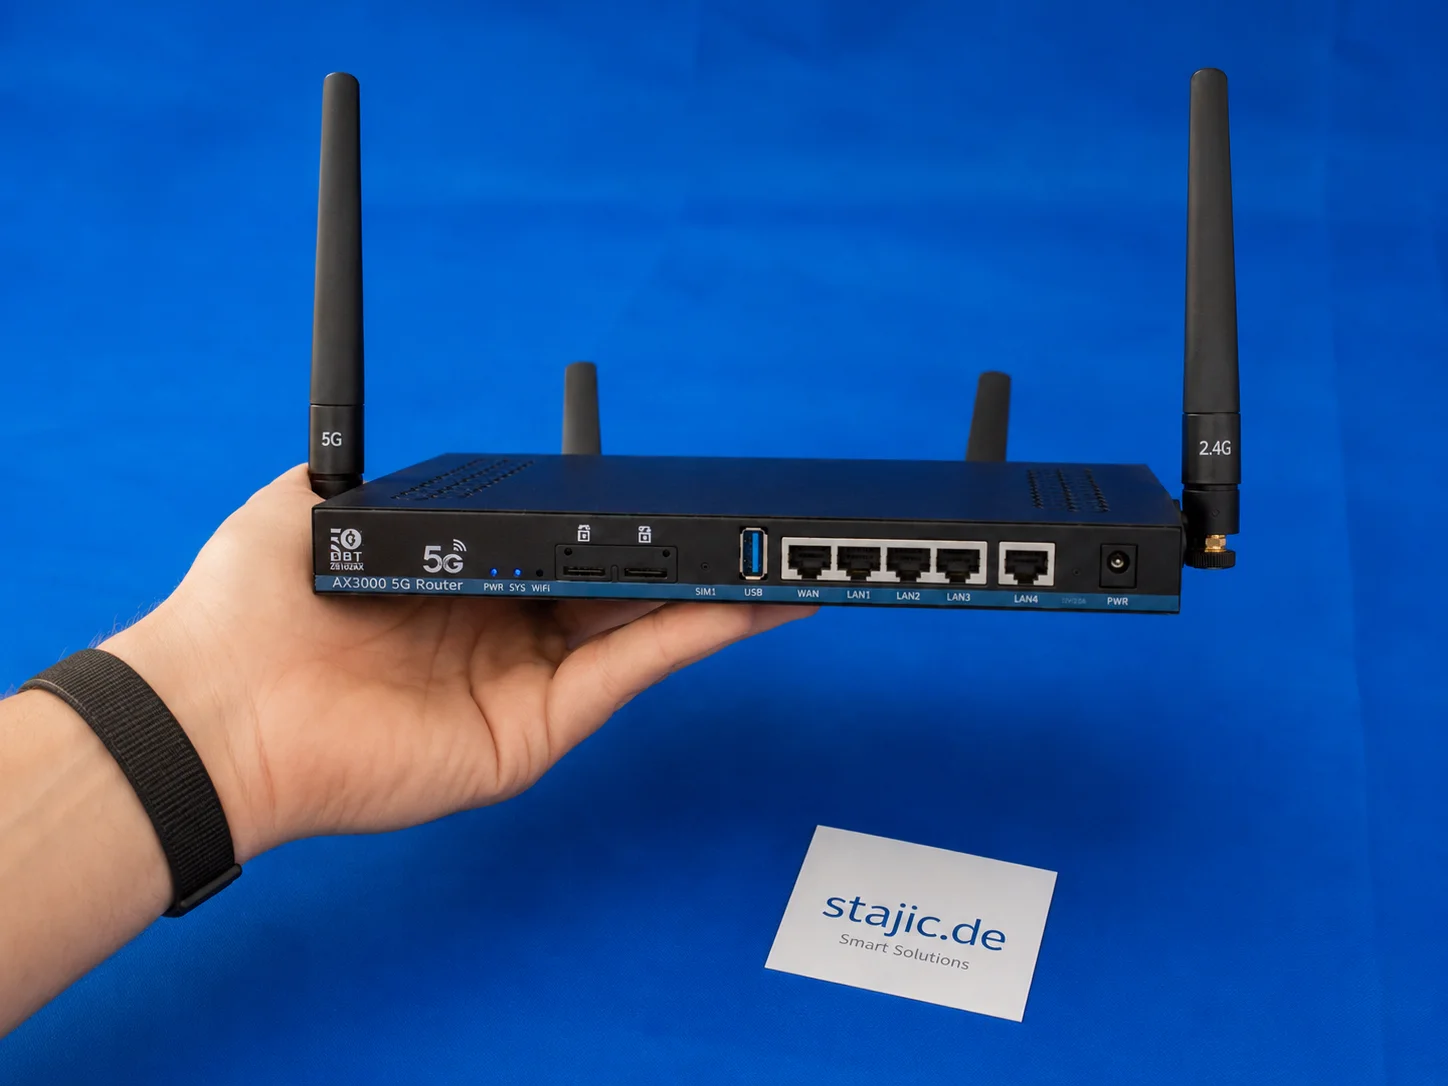
¿Deberías Comprar un Router OpenWrt 5G con Firmware Antiguo? El ZBT Z8102AX como Ejemplo Práctico
Comprar un router 5G OpenWrt con firmware antiguo puede tener sentido, pero solo bajo las condiciones adecuadas. El ZBT Z8102AX muestra claramente ambos lados: el hardware es útil, el módem funciona y el router se mantuvo estable en las pruebas, pero OpenWrt 21.02, el embalaje débil y las rutas de actualización poco claras requieren una decisión de compra cuidadosa.
MCP vs A2A vs UCP vs AP2 vs A2UI: La pila de protocolos de agentes explicada
MCP, A2A, UCP, AP2 y A2UI a menudo se presentan como estándares de agentes competidores. En su mayoría, resuelven diferentes problemas de interoperabilidad. Esta guía mapea cada protocolo con el límite que realmente estandariza—y muestra cómo pueden funcionar juntos en un sistema de producción.
Nuevo Qwen 3.5-Plus: La IA de código abierto se ha puesto seria
Descubre las características y beneficios innovadores de Qwen 3.5-Plus de Alibaba, una IA de código abierto que cambia las reglas del juego para desarrolladores.