
Más allá de la ingeniería de prompts: una metodología para un razonamiento de IA más fiable
La ingeniería de prompts suele tratarse como el arte de hacer mejores preguntas a un modelo. Eso es útil, pero aborda solo una parte del problema. Un prompt bien redactado puede mejorar la relevancia, la estructura y el cumplimiento de la tarea sin hacer que la conclusión resultante sea epistémicamente robusta.
El problema más profundo es que un modelo de lenguaje grande no razona independientemente del prompt que lo activa. La redacción, el encuadre, el orden, los supuestos incorporados en la solicitud y la posición expresada explícitamente por el usuario pueden influir en qué partes del conocimiento interno del modelo se vuelven dominantes en la respuesta generada.
Esto significa que mejorar el razonamiento de la IA requiere más que mejores instrucciones. Requiere una metodología que trate el propio prompt como una posible fuente de sesgo y someta la conclusión del modelo a una verificación estructurada.
El objetivo no es hacer que el modelo sea más inteligente. El objetivo es utilizar con mayor rigor la inteligencia que ya tiene disponible.
La capacidad no es lo mismo que la disciplina de razonamiento
Los modelos de razonamiento modernos pueden descomponer tareas complejas, comparar alternativas, inspeccionar evidencia, identificar contradicciones y revisar conclusiones. Pero tener estas capacidades no implica que cada respuesta las utilice automáticamente todas.
Un asistente de IA de propósito general tiene que operar en tareas y usuarios radicalmente diferentes. Un usuario quiere un cálculo. Otro quiere que se reescriba un mensaje corto. Otro quiere depuración de software. Otro espera una investigación histórica o científica. Aplicar un protocolo máximo de contraste de hipótesis a cada solicitud aumentaría con frecuencia la latencia, la verbosidad y la carga cognitiva sin mejorar la utilidad real de la respuesta.
En consecuencia, la pregunta central no es simplemente si un modelo puede realizar un razonamiento riguroso. La pregunta más importante es bajo qué condiciones esa capacidad se activa, se cuestiona y se verifica de manera sistemática.
El prompt no es una interfaz neutral
La investigación ha demostrado repetidamente que características aparentemente secundarias de los prompts pueden influir en las salidas del modelo. Se ha demostrado que el orden de los prompts, las etiquetas, el encuadre y las solicitudes de justificación producen artefactos metodológicos medibles. Investigaciones separadas sobre la adulación han mostrado que los modelos de lenguaje a veces pueden adaptar sus respuestas hacia las posiciones expresadas por el usuario en lugar de mantener una evaluación completamente independiente.
Esto no significa que cada modelo simplemente esté de acuerdo con su usuario, ni que cada prompt contamine cada conclusión. Significa algo más preciso: el prompt forma parte del entorno de inferencia. Por lo tanto, una conclusión obtenida bajo un encuadre no puede asumirse automáticamente como invariante bajo otro.
Las consecuencias de esa distinción se examinan por separado en El prompt es parte del sesgo, donde el encuadre del prompt, el seguimiento de instrucciones y el comportamiento de acuerdo del modelo se tratan como un problema metodológico y no meramente como un problema de prompting.
De la ingeniería de prompts a un proceso epistémico
La ingeniería de prompts tradicional optimiza principalmente la entrada. La metodología propuesta aquí, en cambio, estructura el camino completo desde la pregunta hasta la conclusión.
Una forma simplificada de ese proceso puede representarse como:
Problema → descomposición → evidencia → hipótesis en competencia → contraevidencia → intentos de falsación → síntesis → verificación del encuadre → conclusión calibrada
La diferencia importante es que la primera respuesta coherente ya no se trata como el punto final. Se convierte en una conclusión candidata que debe sobrevivir a pruebas adicionales.
1. Separar la evidencia de la interpretación
El primer requisito es evitar que las observaciones, las interpretaciones y las suposiciones colapsen en una sola narrativa. Un modelo debería distinguir explícitamente lo que está directamente respaldado de lo que se infiere.
- Evidencia: información directamente respaldada por una fuente, observación, medición, registro, documento o resultado reproducible.
- Interpretación: una explicación derivada de la evidencia.
- Suposición: una proposición actualmente requerida por el proceso de razonamiento pero que aún no ha sido establecida de forma independiente.
- Pregunta abierta: una incertidumbre relevante para la cual la evidencia disponible es insuficiente.
Esta separación es simple, pero tiene una consecuencia importante: la incertidumbre se vuelve visible antes de ser absorbida por la narrativa final.
2. Generar hipótesis competidoras
Una explicación sólida no se establece simplemente porque la evidencia pueda interpretarse a su favor. El modelo debería construir alternativas creíbles y preguntar si la misma evidencia también puede ser explicada por ellas.
En la investigación histórica, esto podría significar distinguir transmisión directa, transmisión indirecta, convergencia independiente e interpretación retrospectiva. En la depuración de software puede significar separar un fallo de red, un error de configuración, un error de aplicación y un fallo de un servicio externo. En el análisis empresarial puede significar comparar múltiples explicaciones causales para la misma señal de mercado.
Las etiquetas cambian entre disciplinas. El principio metodológico no.
3. Buscar evidencia que podría hacer fracasar la explicación preferida
La confirmación es comparativamente fácil. Dada una hipótesis plausible, tanto los humanos como los modelos de lenguaje a menudo pueden encontrar hechos que parecen compatibles con ella. Una prueba más exigente pregunta qué evidencia debería existir si la hipótesis fuera verdadera, qué evidencia no debería existir y qué observación la debilitaría significativamente.
Trabajos experimentales recientes sobre el sesgo de confirmación en modelos de lenguaje respaldan la importancia de este paso. Cuando se permite a los modelos probar hipótesis libremente, pueden preferir pruebas confirmatorias sobre las falsadoras. Se ha demostrado que las intervenciones explícitas que fomentan contraejemplos y pruebas refutatorias mejoran el descubrimiento de hipótesis.
El papel completo de la falsación y la contraevidencia en esta metodología se desarrolla en Falsación para el razonamiento de IA: de respuestas a hipótesis probadas.
4. Preservar la procedencia y la distancia causal
No toda la información de apoyo tiene el mismo valor probatorio. Un documento primario, una interpretación secundaria, una cita posterior, un resumen sin fuente y una paráfrasis generada por un modelo no pueden tratarse como intercambiables solo porque contengan afirmaciones similares.
Por lo tanto, un proceso riguroso preserva el camino entre la fuente y la conclusión. Cuando sea posible, la cadena de razonamiento debería permanecer inspeccionable:
Conclusión → interpretación → evidencia de apoyo → fuente
Luego se pueden añadir validadores específicos del dominio. La investigación histórica requiere cronología, plausibilidad geográfica, procedencia y posibles canales de transmisión. La arquitectura de software requiere restricciones, compatibilidad, rendimiento, mantenibilidad y modos de fallo. El análisis científico requiere diseño experimental, calidad de medición, reproducibilidad y explicaciones causales alternativas.
5. Probar si la conclusión sobrevive al prompt
La extensión más importante es tratar el propio prompt como una variable.
Uso aquí el término invariancia de prompt para una prueba práctica: ¿permanece estable la conclusión esencial cuando la misma evidencia se examina bajo formulaciones de prompt materialmente diferentes pero legítimas?
Una implementación útil puede contener al menos cuatro pasadas:
- Pasada original: analizar el problema tal como se formuló inicialmente.
- Pasada ciega: eliminar la explicación preferida del usuario y preguntar qué hipótesis respalda la evidencia.
- Pasada invertida: tratar una hipótesis opuesta creíble como la proposición de partida y contrastarla con la misma evidencia.
- Pasada adversarial: construir deliberadamente el desafío basado en evidencia más fuerte contra la conclusión actual.
El objetivo no es forzar cuatro respuestas idénticas. Las diferencias legítimas de formulación pueden exponer supuestos previamente ocultos. La señal relevante es qué hallazgos fácticos, vínculos causales y juicios de confianza sobreviven entre las distintas formulaciones.
Por lo tanto, la invariancia de prompt no debe confundirse con prueba fáctica. Se entiende mejor como una prueba de robustez frente a una clase específica de dependencia metodológica: la dependencia excesiva de la formulación original.
El concepto y sus limitaciones se desarrollan en detalle en Prompt Invariance: Does the Conclusion Survive the Prompt?.
6. Calibrar la conclusión en lugar de forzar la certeza
Una metodología diseñada para resistir el sesgo de confirmación debe permitir que el estado final permanezca incierto. El proceso ha fallado si toda investigación debe terminar en un sí o un no con confianza.
Los resultados posibles incluyen apoyo fuerte, apoyo moderado, apoyo débil, competencia no resuelta entre hipótesis, evidencia insuficiente o evidencia inconsistente con la proposición original. El requisito importante es que la confianza siga la calidad y la estructura de la evidencia, y no la coherencia retórica de la respuesta generada.
Un núcleo independiente del dominio con validadores específicos del dominio
La metodología se vuelve especialmente visible en tareas de investigación porque la investigación expone naturalmente problemas de evidencia, interpretación y explicaciones en competencia. Pero su núcleo no se limita al trabajo histórico o académico.
La misma estructura general puede aplicarse a la depuración, la arquitectura de software, la estrategia de producto, la diligencia debida técnica, la gestión de proyectos, el análisis de seguridad y otros dominios en los que una primera respuesta plausible puede ser sustancialmente más débil que una conclusión probada.
Lo que cambia es la capa de validación. El núcleo epistémico permanece en gran medida estable mientras cada dominio aporta sus propias reglas para determinar qué cuenta como evidencia fuerte, un mecanismo causal plausible o una prueba de falsación significativa.
Esta transición de un protocolo de investigación a un marco de razonamiento reutilizable es el tema de From Research Protocol to General AI Reasoning Framework.
Por qué un modelo de razonamiento no aplica automáticamente el método completo
Sería tentador concluir que los modelos de razonamiento suficientemente avanzados deberían hacer innecesaria esta metodología. Esa conclusión confunde capacidad con comportamiento predeterminado.
Un asistente general no tiene una razón universal para maximizar la verificación epistémica en cada solicitud. Los usuarios difieren en experiencia, objetivos, tiempo disponible, profundidad deseada y tolerancia a la complejidad. Las tareas también difieren radicalmente en el costo de equivocarse.
Para muchas solicitudes, una respuesta directa es el comportamiento de producto correcto. Para otras, especialmente la investigación, la arquitectura, las decisiones de alto impacto y el diagnóstico técnico complejo, la verificación adicional puede mejorar sustancialmente la fiabilidad.
Por lo tanto, la metodología actúa como un cambio deliberado en el objetivo del razonamiento. En lugar de optimizar principalmente para obtener una respuesta útil y coherente, otorga un peso adicional a la robustez epistémica, la trazabilidad y la resistencia al encuadre inicial del usuario.
De la metodología a una capa de verificación epistémica
Una vez expresada como un proceso repetible, la metodología ya no tiene que existir solo como una larga instrucción colocada frente a un modelo de lenguaje. Puede convertirse en parte de una arquitectura de IA.
Diferentes agentes o pasadas de inferencia pueden generar hipótesis, buscar evidencia contradictoria, evaluar fuentes, realizar una revisión adversarial y comparar resultados entre variantes de prompt. La respuesta final puede entonces producirse a partir del estado intermedio verificado en lugar de directamente a partir de la solicitud original del usuario.
Prompt → descomposición → explicaciones candidatas → evidencia → desafío → verificación → síntesis → respuesta
Esta arquitectura y su relación con agentes, sistemas de recuperación e inferencia de múltiples pasadas se desarrollan en Diseño de una capa de verificación epistémica para LLM.
Lo que esta metodología no afirma
Una metodología rigurosa también debería definir sus propios límites.
- No garantiza que el modelo posea el conocimiento necesario.
- No fortalece la evidencia débil o ausente.
- No elimina la alucinación, los efectos de encuadre ni el sesgo del modelo.
- No prueba que una conclusión sea verdadera simplemente porque varias variantes de prompt la produjeron.
- No reemplaza la experiencia en el dominio, las fuentes primarias, los experimentos ni la verificación externa cuando estos son necesarios.
- Aumenta el trabajo computacional, el uso de tokens y la latencia.
- Su propósito es hacer que los errores, las suposiciones y las dependencias sean más fáciles de exponer antes de que se conviertan en conclusiones.
El principio central
La ingeniería de prompts pregunta cómo obtener una mejor respuesta de un modelo.
La metodología descrita aquí plantea una pregunta diferente:
¿Qué proceso debería superar una conclusión de IA antes de que decidamos que la respuesta es lo suficientemente buena como para confiar en ella?
Ese cambio de perspectiva es fundamental. Aleja el enfoque de la optimización de un único prompt y lo orienta hacia el control del proceso de razonamiento que lo rodea.
El prompt sigue siendo importante, pero ya no se trata como un punto de partida incuestionable. Se convierte en una entrada más de un proceso que puede inspeccionar sus suposiciones, desafiar su encuadre y comprobar si la conclusión resultante sobrevive a interpretaciones alternativas.
En términos prácticos, la metodología no intenta crear un modelo más inteligente. Intenta crear un uso más disciplinado de las capacidades existentes del modelo.
Contexto de investigación
Referencias seleccionadas
- Sharma, M. et al. — Towards Understanding Sycophancy in Language Models. arXiv:2310.13548, publicado originalmente en 2023; revisado en 2025.
- Brucks, M. S. & Toubia, O. — Prompt architecture induces methodological artifacts in large language models. PLOS ONE, 2025.
- Jhaveri, A. R., GX-Chen, A., Sucholutsky, I. & Choi, E. — Failing to Falsify: Evaluating and Mitigating Confirmation Bias in Language Models. arXiv, 2026.
Continúa la serie
- El prompt es parte del sesgo — cómo el encuadre, las instrucciones y las suposiciones del usuario influyen en el razonamiento del modelo.
- Invariancia del prompt: ¿sobrevive la conclusión al prompt? — una prueba práctica de robustez mediante formulaciones ciegas, invertidas y adversariales.
- Falsación para el razonamiento de IA: de respuestas a hipótesis contrastadas — contraevidencia, hipótesis competidoras y pruebas desconfirmatorias.
- Del protocolo de investigación a un marco general de razonamiento para IA — aplicación de la metodología más allá de la investigación histórica.
- IA en videojuegos: razonamiento aplicado bajo información incierta — una perspectiva aplicada desde figure.rocks.
Related Articles
Reseña del firmware OpenWrt 21.02 de ZBT Z8102AX: lo suficientemente estable, pero ¿está preparado para el futuro?
El ZBT Z8102AX ejecuta una compilación de OpenWrt 21.02 modificada por el proveedor con el kernel 5.4.246. En las pruebas prácticas, el firmware funcionó correctamente y mantuvo el router estable durante varios días, pero la base antigua plantea preguntas importantes sobre la seguridad, el control del módem, las rutas de actualización y la mantenibilidad a largo plazo.
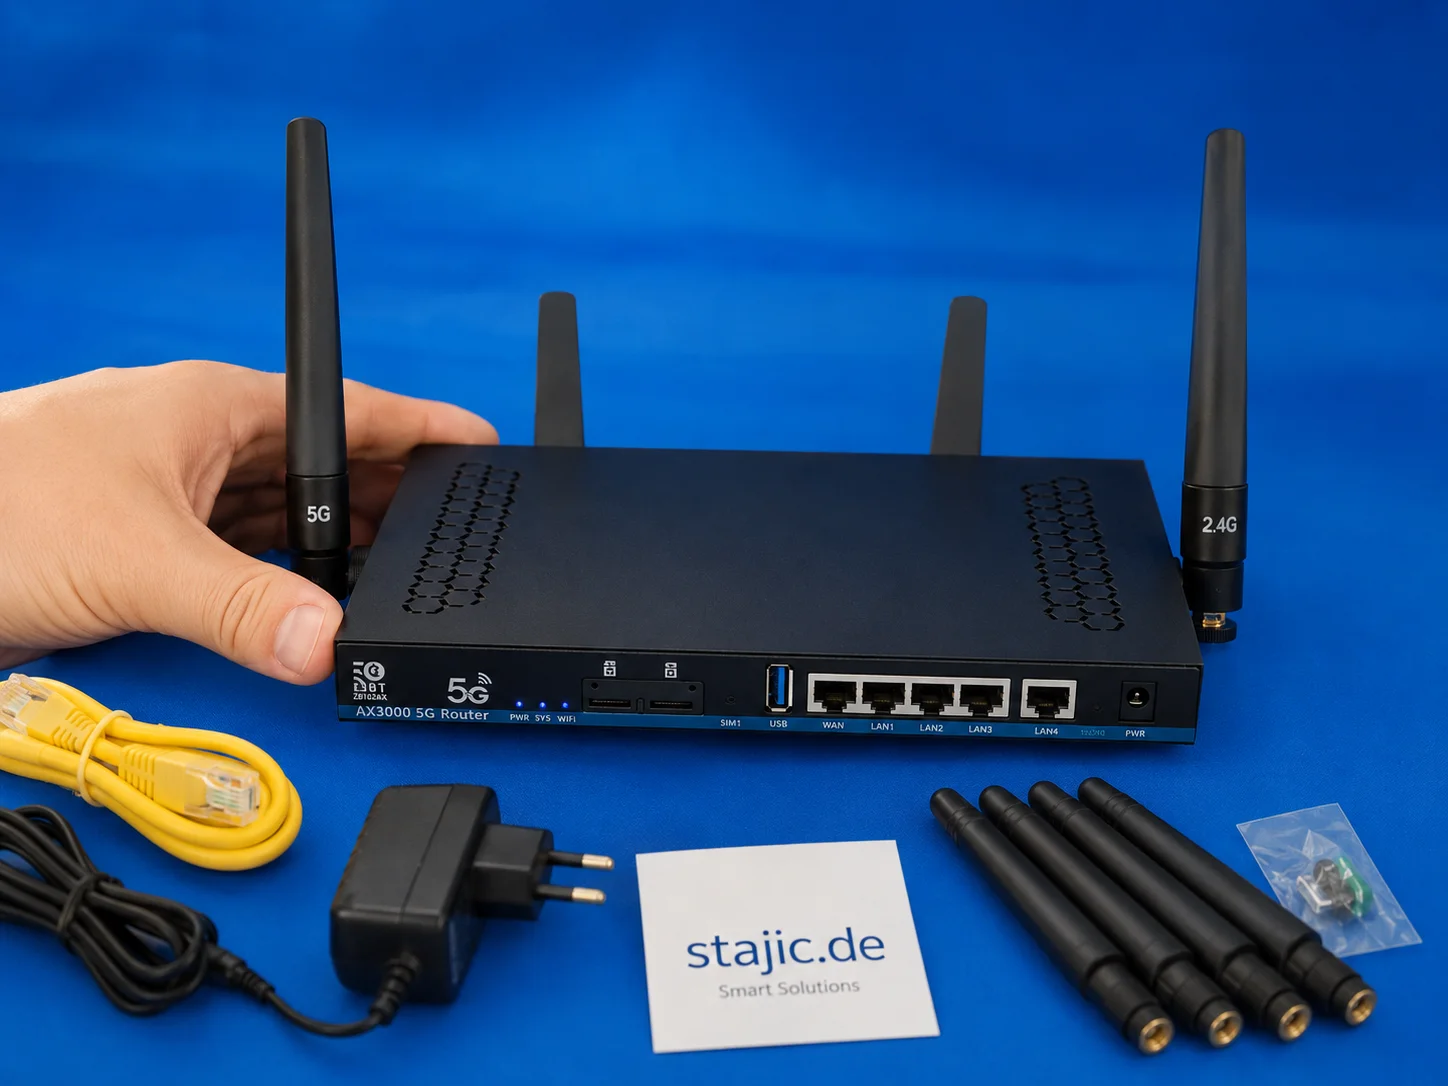
Análisis del router 5G OpenWrt ZBT Z8102AX: doble SIM, RM500U-EA y una valoración honesta
El ZBT Z8102AX es un router 5G inusual con una base OpenWrt, un concepto de doble SIM y un módem Quectel RM500U-EA. En las pruebas, muestra claras fortalezas en flexibilidad, interfaces y conectividad móvil, pero también las debilidades típicas de una compilación de OpenWrt modificada por el fabricante.
Guía Integral de Métricas para Entrega y Gestión del Cambio
Esta guía proporciona una descripción detallada de las métricas esenciales para la entrega empresarial y la gestión del cambio, ayudando a los equipos a medir el rendimiento, optimizar procesos e impulsar la mejora continua. Descubra indicadores clave, métodos de cálculo y mejores prácticas para alinear sus métricas con los resultados empresariales.
De un protocolo de investigación a un marco general de razonamiento de IA
Una metodología desarrollada para la investigación rigurosa asistida por IA puede generalizarse mucho más allá de la propia investigación. Al separar la evidencia de los supuestos, poner a prueba hipótesis competidoras, controlar el encuadre del prompt, buscar contraevidencia y aplicar validadores específicos del dominio, la misma arquitectura de razonamiento puede mejorar la depuración, el diseño de software, la estrategia, el análisis técnico y el soporte a la toma de decisiones asistido por IA.
¿Qué es RAG? La explicación más sencilla de cómo funciona
RAG suena complicado, pero la idea es simple: antes de que una IA responda, primero busca información útil de una fuente de conocimiento y le da esa información al modelo de lenguaje. Esta guía explica RAG, los LLM, el estado, la memoria y las herramientas usando un modelo mental simple.
La GPU no es el producto: arquitectura de IA privada a prueba de futuro
La infraestructura de IA privada no debe diseñarse en torno a una sola GPU o un solo modelo. Un enfoque más resiliente combina GPUs de inferencia rápida, sistemas de IA ricos en memoria, nodos de IA física y modelos en la nube frontier opcionales detrás de una capa de enrutamiento consciente de las capacidades.
RBAC vs Aislamiento de Inquilinos: Dos Límites de Seguridad Diferentes
El RBAC controla lo que un usuario puede hacer; el aislamiento de inquilinos controla a qué recursos de qué inquilino puede llegar esa acción. Descubre por qué la seguridad SaaS multiinquilino requiere ambos límites.
Fiabilidad de los Agentes de IA: Por Qué la Respuesta Final No es Suficiente
Una salida correcta no demuestra un razonamiento correcto, una ejecución segura ni un sistema confiable.
OpenAI Agents API vs Agents SDK vs Responses API: ¿Sobre qué deberías construir en 2026?
El stack de agentes de OpenAI cambió en septiembre de 2026. Esta guía de arquitectura separa la Agents API, el Agents SDK, la Responses API y el Codex SDK por propiedad del runtime—para que los equipos puedan elegir el límite de control adecuado en lugar de comparar nombres de productos.
Ollama no es el producto: Construcción de aplicaciones de LLM abiertos listas para producción
Ejecutar un modelo local con Ollama es fácil. Construir una aplicación Open-LLM lista para producción es más difícil: requiere RAG, control de acceso, abstracción de proveedores, evaluación, registro, disciplina de despliegue y una capa de aplicación controlada alrededor del modelo.
Tendencias emergentes de Linux en 2026: Moldeando el futuro de la infraestructura de servidores
Explora las tendencias clave de Linux de 2026, desde el dominio de Kubernetes y las distribuciones inmutables hasta la integración de IA y la seguridad eBPF.
Google I/O 2026: Gemini Omni, Gemini 3.5 y la capa de cómputo detrás de la IA agéntica
Google I/O 2026 situó a Gemini Omni y Gemini 3.5 en el centro de la estrategia de IA agéntica de Google. Este artículo desglosa la diferencia entre la creación multimodal y la inteligencia de grado de acción, por qué Gemini 3.5 Flash es importante para los agentes y la codificación, y cómo estos modelos impulsan el cambio de plataforma más amplio de Google I/O 2026.