
ComfyUI en Fedora 43: Dos entornos virtuales + Inicio con un solo clic (marzo de 2026)
ComfyUI en Fedora 43: Dos entornos virtuales + Inicio con un solo clic (marzo de 2026)
Fecha: Marzo de 2026
SO: Fedora 43
Objetivo: Mantener dos venvs de Python (ej. 3.12 + 3.14) para compatibilidad, pero iniciar ComfyUI automáticamente con una configuración limpia y ligera.
Sistema Operativo de Entrega Empresarial
Esta guía es parte de la serie Sistema Operativo de Entrega Empresarial. Utilice estos centros de categorías para navegar por el stack completo (infraestructura → flujos de trabajo → gobernanza).
ArquitecturaArquitectura de referencia para el Sistema Operativo de Entrega Empresarial.
DevOps y Tiempo de EjecuciónDespliegues, servicios, puertos, operaciones en tiempo de ejecución y repetibilidad.
Herramientas de IA y AutomatizaciónStack de IA local, orquestación, automatización y flujos de trabajo estables.
Seguridad y CumplimientoPermisos, endurecimiento y valores predeterminados seguros para sistemas de IA locales.
Observabilidad y RendimientoAjuste de rendimiento, monitoreo, presupuesto de VRAM/RAM y estabilidad.
¿Por qué mantener dos venvs?
Las herramientas de IA avanzan rápido. Algunos nodos y wheels se quedan atrás respecto al Python más reciente, mientras que otros lo requieren.
- Python 3.12 venv → “aburrido pero compatible” (TensorRT/LW wheels/Lightning suelen funcionar mejor)
- Python 3.14 venv → funciones más recientes, pero es común encontrar más wheels faltantes o problemas de importación
Regla: nunca mezcles instalaciones entre venvs. Ejecuta siempre ComfyUI desde el venv que pretendas usar.
Configuración: Un script por venv
Crea un pequeño script de lanzamiento que:
1) cambie a la carpeta de ComfyUI
2) active el venv elegido
3) ejecute ComfyUI en localhost
1) Crea un lanzador para el venv de Python 3.12
mkdir -p ~/.local/bin

cat > ~/.local/bin/comfyui-start-312.sh <<'EOF'
#!/usr/bin/env bash
set -euo pipefail

cd /home/x/ai/ComfyUI
source /home/x/ai/ComfyUI/.venv312/bin/activate
exec python main.py --listen 127.0.0.1 --port 8188
EOF

chmod +x ~/.local/bin/comfyui-start-312.sh
2) (Opcional) Crea un lanzador para el venv de Python 3.14
cat > ~/.local/bin/comfyui-start-314.sh <<'EOF'
#!/usr/bin/env bash
set -euo pipefail

cd /home/x/ai/ComfyUI
source /home/x/ai/ComfyUI/.venv/bin/activate
exec python main.py --listen 127.0.0.1 --port 8189
EOF

chmod +x ~/.local/bin/comfyui-start-314.sh
Ahora puedes ejecutar cualquiera de las versiones sin pensarlo:
- ~/.local/bin/comfyui-start-312.sh
- ~/.local/bin/comfyui-start-314.sh
Inicio automático: servicio de usuario systemd (la mejor opción)
Esto inicia ComfyUI al iniciar sesión, se reinicia en caso de error y se mantiene minimalista (sin root, sin envoltorios pesados).
1) Crear el servicio de usuario para 3.12
mkdir -p ~/.config/systemd/user

cat > ~/.config/systemd/user/comfyui312.service <<'EOF'
[Unit]
Description=ComfyUI (Python 3.12 venv)
After=network.target

[Service]
Type=simple
WorkingDirectory=/home/x/ai/ComfyUI
ExecStart=/home/x/.local/bin/comfyui-start-312.sh
Restart=on-failure
RestartSec=2
Environment=PYTHONUNBUFFERED=1

[Install]
WantedBy=default.target
EOF
2) Habilitar + iniciar
systemctl --user daemon-reload
systemctl --user enable --now comfyui312.service
systemctl --user status comfyui312.service --no-pager
3) Registros (depuración)
journalctl --user -u comfyui312.service -f(Si también deseas el servicio 3.14, repite con comfyui314.service y el otro script).
GUI de un solo clic: Lanzador de escritorio (abrir ComfyUI en el navegador)
Esto crea una entrada de aplicación en tu menú. Al hacer clic:
1) inicia el servicio
2) abre la interfaz en tu navegador
mkdir -p ~/.local/share/applications

cat > ~/.local/share/applications/comfyui.desktop <<'EOF'
[Desktop Entry]
Type=Application
Name=ComfyUI (Local)
Comment=Start ComfyUI and open the UI
Exec=sh -lc 'systemctl --user start comfyui312.service; xdg-open http://127.0.0.1:8188'
Icon=utilities-terminal
Terminal=false
Categories=Graphics;AI;
EOF
Notas para evitar errores comunes
- Si ves que pip se instala en ~/.local/..., no estás en el venv correcto (o no lo activaste).
- Si un nodo falla porque falta pkg_resources → instala setuptools dentro del venv elegido:source /home/x/ai/ComfyUI/.venv312/bin/activatepython -m pip install -U pip setuptools wheel
- Los fallos del nodo TensorRT son normales en las versiones más recientes de Python: si no lo necesitas, desactiva esa carpeta de nodos personalizados.
Siguientes lecturas
Si quieres profundizar, estas guías se conectan directamente con la configuración anterior:
Nodos de ComfyUI: correcciones de dependencias (Lightning, pkg_resources, ffmpeg)Corrige fallos comunes en la importación de nodos y mantén tu entorno de ComfyUI estable frente a las actualizaciones.
Dos venvs, dos puertos, cero confusiónEjecuta múltiples instancias de ComfyUI de forma limpia: puertos, servicios y perfiles predecibles.
Presupuesto de VRAM: qué reduce realmente los errores de falta de memoria (OOM)Tácticas prácticas para VRAM: modos de atención, tamaños de modelo, procesamiento por lotes y límites del mundo real.
Fortalecimiento de IA local: permisos, sandboxing y valores predeterminados segurosReduce el riesgo en sistemas de IA locales: permisos de archivos, aislamiento de servicios y valores predeterminados más seguros.
Pros y contras (rápido)
servicio de usuario systemd
- ✅ estable, reinicio automático, bajo consumo de recursos, limpio
- ⛔ requiere configuración inicial una sola vez
lanzador de escritorio
- ✅ flujo de trabajo de un solo clic
- ⛔ sigue dependiendo de la interfaz del navegador
dos venvs
- ✅ lo mejor de ambos mundos (compatibilidad + última versión)
- ⛔ debes mantener los puertos/servicios separados para evitar confusiones
Related Articles
IA generativa explicada: modelos, recuperación, herramientas y aplicaciones no son lo mismo
La IA generativa es más que un modelo. Aprende cómo los modelos, la recuperación, las herramientas, el contexto, los entornos de ejecución y las aplicaciones encajan en los sistemas de IA en producción.
Tendencias emergentes de Linux en 2026: Moldeando el futuro de la infraestructura de servidores
Explora las tendencias clave de Linux de 2026, desde el dominio de Kubernetes y las distribuciones inmutables hasta la integración de IA y la seguridad eBPF.
Guía Integral de Métricas para Entrega y Gestión del Cambio
Esta guía proporciona una descripción detallada de las métricas esenciales para la entrega empresarial y la gestión del cambio, ayudando a los equipos a medir el rendimiento, optimizar procesos e impulsar la mejora continua. Descubra indicadores clave, métodos de cálculo y mejores prácticas para alinear sus métricas con los resultados empresariales.
Harness de agente gestionado vs. bucle de agente autohospedado: lo que ganas, lo que pierdes
“Agente autoalojado” puede significar arquitecturas muy diferentes. Esta guía separa el arnés gestionado, el entorno de ejecución autoalojado y el bucle de agente totalmente autooperado—y muestra qué límite de control necesitan realmente los equipos.
Guía completa de Evaluation Harness: Dominando la evaluación del rendimiento de LLM
Esta guía proporciona un recorrido detallado de Evaluation Harness, un marco de trabajo esencial para evaluar rigurosamente las capacidades de los modelos de lenguaje extensos (LLM) en los pipelines de LLMOps empresariales. Conozca la configuración, las mejores prácticas y las técnicas avanzadas para garantizar una evaluación comparativa y optimización de modelos confiables.
Google I/O 2026: Giros arquitectónicos, IA agéntica y la dosis de realidad del ecosistema unificado
Google I/O 2026 no fue solo un evento de modelos. Mostró un cambio de plataforma más profundo en los modelos Gemini, las herramientas de desarrollo, las superficies vinculadas a Android y los dispositivos inteligentes. Este artículo desglosa la conferencia principal como un artículo central para ingenieros, arquitectos y equipos de producto que necesitan separar las implicaciones reales en tiempo de ejecución de la exageración del escenario.
Arquitectura Multi-Inquilino de Grado Empresarial para una Plataforma Internacional
Loving Rocks es una plataforma de bodas de nivel empresarial diseñada con una verdadera arquitectura multiinquilino, bases de datos aisladas por inquilino e internacionalización integrada para escalabilidad global, seguridad y estabilidad operativa a largo plazo.
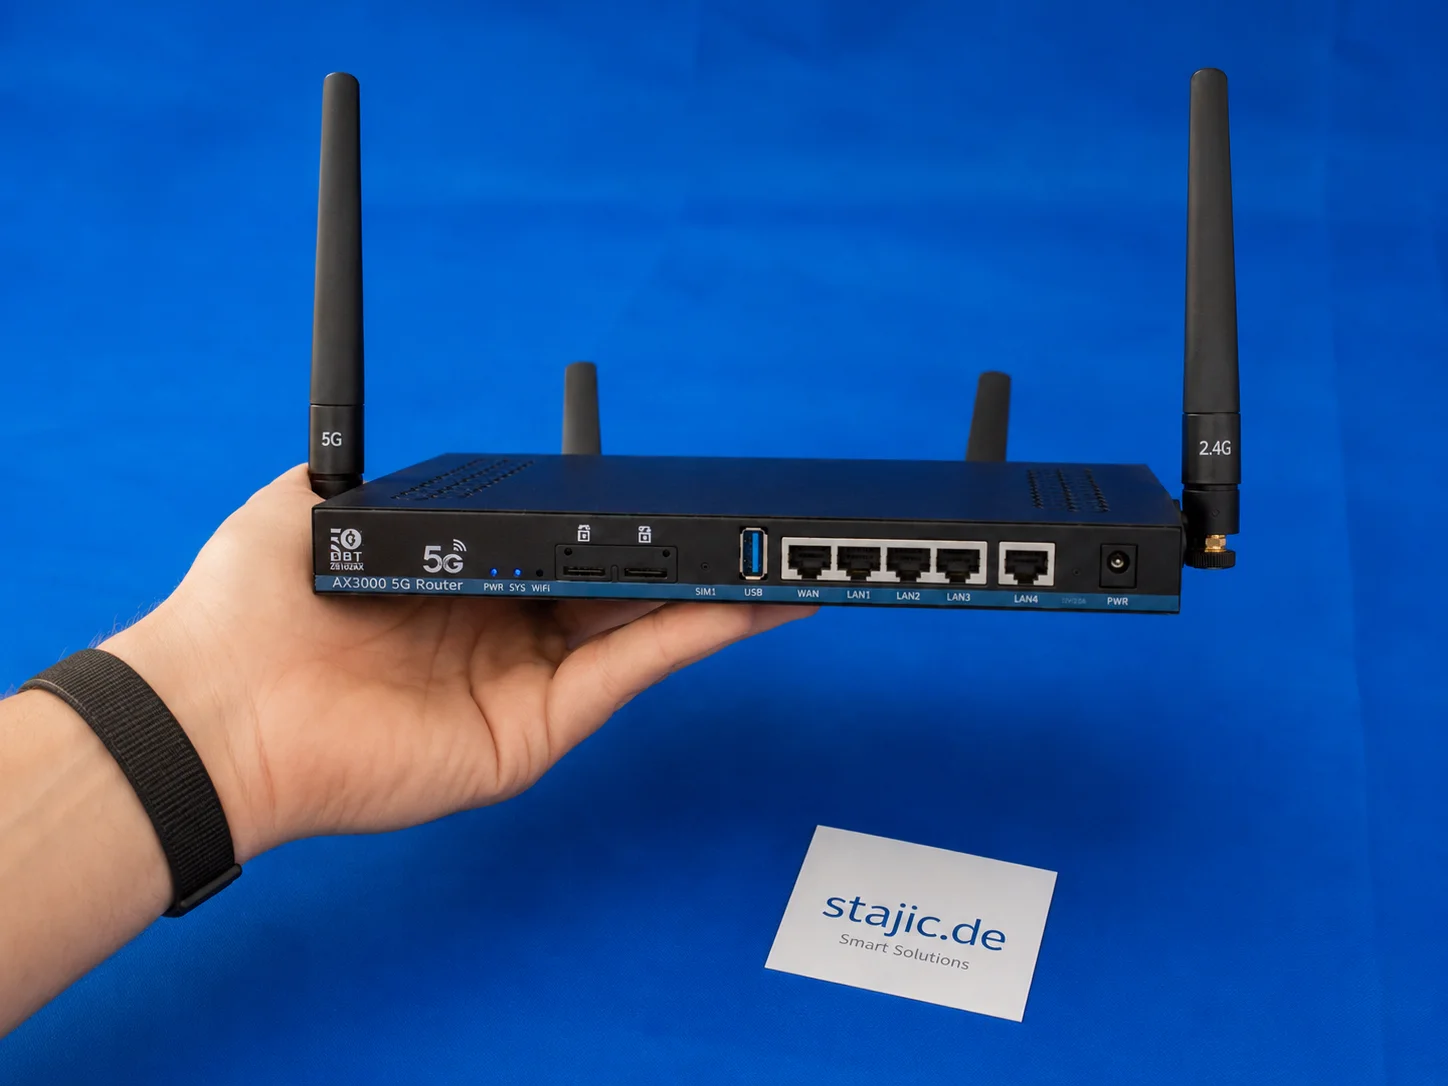
¿Deberías Comprar un Router OpenWrt 5G con Firmware Antiguo? El ZBT Z8102AX como Ejemplo Práctico
Comprar un router 5G OpenWrt con firmware antiguo puede tener sentido, pero solo bajo las condiciones adecuadas. El ZBT Z8102AX muestra claramente ambos lados: el hardware es útil, el módem funciona y el router se mantuvo estable en las pruebas, pero OpenWrt 21.02, el embalaje débil y las rutas de actualización poco claras requieren una decisión de compra cuidadosa.
¿Qué es la ingeniería de contexto? Lo que el modelo recibe antes de responder
La ingeniería de contexto diseña qué información recibe un modelo de IA antes de la inferencia, incluidos los prompts, la recuperación, la memoria, el estado de la aplicación, los resultados de las herramientas y el historial de conversación.
Google I/O 2026: Productos agénticos en Búsqueda, Workspace y Shopping
Google I/O 2026 demostró que la IA agéntica está yendo más allá de las demostraciones de modelos y las herramientas para desarrolladores hacia las superficies de productos cotidianos. Este artículo desglosa cómo Search, Workspace, Gemini Spark y Universal Cart apuntan hacia un nuevo modelo de producto donde los agentes de Google ayudan a los usuarios a investigar, trabajar, comprar y actuar a través de servicios conectados.
IA agéntica explicada: cuando un sistema de IA puede planificar, usar herramientas y actuar
La IA agéntica utiliza modelos dentro de bucles de ejecución de varios pasos, donde pueden elegir herramientas, observar resultados, actualizar el estado y adaptar su siguiente acción dentro de límites explícitos de tiempo de ejecución y permisos.
El prompt es parte del sesgo: cómo el encuadre de la IA moldea el razonamiento
La redacción del prompt no es neutral. Explore cómo el encuadre, las suposiciones, el seguimiento de instrucciones y la adulación pueden moldear el razonamiento de la IA—y por qué las conclusiones confiables requieren pruebas más allá del prompt original.