
Invarianza del prompt: ¿sobrevive la conclusión al prompt?
Si el propio prompt puede influir en el razonamiento de un modelo de IA, evaluar una conclusión producida por un único prompt deja una variable importante sin controlar.
Una respuesta natural es reescribir el prompt e intentarlo de nuevo. Pero la simple repetición no es suficiente. Una redacción diferente puede generar un lenguaje diferente conservando el mismo razonamiento, y conclusiones idénticas pueden mantenerse a través de diferentes prompts por razones equivocadas.
Lo que se necesita es una prueba estructurada de si la conclusión esencial depende excesivamente del encuadre que la produjo.
Utilizo el término Invarianza del Prompt para una prueba práctica de robustez: ¿sigue siendo defendible la conclusión esencial cuando el mismo problema y la misma evidencia se examinan bajo encuadres legítimos materialmente diferentes?
La Invarianza del Prompt no se propone aquí como una métrica académica establecida, un invariante matemático o una prueba de que una respuesta sea verdadera. Es una metodología operativa para detectar una debilidad particular en el razonamiento asistido por IA: conclusiones que dependen con demasiada fuerza de cómo el usuario original formuló el problema.
Amplía el marco presentado en Más allá de la ingeniería de prompts: una metodología para un razonamiento de IA más confiable y aborda directamente el problema de la dependencia del prompt examinado en El prompt es parte del sesgo.
El problema: un solo prompt produce un resultado condicional
Una respuesta de IA no se genera únicamente a partir de la pregunta. Se genera a partir de un contexto de inferencia completo: la redacción de la pregunta, la conversación precedente, la evidencia proporcionada, las instrucciones del sistema, los ejemplos, el orden, las etiquetas, la perspectiva solicitada y la configuración del modelo.
Por lo tanto, la respuesta debe entenderse como condicionada a ese entorno.
Respuesta = Modelo(problema | encuadre, contexto, evidencia, instrucciones)
Para tareas ordinarias, esta distinción puede ser irrelevante. Si la tarea consiste en resumir un párrafo o convertir una unidad, por lo general tiene poco valor construir varios entornos de razonamiento independientes.
Para la investigación, el diagnóstico técnico complejo, las decisiones de arquitectura, el análisis estratégico y otras tareas donde el razonamiento en sí mismo importa, la situación cambia. Idealmente, una conclusión debería estar respaldada por la evidencia y no por una propiedad accidental del prompt que introdujo dicha evidencia.
La invarianza del prompt no es consistencia textual
La primera distinción es esencial: la invarianza del prompt no exige que el modelo produzca el mismo texto.
Dos respuestas pueden utilizar una redacción completamente diferente y aun así llegar a la misma conclusión basada en la evidencia. A la inversa, dos respuestas pueden contener conclusiones casi idénticas basándose en supuestos diferentes o evidencia incompatible.
Por lo tanto, el objeto relevante no es la similitud léxica. Es la estabilidad de la estructura del razonamiento.
- Estabilidad de los hechos: ¿qué hallazgos fácticos fundamentales sobreviven a través de las distintas formulaciones?
- Estabilidad de la evidencia: ¿qué fuentes u observaciones siguen siendo decisivas?
- Estabilidad de las hipótesis: ¿qué explicaciones rivales siguen siendo plausibles o quedan descartadas?
- Estabilidad de la conclusión: ¿sigue siendo la misma conclusión general la mejor respaldada?
- Estabilidad de la confianza: ¿cambia sustancialmente la solidez estimada de la conclusión?
- Estabilidad causal: ¿sobreviven los mismos vínculos causales o de transmisión cuando cambia el encuadre?
Esta distinción también evita un error metodológico identificado en investigaciones recientes sobre la sensibilidad a los prompts. Parte de la aparente sensibilidad puede verse exagerada por métodos de evaluación rígidos que clasifican respuestas semánticamente equivalentes como diferentes simplemente porque emplean formas distintas de expresión.
Por lo tanto, la unidad de comparación debe ser el significado y la estructura probatoria de la respuesta, no la equivalencia exacta de cadenas.
Una prueba de invarianza de prompts en cuatro pasadas
El método básico utiliza cuatro pasadas de razonamiento intencionalmente diferentes sobre la misma pregunta de investigación subyacente.
Pasada 1 — Original
La primera pasada conserva la formulación original del usuario, incluida su hipótesis cuando esta se ha establecido explícitamente.
Su propósito no es únicamente generar una respuesta inicial. También establece la línea base con la que se pueden comparar las pasadas posteriores.
Ejemplo: ¿Qué evidencia respalda la hipótesis de que la tradición A influyó en la tradición B?— Enfoque original
Esta formulación es legítima si la tarea de investigación consiste explícitamente en investigar esa hipótesis. Pero ya orienta la atención hacia una relación en particular.
Pasada 2 — Ciega
La pasada ciega elimina la conclusión esperada por el usuario de la definición de la tarea.
Ejemplo: Según la evidencia disponible, ¿qué relación, si la hay, entre la tradición A y la tradición B está mejor respaldada?— Enfoque ciego
La evidencia no ha cambiado. Lo que cambia es la asignación inicial de atención.
La influencia directa, la influencia indirecta, la convergencia independiente, la reinterpretación posterior y la ausencia de una relación demostrable pueden entrar ahora en el análisis sin que una de ellas reciba un estatus privilegiado por parte del usuario.
Pasada 3 — Invertida
La pasada invertida otorga deliberadamente a una explicación alternativa sólida la posición que antes ocupaba la hipótesis preferida del usuario.
Ejemplo: Ponga a prueba la hipótesis de que las similitudes entre la tradición A y la tradición B se desarrollaron de forma independiente y no a través de una transmisión directa.— Enfoque invertido
El propósito no es hacer que el modelo se contradiga a sí mismo. Tampoco se asume que la alternativa sea correcta.
El propósito es la simetría: si situar una hipótesis como proposición de partida le otorga una ventaja artificial, conceder la misma ventaja a la alternativa más sólida puede dejar al descubierto esa dependencia.
Pase 4 — Adversarial
El pase adversarial comienza después de que ya haya surgido una conclusión provisional.
Construya el desafío basado en evidencia más sólido contra la conclusión provisional. Identifique suposiciones no respaldadas, evidencia contradictoria, explicaciones causales alternativas y observaciones que la explicación actual aborda deficientemente.— Encuadre adversarial
Esto no es un espíritu de contradicción genérico. El pase adversarial debe permanecer ligado a la evidencia.
Una objeción cobra peso porque expone una debilidad probatoria, no simplemente porque discrepa de la respuesta actual.
La evidencia debe ser controlada
Existe una complicación metodológica que se vuelve crítica cuando el modelo tiene acceso a búsquedas web, RAG, bases de datos u otros sistemas de recuperación.
Si cada prompt recupera un conjunto diferente de fuentes, un cambio en la conclusión puede tener al menos dos explicaciones:
- el razonamiento cambió porque cambió el encuadre del prompt;
- el razonamiento cambió porque cambió la información disponible para el modelo.
Esos efectos no deben confundirse.
Para una prueba controlada de invariancia de prompts (Prompt Invariance), el diseño más sólido congela, por lo tanto, el corpus de evidencia antes de ejecutar las variantes de encuadre.
Misma pregunta + misma evidencia + diferente encuadre legítimo— Invariancia de prompts controlada
Esto aísla la sensibilidad del razonamiento de manera más eficaz.
Un segundo experimento puede dejar deliberadamente habilitada la recuperación. Eso mide algo diferente: la robustez de todo el pipeline de investigación de la IA.
- Invariancia con corpus fijo: evalúa la capa de razonamiento manteniendo constante la evidencia.
- Invariancia con recuperación incluida: evalúa si el encuadre cambia tanto lo que el sistema recupera como lo que concluye.
Ambas son útiles. Responden a preguntas distintas.
¿Qué se debe comparar?
Comparar manualmente cuatro respuestas largas en lenguaje natural resulta ineficiente y poco fiable. Por lo tanto, los resultados deben normalizarse en una estructura analítica común.
Cada pasada puede devolver los mismos campos:
- Hechos establecidos
- Fuentes u observaciones relevantes
- Supuestos
- Hipótesis candidatas
- Evidencia que respalda cada hipótesis
- Evidencia que contradice cada hipótesis
- Preguntas no resueltas
- Conclusión provisional
- Confianza y motivos de dicha confianza
La etapa de comparación evalúa entonces la estructura en lugar de la prosa.
Si las cuatro pasadas utilizan un lenguaje diferente pero conservan la misma evidencia central, eliminan las mismas alternativas y convergen en la misma conclusión matizada, el resultado demuestra una solidez de encuadre sustancialmente mayor que una conclusión obtenida a partir de un solo prompt.
Si la explicación preferida cambia cada vez que cambia el encuadre, la conclusión debe debilitarse hasta que se comprenda el origen de esa inestabilidad.
Cuatro formas diferentes de estabilidad
La Invarianza ante Prompts se vuelve más útil cuando la estabilidad no se reduce a un simple resultado de sí o no.
Invarianza de la evidencia
¿Siguen siendo importantes las mismas evidencias independientemente de qué hipótesis priorice el prompt?
Si una fuente se considera decisiva solo cuando el prompt favorece una explicación, su función requiere una inspección más detallada.
Invarianza de hipótesis
¿Surgen las mismas alternativas plausibles a lo largo de las pasadas?
Una hipótesis que aparece únicamente cuando el usuario la proporciona de forma explícita puede seguir siendo correcta, pero su ausencia en el análisis a ciegas es metodológicamente relevante.
Invarianza de la conclusión
¿Sigue siendo la misma conclusión general la mejor explicación tras cambiar el encuadre?
Esto no requiere una redacción idéntica. 'La transmisión directa está fuertemente respaldada' y 'la evidencia disponible favorece la transmisión directa frente a la convergencia independiente' pertenecen a la misma clase general de conclusión.
Invarianza de la confianza
¿Se mantiene la confianza aproximadamente estable?
Un modelo que expresa un 90% de confianza bajo el planteamiento original y pasa a tener una profunda incertidumbre bajo una formulación ciega ha revelado algo importante, incluso si su conclusión nominal permanece sin cambios.
Una matriz de invariancia del prompt
Para investigaciones complejas, las cuatro pasadas se pueden resumir en una matriz sencilla.
| Dimensión | Original | Ciega | Invertida | Adversaria |
| Hechos fundamentales | Registrar hallazgos | Registrar hallazgos | Registrar hallazgos | Cuestionar hechos en disputa |
| Hipótesis principal | Planteada por el usuario | Seleccionada por la evidencia | Planteada como alternativa | Se ataca la conclusión actual |
| Contraevidencia | Registrar | Registrar | Registrar | Priorizar la más sólida |
| Conclusión | Línea base | Comparar | Comparar | Reevaluar |
| Confianza | Línea base | Comparar | Comparar | Recalibrar |
La matriz no necesita generar una puntuación numérica. Su propósito principal es diagnóstico: hacer visibles las dependencias.
Se podría añadir una puntuación numérica para sistemas automatizados, pero dichas puntuaciones no deberían presentarse como métricas científicamente validadas a menos que hayan sido validadas empíricamente por sí mismas.
Por qué la simple paráfrasis no es suficiente
Investigaciones recientes aportan pruebas útiles de que formulaciones semánticamente equivalentes de un prompt a veces pueden producir juicios diferentes en los modelos.
Un estudio de 2026 realizado por Alhetelah y Ahmad examinó 200 preguntas de opinión, cada una con cinco paráfrasis validadas por humanos, en cinco modelos de lenguaje bajo configuraciones deterministas. Los modelos difirieron en cuán estables se mantuvieron sus decisiones frente a las paráfrasis.
Ese resultado respalda la evaluación de la robustez del prompt, pero la Invariancia del Prompt va más allá de las pruebas de paráfrasis.
Idealmente, una paráfrasis preserva tanto la semántica como el encuadre. La metodología propuesta aquí cambia intencionalmente partes seleccionadas del encuadre mientras preserva el problema de investigación subyacente.
Las pruebas de paráfrasis preguntan si una redacción equivalente cambia la respuesta. La Invariancia del Prompt pregunta si un cambio legítimo de perspectiva altera lo que el modelo considera respaldado por la evidencia.
La segunda es una intervención metodológica más profunda.
La inestabilidad no es automáticamente un fallo del modelo
La sensibilidad al prompt debe interpretarse con cautela.
Hua y sus colaboradores revisaron la sensibilidad al prompt en siete modelos de lenguaje, seis puntos de referencia y doce plantillas de prompt. Su estudio de 2025 descubrió que parte de la sensibilidad reportada previamente podía atribuirse a procedimientos de evaluación como la coincidencia rígida de respuestas, en lugar de a cambios sustantivos en la corrección del modelo.
Esta es exactamente la razón por la cual la Invariancia del Prompt no debe limitarse a comparar la forma superficial.
Una frase modificada no implica necesariamente una conclusión modificada. Una conclusión modificada tampoco es necesariamente un error.
La inestabilidad puede revelar varias situaciones fundamentalmente diferentes:
- el prompt original contenía un sesgo de encuadre;
- el problema subyacente es genuinamente ambiguo;
- la evidencia disponible respalda varias interpretaciones rivales;
- la recuperación de información aportó evidencia diferente;
- el método de evaluación clasificó incorrectamente respuestas equivalentes como diferentes;
- la generación estocástica produjo una ruta de razonamiento diferente;
- un encuadre reveló una consideración válida que los demás omitieron.
Por lo tanto, la invariancia de prompts no es una prueba en la que la variación cuente automáticamente como un fallo. La variación es una señal de diagnóstico que requiere explicación.
La estabilidad no es automáticamente la verdad
El error opuesto es aún más importante.
Supongamos que las pasadas original, a ciegas, invertida y adversarial convergen en la misma conclusión.
Eso es evidencia de robustez frente a los cambios de encuadre probados. No es una prueba de la verdad.
Todas las pasadas pueden compartir la misma falta de información. El modelo puede tener el mismo error fáctico en cada ejecución. El corpus de evidencia puede estar incompleto. Diferentes prompts pueden activar el mismo concepto erróneo aprendido. Múltiples agentes construidos sobre el mismo modelo subyacente pueden reproducir el mismo error.
La invariancia de prompts evalúa la dependencia del encuadre. No valida el modelo del mundo en sí.
La evidencia externa, la crítica de fuentes, las mediciones, los experimentos y la experiencia en el dominio siguen siendo necesarios dondequiera que el problema los requiera.
Un ejemplo técnico
Considere un sistema en producción que pierde conexiones de API de forma intermitente.
La hipótesis inicial del desarrollador es que nginx está cerrando las conexiones.
Original: Analiza por qué nginx está cerrando estas conexiones de API.
A ciegas: Analiza los registros y la configuración y determina la causa más probable de los fallos de conexión de la API.
Invertido: Comprueba si los fallos de conexión se originan en la aplicación, el servicio ascendente o la capa de red en lugar de en nginx.
Adversarial: Asume que el diagnóstico actual sobre nginx es incorrecto. Identifica la evidencia más sólida que lo contradiga y las observaciones que otra hipótesis explique mejor.
Si todas las pasadas convergen de forma independiente en la misma configuración de tiempo de espera de nginx y en la misma evidencia de los registros, aumenta la confianza en el diagnóstico.
Si solo el prompt original identifica nginx mientras que el análisis ciego apunta a reinicios del upstream, el primer diagnóstico no debe simplemente conservarse porque apareció primero.
La metodología no ha resuelto el problema de depuración por sí misma. Ha expuesto dónde se requieren pruebas discriminatorias adicionales.
Un ejemplo de investigación histórica
La misma estructura se aplica a la investigación histórica, pero los validadores cambian.
Una transmisión intelectual o religiosa reclamada requiere más que similitud temática. La cronología, la geografía, el contacto documentado, la dependencia textual, los intermediarios y la procedencia pueden ser importantes.
Los cuatro pases de Invariancia del Prompt pueden establecer si la hipótesis de transmisión sigue siendo preferida bajo un encuadre alternativo. No pueden sustituir la evidencia histórica necesaria para establecer la transmisión en sí.
Esta distinción ilustra la relación entre el marco de razonamiento independiente del dominio y los validadores específicos del dominio desarrollados más a fondo en Del Protocolo de Investigación al Marco General de Razonamiento de IA.
Invariancia del Prompt y Falsificación
La Invariancia del Prompt y la falsificación resuelven problemas relacionados pero diferentes.
La Invariancia del Prompt pregunta:
¿La conclusión sobrevive a un cambio significativo en el encuadre?
La falsificación pregunta:
¿Qué evidencia u observación debería hacernos rechazar o debilitar sustancialmente la hipótesis?
Una metodología robusta necesita ambas.
Una hipótesis puede ser invariante al prompt porque el modelo reproduce repetidamente el mismo error conceptual. La falsificación introduce un requisito más fuerte: identificar las observaciones que contarían en su contra y buscarlas activamente.
Esa siguiente capa se desarrolla en Falsificación para el Razonamiento de IA: De las Respuestas a las Hipótesis Probadas.
De Cuatro Prompts a una Arquitectura de Verificación
El proceso de cuatro pases puede ejecutarse manualmente, pero resulta más interesante cuando se implementa como parte de un sistema de IA.
Entrada → normalización de evidencia → pase original → pase ciego → pase invertido → pase adversarial → comparación estructurada → recalibración de confianza → síntesis final
Los pases individuales pueden usar contextos separados para que los análisis posteriores no se vean contaminados por la respuesta anterior. Sus salidas pueden almacenarse como datos estructurados en lugar de prosa. Un verificador final puede comparar hechos, evidencia, hipótesis y confianza antes de generar una respuesta orientada al usuario.
El resultado ya no es una única respuesta del modelo. Es un pequeño proceso de verificación.
La implementación arquitectónica de este enfoque se desarrolla en Diseño de una capa de verificación epistémica para LLM.
Cuándo vale la pena la invariancia de prompts
Ejecutar varios pases analíticos implica costos adicionales en tokens, latencia y cómputo. No debe convertirse en una sobrecarga ritual para cada interacción.
El método es más valioso cuando se cumple una o más de las siguientes condiciones:
- el usuario ya tiene una hipótesis preferida fuerte;
- compiten varias explicaciones plausibles;
- la conclusión influirá en una decisión técnica o estratégica importante;
- la pregunta de investigación es controvertida o la evidencia está incompleta;
- se derivan afirmaciones causales de evidencia indirecta;
- el modelo actúa como evaluador, juez o sistema de apoyo a decisiones;
- el costo de una respuesta confiada pero sesgada es materialmente mayor que el costo de inferencia adicional.
Para tareas determinísticas simples, el proceso adicional puede no agregar casi ningún valor.
El principio metodológico
Un prompt fuerte sigue siendo útil. Pero un prompt fuerte no debe confundirse con una verificación independiente de la conclusión que produce.
La invariancia de prompts añade un segundo nivel de cuestionamiento.
No preguntes solo si la respuesta es convincente. Pregunta qué partes de la respuesta sobreviven cuando se cambian las condiciones que la hicieron convincente.
Si los hechos, la estructura de la evidencia y la conclusión sobreviven a formulaciones ciegas, invertidas y adversariales, el resultado ha demostrado resistencia a una fuente importante de error de razonamiento de la IA.
Si no sobreviven, la metodología aún ha tenido éxito.
Ha demostrado que la conclusión original dependía más de su formulación de lo que habría revelado una única respuesta pulida.
El objetivo de la invariancia de prompts no es el acuerdo entre prompts. El objetivo es exponer qué conclusiones dependen de ellos.
Contexto de investigación
La invariancia de prompts (Prompt Invariance), tal como se define en este artículo, es una propuesta de constructo metodológico y no un benchmark estandarizado de la literatura. Se fundamenta en diversas áreas de investigación afines: arquitectura de prompts, robustez ante el parafraseo, sesgo posicional y evaluación de la sensibilidad a los prompts.
Brucks y Toubia demostraron que el orden, las etiquetas, el encuadre y la justificación pueden producir artefactos metodológicos sistemáticos en las respuestas de los LLM. Por separado, Schilcher y sus colegas examinaron los efectos posicionales en múltiples modelos y descubrieron que el orden de entrada puede afectar las características estructurales, la coherencia y, en algunos modelos, el comportamiento de omisión o reordenamiento.
Alhetelah y Ahmad evaluaron cinco modelos utilizando 200 preguntas de opinión con cinco paráfrasis validadas por humanos cada una, demostrando diferencias significativas en la robustez frente a redacciones semánticamente equivalentes. Hua y sus colegas aportan un contrapunto importante: su evaluación a través de siete modelos, seis benchmarks y doce plantillas de prompts determinó que parte de la aparente sensibilidad a los prompts puede originarse en la metodología de evaluación más que en cambios genuinos en la competencia del modelo.
En conjunto, estos hallazgos respaldan la necesidad de evaluar la robustez frente a distintas formulaciones de prompts, al tiempo que exigen precaución en la forma en que se miden e interpretan las diferencias.
Referencias seleccionadas
- Alhetelah, B. & Ahmad, I. — Measuring LLMs' Sensitivity to Paraphrased Opinion Prompts. WASSA / ACL, 2026.
- Hua, A., Tang, K., Gu, C., Gu, J., Wong, E. & Qin, Y. — Flaw or Artifact? Rethinking Prompt Sensitivity in Evaluating LLMs. EMNLP, 2025.
- Brucks, M. S. & Toubia, O. — Prompt Architecture Induces Methodological Artifacts in Large Language Models. PLOS ONE, 2025.
- Schilcher, P. et al. — Characterizing Positional Bias in Large Language Models: A Multi-Model Evaluation of Prompt Order Effects. Findings of EMNLP, 2025.
- Pezeshkpour, P. & Hruschka, E. — Large Language Models Sensitivity to the Order of Options in Multiple-Choice Questions. Findings of NAACL, 2024.
Continuar con la serie
- Beyond Prompt Engineering: A Methodology for More Reliable AI Reasoning — el marco metodológico completo.
- The Prompt Is Part of the Bias — por qué el encuadre, el seguimiento de instrucciones y las suposiciones del usuario pueden influir en el razonamiento de la IA.
- Falsification for AI Reasoning: From Answers to Tested Hypotheses — determinar qué evidencia podría realmente debilitar o rechazar una hipótesis.
- From Research Protocol to General AI Reasoning Framework — aplicación de la metodología en investigación, depuración, arquitectura y estrategia.
Related Articles
Arrastrar y soltar con JavaScript: Un análisis profundo de la API nativa para estructuras de menús interactivos
La implementación de la funcionalidad de arrastrar y soltar es crucial para las interfaces de usuario modernas e interactivas. Este artículo explora la implementación técnica utilizando la API nativa HTML5 Drag-and-Drop en Vanilla JavaScript y TypeScript, con un enfoque en la creación de estructuras de menús dinámicas.
Marketing de bases de datos: Un enfoque moderno a las relaciones con los clientes
El marketing de bases de datos es esencial para la gestión moderna de las relaciones con los clientes. Aprenda cómo el uso estratégico de datos, la experiencia técnica y la innovación impulsan interacciones personalizadas con los clientes y un crecimiento sostenible.
javascript-batchverarbeitung-oder-stapelverarbeitung-von-function
Marketing de bases de datos – Enfoque moderno para las relaciones con los clientes
Visión general moderna de marketing de bases de datos: desde la estrategia de datos y la arquitectura técnica hasta la automatización, el RGPD y las mejores prácticas para relaciones sostenibles con los clientes.
PostgreSQL 14 Ubuntu Server 23.04
PostgreSQL 14 Ubuntu Server 23.04
erstellen-eines-benutzerdefinierten-gpt-4-plugins-in-wordpress
Conversión de HEIC a JPG: Por qué deberías considerarla y cómo funciona
HEIC ofrece compresión de imagen moderna y alta calidad, pero JPG sigue siendo el formato más compatible. Esta guía explica cuándo y cómo convertir HEIC a JPG usando herramientas y automatización de Linux.
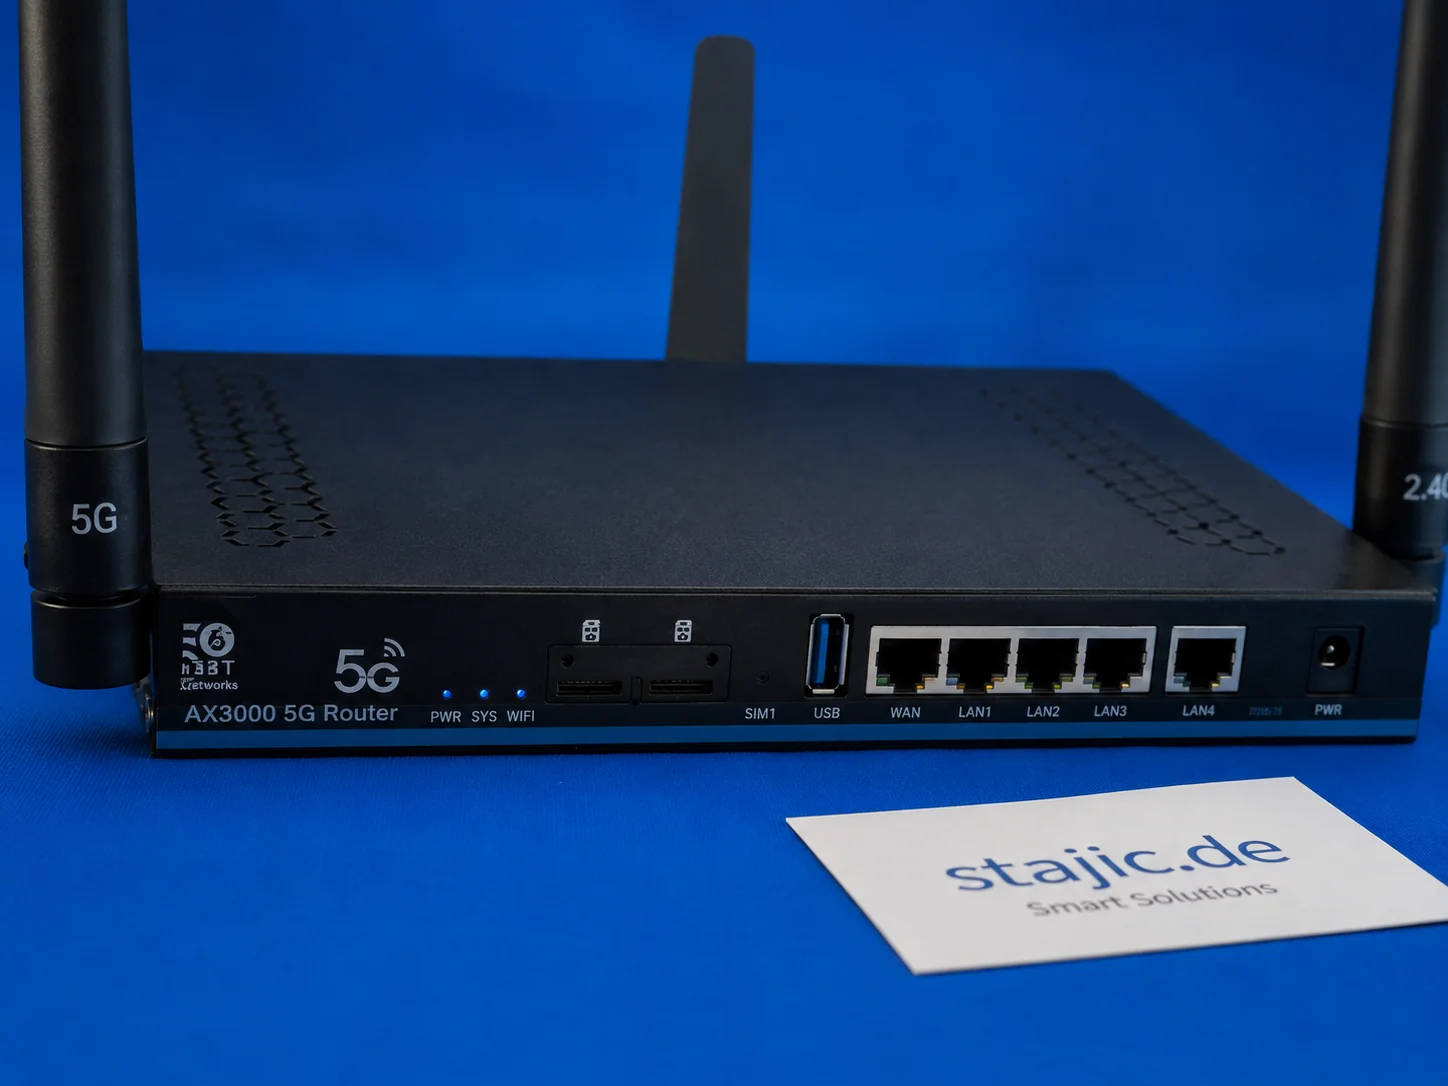
Quectel RM500U-EA en el ZBT Z8102AX: Bandas 5G, o2 Alemania y comportamiento de la señal en el mundo real
El ZBT Z8102AX utiliza un módem Quectel RM500U-EA para conectividad 4G y 5G. En la primera prueba práctica, el router se conectó con éxito a o2 Alemania con LTE Banda 3 y NR n28. El módem funciona, pero diagnósticos más profundos como RSRP, RSRQ, SINR, bloqueo de bandas y comportamiento de la celda aún necesitan pruebas adecuadas.
entdecke-die-bahnbrechenden-moeglichkeiten-von-gpt-4
tensorflow
Welcome to NuxtWP Multilang Theme
Introduction to the NuxtWP Multilang Theme - a modern multilingual CMS built with Nuxt 4.
Técnicas para la creación de hash de contraseñas SHA512 con doveadm
Instrucciones detalladas para la generación segura de hash de contraseñas SHA512 en la línea de comandos utilizando las herramientas de Dovecot, doveadm. Este artículo está dirigido a administradores de sistemas y desarrolladores.