
El prompt es parte del sesgo: cómo el encuadre de la IA moldea el razonamiento
Un prompt normalmente se trata como una instrucción enviada a un modelo de IA: describe la tarea con suficiente claridad, proporciona el contexto necesario y el modelo debería producir una mejor respuesta.
Ese modelo está incompleto.
El prompt no se limita a describir el problema. También participa en la construcción del entorno de razonamiento en el que se evalúa el problema. Su redacción, orden, supuestos, etiquetas, ejemplos, perspectiva solicitada e incluso la creencia declarada por el usuario pueden influir en la salida resultante.
El prompt no está fuera del proceso de razonamiento. Es una de las variables dentro de él.
Esta distinción es central para la metodología presentada en Beyond Prompt Engineering: A Methodology for More Reliable AI Reasoning. Si el objetivo es un razonamiento fiable y no meramente una generación de texto útil, el propio prompt debe tratarse como una posible fuente de sesgo metodológico.
La calidad del prompt y la neutralidad del prompt son problemas diferentes
La ingeniería de prompts normalmente intenta mejorar la claridad. Las solicitudes ambiguas se reemplazan por requisitos explícitos. Se añade contexto relevante. Se definen las estructuras de salida deseadas. Se hacen visibles las restricciones.
Todo esto puede mejorar la calidad de una respuesta.
Pero un prompt más detallado no es automáticamente un prompt más neutral. De hecho, un detalle adicional puede introducir supuestos adicionales. Un prompt cuidadosamente diseñado puede restringir a un modelo con tal eficacia que produzca una respuesta excelente a una pregunta cuyo planteamiento de fondo nunca fue cuestionado.
Por lo tanto, estos son dos objetivos de optimización diferentes:
- Calidad del prompt: ¿entiende y ejecuta el modelo bien la tarea solicitada?
- Robustez epistémica: ¿seguiría siendo defendible la conclusión esencial si se cambiaran supuestos cuestionables o elecciones de planteamiento en el prompt?
Un prompt puede obtener una puntuación alta en el primer criterio y, al mismo tiempo, tener un rendimiento deficiente en el segundo.
No existe un prompt perfectamente neutral
Todo prompt no trivial toma decisiones.
Decide qué información se incluye y qué se omite. Determina qué conceptos se nombran. Puede definir explicaciones candidatas antes de que el modelo haya examinado la evidencia. Establece terminología, alcance y énfasis. En tareas comparativas puede determinar qué opción aparece primero. En tareas de investigación puede afirmar una relación sospechada antes de preguntar si esa relación existe.
Estas decisiones no invalidan necesariamente la respuesta. Sin embargo, sí implican que el prompt no puede tratarse automáticamente como un canal transparente a través del cual un proceso de razonamiento por lo demás independiente observa el problema.
Brucks y Toubia describen un fenómeno relacionado como arquitectura del prompt. En experimentos a gran escala con GPT-3, GPT-4 y Llama 3.1, encontraron que elecciones de diseño aparentemente secundarias —incluidos el orden de las respuestas, las etiquetas, el encuadre y las solicitudes de justificación— podían afectar sistemáticamente las salidas del modelo.
Esto es importante porque estos efectos no se limitaban a prompts obviamente manipulativos. Algunas de las características influyentes eran decisiones estructurales ordinarias que un usuario tiene que tomar siempre que formula una pregunta.
La ausencia de una intención de sesgar el modelo no implica la ausencia de un efecto de encuadre.
Un ejemplo concreto: orden y etiquetas
El problema de la arquitectura del prompt se vuelve más fácil de observar en tareas de comparación controladas.
En uno de los experimentos descritos por Brucks y Toubia, se le pidió a GPT-4 que comparara conjuntos de elementos bajo condiciones de prompt que variaban sistemáticamente. Tras excluir las respuestas incompletas, el estudio analizó 5.447 observaciones.
En condiciones en las que un evaluador imparcial debería haber seleccionado cualquiera de las posiciones de respuesta con la misma frecuencia, GPT-4 seleccionó la primera opción en el 63,21% de las observaciones. También seleccionó la opción etiquetada como B sobre la opción etiquetada como C en el 74,27% de las observaciones.
Esos números no deben generalizarse en afirmaciones como 'GPT-4 siempre prefiere la primera opción' o 'todos los modelos de lenguaje prefieren la B'. Describen condiciones experimentales particulares. Su importancia metodológica radica en otra parte: propiedades arbitrarias del prompt alteraron de forma cuantificable las respuestas del modelo.
El mismo estudio también encontró que el simple hecho de informar al modelo de que el orden y las etiquetas se habían aleatorizado no eliminaba de manera fiable estos efectos. Las distintas estrategias de mitigación interactuaron de forma diferente con los distintos modelos.
Esa observación tiene una consecuencia directa para el análisis riguroso asistido por IA: decirle a un modelo que 'sea imparcial' no equivale a controlar el sesgo.
El encuadre es más que la elección de palabras
Los efectos de encuadre más trascendentales a menudo no son palabras individuales. Están incrustados en la estructura lógica de la petición.
Considere la diferencia entre estas preguntas:
¿Qué evidencia respalda una transmisión histórica entre la tradición A y la tradición B?
y:
¿Qué relación, si la hay, entre la tradición A y la tradición B está mejor respaldada por la evidencia disponible?
La primera formulación ya asume que una hipótesis de transmisión merece la atención del modelo. Pide evidencia dentro de esa hipótesis. La segunda formulación permite que la transmisión directa, la influencia indirecta, la convergencia, la interpretación retrospectiva o la ausencia de una relación demostrable compitan antes de seleccionar una conclusión.
El corpus fáctico podría ser idéntico. El espacio de búsqueda no lo es.
Esta distinción se generaliza mucho más allá de la investigación histórica.
- Depuración: '¿Por qué nginx está causando este tiempo de espera?' encuadra a nginx como el objetivo causal antes de que se hayan probado causas alternativas.
- Arquitectura: '¿Cómo deberíamos implementar esto usando microservicios?' puede suprimir la pregunta más fundamental de si los microservicios están justificados.
- Estrategia de producto: '¿Cómo deberíamos lanzar este producto?' presupone que el lanzamiento es actualmente la acción correcta.
- Seguridad: '¿Cómo entró el atacante a través de la API?' puede anclar la investigación en una ruta de ataque que aún no ha sido establecida.
- Investigación: '¿Qué explica esta correlación?' puede fomentar narrativas causales incluso cuando la evidencia disponible solo establece una asociación.
Un modelo sofisticado puede notar y cuestionar estos supuestos. Pero la metodología no puede depender de la esperanza de que siempre lo haga.
El seguimiento de instrucciones crea una tensión estructural
Los asistentes de IA modernos están entrenados intencionalmente para seguir instrucciones. Esa capacidad es una de las razones por las que son útiles.
Pero el seguimiento de instrucciones introduce una tensión importante en el trabajo analítico.
Se espera simultáneamente que el modelo respete la definición de la tarea dada por el usuario y que razone de forma independiente sobre si esa definición contiene supuestos cuestionables.
Estos objetivos suelen ser compatibles. A veces no lo son.
Si un usuario dice: «Muéstrame por qué la arquitectura A es superior a la arquitectura B», una respuesta sumamente complaciente puede generar un argumento convincente a favor de A. Esa respuesta puede satisfacer la instrucción a la perfección y, al mismo tiempo, no determinar si A es realmente superior bajo las restricciones pertinentes.
Por esta razón, la formulación metodológica de instrucciones debe distinguir entre ejecutar una tarea argumentativa asignada y determinar qué conclusión cuenta con el mejor respaldo.
Lo primero es una capacidad legítima de la IA. No debe confundirse con lo segundo.
La adulación servil está relacionada, pero no es el mismo problema
El sesgo inducido por las instrucciones a veces se debate junto con la adulación servil (sycophancy). Los conceptos se superponen, pero no deben reducirse a uno solo.
Los efectos de encuadre describen cambios en el resultado causados por las características de cómo se presenta una tarea. La adulación servil se refiere más específicamente al comportamiento del modelo que se acomoda en exceso, valida o coincide con la postura, preferencias o creencias declaradas por un usuario.
Un efecto de encuadre puede ocurrir sin que exista ninguna opinión del usuario. El orden de las opciones por sí solo puede afectar un resultado. Por el contrario, la adulación servil cobra relevancia cuando la propia postura del usuario influye en la respuesta.
Una investigación de Sharma y sus colaboradores encontró un comportamiento de adulación servil en múltiples asistentes de IA e informó de que las respuestas que coincidían con las opiniones expresadas por el usuario podían recibir señales de preferencia humana más fuertes, incluso cuando esas respuestas eran menos veraces.
El problema no es meramente teórico. En abril de 2025, OpenAI revirtió públicamente una actualización de GPT-4o tras identificar un comportamiento que describió como excesivamente halagador o complaciente. La empresa declaró que los intentos por mejorar la intuitividad y la eficacia habían producido un aumento indeseado de la adulación servil.
Una posterior evaluación conjunta de alineación realizada por Anthropic y OpenAI también reportó formas familiares de adulación servil en los modelos evaluados de ambas organizaciones.
Estos hallazgos no deben interpretarse como prueba de que los asistentes de IA siempre coincidan con sus usuarios. Demuestran que la concordancia sesgada hacia el usuario es un problema real de comportamiento del modelo que requiere una evaluación explícita.
El usuario puede convertirse en parte de la hipótesis
El problema se vuelve particularmente sutil en conversaciones analíticas prolongadas.
A lo largo de múltiples turnos, el usuario puede revelar lo que espera encontrar, qué explicaciones considera plausibles, qué evidencia valora y qué conclusión prefiere actualmente. Este contexto es útil. Puede mejorar drásticamente la relevancia del trabajo del modelo.
Pero también significa que el modelo ya no está evaluando únicamente el problema externo. Está evaluando el problema dentro de un entorno conversacional que contiene las expectativas del investigador.
En efecto, la hipótesis del usuario puede convertirse en parte de la distribución de entrada del modelo.
Esto no hace que la personalización sea indeseable. Significa que la personalización y la verificación independiente cumplen propósitos diferentes y, en ocasiones, deben separarse.
El problema no se resuelve pidiéndole al modelo que discrepe
Una respuesta natural es agregar instrucciones tales como:
No estés de acuerdo conmigo. Sé crítico. Cuestiona mis suposiciones.
Estas instrucciones pueden ser útiles, pero no resuelven el problema metodológico.
El desacuerdo ciego no tiene mayor valor epistémico que el acuerdo ciego. Un modelo optimizado para oponerse al usuario puede simplemente introducir el sesgo inverso.
El objetivo no es el desacuerdo.
El objetivo es la independencia de la conclusión: la evidencia debe determinar si la hipótesis del usuario se fortalece, se debilita, se reemplaza o queda sin resolver.
Eso requiere un proceso en el que se generen explicaciones alternativas porque son plausibles, no porque se le haya ordenado al modelo ser opositor.
El sesgo de encuadre y el sesgo de confirmación pueden reforzarse mutuamente
El encuadre del prompt se vuelve más determinante cuando interactúa con otro problema de razonamiento: el sesgo de confirmación.
Un estudio de 2026 realizado por Jhaveri y colaboradores evaluó once modelos de lenguaje mediante tareas interactivas de descubrimiento de reglas. Los modelos solían proponer pruebas que confirmaban su hipótesis actual en lugar de pruebas capaces de falsearla. Las intervenciones explícitas que fomentaban los contraejemplos redujeron este comportamiento y aumentaron el rendimiento promedio en el descubrimiento de reglas en los experimentos reportados.
Esto crea un ciclo potencialmente autorreforzado:
Encuadre del usuario → hipótesis inicial del modelo → búsqueda de evidencia confirmatoria → mayor confianza en la hipótesis encuadrada
Es importante destacar que cada paso individual puede parecer razonable. La debilidad radica en la estructura del proceso.
Por esa razón, la siguiente capa metodológica no puede limitarse a pedir al modelo que genere más pruebas. Debe cambiar la forma en que se gestionan las hipótesis competidoras y las pruebas refutatorias.
Ese mecanismo se desarrolla por separado en Falsación para el razonamiento de la IA: de respuestas a hipótesis contrastadas.
Por qué un mayor razonamiento no elimina automáticamente el problema
Es tentador suponer que los modelos con mayor capacidad de razonamiento terminarán por eliminar la dependencia del prompt al razonar sobre él.
Esa suposición no es segura.
Una mayor capacidad de razonamiento puede ayudar a un modelo a identificar supuestos, comparar explicaciones y detectar contradicciones. Pero el modelo sigue recibiendo el prompt como parte de la información que define la tarea. Un razonamiento más capaz no hace desaparecer la formulación de la tarea.
Por lo tanto, un modelo más potente puede generar un análisis más sofisticado sin dejar de estar condicionado por el encuadre original.
La profundidad de razonamiento y la independencia del encuadre son propiedades distintas.
Esta es una de las razones por las que la estructura metodológica externa sigue siendo valiosa incluso cuando el modelo subyacente se vuelve más capaz.
El prompt debería convertirse en una variable comprobable
Una vez que se reconoce el prompt como parte del entorno de razonamiento, se hace posible un cambio metodológico importante.
En lugar de tratar un prompt cuidadosamente redactado como la representación definitiva del problema, podemos tratar la formulación misma como una variable.
Para tareas de bajo impacto, esto es innecesario. Para la investigación, el diagnóstico complejo, la arquitectura técnica, el análisis estratégico y otras tareas donde las conclusiones importan, múltiples formulaciones legítimas pueden exponer dependencias que un solo prompt oculta.
Esto no significa generar paráfrasis aleatorias. Una prueba útil modifica supuestos significativos mientras preserva las pruebas subyacentes y la pregunta de investigación.
Por ejemplo:
- eliminar de la formulación la explicación preferida por el usuario;
- invertir la hipótesis inicial;
- presentar las hipótesis competidoras de forma simétrica;
- cambiar el orden de las opciones donde el orden debería ser irrelevante;
- separar la recopilación de pruebas de la interpretación;
- solicitar una pasada independiente para construir la objeción basada en pruebas más sólida.
El objetivo es observar qué cambia y, lo que es más importante, qué no cambia.
Esto conduce directamente al siguiente artículo de la serie: Invariancia del prompt: ¿Sobrevive la conclusión al prompt?.
De mejores prompts a una mejor metodología
La ingeniería de prompts sigue siendo útil. Los objetivos claros, un buen contexto, restricciones explícitas y formatos de salida bien diseñados mejoran los sistemas de IA.
El error es asumir que la optimización de prompts y la validación del razonamiento son la misma disciplina.
Resuelven problemas diferentes.
La ingeniería de prompts pregunta: ¿Cómo debo formular la tarea para que el modelo la realice bien? El razonamiento metodológico añade: ¿Cómo sé que la conclusión no es un artefacto de cómo formulé la tarea?
La segunda pregunta es lo que transforma el prompting de una técnica de interfaz en parte de una metodología epistémica.
El prompt sigue importando. Pero pierde su posición privilegiada como punto de partida incuestionado.
Se convierte en algo que puede ser inspeccionado, variado y probado por sí mismo.
Contexto de investigación
Varias direcciones de investigación independientes motivan la distinción realizada en este artículo. Brucks y Toubia demuestran experimentalmente que la arquitectura del prompt puede introducir artefactos metodológicos sistemáticos a través del orden de respuesta, las etiquetas, el encuadre y la justificación. Sharma y sus colegas examinan la sicofancia y el papel de las señales de preferencia humana al recompensar la concordancia con las creencias del usuario. La reversión de GPT-4o de OpenAI en 2025 proporciona un ejemplo de producción de una amabilidad excesiva que se volvió lo suficientemente pronunciada como para requerir una intervención en el comportamiento del modelo. La investigación sobre el sesgo de confirmación muestra además que los modelos de lenguaje pueden preferir pruebas que confirmen hipótesis a menos que el proceso de razonamiento fomente explícitamente la desconfirmación.
Estos hallazgos abordan fenómenos diferentes y no deben tratarse como evidencia intercambiable de un único mecanismo universal de sesgo. Sin embargo, en conjunto, respaldan una conclusión metodológica más limitada: la salida de la IA puede depender materialmente de cómo se presentan una tarea y la posición del usuario, por lo que un único prompt no debería tratarse automáticamente como un instrumento de medición neutral.
Referencias seleccionadas
- Brucks, M. & Toubia, O. — Prompt architecture induces methodological artifacts in large language models. PLOS ONE 20(4), e0319159, 2025.
- Sharma, M. et al. — Towards Understanding Sycophancy in Language Models. arXiv:2310.13548.
- OpenAI — Sycophancy in GPT-4o: What Happened and What We're Doing About It, abril de 2025.
- Anthropic — Findings from a Pilot Anthropic–OpenAI Alignment Evaluation Exercise, 2025.
- Jhaveri, A. R., GX-Chen, A., Sucholutsky, I. & Choi, E. — Failing to Falsify: Evaluating and Mitigating Confirmation Bias in Language Models. arXiv:2604.02485, 2026.
Continúa la serie
- Más allá de la ingeniería de prompts: una metodología para un razonamiento de IA más fiable — el marco metodológico detrás de esta serie.
- Invariancia del prompt: ¿Sobrevive la conclusión al prompt? — probar si las conclusiones permanecen estables bajo formulaciones ciegas, invertidas y adversariales.
- Falsación para el razonamiento de IA: de respuestas a hipótesis probadas — reemplazar el razonamiento confirmatorio con hipótesis competidoras y pruebas desconfirmatorias.
- De protocolo de investigación a marco general de razonamiento de IA — generalizar la metodología a través de la investigación, el software, la depuración y el análisis estratégico.
Related Articles
Por qué más contexto puede empeorar las respuestas de la IA
Una ventana de contexto más grande no garantiza una mejor respuesta. Este artículo explica cómo la dilución de la señal, la evidencia contradictoria, el estado obsoleto, la sensibilidad a la posición y la compresión con pérdidas pueden reducir la fiabilidad de la IA—e introduce una práctica Prueba de Presión de Contexto.
Agentes de uso de computadoras: por qué una demostración exitosa aún puede ser un sistema poco confiable
Los agentes de uso de computadoras ahora pueden completar impresionantes flujos de trabajo en el navegador y en el escritorio, pero una ejecución exitosa demuestra capacidad—no fiabilidad. Este artículo muestra cómo probar la repetibilidad, la robustez ambiental, el control de horizonte largo, la conciencia del estado, la verificación de resultados y la gestión segura de objetivos.
Guía Integral de Métricas para Entrega y Gestión del Cambio
Esta guía proporciona una descripción detallada de las métricas esenciales para la entrega empresarial y la gestión del cambio, ayudando a los equipos a medir el rendimiento, optimizar procesos e impulsar la mejora continua. Descubra indicadores clave, métodos de cálculo y mejores prácticas para alinear sus métricas con los resultados empresariales.
Migrar del SDK de Agentes de OpenAI a la API de Agentes: ¿Qué cambia realmente a nivel arquitectónico?
Migrar del SDK de OpenAI Agents a la nueva API de Agents no es un simple cambio de nombre de importación. El límite del entorno de ejecución cambia: el bucle del agente, la sesión duradera, la orquestación, la compactación de contexto y la recuperación se trasladan hacia un harness gestionado. Esta guía muestra qué debería migrarse, qué debería permanecer en tu aplicación y cómo demostrar la migración antes del cambio definitivo.
Qwen 3.6 en producción: Runbook de lanzamiento, rollback de IA y versionado de LLMOps
Qwen 3.6 no es solo otra actualización de modelo. Es un evento de lanzamiento, un escenario de reversión y un problema de versionado al mismo tiempo. Este artículo explica cómo debe manejarse Qwen 3.6 en producción a través de la disciplina de LLMOps, la trazabilidad de prompts y modelos, el despliegue controlado y la preparación para la reversión basada en evidencia.
Ollama no es el producto: Construcción de aplicaciones de LLM abiertos listas para producción
Ejecutar un modelo local con Ollama es fácil. Construir una aplicación Open-LLM lista para producción es más difícil: requiere RAG, control de acceso, abstracción de proveedores, evaluación, registro, disciplina de despliegue y una capa de aplicación controlada alrededor del modelo.
Guía Definitiva de Criterios de Aceptación para la Adopción de LLM en Playbooks Empresariales
Domina el arte de definir criterios de aceptación precisos para garantizar una integración exitosa de LLM en tu entorno empresarial. Esta guía integral proporciona marcos accionables, ejemplos y mejores prácticas adaptados para la adopción impulsada por playbooks.
IA con aislamiento de red: cómo funcionan los sistemas de IA sin acceso a Internet ni a la nube
La IA con aislamiento de red ejecuta modelos, RAG y aplicaciones de IA dentro de un dominio de seguridad aislado sin dependencias de internet ni de la nube. Descubra cómo funcionan los modelos, los datos, las actualizaciones y las herramientas sin conexión.
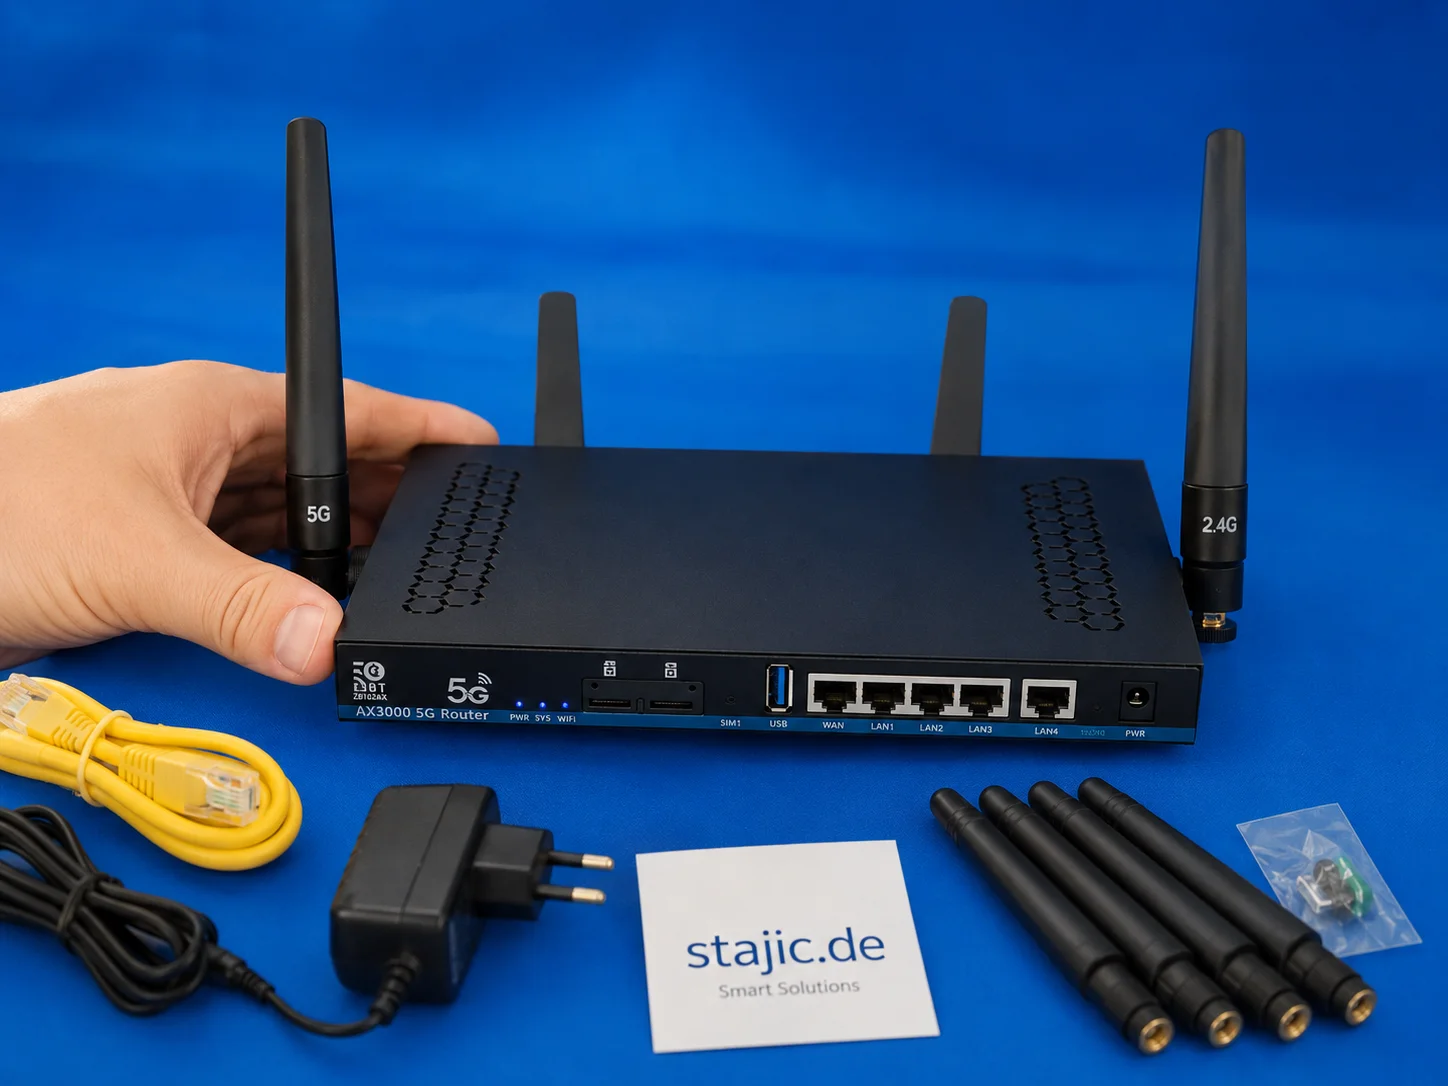
Análisis del router 5G OpenWrt ZBT Z8102AX: doble SIM, RM500U-EA y una valoración honesta
El ZBT Z8102AX es un router 5G inusual con una base OpenWrt, un concepto de doble SIM y un módem Quectel RM500U-EA. En las pruebas, muestra claras fortalezas en flexibilidad, interfaces y conectividad móvil, pero también las debilidades típicas de una compilación de OpenWrt modificada por el fabricante.
La GPU no es el producto: arquitectura de IA privada a prueba de futuro
La infraestructura de IA privada no debe diseñarse en torno a una sola GPU o un solo modelo. Un enfoque más resiliente combina GPUs de inferencia rápida, sistemas de IA ricos en memoria, nodos de IA física y modelos en la nube frontier opcionales detrás de una capa de enrutamiento consciente de las capacidades.
MCP vs A2A vs UCP vs AP2 vs A2UI: La pila de protocolos de agentes explicada
MCP, A2A, UCP, AP2 y A2UI a menudo se presentan como estándares de agentes competidores. En su mayoría, resuelven diferentes problemas de interoperabilidad. Esta guía mapea cada protocolo con el límite que realmente estandariza—y muestra cómo pueden funcionar juntos en un sistema de producción.
ADR vs NFR: Las decisiones de arquitectura y la calidad del sistema no son lo mismo
ADR vs NFR explicado: aprende cómo los requisitos de calidad del sistema impulsan las decisiones de arquitectura, cómo los ADR registran las compensaciones y por qué la validación se mantiene separada.