
Guía Completa sobre Disparadores de Reversión en Runbooks de IA Empresarial
# Guía de Disparadores de Reversión
## Introducción a los Disparadores de Reversión
En los runbooks de IA empresarial, los Disparadores de Reversión actúan como salvaguardas automatizadas que detectan problemas de implementación y revierten a una versión estable anterior. Estos disparadores son fundamentales para minimizar el tiempo de inactividad, proteger la experiencia del usuario y garantizar el cumplimiento en entornos de IA de alto riesgo. Al definir condiciones precisas para la reversión, los equipos pueden responder a fallos en segundos en lugar de horas.
Los Disparadores de Reversión se integran perfectamente con pipelines de CI/CD, herramientas de monitorización y métricas específicas de IA como la deriva del modelo o picos de latencia de inferencia.
## Beneficios Clave de los Disparadores de Reversión
- **Recuperación Rápida**: Revierte automáticamente los cambios en segundos tras detectar problemas. - **Reducción de Errores Humanos**: Elimina la intervención manual en situaciones de pánico. - **Garantía de Cumplimiento**: Registra todos los eventos de disparo para pistas de auditoría. - **Ahorro de Costos**: Evita la exposición prolongada a modelos defectuosos que generan altos costos de cómputo. - **Escalabilidad**: Maneja miles de microservicios o variantes de modelos sin esfuerzo.
## Tipos de Disparadores de Reversión
### 1. Disparadores Basados en Métricas
Monitorea KPIs cuantitativos como: - Tasas de error superiores al 5%. - Aumentos de latencia superiores a 200ms p95. - Picos de utilización de CPU/memoria superiores al 90%.
### 2. Disparadores de Detección de Anomalías
Aprovecha la detección de anomalías impulsada por IA: - Caídas repentinas en la precisión del modelo. - Patrones de tráfico inusuales que indican fallos en pruebas A/B. - Puntuaciones de deriva de datos que superan umbrales predefinidos.
### 3. Disparadores de Canary y Blue-Green
Disparadores específicos de implementación: - Fallo en el despliegue canary (ej. <80% de instancias saludables). - Reversión blue-green ante discrepancias en el tráfico de sombra.
### 4. Disparadores Manuales y Externos
- Endpoints de API para reversiones bajo demanda. - Integración con PagerDuty o Slack para anulación humana.
## Configuración de Disparadores de Reversión: Paso a Paso
### Paso 1: Definir las Condiciones del Disparador
En la configuración YAML de tu runbook:
- Establecer umbrales: `error_rate > 0.05 for 2m`. - Especificar ventanas de evaluación: Promedios móviles de 5 minutos. - Añadir histéresis para evitar flapping: `>5% up, <3% down`.
### Paso 2: Seleccionar el alcance del rollback
Elegir granularidad: - **Nivel de modelo**: Revertir versiones específicas de modelos de IA. - **Nivel de servicio**: Realizar rollback de todo el microservicio. - **Nivel de clúster**: Revertir despliegues de Kubernetes.
### Paso 3: Integrar la monitorización
Conectar a herramientas como Prometheus, Datadog o plataformas personalizadas de observabilidad de IA:
- Exportar métricas mediante el endpoint `/metrics`. - Definir alertas con consultas `PromQL`. - Habilitar notificaciones webhook para sistemas externos.
### Paso 4: Probar los triggers
- **Modo Dry-Run**: Simular fallos sin realizar rollbacks reales. - **Ingeniería del caos**: Inyectar fallos con herramientas como Gremlin. - **Reproducción histórica**: Probar con datos de incidentes pasados.
### Paso 5: Desplegar y monitorizar
- Desplegar mediante GitOps (ArgoCD, Flux). - Configurar paneles para el historial de triggers. - Revisar falsos positivos semanalmente.
## Mejores prácticas para triggers de rollback efectivos
- **Lógica multi-trigger**: Usar combinaciones AND/OR (ej. alto error Y latencia). - **Períodos de gracia**: Permitir 30-60s de calentamiento tras el despliegue. - **Fijación de versión**: Siempre hacer rollback a versiones conocidas y estables, no a la última. - **Prevención de fatiga de alertas**: Agrupar métricas relacionadas en triggers compuestos. - **Análisis post-rollback**: Generar informes de incidentes automáticamente.
## Errores comunes y soluciones
| Error | Solución | |--------|----------| | Falsos positivos | Aumentar la ventana de evaluación y añadir múltiples condiciones. | | Detección lenta | Usar intervalos de sondeo inferiores al minuto. | | Rollbacks incompletos | Verificar el éxito del rollback con comprobaciones de salud. | | Triggers demasiado agresivos | Implementar rollbacks por etapas (50% -> 100%). |
## Funcionalidades avanzadas
- **Triggers optimizados con ML**: Ajustar automáticamente los umbrales mediante aprendizaje por refuerzo. - **Triggers federados**: Coordinar rollbacks en entornos multi-cloud. - **Triggers predictivos**: Usar pronósticos de series temporales para anticipar problemas.
## Monitorización y mantenimiento
Seguimiento de estos KPIs: - Tasa de activación de triggers (objetivo: <1% de despliegues). - Tiempo medio hasta el rollback (objetivo: <30s). - Tasa de éxito de rollbacks (objetivo: 99.9%).
Auditar regularmente las configuraciones durante las revisiones de sprint.
## Conclusión
Los Disparadores de Reversión transforman los despliegues de IA de experimentos arriesgados en sistemas de producción confiables. Al definir y refinar proactivamente estos mecanismos, los equipos empresariales logran una estabilidad y velocidad sin precedentes. Comience con disparadores de métricas básicas y evolucione hacia la detección de anomalías impulsada por IA para obtener resultados óptimos.
Related Articles
De un protocolo de investigación a un marco general de razonamiento de IA
Una metodología desarrollada para la investigación rigurosa asistida por IA puede generalizarse mucho más allá de la propia investigación. Al separar la evidencia de los supuestos, poner a prueba hipótesis competidoras, controlar el encuadre del prompt, buscar contraevidencia y aplicar validadores específicos del dominio, la misma arquitectura de razonamiento puede mejorar la depuración, el diseño de software, la estrategia, el análisis técnico y el soporte a la toma de decisiones asistido por IA.
OpenAI Agents API vs Agents SDK vs Responses API: ¿Sobre qué deberías construir en 2026?
El stack de agentes de OpenAI cambió en septiembre de 2026. Esta guía de arquitectura separa la Agents API, el Agents SDK, la Responses API y el Codex SDK por propiedad del runtime—para que los equipos puedan elegir el límite de control adecuado en lugar de comparar nombres de productos.
Cómo saber si un agente de IA realmente utilizó la evidencia correcta
Un agente de IA puede citar fuentes y aun así usar la evidencia incorrecta. Este artículo presenta un método práctico para verificar el respaldo de las afirmaciones, la autoridad de la fuente, la aplicabilidad, la procedencia y si la evidencia realmente influyó en la respuesta.
Google I/O 2026: Productos agénticos en Búsqueda, Workspace y Shopping
Google I/O 2026 demostró que la IA agéntica está yendo más allá de las demostraciones de modelos y las herramientas para desarrolladores hacia las superficies de productos cotidianos. Este artículo desglosa cómo Search, Workspace, Gemini Spark y Universal Cart apuntan hacia un nuevo modelo de producto donde los agentes de Google ayudan a los usuarios a investigar, trabajar, comprar y actuar a través de servicios conectados.
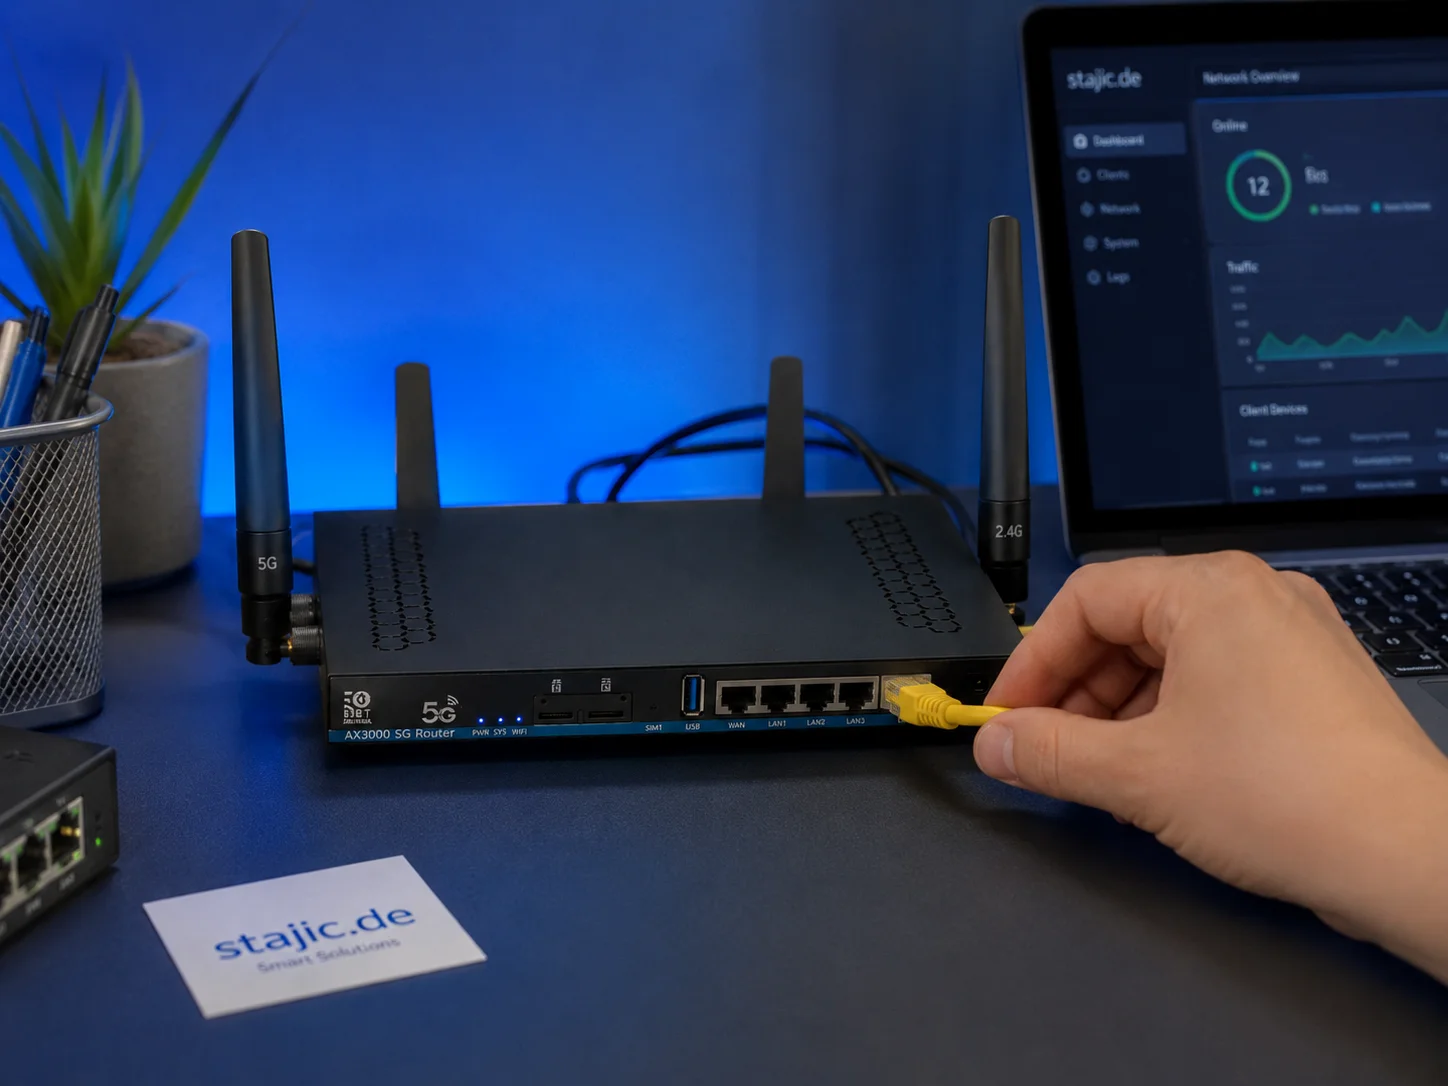
Reseña del firmware OpenWrt 21.02 de ZBT Z8102AX: lo suficientemente estable, pero ¿está preparado para el futuro?
El ZBT Z8102AX ejecuta una compilación de OpenWrt 21.02 modificada por el proveedor con el kernel 5.4.246. En las pruebas prácticas, el firmware funcionó correctamente y mantuvo el router estable durante varios días, pero la base antigua plantea preguntas importantes sobre la seguridad, el control del módem, las rutas de actualización y la mantenibilidad a largo plazo.
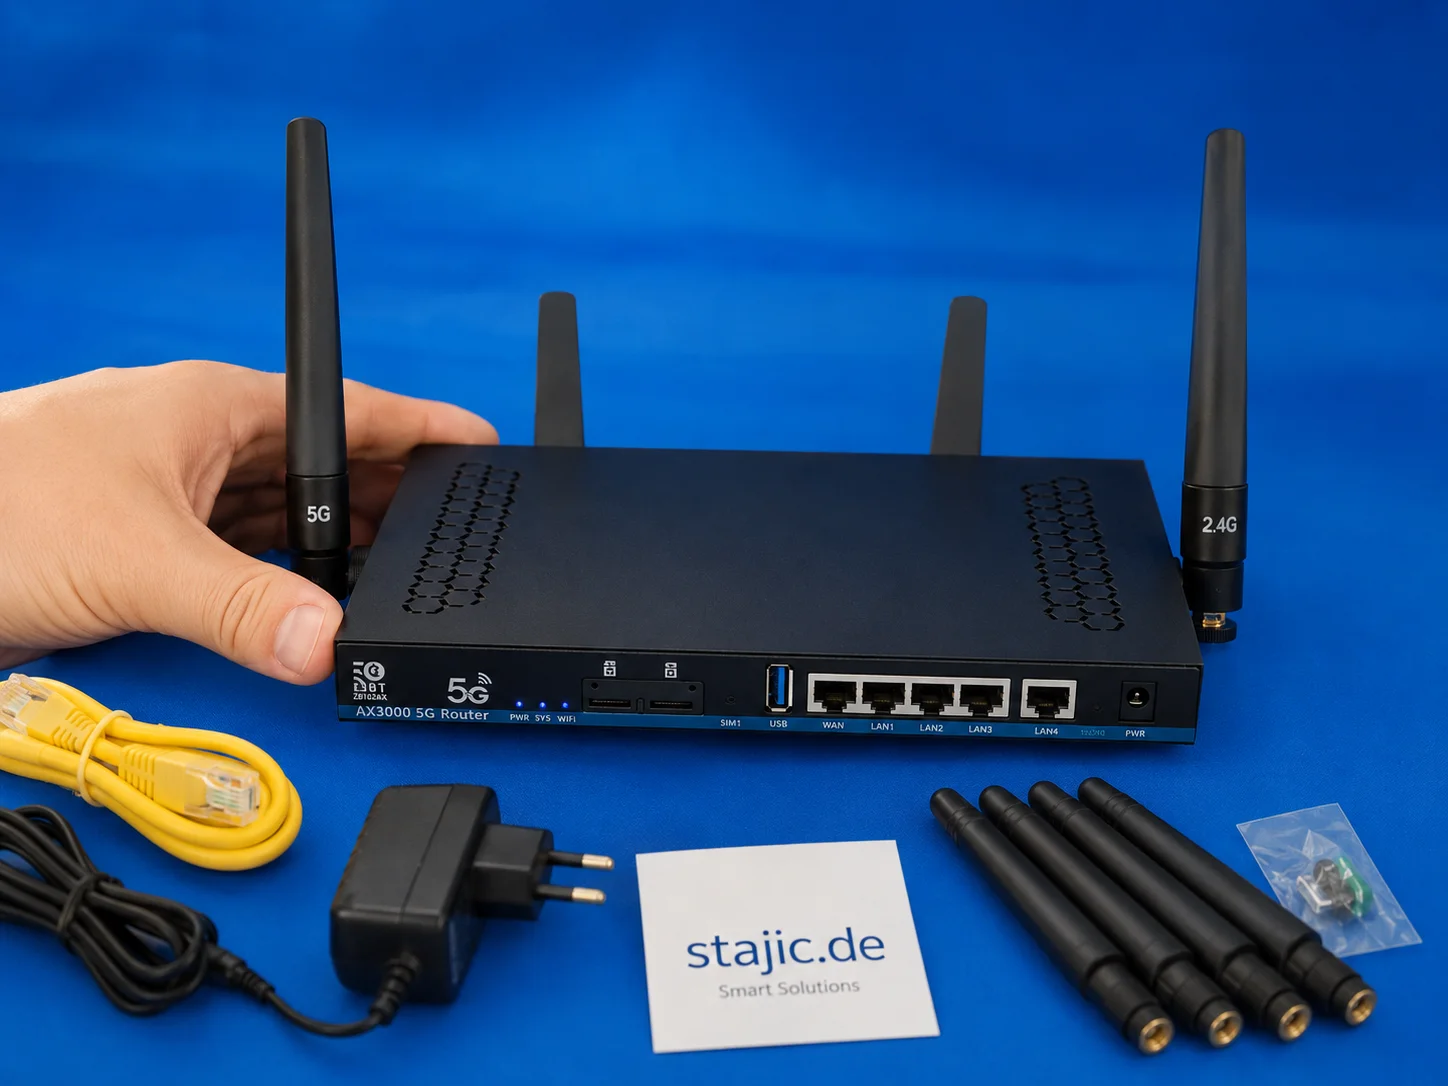
El próximo router OpenWrt 5G: por qué importan el Wi-Fi 7, una CPU más potente y un mejor firmware
El ZBT Z8102AX es una primera muestra útil, pero el siguiente paso debería ser más fuerte: Wi-Fi 7, una plataforma de cuatro núcleos más potente, una mejor claridad del firmware, un embalaje mejorado y una política de precios más estable. El objetivo no es solo otro router 5G, sino un dispositivo prosumer basado en OpenWrt mejor configurado.
Google I/O 2026: Antigravity, AI Studio y el cambio hacia las DevTools agénticas
Google I/O 2026 dejó una cosa clara para los ingenieros: las herramientas de IA están yendo más allá del autocompletado hacia la ejecución agéntica gestionada. Este artículo desglosa Antigravity 2.0, el papel en expansión de Google AI Studio, Gemini 3.5 Flash y los verdaderos compromisos en torno a la orquestación, la dependencia del proveedor, la verificación y el diseño del flujo de trabajo del desarrollador.
Agentes de uso de computadoras: por qué una demostración exitosa aún puede ser un sistema poco confiable
Los agentes de uso de computadoras ahora pueden completar impresionantes flujos de trabajo en el navegador y en el escritorio, pero una ejecución exitosa demuestra capacidad—no fiabilidad. Este artículo muestra cómo probar la repetibilidad, la robustez ambiental, el control de horizonte largo, la conciencia del estado, la verificación de resultados y la gestión segura de objetivos.
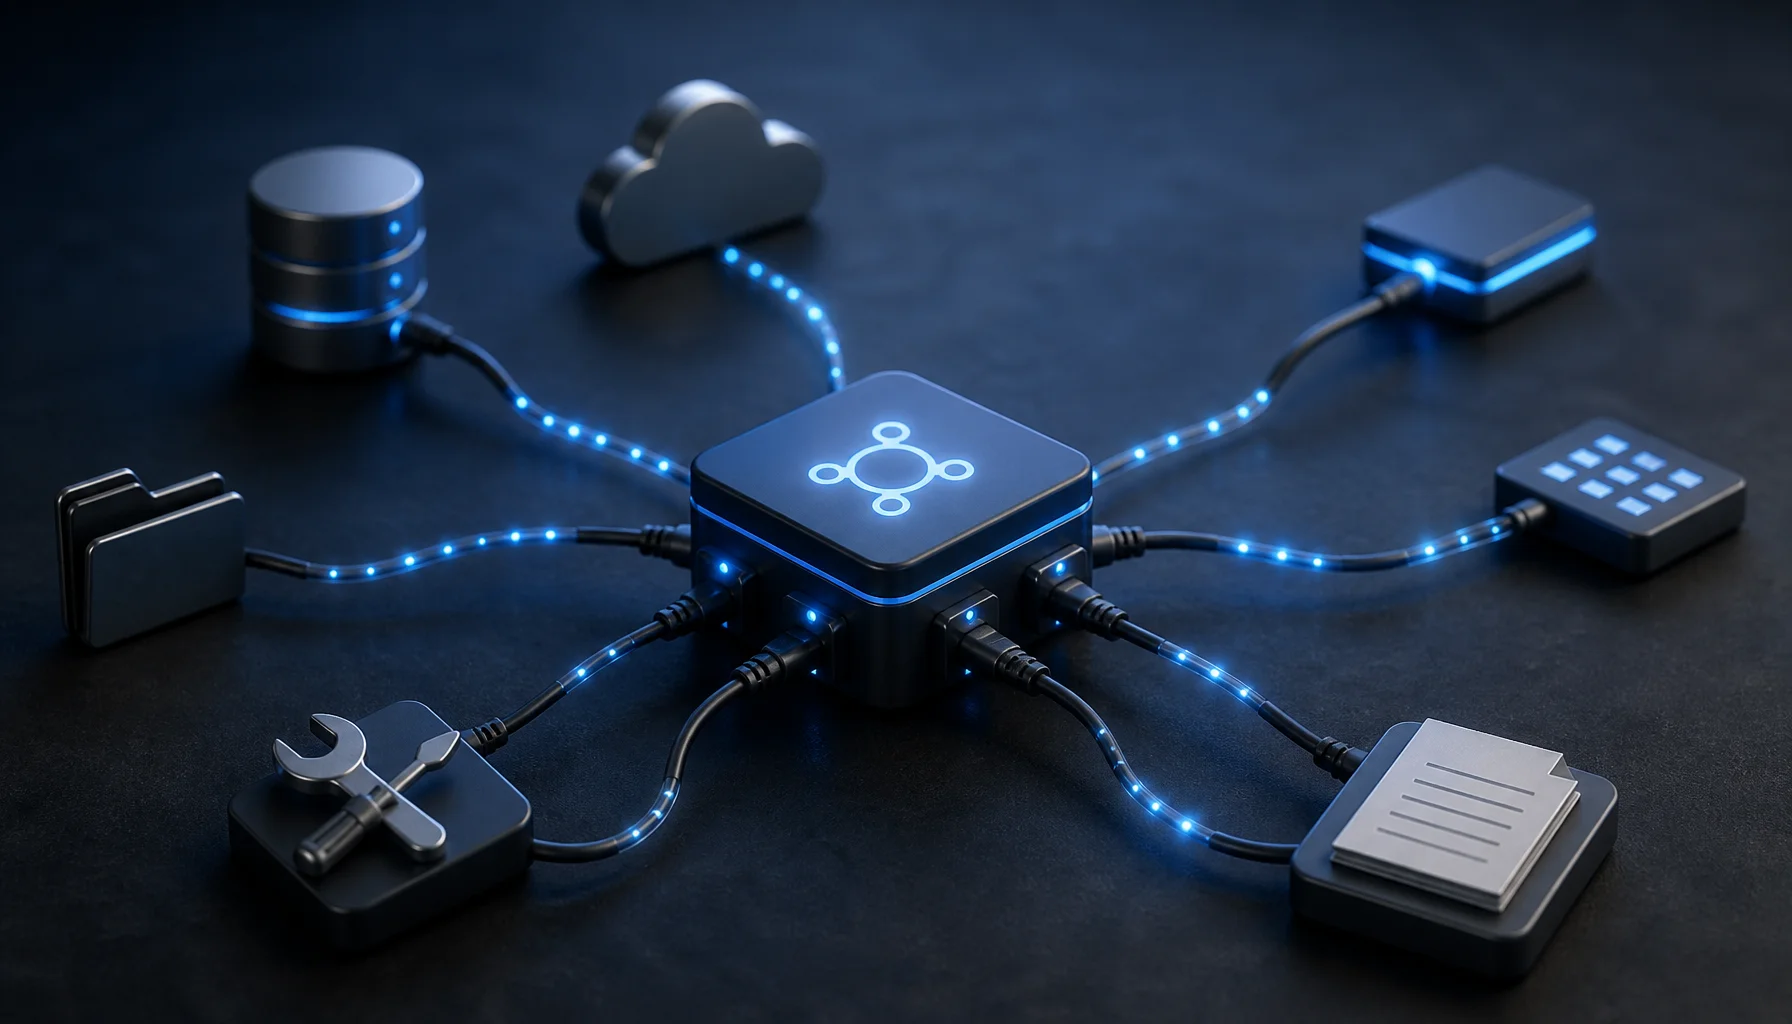
MCP explicado: qué conecta, qué no hace y dónde encaja
El Protocolo de Contexto de Modelo conecta aplicaciones de IA con herramientas, recursos y prompts externos a través de un límite estándar cliente-servidor. Aprende qué hace MCP, qué no hace y dónde encaja en la arquitectura de agentes.
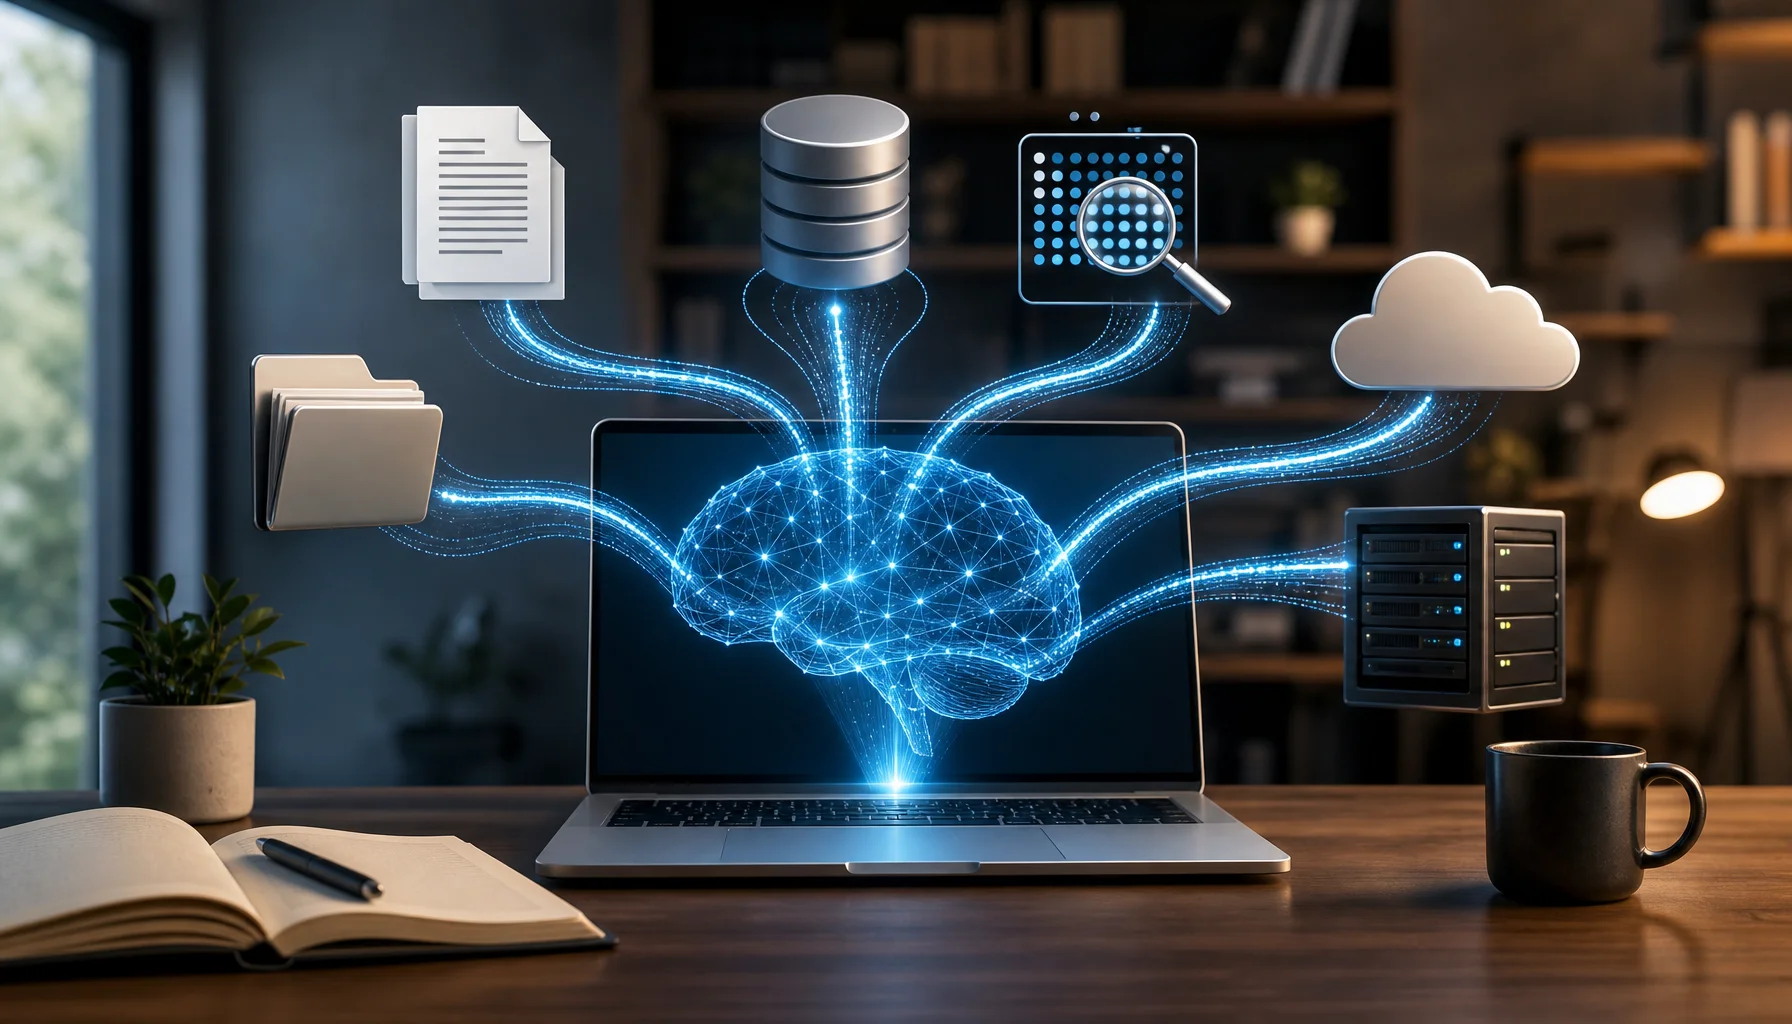
¿De dónde obtiene sus datos un LLM? Fuentes de datos RAG en Python
Un LLM no conoce mágicamente tus archivos, bases de datos o APIs. Esta continuación práctica de la serie RAG muestra, con Python sencillo, cómo los datos externos se convierten en evidencia recuperable: desde archivos de texto y SQL hasta búsqueda de texto completo, embeddings, ensamblaje de contexto y la llamada final al LLM.
ADR vs NFR: Las decisiones de arquitectura y la calidad del sistema no son lo mismo
ADR vs NFR explicado: aprende cómo los requisitos de calidad del sistema impulsan las decisiones de arquitectura, cómo los ADR registran las compensaciones y por qué la validación se mantiene separada.
Enterprise Start Here: Your Gateway to Operational Excellence
New to our enterprise platform? This guide provides a structured onboarding path, from foundational reference models to actionable playbooks, runbooks, and assessments designed for seamless implementation.