
Guía Integral de Métricas para Entrega y Gestión del Cambio
# Guía completa de métricas para la entrega y la gestión del cambio
En entornos empresariales, la entrega efectiva y la gestión del cambio dependen de información basada en datos. Las métricas sirven como base para evaluar el rendimiento, identificar cuellos de botella y garantizar la alineación con los objetivos estratégicos. Esta guía abarca las métricas principales en los flujos de entrega, los procesos de cambio y la realización general del valor, con pasos prácticos para su implementación.
## Por qué importan las métricas en la entrega y el cambio
Las métricas transforman las opiniones subjetivas en datos objetivos, permitiendo a los equipos: - Hacer seguimiento del progreso frente a los objetivos - Predecir y mitigar riesgos - Optimizar la asignación de recursos - Demostrar el ROI a las partes interesadas
Sin métricas sólidas, las organizaciones corren el riesgo de esfuerzos aislados, tiempos de inactividad prolongados y transformaciones fallidas.
## Métricas principales de entrega
### 1. Frecuencia de implementación Mide la frecuencia con la que se implementa código en producción. - **Objetivo**: Diaria o varias veces al día para los mejores desempeños (estándares DORA) - **Cálculo**: Número de implementaciones por día/semana/mes - **Pasos prácticos**: 1. Integrar el seguimiento de implementaciones en tu pipeline de CI/CD 2. Segmentar por entorno (desarrollo/staging/producción) 3. Comparar con los estándares de la industria
### 2. Tiempo de entrega para cambios Tiempo desde el commit hasta la implementación en producción. - **Objetivo**: Menos de un día - **Cálculo**: Tiempo promedio de todos los cambios - **Pasos prácticos**: 1. Usar herramientas como GitHub Actions o Jenkins para el registro automatizado 2. Identificar retrasos en las etapas de revisión, pruebas o aprobación 3. Automatizar donde sea posible para reducir cuellos de botella humanos
### 3. Tasa de fallos en cambios Porcentaje de implementaciones que causan fallos en producción. - **Objetivo**: 0-15% - **Cálculo**: (Cambios fallidos / Total de cambios) × 100 - **Pasos prácticos**: 1. Definir 'fallo' (por ejemplo, rollback, hotfix, servicio degradado >1h) 2. Implementar lanzamientos canary y feature flags 3. Realizar análisis post-mortem de los fallos
### 4. Tiempo medio de recuperación (MTTR) Tiempo promedio para restaurar el servicio tras un fallo. - **Objetivo**: Menos de una hora - **Cálculo**: Tiempo total de inactividad / Número de incidentes - **Pasos prácticos**: 1. Configurar alertas con PagerDuty u Opsgenie 2. Automatizar los procedimientos de rollback 3. Ejecutar simulacros de ingeniería del caos
## Métricas clave de gestión del cambio
### 1. Tasa de éxito de cambios Proporción de cambios implementados sin problemas. - **Objetivo**: >85% - **Cálculo**: (Cambios exitosos / Total de cambios) × 100 - **Pasos prácticos**: 1. Estandarizar las plantillas de solicitud de cambios 2. Exigir evaluaciones de riesgo y revisiones por pares 3. Hacer seguimiento mediante herramientas ITSM como ServiceNow
### 2. Volumen de cambios y backlog Número de cambios procesados frente a los pendientes. - **Objetivo**: Backlog <10% del volumen mensual - **Cálculo**: Cambios pendientes / Total enviados - **Pasos prácticos**: 1. Priorizar mediante el método MoSCoW 2. Implementar comités asesores de cambios (CAB) 3. Supervisar el tiempo de ciclo desde la solicitud hasta la aprobación
### 3. Porcentaje de cambios de emergencia Proporción de cambios urgentes respecto al total de cambios. - **Objetivo**: <10% - **Cálculo**: (Cambios de emergencia / Total) × 100 - **Pasos prácticos**: 1. Analizar las causas raíz de las emergencias 2. Pasar al mantenimiento proactivo 3. Exigir revisiones post-cambio
## Métricas de realización del valor
### 1. Valor empresarial entregado Cuantifica el impacto de los cambios en los resultados clave. - **Ejemplos**: Aumento de ingresos, ahorro de costos, participación de usuarios - **Cálculo**: Delta de KPIs antes/después del cambio - **Pasos prácticos**: 1. Etiquetar los cambios con los resultados empresariales esperados 2. Usar marcos OKR para la alineación 3. Informar cuadros de mando trimestrales de valor
### 2. Satisfacción del cliente (CSAT) Retroalimentación sobre los cambios entregados. - **Objetivo**: >4/5 puntos - **Cálculo**: Puntuación media de la encuesta posterior a la implementación - **Pasos prácticos**: 1. Automatizar encuestas NPS/CSAT 2. Correlacionar con las métricas de implementación 3. Iterar según la retroalimentación cualitativa
## Implementación de un marco de métricas
1. **Seleccionar métricas**: Comience con las cuatro métricas clave de DORA y luego añada otras específicas del cambio. 2. **Herramientas**: Utilice plataformas de observabilidad (Datadog, New Relic) integradas con ITSM. 3. **Paneles**: Cree vistas en tiempo real en Grafana o Tableau. 4. **Comparación**: Compare con sus pares del sector mediante el informe Accelerate State of DevOps. 5. **Frecuencia de revisión**: Revisiones semanales del equipo y actualizaciones mensuales para la dirección. 6. **Bucles de acción**: Vincule las métricas a las retrospectivas y a la planificación de PI.
## Errores comunes y mejores prácticas
- **Error**: Métricas vanidosas (por ejemplo, líneas de código) – Céntrese en los resultados. - **Mejor práctica**: El contexto importa; segmente por equipo/servicio. - **Error**: Sobrecargar con métricas – Limítese a 7-10 métricas principales. - **Mejor práctica**: Automatice la recopilación para garantizar la precisión.
Refine periódicamente sus métricas para reflejar las prioridades en evolución. Para el éxito a escala empresarial, integre estas métricas en sus modelos de referencia para la entrega y el cambio.
Related Articles
Agentes de uso de computadoras: por qué una demostración exitosa aún puede ser un sistema poco confiable
Los agentes de uso de computadoras ahora pueden completar impresionantes flujos de trabajo en el navegador y en el escritorio, pero una ejecución exitosa demuestra capacidad—no fiabilidad. Este artículo muestra cómo probar la repetibilidad, la robustez ambiental, el control de horizonte largo, la conciencia del estado, la verificación de resultados y la gestión segura de objetivos.
Ollama no es el producto: Construcción de aplicaciones de LLM abiertos listas para producción
Ejecutar un modelo local con Ollama es fácil. Construir una aplicación Open-LLM lista para producción es más difícil: requiere RAG, control de acceso, abstracción de proveedores, evaluación, registro, disciplina de despliegue y una capa de aplicación controlada alrededor del modelo.
La memoria del agente de IA no es RAG: cómo separar memoria, recuperación, estado y contexto
La memoria del agente, RAG, el estado y el contexto a menudo se usan como si fueran intercambiables. No lo son. Este modelo práctico de arquitectura separa las cuatro capas, muestra dónde pertenece cada una y explica qué se rompe cuando los sistemas las colapsan en una sola.
Guía Definitiva de Criterios de Aceptación para la Adopción de LLM en Playbooks Empresariales
Domina el arte de definir criterios de aceptación precisos para garantizar una integración exitosa de LLM en tu entorno empresarial. Esta guía integral proporciona marcos accionables, ejemplos y mejores prácticas adaptados para la adopción impulsada por playbooks.
Google I/O 2026: Gemini Omni, Gemini 3.5 y la capa de cómputo detrás de la IA agéntica
Google I/O 2026 situó a Gemini Omni y Gemini 3.5 en el centro de la estrategia de IA agéntica de Google. Este artículo desglosa la diferencia entre la creación multimodal y la inteligencia de grado de acción, por qué Gemini 3.5 Flash es importante para los agentes y la codificación, y cómo estos modelos impulsan el cambio de plataforma más amplio de Google I/O 2026.
Falsación para el razonamiento de IA: De respuestas a hipótesis comprobadas
Los modelos de IA pueden generar evidencia convincente para casi cualquier hipótesis plausible. Una metodología más fiable plantea la pregunta opuesta: ¿qué evidencia debilitaría, contradiría o nos obligaría a abandonar la conclusión? Este artículo desarrolla un razonamiento orientado a la falsación para los LLM utilizando hipótesis rivales, pruebas discriminantes, contraevidencia y criterios de rechazo explícitos.
ADR vs NFR: Las decisiones de arquitectura y la calidad del sistema no son lo mismo
ADR vs NFR explicado: aprende cómo los requisitos de calidad del sistema impulsan las decisiones de arquitectura, cómo los ADR registran las compensaciones y por qué la validación se mantiene separada.
Una Arquitectura Monorepo Práctica con Next.js, Fastify, Prisma y NGINX
Explora una arquitectura monorepo práctica utilizando Next.js, Fastify, Prisma y NGINX, destacando la integración y el flujo de trabajo en el mundo real.
Migrar del SDK de Agentes de OpenAI a la API de Agentes: ¿Qué cambia realmente a nivel arquitectónico?
Migrar del SDK de OpenAI Agents a la nueva API de Agents no es un simple cambio de nombre de importación. El límite del entorno de ejecución cambia: el bucle del agente, la sesión duradera, la orquestación, la compactación de contexto y la recuperación se trasladan hacia un harness gestionado. Esta guía muestra qué debería migrarse, qué debería permanecer en tu aplicación y cómo demostrar la migración antes del cambio definitivo.
Arquitectura Multi-Inquilino de Grado Empresarial para una Plataforma Internacional
Loving Rocks es una plataforma de bodas de nivel empresarial diseñada con una verdadera arquitectura multiinquilino, bases de datos aisladas por inquilino e internacionalización integrada para escalabilidad global, seguridad y estabilidad operativa a largo plazo.
Enterprise Start Here: Your Gateway to Operational Excellence
New to our enterprise platform? This guide provides a structured onboarding path, from foundational reference models to actionable playbooks, runbooks, and assessments designed for seamless implementation.
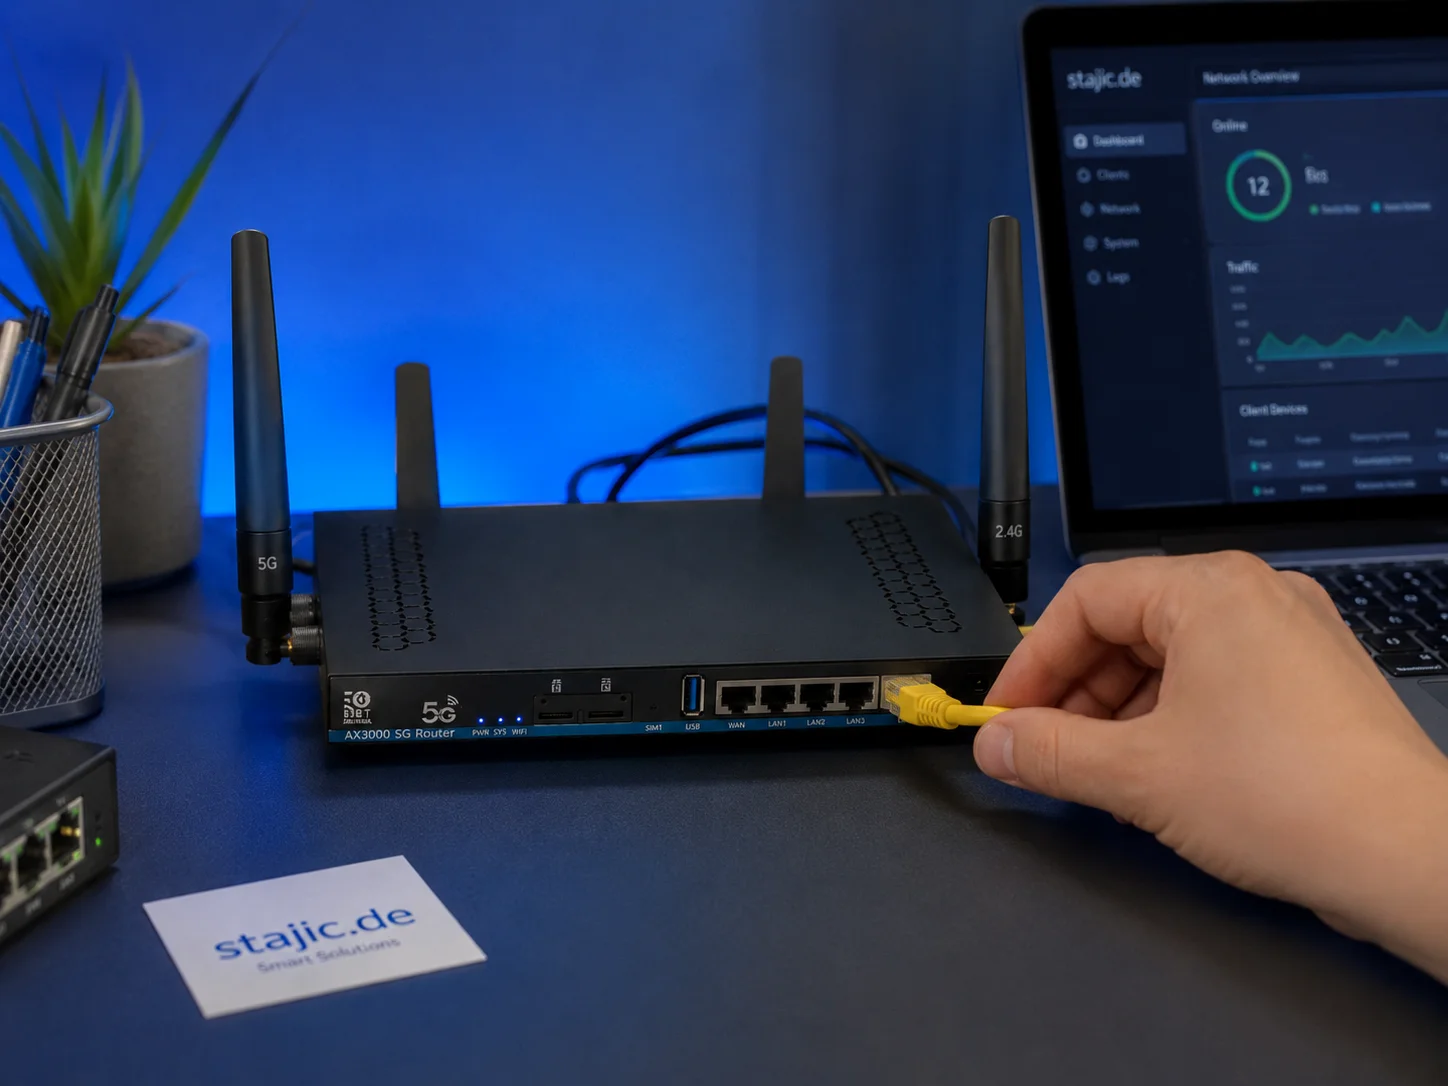
Reseña del firmware OpenWrt 21.02 de ZBT Z8102AX: lo suficientemente estable, pero ¿está preparado para el futuro?
El ZBT Z8102AX ejecuta una compilación de OpenWrt 21.02 modificada por el proveedor con el kernel 5.4.246. En las pruebas prácticas, el firmware funcionó correctamente y mantuvo el router estable durante varios días, pero la base antigua plantea preguntas importantes sobre la seguridad, el control del módem, las rutas de actualización y la mantenibilidad a largo plazo.