De un protocolo de investigación a un marco general de razonamiento de IA
La metodología desarrollada a lo largo de esta serie comenzó con un problema de investigación: ¿cómo puede un modelo de IA ayudar a investigar una cuestión compleja sin limitarse a reforzar las suposiciones ya presentes en el prompt del usuario?
Ese problema parece pertenecer inicialmente a la investigación histórica o académica. En realidad, es mucho más amplio.
La depuración de software, las decisiones de arquitectura, el diagnóstico técnico, el análisis de seguridad, la estrategia de producto y muchas formas de soporte a la toma de decisiones comparten la misma estructura subyacente. Se presenta un problema. Se dispone de cierta evidencia. Una o más explicaciones parecen plausibles. Las suposiciones se introducen en el análisis. El sistema debe determinar qué conclusión está mejor respaldada.
El dominio cambia. El problema epistémico a menudo no lo hace.
Este artículo, por lo tanto, da el siguiente paso: convertir el protocolo de investigación desarrollado en los artículos anteriores en un marco de razonamiento general para el trabajo analítico asistido por IA.
El marco se basa directamente en cuatro capas anteriores: Beyond Prompt Engineering: A Methodology for More Reliable AI Reasoning define el problema metodológico general; The Prompt Is Part of the Bias examina el encuadre y la dependencia del prompt; Prompt Invariance: Does the Conclusion Survive the Prompt? introduce una prueba de robustez frente al encuadre; y Falsification for AI Reasoning: From Answers to Tested Hypotheses añade la refutación sistemática y las hipótesis en competencia.
La generalización clave
La generalización no consiste en que cada tarea deba tratarse como una investigación histórica.
Eso sería un error de categoría.
La investigación histórica depende de la cronología, la procedencia, la transmisión, la crítica de fuentes y la exhaustividad archivística. La depuración de software depende de los registros, la configuración, la reproducibilidad, el estado de ejecución y las pruebas controladas. La arquitectura depende de los requisitos, las restricciones, las interfaces, los atributos de calidad y los compromisos operativos.
Lo que sí se puede generalizar es el proceso de razonamiento que rodea a esas formas de evidencia específicas de cada dominio.
El marco es independiente del dominio en su núcleo, pero nunca ajeno al dominio.
Esta distinción es fundamental. Una metodología de razonamiento universal no puede reemplazar a la experiencia técnica. En su lugar, puede definir cómo deben gestionarse la evidencia, las suposiciones, las hipótesis, las contradicciones y la incertidumbre antes de que la experiencia en el dominio emita el juicio final.
Un núcleo de razonamiento independiente del dominio
En todos los dominios analíticos, se puede aplicar la misma secuencia de alto nivel:
Problema → descomposición → evidencia → suposiciones → hipótesis en competencia → predicciones → contraevidencia → pruebas discriminatorias → validación de dominio → recalibración de la confianza → conclusión
El proceso evita deliberadamente que la primera explicación coherente del modelo se convierta en la respuesta definitiva por defecto.
En su lugar, la primera explicación pasa a ser una candidata.
1. Definir el problema real
Antes de generar una solución, el sistema debe determinar qué se está preguntando realmente.
Las solicitudes de los usuarios suelen contener con frecuencia tanto un problema como un diagnóstico propuesto:
¿Por qué nginx está causando los fallos de conexión de mi API?
En cambio, el problema real puede ser:
¿Qué está causando los fallos de conexión de la API?
La diferencia es pequeña lingüísticamente y enorme metodológicamente.
La primera formulación incorpora una hipótesis causal. La segunda expone esa hipótesis a la competencia.
Este es precisamente el problema de encuadre examinado en The Prompt Is Part of the Bias.
2. Separar hechos, supuestos e incógnitas
Un proceso de razonamiento fiable debe evitar que las observaciones y las interpretaciones se fusionen silenciosamente.
- Hecho: respaldado directamente por la evidencia disponible.
- Interpretación: una explicación inferida a partir de los hechos.
- Supuesto: una proposición requerida por la línea de razonamiento actual, pero no establecida de forma independiente.
- Incógnita: información necesaria para una mayor discriminación, pero no disponible actualmente.
Esta clasificación puede parecer elemental, pero resuelve un modo de fallo común en los análisis generados por IA: los supuestos se integran en una prosa fluida y luego reaparecen como si ya hubieran sido establecidos.
La trazabilidad comienza impidiendo que la inferencia se disfrace de evidencia.
3. Generar explicaciones alternativas
Una explicación candidata no debe evaluarse de forma aislada cuando existen alternativas creíbles.
Por lo tanto, el sistema debe generar varias hipótesis plausibles antes de comprometerse con una.
El propósito no es una lluvia de ideas artificial. Las alternativas deben representar mecanismos genuinamente diferentes capaces de explicar las observaciones.
Una hipótesis preferida no ha ganado si no se permitió que ningún competidor serio entrara en la prueba.
Este concepto es central en Falsification for AI Reasoning, donde las hipótesis se evalúan mediante observaciones esperadas, contraevidencia y pruebas discriminatorias en lugar de prosa de apoyo acumulada.
4. Preservar la procedencia de la evidencia
La evidencia debe seguir siendo rastreable hasta su origen.
Conclusión → interpretación → observación → fuente
Una línea de registro, una especificación técnica oficial, un experimento, un documento histórico primario, una interpretación de expertos y un resumen generado por IA no tienen el mismo estatus probatorio.
Por lo tanto, el marco no se limita a almacenar información. Debe preservar suficientes metadatos para saber de dónde provino una afirmación y qué tan lejos está la conclusión final de la observación original.
5. Derivar predicciones antes de explicar los resultados
Una vez que existen hipótesis, cada una debería generar expectativas.
Si la hipótesis es correcta, ¿qué deberíamos observar?
Si una alternativa es correcta, ¿qué debería ser diferente?
Derivar expectativas antes de interpretar toda la evidencia disponible ayuda a evitar que cada observación se adapte retroactivamente a la narrativa preferida.
6. Buscar contraevidencia
Un modelo generativo es naturalmente eficaz a la hora de construir un apoyo coherente para una idea plausible. Esto hace que la refutación sea particularmente importante.
El sistema debería preguntar explícitamente:
- ¿Qué observación debilitaría sustancialmente esta explicación?
- ¿Qué evidencia explica mal la hipótesis?
- ¿Qué alternativa explica las mismas observaciones con menos supuestos?
- ¿Qué observaciones esperadas faltan?
- ¿Podría explicarse el apoyo aparente mediante otro mecanismo?
El principio se desarrolla en detalle en Falsification for AI Reasoning: From Answers to Tested Hypotheses.
7. Probar la dependencia del prompt
La evaluación de la evidencia por sí sola no revela si el análisis del modelo sigue dependiendo excesivamente de la formulación del usuario.
Por lo tanto, para problemas suficientemente importantes, la conclusión puede volver a ponerse a prueba bajo formulaciones legítimas alternativas.
- Original: conservar la formulación del usuario.
- A ciegas: eliminar la conclusión preferida.
- Invertida: priorizar la alternativa más sólida.
- Adversarial: buscar deliberadamente el cuestionamiento basado en evidencia más sólido.
Este es el método de Invarianza de Prompts presentado en Prompt Invariance: Does the Conclusion Survive the Prompt?.
Su función no es demostrar que una respuesta estable sea verdadera. Su función es exponer conclusiones que cambian principalmente porque cambió el marco de referencia.
8. Aplicar validadores específicos del dominio
Aquí es donde el marco general deja deliberadamente de ser universal.
Cada dominio requiere sus propias reglas para determinar si una explicación es realmente creíble.
| Dominio | Validadores típicos |
| Investigación histórica | Cronología, procedencia, plausibilidad geográfica, canales de transmisión, fuentes primarias, historiografía |
| Depuración de software | Registros, reproducción, estado en tiempo de ejecución, configuración, cambios controlados, correlación de errores |
| Arquitectura de software | Requisitos, restricciones, escalabilidad, mantenibilidad, seguridad, operatividad, costo |
| Análisis de seguridad | Telemetría, ruta de ataque, permisos, indicadores observables, reproducibilidad, modelo de amenazas |
| Estrategia de producto | Evidencia de clientes, comportamiento de precios, conversión, alternativas, restricciones del mercado, criterios de fracaso |
| Gestión de proyectos | Alcance, dependencias, recursos, riesgos, criterios de aceptación, hitos, restricciones de las partes interesadas |
| Análisis científico | Diseño experimental, calidad de medición, controles, reproducibilidad, evidencia estadística, explicaciones alternativas |
El marco controla cómo se procesan las afirmaciones. Los validadores de dominio determinan si esas afirmaciones sobreviven al contacto con la realidad.
9. Recalibrar la confianza
La conclusión final no debería conservar automáticamente el nivel de confianza de la respuesta inicial.
La confianza debe recalcularse después de haber considerado alternativas, contraevidencia, variaciones de prompts y validación de dominio.
Por lo tanto, un resultado útil puede seguir siendo incierto.
- fuertemente respaldada;
- provisionalmente respaldada;
- débilmente respaldada;
- indeterminada;
- sustancialmente contradicha;
- no comprobable con la evidencia actual.
La incertidumbre no es un fallo del razonamiento cuando la evidencia misma es incierta.
El mismo marco en diferentes dominios
La forma más sencilla de comprender el marco general es observar cómo se comporta la misma arquitectura de razonamiento cuando cambia el dominio.
Investigación histórica
Problema: determinar si las similitudes entre dos tradiciones intelectuales indican una transmisión histórica.
- Separar las similitudes documentadas de los paralelismos interpretativos.
- Comparar la transmisión directa, la herencia indirecta, la convergencia y la interpretación retrospectiva.
- Comprobar la cronología y el contacto geográfico.
- Buscar rastros documentales o terminológicos.
- Identificar las pruebas esperadas en caso de transmisión directa.
- Buscar ejemplos independientes anteriores que debiliten esa hipótesis.
- Replantear la pregunta sin la genealogía preferida.
- Concluir únicamente con el nivel de certeza que respalden las pruebas supervivientes.
Depuración de software
Problema: determinar por qué una conexión API falla de forma intermitente.
- Separar los fallos observados de la causa que sospecha el desarrollador.
- Generar hipótesis sobre el proxy, la aplicación, la base de datos, la red y el cliente.
- Determinar qué registros y comportamiento en tiempo de ejecución predice cada hipótesis.
- Realizar pruebas capaces de distinguir entre ellas.
- Intentar reproducir el fallo eliminando capas.
- Rechazar explicaciones contradichas por observaciones controladas.
- Identificar el primer mecanismo de fallo confirmado en lugar de la narrativa más convincente.
Arquitectura de software
Problema: elegir una arquitectura para una nueva plataforma.
- Separar los requisitos de las preferencias de implementación.
- Comparar alternativas de monolito modular, servicios e híbridas.
- Evaluar cada opción frente a la escalabilidad, la estructura del equipo, el despliegue, la complejidad operativa y el coste.
- Identificar qué requisito exige genuinamente complejidad arquitectónica.
- Buscar diseños más simples capaces de satisfacer las mismas restricciones.
- Tratar la preferencia tecnológica como un supuesto en lugar de un requisito.
Estrategia de producto
Problema: determinar si debe comercializarse una funcionalidad de producto.
- Separar la posibilidad técnica de la demanda demostrada.
- Definir problemas de clientes alternativos y soluciones alternativas.
- Identificar el comportamiento de mercado observable que predice la tesis de negocio.
- Definir los criterios de fracaso antes de interpretar los resultados.
- Buscar pruebas de que los clientes resuelven el problema de manera diferente.
- Distinguir entre interés, disposición a probar y disposición a pagar.
Análisis de proyectos y entrega
Problema: determinar por qué un proyecto no está alcanzando los resultados planificados.
- Separar los síntomas, como los retrasos, de sus causas asumidas.
- Comparar alcance, dependencias, capacidad, requisitos, gobernanza y riesgo técnico.
- Rastrear pruebas a través de planes, decisiones, cambios y criterios de aceptación.
- Comprobar si la acción correctiva aborda el mecanismo real en lugar del síntoma visible.
- Reevaluar la hipótesis del proyecto a medida que aparecen nuevas pruebas de entrega.
Por qué esto es más que ingeniería de prompts
La ingeniería de prompts cambia la instrucción presentada a un modelo.
Un marco de razonamiento cambia el proceso a través del cual se permite que una respuesta se convierta en una conclusión.
La ingeniería de prompts optimiza una invocación. Un marco de razonamiento rige un proceso de inferencia.
Esta diferencia cobra importancia a medida que los sistemas de IA pasan de interfaces de chat hacia agentes, canalizaciones de RAG, investigación automatizada, herramientas de desarrollo y sistemas de soporte para la toma de decisiones.
Un solo prompt cuidadosamente diseñado puede mejorar una llamada al modelo. Un marco de razonamiento puede definir cómo interactúan múltiples llamadas, la evidencia recuperada, los resultados de herramientas y las etapas de validación antes de que el sistema se comprometa con una respuesta.
El marco está relacionado con —pero es diferente de— los métodos de razonamiento de LLM existentes
El panorama de investigación más amplio ya contiene varios enfoques importantes que demuestran que el rendimiento de los LLM puede mejorar cuando la inferencia se estructura como un proceso en lugar de como una sola generación.
ReAct combina el razonamiento con acciones y observaciones de un entorno externo. En lugar de depender exclusivamente del conocimiento interno del modelo, este puede actuar, observar nueva información y actualizar su siguiente paso.
Self-Refine utiliza la generación iterativa, la retroalimentación y el refinamiento, demostrando que una respuesta inicial de un LLM a menudo puede mejorarse mediante una autorretroalimentación explícita sin necesidad de entrenamiento adicional del modelo.
Reflexion utiliza retroalimentación verbal y memoria episódica para permitir que los agentes de lenguaje aprendan de intentos previos y modifiquen su comportamiento posterior.
Tree of Thoughts explora múltiples rutas de razonamiento en lugar de comprometerse de inmediato con una sola cadena lineal de izquierda a derecha, lo que permite la búsqueda, evaluación y retroceso sobre los enfoques candidatos.
Estos métodos difieren sustancialmente en propósito e implementación, pero establecen un punto general importante: la estructura en tiempo de inferencia puede cambiar materialmente el rendimiento del modelo.
El marco propuesto en esta serie aborda un objetivo principal diferente.
El objetivo no es simplemente hacer que el modelo busque durante más tiempo, reflexione más o genere una respuesta mejor. El objetivo es hacer que el camino desde la evidencia hasta la conclusión sea más resistente al encuadre, a la confirmación y a las suposiciones infundadas.
La invariancia de prompts, las pruebas orientadas a la falsación y la validación específica de dominio actúan, por tanto, como controles epistémicos en lugar de técnicas genéricas de expansión de inferencia.
Una visión por capas de la calidad del razonamiento de la IA
El sistema resultante puede entenderse como una serie de capas.
| Capa | Pregunta |
| Comprensión de la tarea | ¿Qué problema estamos resolviendo en realidad? |
| Evidencia | ¿Qué sabemos en realidad? |
| Suposiciones | ¿Qué estamos dando por sentado actualmente? |
| Hipótesis | ¿Qué mecanismos plausibles podrían explicar la evidencia? |
| Falsación | ¿Qué evidencia podría debilitar cada explicación? |
| Invarianza de prompts | ¿Depende la conclusión en exceso del encuadre? |
| Validación de dominio | ¿Satisface la explicación las reglas de la disciplina pertinente? |
| Calibración de la confianza | ¿Con cuánta seguridad se debe confiar en la conclusión superviviente? |
Una respuesta puede fallar en cualquier capa.
Puede responder correctamente al problema equivocado. Puede razonar correctamente a partir de evidencia falsa. Puede recuperar hechos correctos pero elegir la explicación causal equivocada. Puede producir una explicación sólida que desaparece cuando se replantea el prompt. O puede superar todas las comprobaciones generales de razonamiento y, aun así, infringir una restricción específica del dominio.
La corrección no es una sola propiedad. Es el resultado de varias dependencias que sobreviven simultáneamente.
Calidad de razonamiento frente a capacidad del modelo
Esto nos lleva de vuelta a una de las ideas centrales de la serie.
Un modelo más potente no implica automáticamente que cada invocación vaya a utilizar sus capacidades de la forma más rigurosa posible.
Un modelo puede poseer la capacidad de generar alternativas, inspeccionar registros, buscar fuentes, cuestionar suposiciones y revisar una conclusión. Si todas esas operaciones realmente ocurren depende de la tarea, el prompting, las herramientas disponibles, el contexto y la arquitectura del sistema circundante.
Por lo tanto, el marco de trabajo separa dos cuestiones:
- Capacidad: ¿qué puede hacer el modelo?
- Disciplina metodológica: ¿cuáles de esas capacidades deben ejercerse antes de que el sistema acepte una conclusión?
La distinción fue el punto de partida de Beyond Prompt Engineering y se vuelve aún más importante una vez que la metodología se generaliza más allá de la investigación.
No todas las tareas necesitan el marco completo
El marco no debería convertirse en una sobrecarga obligatoria para cada interacción con la IA.
Muchas tareas tienen una baja complejidad epistémica:
- formatear este JSON;
- traducir esta oración;
- convertir estas unidades;
- reescribir este mensaje;
- extraer estos campos;
- resumir este texto suministrado.
Ejecutar cuatro variantes de prompt, tres hipótesis en competencia y una fase de falsación para tales tareas añadiría coste sin un valor proporcional.
El método completo se vuelve más valioso cuando:
- la respuesta depende de la interpretación y no de una recuperación directa;
- el usuario ya tiene una explicación preferida;
- múltiples mecanismos causales son plausibles;
- la evidencia es incompleta o contradictoria;
- la decisión tiene consecuencias técnicas, financieras o de investigación significativas;
- se espera que el sistema de IA actúe de forma autónoma según la conclusión.
Por lo tanto, la profundidad metodológica debe escalar con el riesgo epistémico.
Del prompt estático a la política de razonamiento adaptativa
Una vez generalizado, el marco ya no necesita existir como un único prompt enorme.
Un sistema práctico puede decidir dinámicamente qué controles requiere una tarea.
Tarea simple → respuesta directa Tarea analítica → verificación estructurada de evidencia Tarea de alta incertidumbre → hipótesis en competencia Tarea sensible al encuadre → Invariancia del Prompt Hipótesis de altas consecuencias → falsación y validación de dominio
Esto transforma la metodología de una plantilla de prompt fija en una política de razonamiento adaptativa.
El sistema no siempre razona al máximo. Razona con el rigor que la tarea requiere.
Un marco general práctico
El proceso completo se puede resumir de la siguiente manera:
- Normalizar el problema. Eliminar las conclusiones incrustadas en la definición de la tarea cuando corresponda.
- Identificar la evidencia. Separar las observaciones de las interpretaciones.
- Exponer los supuestos. Registrar las proposiciones que aún no se han establecido.
- Generar alternativas serias. No permitir que la primera hipótesis compita solo contra hombres de paja débiles.
- Preservar la procedencia. Mantener las afirmaciones rastreables hasta sus fuentes.
- Derivar expectativas. Definir qué predice cada hipótesis.
- Buscar contraevidencia. Buscar activamente observaciones que la hipótesis preferida maneja mal.
- Ejecutar pruebas discriminantes. Preferir la evidencia que diferencia entre explicaciones.
- Probar la dependencia del encuadre. Aplicar la Invariancia del Prompt cuando el encuadre del usuario pueda influir en el resultado.
- Aplicar validadores de dominio. Usar los criterios específicos de la disciplina relevantes para el problema.
- Recalibrar la confianza. Permitir que la conclusión se debilite, quede sin resolver o cambie.
- Preservar la trazabilidad. Hacer inspeccionable el camino desde la conclusión hasta la evidencia.
Lo que el marco no afirma
- No garantiza una salida veraz.
- No elimina las alucinaciones.
- No convierte a un LLM en un experto de dominio.
- No prueba que las conclusiones estables sean correctas.
- No elimina los sesgos compartidos en todas las pasadas de razonamiento.
- No reemplaza experimentos, mediciones o fuentes primarias.
- No garantiza que se hayan generado todas las hipótesis relevantes.
- No implica que razonar más sea siempre mejor.
- No afirma que el marco completo ya haya sido validado como una metodología académica estandarizada.
Su afirmación es más limitada y más defendible: los sistemas de IA analíticos pueden volverse metodológicamente más sólidos cuando los supuestos, el encuadre, las explicaciones en competencia, la contraevidencia y la validación de dominio se manejan explícitamente en lugar de dejarse por completo a una única generación sin restricciones.
Los cuatro artículos se convierten en un sistema de razonamiento
Los artículos anteriores ahora pueden entenderse no como técnicas de prompting separadas, sino como componentes de una única arquitectura de razonamiento.
| Artículo | Función en el marco |
| Más allá de la ingeniería de prompts | Define el cambio de la generación de respuestas al razonamiento metodológico. |
| El prompt es parte del sesgo | Trata la formulación del usuario como una posible fuente de sesgo de razonamiento. |
| Invariancia del Prompt | Prueba si la conclusión sobrevive a cambios significativos en el encuadre. |
| Falsación para el razonamiento de IA | Prueba si las hipótesis sobreviven a la evidencia desconfirmatoria y a alternativas serias. |
| Del protocolo de investigación a un marco general de razonamiento de IA | Combina los controles en un núcleo independiente del dominio con validación específica del dominio. |
Juntos describen una transición:
Prompt → respuesta se convierte en Problema → evidencia → hipótesis → desafío → validación → conclusión calibrada
El principio central
La metodología comenzó con una observación simple: hacerle una pregunta a un poderoso modelo de razonamiento no significa automáticamente que se utilizará cada capacidad de razonamiento útil disponible para el modelo.
La solución no es forzar el razonamiento máximo en cada interacción.
La solución consiste en identificar qué controles de razonamiento son relevantes para la tarea y hacerlos explícitos.
Una buena metodología de IA no le dice al modelo a qué conclusión debe llegar. Define lo que una conclusión debe superar antes de ser aceptada.
Ese principio es transferible.
En la investigación histórica, la conclusión debe resistir la cronología y la crítica de fuentes. En la depuración de código, debe superar la reproducción y las pruebas discriminatorias. En la arquitectura, debe satisfacer los requisitos y las restricciones operativas. En la estrategia, debe resistir la evidencia del mercado y los criterios de fallo.
Los validadores cambian.
La disciplina metodológica permanece.
El objetivo no es un modelo que siempre piense durante más tiempo. Es un sistema que sabe cuándo una respuesta aún no está justificada.
Contexto de investigación
El marco completo descrito en esta serie es una síntesis metodológica más que un benchmark estandarizado y establecido para LLM. No obstante, varias líneas de investigación afines respaldan su premisa arquitectónica central: la calidad de la inferencia puede cambiar sustancialmente cuando la resolución de problemas mediante modelos de lenguaje se organiza como un proceso iterativo o de múltiples etapas en lugar de una sola generación.
ReAct combina el razonamiento con acciones y observaciones externas, y demostró beneficios en tareas de respuesta a preguntas, verificación de hechos y toma de decisiones interactivas. Tree of Thoughts explora múltiples rutas candidatas de razonamiento con evaluación y retroceso en lugar de comprometerse de inmediato con una sola cadena. Self-Refine mostró mejoras en diversas tareas mediante la iteración entre generación, retroalimentación y refinamiento. Reflexion demostró que los agentes de lenguaje pueden utilizar la retroalimentación verbal de intentos anteriores para mejorar decisiones posteriores sin necesidad de actualizar los pesos del modelo.
Estos enfoques no implementan la Invarianza del Prompt ni el marco orientado a la falsación que aquí se propone. Sin embargo, aportan evidencia independiente para la idea más amplia de que el procedimiento durante el tiempo de inferencia importa: la capacidad del modelo y el proceso a través del cual se ejerce esa capacidad no son idénticos.
La contribución de esta serie consiste en organizar esa perspectiva en torno a controles epistémicos: separación de evidencia, seguimiento de supuestos, análisis del encuadre del prompt, hipótesis rivales, falsación, procedencia, validación de dominio e incertidumbre calibrada.
Referencias seleccionadas
- Yao, S. et al. — ReAct: Synergizing Reasoning and Acting in Language Models. ICLR, 2023.
- Yao, S. et al. — Tree of Thoughts: Deliberate Problem Solving with Large Language Models. NeurIPS, 2023.
- Madaan, A. et al. — Self-Refine: Iterative Refinement with Self-Feedback. NeurIPS, 2023.
- Shinn, N. et al. — Reflexion: Language Agents with Verbal Reinforcement Learning. NeurIPS, 2023.
- Jhaveri, A. R., GX-Chen, A., Sucholutsky, I. & Choi, E. — Failing to Falsify: Evaluating and Mitigating Confirmation Bias in Language Models. 2026.
- Brucks, M. S. & Toubia, O. — Prompt Architecture Induces Methodological Artifacts in Large Language Models. PLOS ONE, 2025.
Serie sobre Metodología de Razonamiento en IA
- Más allá de la ingeniería de prompts: una metodología para un razonamiento de IA más confiable — por qué la capacidad del modelo por sí sola no es suficiente.
- El prompt es parte del sesgo — cómo la formulación de la tarea puede influir en el entorno de razonamiento.
- Invarianza del prompt: ¿sobrevive la conclusión al prompt? — comprobación de la estabilidad de las conclusiones frente a encuadres alternativos.
- Falsación para el razonamiento de IA: de respuestas a hipótesis contrastadas — hipótesis rivales, contraevidencia y pruebas discriminatorias.
- Del protocolo de investigación a un marco general de razonamiento para IA — integración de la metodología en un núcleo de razonamiento reutilizable e independiente del dominio.
- Una aplicación práctica de este mismo marco de razonamiento en la IA para videojuegos —incluyendo asistentes de juego, agentes autónomos, conocimiento sensible a parches y validación del estado del juego en tiempo real— se explora en When Gaming AI Sounds Right but Isn't: The Reasoning Problem Behind Game Assistants and Agents en figure.rocks.
Related Articles
Qwen 3.6 en producción: Runbook de lanzamiento, rollback de IA y versionado de LLMOps
Qwen 3.6 no es solo otra actualización de modelo. Es un evento de lanzamiento, un escenario de reversión y un problema de versionado al mismo tiempo. Este artículo explica cómo debe manejarse Qwen 3.6 en producción a través de la disciplina de LLMOps, la trazabilidad de prompts y modelos, el despliegue controlado y la preparación para la reversión basada en evidencia.
mozilla-thunderbird-68-x-kann-oauth2-fuer-provider-for-google-calendar-nicht-speichern
Google I/O 2026: Antigravity, AI Studio y el cambio hacia las DevTools agénticas
Google I/O 2026 dejó una cosa clara para los ingenieros: las herramientas de IA están yendo más allá del autocompletado hacia la ejecución agéntica gestionada. Este artículo desglosa Antigravity 2.0, el papel en expansión de Google AI Studio, Gemini 3.5 Flash y los verdaderos compromisos en torno a la orquestación, la dependencia del proveedor, la verificación y el diseño del flujo de trabajo del desarrollador.
Más allá de la ingeniería de prompts: una metodología para un razonamiento de IA más fiable
Los modelos de lenguaje grandes no necesariamente fallan porque carezcan de capacidad de razonamiento. A menudo fallan porque el proceso de razonamiento no está suficientemente restringido, cuestionado o verificado. Este artículo presenta una metodología independiente del dominio que convierte el prompting en un proceso epistémico estructurado: separar los hechos de las suposiciones, generar hipótesis en competencia, poner a prueba la contraevidencia, aplicar la falsación y comprobar si las conclusiones se mantienen estables bajo enfoques alternativos. El objetivo no es hacer que el modelo "esté menos de acuerdo", sino hacer que sus conclusiones dependan menos del enfoque inicial del usuario.
Optimización de la calidad del código: Probando con ESLint y Prettier
En el desarrollo de software moderno, mantener una calidad y un estilo de código consistentes es primordial. ESLint y Prettier ofrecen una potente combinación para automatizar estos aspectos cruciales, asegurando que las bases de código estén limpias, sean legibles y se adhieran a los estándares definidos. Este artículo profundiza en cómo estas herramientas se integran a la perfección en los flujos de trabajo de prueba, mejorando la productividad del desarrollador y la mantenibilidad del proyecto.
Optimización para motores de búsqueda: El flujo de trabajo confiable para los primeros puestos
Análisis detallado de la optimización para motores de búsqueda (SEO), sus fundamentos técnicos, el papel de los rastreadores web y los pasos estratégicos para alcanzar las primeras posiciones orgánicas.
Enterprise Start Here: Your Gateway to Operational Excellence
New to our enterprise platform? This guide provides a structured onboarding path, from foundational reference models to actionable playbooks, runbooks, and assessments designed for seamless implementation.
How to Scan and Clean Your Cloud Linux Server from Malware
Comprender y resolver conflictos de dependencias ERESOLVE de npm
Resuelve los conflictos de dependencias de pares ERESOLVE de npm de la manera correcta: identifica el desajuste real, alinea las versiones, usa overrides de forma segura y conoce cuándo pnpm o Yarn son una mejor opción.
Conversión de HEIC a JPG: Por qué deberías considerarla y cómo funciona
HEIC ofrece compresión de imagen moderna y alta calidad, pero JPG sigue siendo el formato más compatible. Esta guía explica cuándo y cómo convertir HEIC a JPG usando herramientas y automatización de Linux.
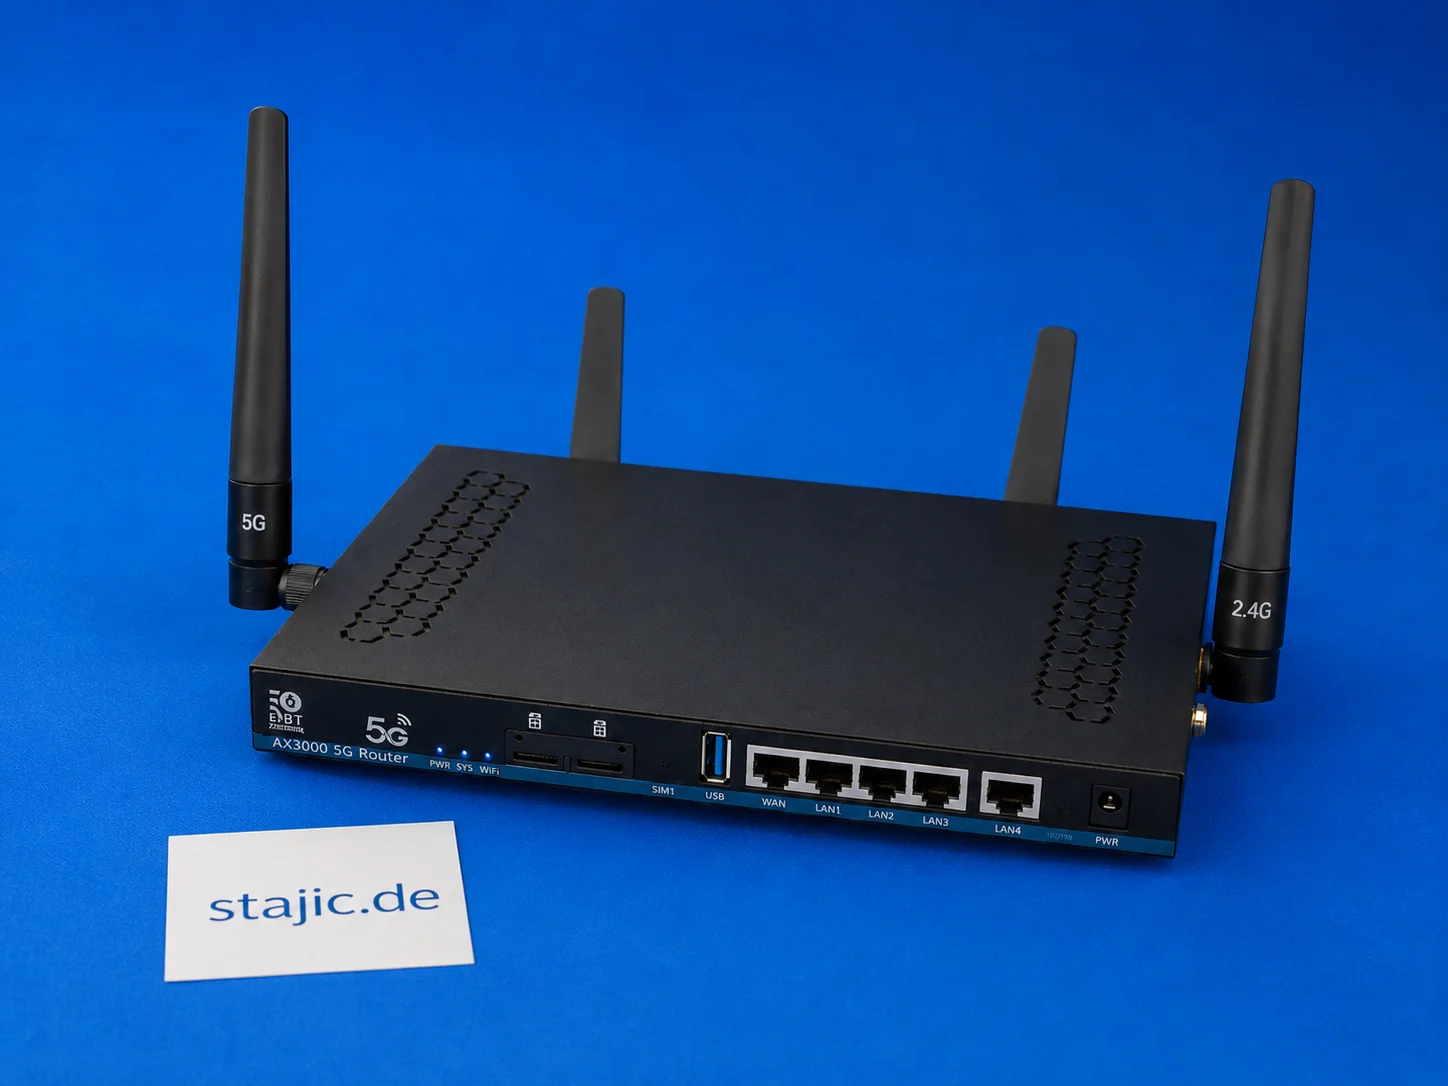
Conmutación por error de doble SIM del ZBT Z8102AX: qué funciona, qué falta y qué necesita un mejor firmware
El ZBT Z8102AX es un router OpenWrt 5G de doble SIM, pero el hardware de doble SIM por sí solo no es lo mismo que una conmutación por error inteligente. El router reconoce la SIM y se conecta correctamente, pero el cambio automático, la recuperación del módem, las decisiones basadas en la señal y una lógica de conmutación por error limpia aún necesitan pruebas más profundas.