从研究协议到通用AI推理框架
本系列所开发的方法论始于一个研究问题:AI 模型如何帮助调查一个复杂问题,而不是仅仅强化用户提示中已有的假设?
这个问题最初似乎属于历史或学术研究。实际上,它要广泛得多。
软件调试、架构决策、技术诊断、安全分析、产品策略以及许多形式的决策支持都具有相同的底层结构。一个问题被提出。一些证据可用。一个或多个解释看似合理。假设进入分析。系统必须确定哪个结论得到最好的支持。
领域会变化。认识论问题往往不会。
因此,本文采取下一步:将前几篇文章中开发的研究协议转化为 AI 辅助分析工作的通用推理框架。
该框架直接建立在四个先前层次之上:超越提示工程:更可靠 AI 推理的方法论定义了整体方法论问题;提示是偏见的一部分考察了框架和提示依赖;提示不变性:结论能在提示下存活吗?引入了针对框架的稳健性测试;以及AI 推理的证伪:从答案到经过检验的假设增加了系统性的反证和竞争性假设。
关键泛化
这种泛化并不是说每项任务都应像历史研究一样对待。
那将是一种范畴错误。
历史研究依赖于年代顺序、来源、传承、史料批判和档案完整性。软件调试依赖于日志、配置、可复现性、执行状态和受控测试。架构依赖于需求、约束、接口、质量属性和运营权衡。
可以泛化的是围绕这些领域特定证据形式的推理过程。
该框架在核心上是领域无关的,但从不脱离领域。
这一区分是根本性的。通用推理方法论不能取代专业知识。相反,它可以定义在领域专业知识产生最终判断之前,应如何处理证据、假设、竞争性假设、矛盾和不确定性。
领域无关的推理核心
跨分析领域,可以应用相同的高层序列:
问题 → 分解 → 证据 → 假设 → 竞争性假设 → 预测 → 反证 → 区分性测试 → 领域验证 → 置信度重新校准 → 结论
该过程有意防止模型第一个连贯的解释默认成为最终答案。
相反,第一个解释成为一个候选。
1. 定义实际问题
在生成解决方案之前,系统应确定实际被问及的是什么。
用户请求通常同时包含问题和提议的诊断:
为什么 nginx 导致我的 API 连接失败?
实际问题可能反而是:
是什么导致 API 连接失败?
这种差异在语言上很小,在方法论上却巨大。
第一种表述嵌入了一个因果假设。第二种则将这一假设置于竞争之中。
这正是 提示词是偏见的一部分 中所考察的框架问题。
2. 区分事实、假设和未知
可靠的推理过程必须防止观察和解释悄然合并。
- 事实:直接由现有证据支持。
- 解释:从事实中推断出的说明。
- 假设:当前推理路径所需但尚未独立确立的命题。
- 未知:进行更强区分所需但目前无法获得的信息。
这种分类可能看起来很简单,但它解决了 AI 生成分析中的一个常见失败模式:假设被嵌入流畅的文字中,随后又像已经被确立一样重新出现。
可追溯性始于防止推断伪装成证据。
3. 生成相互竞争的解释
当存在可信的替代方案时,不应孤立地评估候选解释。
因此,系统在确定一个假设之前,应生成多个合理的假设。
目的不是人为的头脑风暴。替代方案应代表能够解释观察结果的真正不同的机制。
如果没有让任何严肃的竞争者进入测试,那么一个受偏好的假设就尚未胜出。
这一概念是AI推理中的证伪的核心,其中假设通过预期观察、反证和区分性测试来评估,而不是通过累积的支持性论述。
4. 保留证据来源
证据应始终可追溯至其来源。
结论 → 解释 → 观察 → 来源
日志行、官方技术规范、实验、原始历史文献、专家解释和AI生成的摘要并不具有相同的证据地位。
因此,该框架不仅仅存储信息。它应保留足够的元数据,以了解某个主张来自何处,以及最终结论距离原始观察有多远。
5. 在解释结果之前先推导预测
一旦假设存在,每个假设都应产生预期。
如果该假设正确,我们应该观察到什么?
如果某个替代假设正确,应该有什么不同?
在解释所有可用证据之前先推导预期,有助于防止每个观察结果都被事后套入偏好的叙事中。
6. 寻找反证
生成模型自然擅长为一个看似合理的想法构建连贯的支持。这使得否证尤为重要。
系统应明确询问:
- 什么观察会显著削弱这一解释?
- 该假设对哪些证据解释得很差?
- 哪个替代假设以更少的假设解释了相同的观察?
- 哪些预期观察缺失了?
- 表面上的支持是否可能由另一种机制解释?
这一原则在AI推理中的证伪:从答案到经过检验的假设中有详细展开。
7. 测试对提示的依赖性
仅靠证据测试并不能揭示模型的分析是否仍然过度依赖于用户的表述。
因此,对于足够重要的问题,可以在其他合理的表述框架下重新检验结论。
- 原始:保留用户的表述。
- 盲测:移除偏好的结论。
- 反转:突出最强的替代方案。
- 对抗:刻意寻找最强的基于证据的挑战。
这就是提示不变性:结论能否在提示变化下存活?中介绍的提示不变性方法。
它的作用不是证明一个稳定的答案是真实的。它的作用是揭示那些主要因为表述框架改变而改变的结论。
8. 应用领域特定的验证器
这就是通用框架有意不再具有普遍性的地方。
每个领域都需要自己的规则来确定一个解释是否真正可信。
| 领域 | 典型验证器 |
| 历史研究 | 年代学、来源、地理合理性、传播渠道、原始资料、史学 |
| 软件调试 | 日志、复现、运行时状态、配置、受控变更、错误关联 |
| 软件架构 | 需求、约束、可扩展性、可维护性、安全性、可操作性、成本 |
| 安全分析 | 遥测、攻击路径、权限、可观察指标、可复现性、威胁模型 |
| 产品策略 | 客户证据、定价行为、转化、替代方案、市场约束、失败标准 |
| 项目管理 | 范围、依赖关系、资源、风险、验收标准、里程碑、利益相关者约束 |
| 科学分析 | 实验设计、测量质量、对照、可复现性、统计证据、替代解释 |
框架控制如何处理主张。领域验证器决定这些主张在与现实接触后能否存活。
9. 重新校准置信度
最终结论不应自动保留初始答案的置信水平。
在考虑了替代方案、反证、提示变化和领域验证之后,应重新计算置信度。
因此,有用的输出可以保持不确定性。
- 强烈支持;
- 暂时支持;
- 弱支持;
- 证据不足;
- 实质矛盾;
- 无法用当前证据检验。
当证据本身不确定时,不确定性不是推理的失败。
跨不同领域的同一框架
理解通用框架的最简单方法是观察当领域变化时,相同的推理架构如何表现。
历史研究
问题:确定两种思想传统之间的相似性是否表明存在历史传播。
- 将有文献记载的相似性与解释性类比区分开来。
- 比较直接传播、间接继承、趋同和回溯性解释。
- 检验年代顺序和地理接触。
- 寻找文献或术语方面的痕迹。
- 确定在直接传播假设下预期会出现的证据。
- 寻找会削弱该假设的更早的独立例证。
- 在不预设偏好谱系的情况下重新构建问题。
- 仅在现存证据所支持的置信水平上得出结论。
软件调试
问题:确定为什么API连接会间歇性失败。
- 将观察到的故障与开发者怀疑的原因区分开来。
- 生成代理、应用、数据库、网络和客户端假设。
- 确定每个假设所预测的日志和运行时行为。
- 执行能够区分这些假设的测试。
- 在逐层排除的同时尝试复现故障。
- 拒绝与受控观察相矛盾的说明。
- 确定首个被确认的故障机制,而不是最有说服力的叙述。
软件架构
问题:为新平台选择一种架构。
- 将需求与实现偏好区分开来。
- 比较模块化单体、服务和混合方案。
- 根据可扩展性、团队结构、部署、运维复杂性和成本测试每个选项。
- 确定哪项需求真正需要架构复杂性。
- 寻找能够满足相同约束的更简单设计。
- 将技术偏好视为假设而非需求。
产品战略
问题:确定一项产品能力是否应该商业化。
- 将技术可能性与已证明的需求区分开来。
- 定义替代性的客户问题和替代性解决方案。
- 确定商业论点所预测的可观察市场行为。
- 在解释结果之前定义失败标准。
- 寻找客户以不同方式解决问题的证据。
- 区分兴趣、测试意愿和付费意愿。
项目与交付分析
问题:确定为什么项目未能实现计划成果。
- 将延迟等症状与其假定原因区分开来。
- 比较范围、依赖关系、能力、需求、治理和技术风险。
- 通过计划、决策、变更和验收标准追踪证据。
- 检验纠正措施是否针对实际机制而非可见症状。
- 随着新的交付证据出现,重新评估项目假设。
为什么这不仅仅是提示工程
提示工程改变的是呈现给模型的指令。
推理框架改变的是允许答案成为结论的过程。
提示工程优化一次调用。推理框架治理一个推理过程。
该框架与现有LLM推理方法相关——但有所不同
目标不仅仅是让模型搜索更久、反思更多或生成更好的答案。目标是使从证据到结论的路径更能抵抗框架效应、确认偏差和无根据的假设。
AI推理质量的分层视角
| 层次 | 问题 |
| 任务理解 | 我们实际要解决的是什么问题? |
| 证据 | 我们实际知道什么? |
| 假设 | 我们目前将什么视为理所当然? |
| 假说 | 哪些可能的机制可以解释证据? |
| 证伪 | 什么证据可能削弱每种解释? |
| 提示不变性 | 结论是否过度依赖于表述框架? |
| 领域验证 | 该解释是否满足相关学科的规则? |
| 置信度校准 | 幸存的结论应被多大程度地信任? |
正确性不是单一属性。它是多个依赖关系同时成立的结果。
推理质量与模型能力
这又回到了本系列的核心思想之一。
更强大的模型并不自动意味着每次调用都会以最严谨的方式运用其能力。
模型可能具备生成替代方案、检查日志、搜索来源、质疑假设并修正结论的能力。这些操作是否实际发生,取决于任务、提示方式、可用工具、上下文以及周围的系统架构。
因此,该框架区分了两个问题:
- 能力:模型能做什么?
- 方法论纪律:在系统接受结论之前,必须行使哪些能力?
这一区分是超越提示工程的起点,并且当该方法论从研究领域推广到更广泛场景时,其重要性更加凸显。
并非每项任务都需要完整框架
该框架不应成为每次AI交互的强制性开销。
许多任务的认识复杂度较低:
- 格式化此JSON;
- 翻译这句话;
- 转换这些单位;
- 重写这条消息;
- 提取这些字段;
- 总结所提供的文本。
对此类任务运行四种提示变体、三个竞争假设和一个证伪阶段,会增加成本而不会带来成比例的价值。
完整方法在以下情况下更有价值:
- 答案取决于解释而非直接检索;
- 用户已有偏好的解释;
- 多种因果机制都看似合理;
- 证据不完整或相互矛盾;
- 决策具有重大的技术、财务或研究后果;
- AI系统被期望根据结论自主行动。
因此,方法论深度应随认识风险而扩展。
从静态提示到自适应推理策略
一旦推广,该框架就不再需要作为一个庞大的提示存在。
一个实用的系统可以动态地决定一项任务需要哪些控制措施。
简单任务 → 直接回答 分析性任务 → 结构化证据检查 高不确定性任务 → 竞争性假设 框架敏感任务 → 提示不变性 高后果假设 → 证伪与领域验证
这将方法论从固定的提示模板转变为自适应的推理策略。
系统并不总是进行最大程度的推理。它根据任务所需的严格程度进行推理。
一个实用的通用框架
完整流程可总结如下:
- 规范化问题。 在适当情况下,从任务定义中移除嵌入的结论。
- 识别证据。 将观察与解释分开。
- 暴露假设。 记录尚未确立的命题。
- 生成严肃的替代方案。 不要让第一个假设只与薄弱的稻草人竞争。
- 保留来源。 保持主张可追溯至其来源。
- 推导预期。 定义每个假设所预测的内容。
- 寻找反证。 主动寻找首选假设处理不佳的观察结果。
- 进行区分性测试。 优先选择能区分不同解释的证据。
- 测试框架依赖性。 当用户的框架可能影响结果时,应用提示不变性。
- 应用领域验证器。 使用与问题相关的学科特定标准。
- 重新校准置信度。 允许结论减弱、保持未解决或改变。
- 保留可追溯性。 使从结论回到证据的路径可检查。
该框架不声称的内容
- 它不保证输出真实。
- 它不消除幻觉。
- 它不使LLM成为领域专家。
- 它不证明稳定的结论是正确的。
- 它不消除所有推理过程中共有的偏见。
- 它不替代实验、测量或原始来源。
- 它不保证所有相关假设都已生成。
- 它不意味着更多推理总是更好。
- 它不声称完整框架已被验证为标准化的学术方法论。
其主张更为狭窄且更具辩护性:当假设、框架、竞争性解释、反证和领域验证被明确处理,而不是完全留给一次无约束的生成时,分析性AI系统可以在方法论上变得更强。
四篇文章构成一个推理系统
之前的文章现在可以理解为不是独立的提示技术,而是一个推理架构的组成部分。
| 文章 | 在框架中的功能 |
| 超越提示工程 | 定义了从答案生成到方法论推理的转变。 |
| 提示是偏见的一部分 | 将用户的表述视为推理偏见的可能来源。 |
| 提示不变性 | 测试结论是否在框架的有意义变化中保持不变。 |
| AI推理的证伪 | 测试假设是否在反证和严肃的替代方案中存活。 |
| 从研究协议到通用AI推理框架 | 将控制措施组合成一个与领域无关的核心,并带有领域特定的验证。 |
它们共同描述了一个转变:
提示 → 答案 变为 问题 → 证据 → 假设 → 挑战 → 验证 → 校准结论
核心原则
该方法论始于一个简单的观察:向一个强大的推理模型提问并不自动意味着模型可用的所有有用推理能力都会被使用。
解决方案不是将最大推理强加到每一次交互中。
解决方案是确定哪些推理控制对任务重要,并将其明确化。
好的AI方法论不会告诉模型应该得出什么结论。它定义了结论在被接受之前必须经受住什么考验。
这一原则是可迁移的。
在历史研究中,结论必须经受住年代学和史料考证的检验。在调试中,它必须经受住复现和区分性测试的检验。在架构中,它必须经受住需求和运营约束的检验。在战略中,它必须经受住市场证据和失败标准的检验。
验证者会变。
方法论纪律不变。
目标不是让模型总是思考更久。而是一个知道答案何时尚未得到充分论证的系统。
研究背景
本系列中描述的完整框架是一种方法论综合,而非已确立的标准化LLM基准。然而,若干相邻研究方向支持其核心架构前提:当语言模型的问题求解被组织为迭代或多阶段过程而非单次生成时,推理质量可能发生实质性变化。
ReAct将推理与行动及外部观察相结合,并在问答、事实核查和交互式决策任务中展示了优势。思维树探索多条候选推理路径,通过评估和回溯而非立即锁定单一链条。Self-Refine通过在生成、反馈和精炼之间迭代,在多种任务上展现了改进。Reflexion表明语言智能体可以利用先前尝试的言语反馈来改进后续决策,而无需更新模型权重。
这些方法并未实现提示不变性或本文提出的以证伪为导向的框架。它们为更广泛的观点提供了独立证据:推理时程序很重要——模型能力与行使该能力的过程并不等同。
本系列的贡献在于围绕认识论控制来组织这一洞见:证据分离、假设追踪、提示框架分析、竞争性假设、证伪、来源追溯、领域验证和校准不确定性。
精选参考文献
- Yao, S. et al. — ReAct: Synergizing Reasoning and Acting in Language Models. ICLR, 2023.
- Yao, S. et al. — Tree of Thoughts: Deliberate Problem Solving with Large Language Models. NeurIPS, 2023.
- Madaan, A. et al. — Self-Refine: Iterative Refinement with Self-Feedback. NeurIPS, 2023.
- Shinn, N. et al. — Reflexion: Language Agents with Verbal Reinforcement Learning. NeurIPS, 2023.
- Jhaveri, A. R., GX-Chen, A., Sucholutsky, I. & Choi, E. — Failing to Falsify: Evaluating and Mitigating Confirmation Bias in Language Models. 2026.
- Brucks, M. S. & Toubia, O. — Prompt Architecture Induces Methodological Artifacts in Large Language Models. PLOS ONE, 2025.
AI推理方法论系列
- 超越提示工程:一种更可靠AI推理的方法论 — 为什么仅靠模型能力是不够的。
- 提示是偏见的一部分 — 任务表述如何影响推理环境。
- 提示不变性:结论能否经受住提示的考验? — 测试结论在替代框架下的稳定性。
- AI推理的证伪:从答案到经过检验的假设 — 竞争性假设、反证和区分性测试。
- 从研究协议到通用AI推理框架 — 将该方法论整合为可复用的领域无关推理核心。
- 同一推理框架在游戏AI中的实际应用——包括游戏助手、自主智能体、补丁敏感知识和实时游戏状态验证——在当游戏AI听起来正确但并非如此:游戏助手和智能体背后的推理问题(figure.rocks)中进行了探讨。
Related Articles
Welcome to NuxtWP Multilang Theme
Introduction to the NuxtWP Multilang Theme - a modern multilingual CMS built with Nuxt 4.
模型-视图-控制器(MVC):现代Web应用的结构支柱
模型-视图-控制器(通常简称为MVC)依然是软件开发中最经久不衰的架构模式之一。它为团队提供了一种实用的方法,将业务逻辑、展示层和用户交互分离,从而使应用程序更易于构建、扩展、测试和维护。本文阐述了MVC是什么、为何至今仍具重要性、它在当今Web技术栈中的定位,以及它如何与更广泛的平台架构、交付质量、迁移策略和运维成熟度相连接。
Techniques for creating SHA512 password hashes with doveadm
Detailed guide for securely generating SHA512 password hashes from the command line using the Dovecot tool doveadm. This article is intended for system administrators and developers.
Prisma 7 多数据库架构:专家深度解析
复杂数据环境的管理需要现代化的架构。Prisma 7提供多数据库集成的高级功能,并应对多语言持久化带来的挑战。
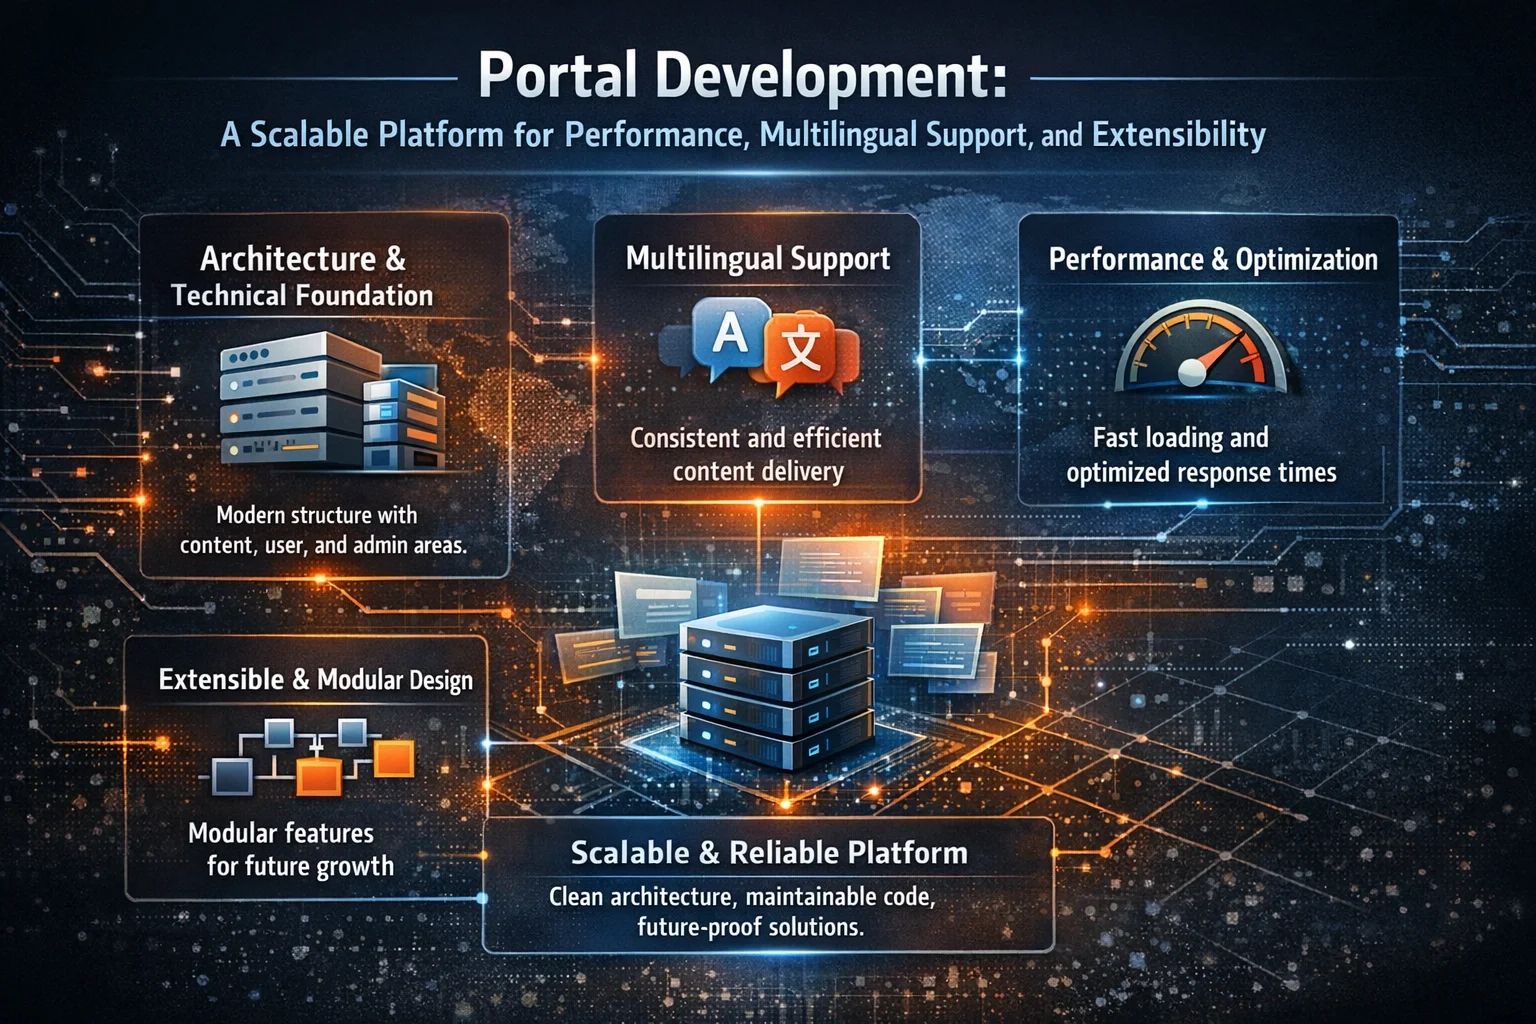
门户开发:一个可扩展的平台,专注于性能、多语言支持与可扩展性
Ein modernes Webportal wird entwickelt, das auf Skalierbarkeit, Leistung, Mehrsprach
entdecke-die-bahnbrechenden-moeglichkeiten-von-gpt-4
Google I/O 2026:反重力、AI Studio 以及向智能体开发工具的转变
Google I/O 2026 向工程师们明确传达了一个信息:AI 工具正从自动补全迈向托管式自主执行。本文深入解析 Antigravity 2.0、Google AI Studio 不断扩展的角色、Gemini 3.5 Flash,以及在编排、锁定效应、验证和开发者工作流设计方面的实际权衡。
Google I/O 2026:Gemini Omni、Gemini 3.5 以及驱动自主式AI的计算层
Google I/O 2026 将 Gemini Omni 和 Gemini 3.5 置于谷歌代理型 AI 战略的核心。本文解析了多模态创作与行动级智能之间的区别,阐释了 Gemini 3.5 Flash 对代理和编码的重要性,以及这些模型如何驱动更广泛的 Google I/O 2026 平台转型。
Google I/O 2026:架构转型、自主AI与统一生态的现实检验
Google I/O 2026 不仅仅是一场模范活动。它展示了 Gemini 模型、开发者工具、Android 相关界面以及智能设备之间更深层次的平台变革。本文作为核心报道,为需要区分实际运行时影响与舞台炒作的技术工程师、架构师和产品团队解读这场主题演讲。
HEIC转JPG转换:为何值得考虑及其工作原理
HEIC格式提供了现代化的图像压缩和高画质,但JPG仍是兼容性最广的格式。本指南将说明在Linux环境下,何时以及如何利用工具与自动化流程将HEIC转换为JPG格式。