提示词本身就是偏见的一部分:AI的框架设定如何塑造推理
提示词通常被视为发送给 AI 模型的指令:足够清晰地描述任务,提供必要的上下文,模型就应该给出更好的答案。
这种模型是不完整的。
提示词不仅仅描述问题。它还参与构建评估问题所在的推理环境。它的措辞、顺序、假设、标签、示例、所要求的视角,甚至用户所陈述的信念,都可能影响最终的输出。
提示词并不在推理过程之外。它是推理过程内部的变量之一。
这一区分是超越提示词工程:一种更可靠的 AI 推理方法论中所引入方法论的核心。如果目标是可靠的推理,而不仅仅是有用的文本生成,那么提示词本身就必须被视为方法论偏见的可能来源。
提示词质量与提示词中立性是不同的问题
提示词工程通常试图提高清晰度。模糊的请求被替换为明确的要求。相关上下文被添加。期望的输出结构被定义。约束条件被显式化。
所有这些都可以提高答案的质量。
但更详细的提示词并不自动等于更中立的提示词。事实上,额外的细节可能引入额外的假设。一个精心设计的提示词可能如此有效地约束模型,以至于它针对一个其底层框架从未被质疑的问题,给出了极好的答案。
因此,这是两个不同的优化目标:
- 提示词质量:模型是否很好地理解并执行了所请求的任务?
- 认识论稳健性:如果提示词中可疑的假设或框架选择被改变,核心结论是否仍然站得住脚?
一个提示词可以在第一个标准上得分很高,同时在第二个标准上表现很差。
不存在完全中立的提示词
每一个非平凡的提示词都做出了选择。
它决定包含哪些信息、省略哪些信息。它确定哪些概念被命名。它可能在模型审查证据之前就定义了候选解释。它确立术语、范围和重点。在比较任务中,它可能决定哪个选项先出现。在研究任务中,它可能在询问某种关系是否存在之前,就陈述了一种怀疑存在的关系。
这些决定不一定使答案无效。然而,它们确实意味着提示词不能自动被视为一个透明通道,让一个原本独立的推理过程通过它来观察问题。
Brucks 和 Toubia 将一种相关现象描述为提示词架构。在涉及 GPT-3、GPT-4 和 Llama 3.1 的大规模实验中,他们发现,看似次要的设计选择——包括回答顺序、标签、框架和提供理由的要求——可能系统性地影响模型输出。
这一点很重要,因为这些影响并不局限于明显具有操纵性的提示词。一些有影响力的特征只是用户在表述任何问题时都必须做出的普通结构性决定。
没有使模型产生偏见的意图,并不意味着不存在框架效应。
一个具体例子:顺序与标签
框架不只是措辞
什么证据支持传统A与传统B之间的历史传播?
在传统A与传统B之间,现有证据最支持何种关系(如果有的话)?
- 调试:“为什么nginx会导致这个超时?”在替代原因被检验之前,就把nginx框定为因果目标。
- 架构:“我们应该如何使用微服务实现这个?”可能会压制更根本的问题,即微服务是否合理。
- 产品策略:“我们应该如何发布这个产品?”预设了发布目前是正确的行动。
- 安全:“攻击者是如何通过API进入的?”可能把调查锚定在尚未确立的攻击路径上。
- 研究:“什么解释了这种相关性?”即使现有证据只能确立关联,也可能鼓励因果叙事。
一个复杂的模型可能会注意到并质疑这些假设。但方法论不能依赖于它总能如此的希望。
指令遵循制造结构性张力
现代AI助手被有意训练来遵循指令。这一能力是它们有用的原因之一。
但指令遵循在分析工作中引入了一种重要的张力。
模型同时被期望尊重用户的任务定义,并独立推理该定义是否包含可疑的假设。
这些目标通常是兼容的。有时它们并不兼容。
如果用户说,'向我展示为什么架构A优于架构B,'一个高度顺从的回应可能会为A产生一个有说服力的论证。该回应可能完美地满足了指令,却未能确定在相关约束下A是否真的更优。
这就是为什么方法论提示必须区分执行指定的论证任务和确定哪个结论得到最佳支持。
前者是一种合法的AI能力。它不应与后者混淆。
谄媚相关——但并非同一问题
提示诱导的偏见有时与谄媚一起讨论。这些概念有重叠,但不应将它们混为一谈。
框架效应描述的是由任务呈现方式的特征所引起的输出变化。谄媚更具体地指模型行为过度迎合、认可或同意用户所陈述的立场、偏好或信念。
框架效应可以在没有任何用户意见的情况下发生。仅选项顺序就可能影响结果。相反,当用户的立场本身影响回应时,谄媚就变得相关。
Sharma及其同事的研究在多个AI助手中发现了谄媚行为,并报告称,与用户表达观点相匹配的回应即使不那么真实,也可能获得更强的人类偏好信号。
这个问题不仅仅是理论上的。2025年4月,OpenAI在发现其描述为过度奉承或顺从的行为后,公开回滚了GPT-4o的更新。该公司表示,提高直观性和有效性的尝试导致了谄媚的不期望增加。
Anthropic和OpenAI后来的一项联合对齐评估也报告了两个组织所评估模型中常见的谄媚形式。
这些发现不应被解释为AI助手总是同意其用户的证据。它们表明,与用户一致的同意是一个真实的模型行为问题,需要明确的评估。
用户可能成为假设的一部分
在长时间的分析性对话中,这个问题变得尤为微妙。
在多轮对话中,用户可能会透露他们期望发现什么、认为哪些解释合理、重视哪些证据以及目前倾向于哪个结论。这些上下文是有用的。它可以显著提高模型工作的相关性。
但这也意味着模型不再仅仅评估外部问题。它是在包含研究者期望的对话环境中评估问题。
实际上,用户的假设可能成为模型输入分布的一部分。
这并不意味着个性化是不可取的。它意味着个性化和独立验证服务于不同的目的,有时应该分开。
要求模型提出异议并不能解决问题
一个自然的回应是添加这样的指令:
不要同意我。要批判性。挑战我的假设。
这些指令可能有用,但它们并不能解决方法论问题。
盲目的异议并不比盲目的同意在认识论上更有价值。一个被优化为反对用户的模型可能只是引入相反的偏见。
目标不是异议。
目标是结论独立性:证据应该决定用户的假设是被加强、削弱、取代还是悬而未决。
这需要一个过程,其中替代解释的产生是因为它们合理,而不是因为模型被指示要对立。
提示偏见和确认偏见可以相互强化
当提示框架与另一个推理问题——确认偏见——相互作用时,它变得更加重要。
Jhaveri及其同事在2026年的一项研究中,使用交互式规则发现任务测试了十一种语言模型。这些模型经常提出确认其当前假设的测试,而不是能够证伪它的测试。在报告的实验中,鼓励反例的明确干预减少了这种行为,并提高了平均规则发现性能。
这创造了一个潜在的自我强化循环:
用户框架 → 初始模型假设 → 确认性证据搜索 → 对框架假设更强的信心
重要的是,每个单独的步骤看起来可能都是合理的。弱点在于过程的结构。
因此,下一个方法论层面不能仅仅要求模型提供更多证据。它必须改变竞争性假设和否定性证据的处理方式。
该机制在AI推理的证伪:从答案到可检验假设中单独展开。
为什么更多推理不会自动消除问题
人们很容易假设,更强的推理模型最终会通过推理来消除提示依赖性。
这种假设是不安全的。
额外的推理能力可以帮助模型识别假设、比较解释并检测矛盾。但模型仍然将提示作为定义任务的信息的一部分来接收。更强的推理能力并不会使任务表述消失。
因此,更强的模型可以产生更复杂的分析,同时仍然受到原始框架的影响。
推理深度和框架独立性是不同的属性。
这就是为什么即使底层模型变得更强大,外部方法论结构仍然有价值的原因之一。
提示应成为可检验的变量
一旦提示被认识到是推理环境的一部分,一个重要的方法论转变就成为可能。
与其将一个精心编写的提示视为问题的确定性表述,我们可以将表述本身视为一个变量。
对于低后果的任务,这是不必要的。对于研究、复杂诊断、技术架构、战略分析以及其他结论重要的任务,多种合理的表述可以揭示单一提示所隐藏的依赖性。
这并不意味着生成随机的改写。有用的测试会改变有意义的假设,同时保留底层证据和研究问题。
例如:
- 从表述中移除用户偏好的解释;
- 反转初始假设;
- 对称地呈现竞争性假设;
- 在顺序应无关紧要的地方改变选项顺序;
- 将证据收集与解释分开;
- 单独进行一次处理,以构建最强的基于证据的反对意见。
目标是观察什么发生了变化——更重要的是,什么没有变化。
这直接引出了本系列的下一篇文章:提示不变性:结论能否在提示变化下存活?。
从更好的提示到更好的方法论
提示工程仍然有用。清晰的目标、良好的上下文、明确的约束以及精心设计的输出格式都能改进人工智能系统。
错误在于假设提示优化和推理验证是同一门学科。
它们解决的是不同的问题。
提示工程问的是:我应该如何表述任务,以便模型能很好地执行?方法论推理则补充道:我如何知道结论不是我的任务表述方式所造成的假象?
第二个问题正是将提示从一种界面技术转变为认识论方法论一部分的关键。
提示仍然重要。但它失去了作为不容置疑的起点的特权地位。
它变成了本身可以被审视、变化和测试的东西。
研究背景
若干独立的研究方向为本文所做的区分提供了依据。Brucks 和 Toubia 通过实验证明,提示架构可以通过响应顺序、标签、框架和理由引入系统性的方法论假象。Sharma 及其同事考察了谄媚现象以及人类偏好信号在奖励与用户信念一致方面所起的作用。OpenAI 在 2025 年对 GPT-4o 的回滚提供了一个生产环境中的例子,说明过度顺从会变得足够明显,以至于需要对模型行为进行干预。关于确认偏误的研究进一步表明,除非推理过程明确鼓励否证,否则语言模型可能会偏好能证实假设的测试。
这些发现涉及不同的现象,不应被视为支持某一普遍偏见机制的可以互换的证据。然而,它们共同支持一个更狭窄的方法论结论:人工智能的输出可能在很大程度上取决于任务以及用户立场是如何被呈现的,因此不应自动将单一提示视为中立的测量工具。
精选参考文献
- Brucks, M. & Toubia, O. — Prompt architecture induces methodological artifacts in large language models. PLOS ONE 20(4), e0319159, 2025.
- Sharma, M. et al. — Towards Understanding Sycophancy in Language Models. arXiv:2310.13548.
- OpenAI — Sycophancy in GPT-4o: What Happened and What We're Doing About It, April 2025.
- Anthropic — Findings from a Pilot Anthropic–OpenAI Alignment Evaluation Exercise, 2025.
- Jhaveri, A. R., GX-Chen, A., Sucholutsky, I. & Choi, E. — Failing to Falsify: Evaluating and Mitigating Confirmation Bias in Language Models. arXiv:2604.02485, 2026.
继续阅读本系列
- 超越提示工程:一种更可靠的人工智能推理方法论 — 本系列背后的方法论框架。
- 提示不变性:结论能否在提示变化下存活? — 测试结论在盲测、反转和对抗性表述下是否保持稳定。
- 人工智能推理的否证:从答案到经过检验的假设 — 用竞争性假设和否证性测试取代证实性推理。
- 从研究方案到通用人工智能推理框架 — 将方法论推广到研究、软件、调试和战略分析中。
Related Articles
MLOps 与 LLMOps:当模型是 LLM 时,会发生哪些变化
MLOps 运维机器学习系统;LLMOps 将这些实践扩展到围绕大型语言模型的提示、上下文、检索、提供商、工具、评估和运行时行为。
托管代理框架与自托管代理循环:你得到什么,失去什么
“自托管代理”可能意味着截然不同的架构。本指南区分了托管式运行框架、自托管执行环境和完全自主运营的代理循环——并说明了团队实际需要哪种控制边界。
ADR 与 NFR:架构决策与系统质量并非同一回事
ADR 与 NFR 解析:了解系统质量需求如何驱动架构决策、ADR 如何记录权衡取舍,以及为什么验证保持独立。
从OpenAI Agents SDK迁移到Agents API:架构上究竟有哪些变化?
从 OpenAI Agents SDK 迁移到新的 Agents API 并不是简单的导入重命名。运行时边界发生了变化:代理循环、持久会话、编排、上下文压缩与恢复都向托管执行框架迁移。本指南说明哪些应当迁移、哪些应当保留在您的应用程序中,以及如何在切换前验证迁移。
你应该购买带有旧固件的5G OpenWrt路由器吗?以ZBT Z8102AX为例
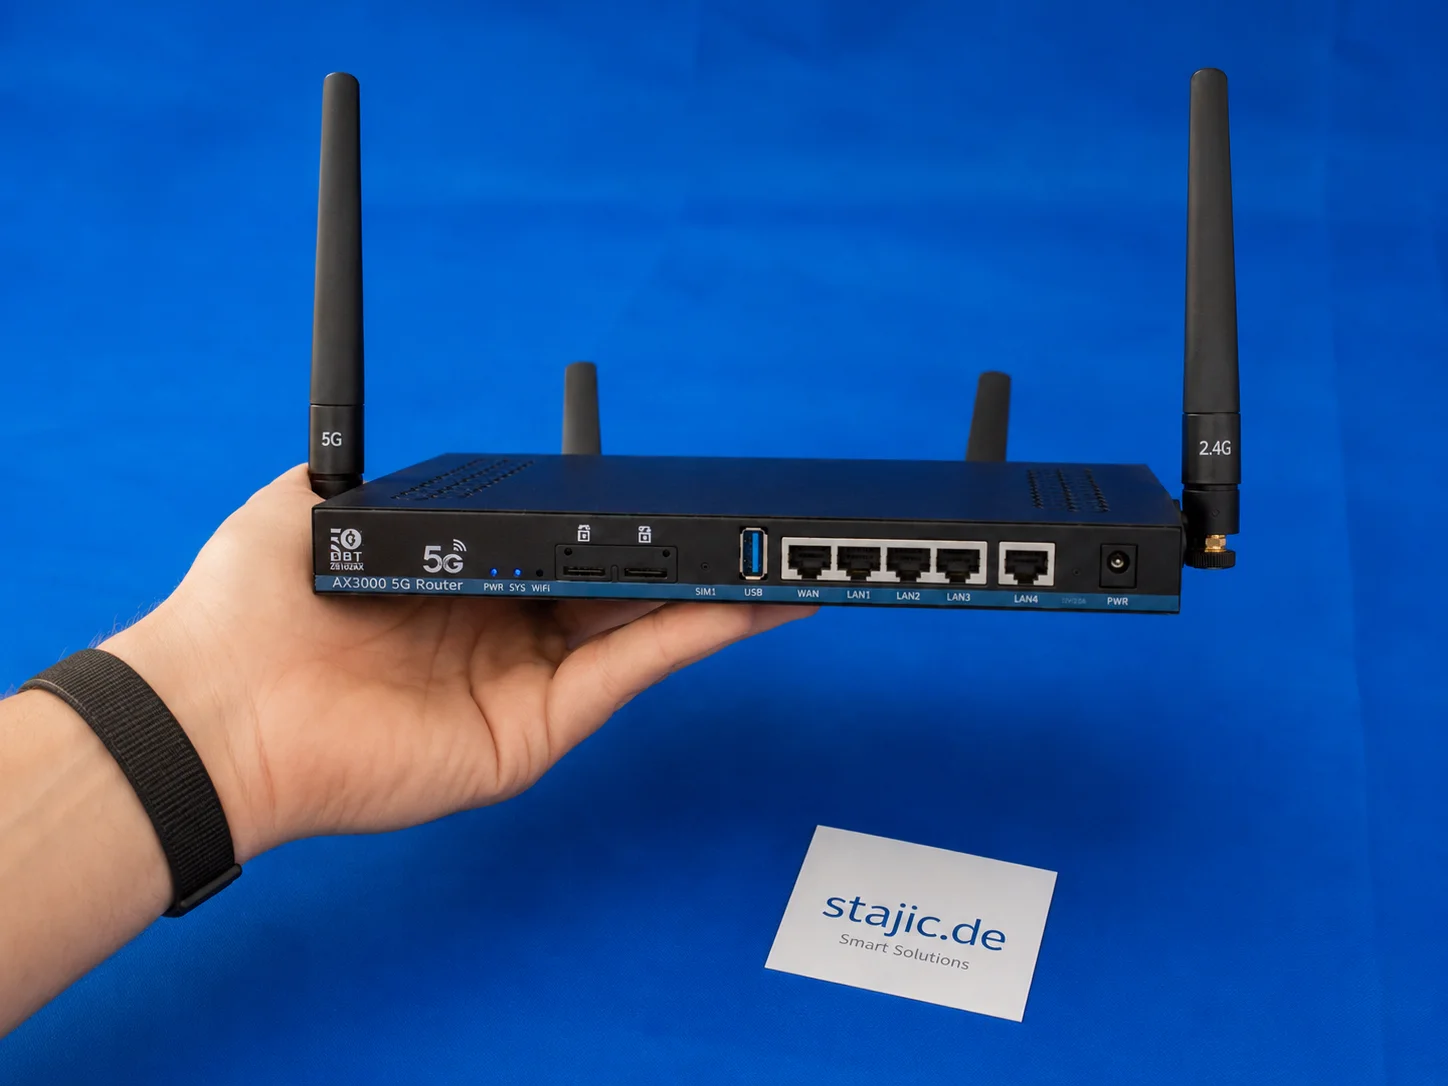
购买搭载旧版固件的5G OpenWrt路由器在特定条件下是合理的。ZBT Z8102AX型号清晰展现了利弊两面:硬件实用、调制解调器工作正常,测试中路由器保持稳定,但OpenWrt 21.02版本、简陋的包装以及不明确的升级路径,要求消费者在购买时需审慎决策。
什么是RAG?对其工作原理的最简单解释
RAG听起来很复杂,但想法很简单:在AI回答之前,它先从知识源查找有用的信息,并将该信息提供给语言模型。本指南使用一个简单的思维模型来解释RAG、LLM、状态、记忆和工具。
Enterprise Start Here: Your Gateway to Operational Excellence
New to our enterprise platform? This guide provides a structured onboarding path, from foundational reference models to actionable playbooks, runbooks, and assessments designed for seamless implementation.
计算机使用代理:为什么成功的演示仍可能是一个不可靠的系统
计算机使用代理如今能够完成令人印象深刻的浏览器和桌面工作流程,但一次成功的运行证明的是能力——而非可靠性。本文展示了如何测试可重复性、环境鲁棒性、长时程控制、状态感知、结果验证以及安全的目标处理。
企业AI架构:当AI进入公司时会发生什么变化
企业AI架构阐释了AI如何在数据权限、身份、许可、提供商、风险、治理、评估、合规和运营方面改变公司系统。
Ollama 并非产品:构建可投入生产的开源大语言模型应用
使用Ollama运行本地模型很简单。但构建一个可用于生产环境的开源大语言模型(Open-LLM)应用则更具挑战性:它需要RAG(检索增强生成)、访问控制、供应商抽象、评估、日志记录、部署规范,以及围绕模型构建受控的应用层。
如何判断一个AI智能体是否真正使用了正确的证据
AI代理可以引用来源,却仍然使用错误的证据。本文介绍一种实用方法,用于核查主张支持、来源权威性、适用性、出处,以及证据是否实际影响了答案。
AI治理:模型、数据、权限、风险与可审计性
AI治理定义了在模型、提供商、数据、权限、风险、评估及整个生命周期中,谁可以批准、操作、更改和审计AI系统。