
人工智能推理的可证伪性:从答案到经过检验的假设
语言模型可以为数量多得惊人的看似合理的解释生成支持性证据。
这种能力对探索很有用,但作为验证方法却很危险。如果模型从一个假设出发,而任务只是解释它为什么可能是正确的,那么一个连贯的答案可能在假设经受严肃检验之前就已经出现了。
因此,可靠的AI推理需要一个更强的问题:
什么证据会使这个假设失败?
本文将以证伪为导向的推理发展为超越提示工程:一种更可靠的AI推理方法中所介绍方法的下一层。前一篇文章提示不变性:结论能在提示变化后存活吗?检验的是结论能否在框架变化后存活。证伪则处理一个不同的问题:假设能否在可能对其不利的证据面前存活。
提示不变性检验的是对框架的依赖。证伪检验的是对证据的脆弱性。
为什么确认太容易
假设给一个AI系统一个假设,并要求它判断该假设是否合理。
模型可以在其知识、提供的文档或检索到的来源中搜索与该假设相容的观察结果。如果找到足够多相容的观察结果,由此产生的解释可能会变得越来越有说服力。
但是,当多个相互竞争的假设预测同一观察结果时,相容性就是弱证据。
考虑一个抽象案例:
观察E与假设H1相容。
仅凭这一陈述并不能确立H1。如果H2、H3和H4也预测E,那么E在区分它们方面几乎没有什么作用。
当相互竞争的解释对我们应该观察到什么做出不同预测时,证据才会变得更有信息量。
这将推理过程从收集支持性事实转向设计具有区分力的检验。
证伪背后的经典思想
卡尔·波普尔的证伪主义强调证实与反驳之间的不对称性。与一个全称主张相容的反复观察无法在逻辑上证明该主张为真,而一个真正不相容的观察则可以直接与之冲突。
用简化的逻辑形式表示:
如果H为真,则应观察到O。O未出现。因此,在测试条件下所陈述的H受到质疑。
这种方法的优势不在于一有机会就证明理论为假,而在于要求主张将自己暴露于可能的失败之中。
一个能够在不改变的情况下容纳所有可设想结果的假设很难被检验,因为没有任何观察能真正对其构成反驳。
一个有用的假设应当承担风险:某些可能的证据必须比对其替代假设更不相容于它。
证伪在实践中更为复杂
流行的证伪版本往往过于简单:出现一个矛盾的观察,因此该假设立即为假。
真实的探究很少如此干净利落。
一个预测通常不仅取决于核心假设,还取决于辅助假设:测量精度、来源可靠性、环境条件、实施细节、背景理论或现有证据的完整性。
更现实的逻辑结构是:
H + A1 + A2 + A3 → 预期观察O
如果未观察到O,失败的预测告诉我们,整个解释结构中的某个部分出了问题。它并不会自动告诉我们哪个组成部分失败了。
假设可能是错的。测量可能不可靠。某个假定条件可能未得到满足。某个来源可能不完整。模型可能误解了证据。
这一区分对AI推理至关重要。目标不是幼稚的拒绝。目标是系统性地让假设暴露于能够削弱它们的证据之下。
面向LLM的证伪导向推理
严格的波普尔式证伪最自然地适用于那些能产生明确可检验后果的主张。AI助手处理的许多任务则不那么干净:历史解释、调试、架构、战略和因果分析往往涉及不完整的证据和概率性解释。
对于这些领域,更通用的术语证伪导向推理很有用。
目标不一定是要获得一个逻辑上决定性的证伪者。而是要组织分析,使能够反驳、削弱或区分当前假设的证据得到明确关注。
不要只问什么支持H。要问如果H为真,应当存在什么;如果H为真,什么应当难以解释;以及什么替代方案能更好地解释同样的证据。
步骤 1 — 精确陈述假设
如果一个假设模糊到可以吸收所有结果,就无法对其进行有意义的检验。
比较:
系统不稳定,因为网络层中的某个地方出了问题。— 弱假设
与:
间歇性 API 故障是由反向代理在超过配置的超时时间时关闭上游连接引起的。— 可检验的假设
第二个主张使自己暴露于具体的检验之下。我们可以检查超时值、连接持续时间、代理日志、上游行为以及发生在配置阈值以下的故障。
假设对所声称关系的定义越精确,就越容易确定什么证据会对其构成反驳。
步骤 2 — 生成真正的竞争性假设
孤立地检验一个假设是薄弱的,因为几乎每一个观察结果都是相对于其他某个东西来解释的。
因此,系统应在评估证据之前构建可信的替代假设。
对于同一个 API 故障,候选解释可能包括:
- H1:反向代理超时;
- H2:上游应用程序崩溃或重启;
- H3:数据库连接耗尽;
- H4:网络中断或数据包丢失;
- H5:客户端超时;
- H6:多个层之间的相互作用,而不是单一孤立原因。
替代假设必须足够可信,才能参与竞争。生成明显劣质的替代假设只会制造批判性推理的表象。
如果替代假设被设计成注定失败,那么一个假设就没有经受住竞争。
步骤 3 — 推导预期观察结果
对于每一个严肃的假设,模型都应推导出在该解释下预期出现的观察结果。
如果 H1 是反向代理超时假设,预期观察结果可能包括:故障集中在特定持续时间附近、代理日志中出现相应的超时消息、故障发生时上游进程健康,以及在受控更改超时后故障消失。
对于H2,即应用程序重启假设,我们会预期看到不同的模式:进程重启、异常、应用程序可用性缺失、资源耗尽或相关的容器事件。
重要的步骤是在将每一个可用的观察结果解释为支持之前,先推导出这些预期。
第4步 — 定义潜在的反驳证据
对于每个假设,问一问什么证据会实质性地削弱它。
如果这个假设是主要解释,我们预期不会观察到什么?
对于代理超时假设,例子包括:故障发生在远低于配置阈值的水平、绕过代理时出现相同的故障、没有相关的代理端事件,或者有证据表明上游应用程序先终止了连接。
这改变了模型的搜索目标。
确认性搜索:寻找与H1兼容的证据。反驳性搜索:寻找H1预测不佳或H2预测明显更好的观察结果。
第5步 — 优先选择有区分力的测试
并非每个测试都同样具有信息量。
假设H1和H2都预测错误率升高。观察到另一个错误几乎没有什么区分力。
更好的测试是寻找一个它们的预测出现分歧的观察结果。
好的测试:一个在H1下很可能出现但在H2下不太可能出现的观察结果,反之亦然。
在调试中,绕过可疑的代理可能具有区分力。在历史研究中,证明时间顺序使得直接传播不可能,可以具有很强的区分力。在产品分析中,在不受所提原因影响的对照市场中观察到相同的需求下降,可以削弱因果解释。
因此,该方法论不仅根据可靠性来评估证据,还根据其区分竞争性解释的能力来评估证据。
第6步 — 主动搜索反证
一旦定义了潜在的反驳者和有区分力的观察结果,系统就应该主动搜索它们。
这一要求很重要,因为语言模型本身可能表现出确认偏误的假设检验。
2026年,Jhaveri、GX-Chen、Sucholutsky和Choi将一项经典的规则发现任务适配到来自多个模型家族和规模的十一个语言模型上。模型经常提出会证实其当前规则的例子,而不是旨在证伪该规则的例子。
其后果是实际性的:以确认为导向的探索导致对隐藏规则的发现更慢且更不成功。
当研究人员明确鼓励考虑反例时,在报告的实验中,平均规则发现成功率从42%提高到56%。
模型不需要新的知识库。它需要更好的假设检验策略。
这与更广泛的方法论直接相关:当推理过程从寻求确认转变为以证伪为导向的探索时,推理质量可以提高。
第7步——将矛盾与拒绝区分开来
找到反对某一假设的证据并不总是足以立即拒绝该假设。
系统应首先评估反证据的质量:
- 观察是否可靠?
- 来源是直接的还是间接的?
- 测量或检索错误能否解释这一冲突?
- 该假设是否确实预测了有争议的观察?
- 矛盾是否依赖于某个辅助假设?
- 反证据是否得到独立佐证?
- 是否有竞争性假设能更成功地解释该证据?
只有在此评估之后,模型才应确定该假设是被削弱、大幅修正还是被拒绝。
第8步——防止特设性挽救
如果每一个矛盾观察都产生一个新的例外,那么一个假设实际上可能变得不可证伪。
这种模式看起来是这样的:
预测失败 → 添加例外 → 预测再次失败 → 再添加一个例外 → 无限期保留原始结论
并非每一种修改都是不合理的。科学和技术的进步常常是因为意外证据揭示了缺失的变量或错误的辅助假设。
方法论上的区别在于,这种修正是否产生新的可检验后果,还是仅仅保护偏好的结论免于失败。
富有成效的修正会提高解释和预测的精确性。特设性挽救只会降低该假设最终失败的可能性。
第9步——更新置信度,而不是为初始答案辩护
以证伪为导向的推理,其输出不必是二元的。
可能的状态包括:
- 强支持:经受住了严格的区分性检验,且竞争性解释的表现明显更差。
- 暂定支持:是目前可得到的最佳解释,但仍存在重要的不确定性。
- 被削弱:存在实质性反证,但尚不具决定性。
- 欠定:若干假说对当前证据的解释力相当。
- 被拒绝:可靠证据与核心预测相冲突,且替代性解释表现更好。
- 无法用现有证据检验:当前语料无法在诸主张之间作出有意义的区分。
核心规则很简单:信心应当跟随检验的结果,而不是模型对其最初答案的修辞性投入。
证伪矩阵
对于复杂分析,可以将各假说规范化到一个比较矩阵中。
| 维度 | H1 | H2 | H3 |
| 核心主张 | 精确定义 | 精确定义 | 精确定义 |
| 预期证据 | 列出预测 | 列出预测 | 列出预测 |
| 潜在反证 | 定义 | 定义 | 定义 |
| 区分性检验 | 具体说明 | 具体说明 | 具体说明 |
| 支持性观察 | 记录 | 记录 | 记录 |
| 矛盾性观察 | 记录 | 记录 | 记录 |
| 辅助性假设 | 揭示 | 揭示 | 揭示 |
| 当前状态 | 重新评估 | 重新评估 | 重新评估 |
该矩阵可防止一种常见的失败模式:对替代方案施加严格审视,却让偏好的假说保持模糊。
负面证据需要特别谨慎对待
预期证据的缺失可以削弱一个假说,但仅在特定条件下如此。
“我们没有发现支持X的证据”这一陈述并不等同于“X没有发生”。
当有正当理由预期:若该假说为真,证据很可能可被观察到、保存下来、记录在案、形成文档或可测量时,负面证据才具有信息价值。
证据的缺失,在证据本不应缺失时最为重要。
在调试中,如果已知日志记录是完整的,那么缺少某个必需的日志事件可能是有意义的。在历史研究中,残缺档案中的缺失通常要弱得多。在安全分析中,如果相关遥测数据从未被采集,那么没有告警几乎没有价值。
因此,模型必须同时评估缺失的证据以及此类证据本可留存下来或被观察到的概率。
历史研究:传播与相似性
历史研究说明了为什么以证伪为导向的推理必须因领域而异。
假设两个传统包含概念上相似的思想,而最初的假说提出存在直接传播。
支持相似性是不够的。该假设应产生额外的预期:时间顺序上的兼容性、合理的地理接触、中介、文本或术语痕迹、文献证据,或与传播相符的转变模式。
可能具有破坏性的观察结果可能包括:时间顺序与所提出的方向相反、地理隔离与所声称的机制不相容、两种传统中都有更早的独立例子,或有证据表明所谓的共同特征仅出现在晚得多的重新解释中。
任何单一的缺失都不一定能否定历史传播。但若干独立的失败可以降低其相对于趋同或间接继承的解释优势。
软件调试:从嫌疑到根本原因
调试自然受益于证伪,因为目标不是围绕错误信息构建一个看似合理的叙述。而是要隔离产生故障的机制。
一个有用的调试循环是:
症状 → 候选原因 → 预测观察 → 区分性测试 → 排除原因 → 复现 → 根本原因
一个假设变得更强,不是因为可以为其写出更多文字,而是因为现实的替代方案在它通过的测试中失败。
软件架构:证伪一个设计决策
架构决策通常无法在严格的科学意义上被证伪,但可以对它们进行面向证伪的分析。
假设该假设是:
需要微服务架构来满足系统的可扩展性和组织要求。
分析不应列出微服务的好处,而应询问什么会使该主张变得不必要。
如果现实的负载测试表明模块化单体满足预期规模,如果不需要部署独立性,并且如果运维复杂性成为主要成本,那么最初的主张已被实质性削弱。
目标不是证伪微服务作为一种技术。而是在项目约束下测试特定的架构主张。
战略:什么会使商业论点出错?
商业战略经常因证据可以在事后解释而遭受确认偏差。
更强的流程会在执行前定义失败标准。
如果产品论点预测某个目标细分市场会为特定能力付费,那么方法论应定义哪些可观察行为会削弱该主张:合格曝光后的低转化率、因同一原因反复被拒绝、无法维持目标价格,或客户通过替代工作流程解决问题的证据。
当成功标准伴随明确的失败标准时,策略变得更可检验。
证伪不同于故意唱反调
一个被指示“反对这一结论”的模型总能生成异议。
那还不是证伪。
故意唱反调优化的是反对。面向证伪的推理优化的是有信息量的检验。
好的反驳听起来合理。好的证伪检验其结果会改变我们应当相信什么。
这一区分可防止验证过程退化为人为辩论,即一个模型为某立场辩护,另一个模型自动反对它。
证伪与提示不变性协同作用
提示不变性与证伪检验不同的依赖关系。
| 方法 | 主要问题 | 检测 |
| 提示不变性 | 结论能否在替代的合法表述下成立? | 对提示表述的依赖 |
| 证伪 | 假设能否在旨在挑战它的证据下成立? | 对确认和弱检验的依赖 |
一个假设可以通过一项检验而在另一项上失败。
一个模型可能在多种提示表述下复现同一错误结论,产生高表述稳定性但低证据效度。反之,一个强假设可能显得不稳定,因为不同提示暴露了不完整证据的不同子集。
结合两种方法可形成更强的序列:
表述变化 → 竞争性假设 → 预期观察 → 反证 → 区分性检验 → 置信度更新
不要让同一智能体不加批判地评判自己的检验
还有另一个架构问题。
如果同一模型生成假设、设计检验、解释证据并决定假设是否成立,其错误会在每个阶段传播。
这并不会使该过程变得无用,但它促使了角色的分离。
假设生成器 → 测试设计者 → 证据检索器 → 批评者 → 验证者 → 最终综合者
这些角色不一定需要六个不同的模型。它们可以通过具有独立上下文、受控证据和结构化输出的隔离推理过程来实现。
重要的特性是程序独立性:后续阶段不应简单地继承原始答案的修辞承诺。
这成为为LLM设计认知验证层的技术主题。
一种面向证伪的通用AI工作流程
问题 → 证据规范化 → 竞争性假设 → 预测 → 潜在证伪因素 → 区分性测试 → 反证据搜索 → 辅助假设检查 → 假设比较 → 置信度重新校准 → 结论
该工作流程并不要求每项任务都像实验室科学那样运作。
相反,它从证伪中提取出一条普遍的认知原则:解释应当暴露在可能使其失败的条件之下。
具体的验证器则因领域而异。
历史分析测试时间顺序、来源和传播。调试测试可观察的系统行为。架构测试需求和约束。策略测试市场假设和预定义的失败标准。
这种领域无关的核心及其领域特定的验证器在从研究协议到通用AI推理框架中得到了进一步发展。
证伪无法做到的事
- 它无法使不完整的证据变得完整。
- 它无法保证已生成正确的替代假设。
- 它无法消除模型、来源和评估过程共有的错误。
- 它无法将本质上属于解释性的主张转化为实验室实验。
- 它无法将每一个缺失的观察都视为反对某一假设的证据。
- 当预测被反驳时,它无法自动识别出是哪个辅助假设失败了。
- 它无法证明一个幸存下来的假设为真。
- 在需要实验、原始资料、领域专业知识或经验测量的地方,它无法替代它们。
一个在反复证伪尝试中幸存下来的假设,更准确的描述是被所进行的测试所确证,而非被证明。
核心原则
生成式AI使确认变得廉价。
给定一个足够合理的命题,一个强大的语言模型通常能够围绕它产生论点、类比、支持性事实和连贯的叙述。
这正是为什么确认不应成为最终检验。
一个可靠的推理过程不应只追问一个假设为何可能正确。它还必须界定该假设可能如何出错。
因此,AI结论的质量不仅取决于系统能检索到多少支持性证据,还取决于竞争性解释是否被允许胜出。
这改变了模型的角色。
它不再仅仅是一个答案生成器。
它成为一个受控过程的参与者,在其中它自己的初步解释是暂定的、可检验的和可替换的。
最强的AI答案不是拥有最多支持论据的那个。而是其最强替代方案被给予公平机会来击败它的那个。
研究背景
本文中的方法论借鉴了科学哲学和当代语言模型推理实证研究的思想。卡尔·波普尔的证伪主义强调,科学主张应使自己暴露于可能与之冲突的观察之下,而后来的科学哲学则明确指出,实际的证伪比在一次异常观察后就简单拒绝一个假设要复杂得多。
这一区分对AI系统很重要,因为真正的检验通常依赖于辅助假设、证据质量和解释。因此,面向证伪的AI推理使用否证逻辑,而不假装每一个复杂的分析主张都能被简化为一个决定性的实验。
Jhaveri、GX-Chen、Sucholutsky和Choi在2026年的研究为这一设计提供了直接的实证动机。在十一个LLM中,作者在交互式规则发现任务中发现了确认偏误的假设探索。提示模型考虑反例持续减少了这种偏误,并将平均规则发现率从42%提高到56%。
这些发现并未证明此处提出的完整方法论已作为一个统一框架得到实验验证。它们支持一个更狭窄但重要的主张:明确干预以寻求否证性证据可以改善LLM的假设探索。
精选参考文献
- Popper, K. R. — 科学发现的逻辑. 英文版,1959年。
- Popper, K. R. — 猜想与反驳:科学知识的增长. 1963年。
- 斯坦福哲学百科全书 — 科学方法,关于假说-演绎检验和证伪主义的章节。
- 斯坦福哲学百科全书 — 卡尔·波普尔,关于基本陈述、可证伪性以及证伪的实际复杂性的讨论。
- Jhaveri, A. R., GX-Chen, A., Sucholutsky, I. & Choi, E. — 未能证伪:评估和缓解语言模型中的确认偏误. arXiv:2604.02485, 2026年。
继续阅读系列
- 超越提示工程:一种更可靠AI推理的方法论 — 完整的方法论框架。
- 提示是偏误的一部分 — 为什么框架和用户假设会影响AI推理。
- 提示不变性:结论能否经受住提示? — 测试结论能否在盲测、反转和对抗性框架下存活。
- 从研究协议到通用AI推理框架 — 将方法论转化为领域无关的推理过程。
Related Articles
tensorflow
Google I/O 2026:Android XR、智能眼镜与环境AI界面
Google I/O 2026 将 Android XR 和智能眼镜从概念推向实际平台方向。本文解析了音频眼镜、显示眼镜、Gemini 驱动的上下文感知、开发者影响、隐私风险,以及为何可穿戴 AI 更关乎创造环境辅助界面,而非取代手机。
Quectel RM500U-EA在ZBT Z8102AX中:5G频段、o2德国及实际信号表现
ZBT Z8102AX 使用移远 RM500U-EA 调制解调器实现 4G 和 5G 连接。在首次实际测试中,该路由器成功连接至德国 o2 网络,使用 LTE Band 3 和 NR n28 频段。调制解调器工作正常,但更深层次的诊断功能如 RSRP、RSRQ、SINR、频段锁定及小区行为仍需进一步测试。
entdecke-die-bahnbrechenden-moeglichkeiten-von-gpt-4
Google I/O 2026:Gemini Omni、Gemini 3.5 以及驱动自主式AI的计算层
Google I/O 2026 将 Gemini Omni 和 Gemini 3.5 置于谷歌代理型 AI 战略的核心。本文解析了多模态创作与行动级智能之间的区别,阐释了 Gemini 3.5 Flash 对代理和编码的重要性,以及这些模型如何驱动更广泛的 Google I/O 2026 平台转型。
规范化架构、URL 设计、解析器逻辑、API 与可扩展性规范
面向多租户门户的地理发现架构。定义了规范化 URL、解析器逻辑、缓存策略以及不依赖 CMS 耦合或数据库重构的地理读模型。该设计旨在确保 SEO 稳定性、高可扩展性,并支持未来的功能扩展,例如预订和地图。
全新Qwen 3.5-Plus:开源AI迈入新纪元
探索阿里巴巴Qwen 3.5-Plus的革命性特性与优势,这款为开发者打造的颠覆性开源人工智能模型。
How to Install PHP 8.3 on Ubuntu 22.04
Up-to-date guide on installing PHP 8.3 on Ubuntu 22.04, including Apache and Nginx (PHP-FPM) integration, extensions, and running multiple PHP versions side by side.
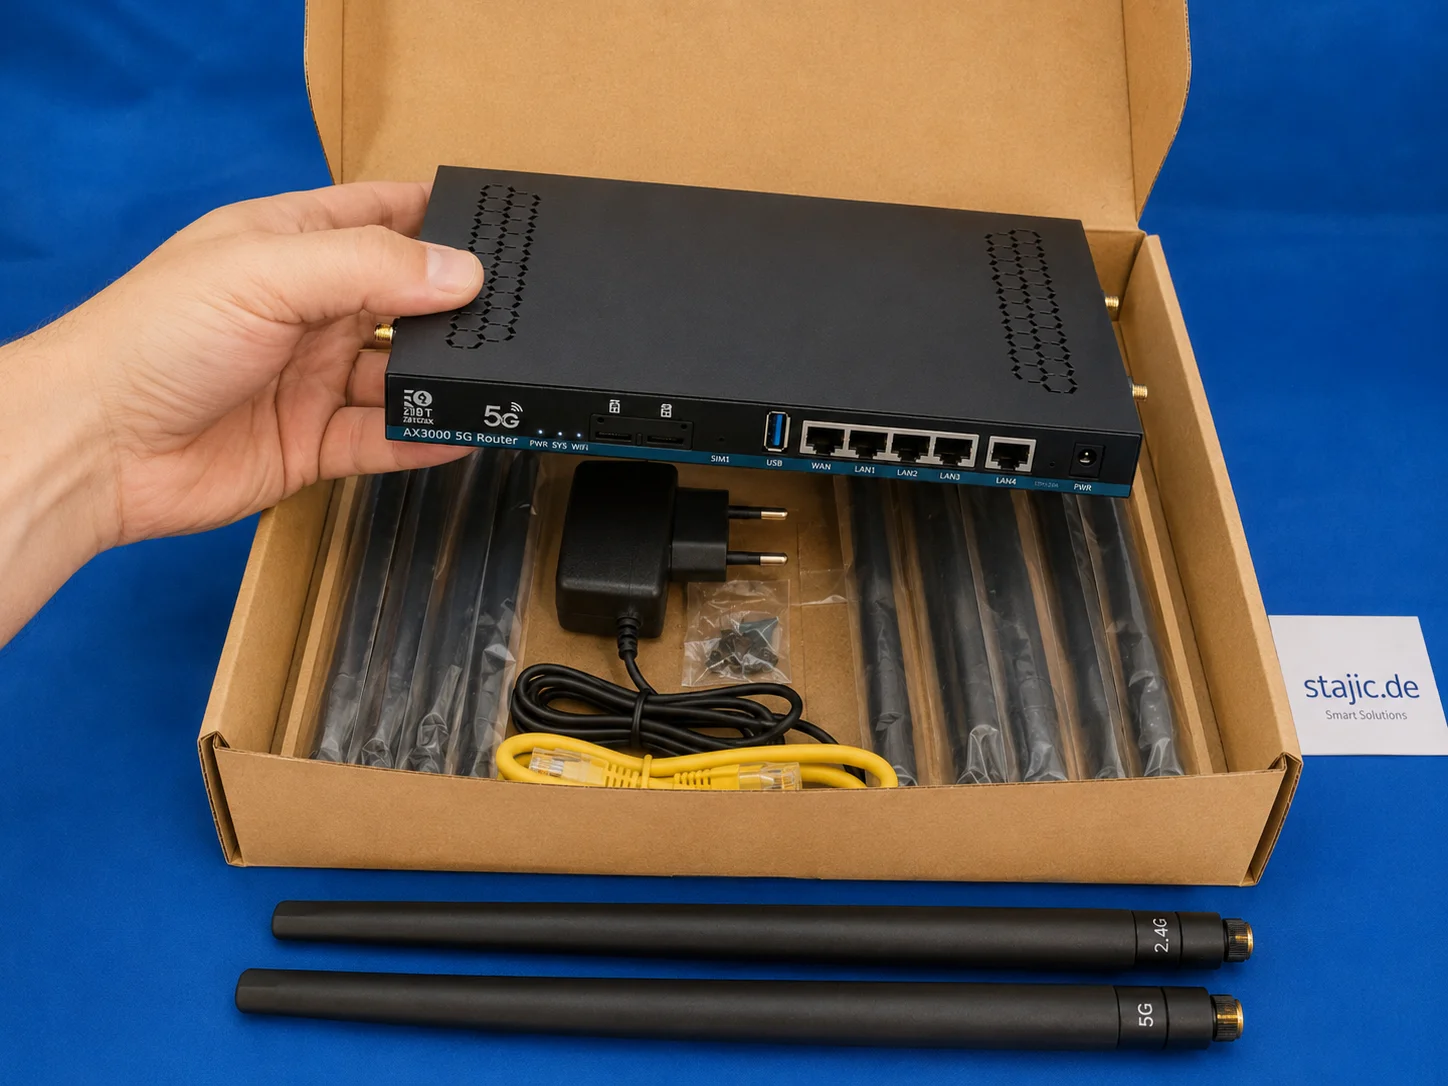
ZBT Z8102AX 硬件与包装评测:强劲路由器,薄弱包装
ZBT Z8102AX 作为一款纤薄黑色金属5G OpenWrt路由器,配备多个天线接口、双SIM卡槽、USB、LAN/WAN端口及实用配件套装,给人留下扎实的第一印象。硬件设计实用且专业,但包装显然是薄弱环节。
Fedora 43上的ComfyUI:双虚拟环境 + 一键启动(2026年3月)
目标:保留两个Python虚拟环境(例如3.12和3.14)以确保兼容性,但通过一个简洁、轻量的配置自动启动ComfyUI。
Test DEv Enterprise Stajic.de 全面指南:架构与最佳实践
探索使用 Test DEv Enterprise Stajic.de 管理企业级开发和测试环境的架构原则、优势及技术细节。
你应该购买带有旧固件的5G OpenWrt路由器吗?以ZBT Z8102AX为例
购买搭载旧版固件的5G OpenWrt路由器在特定条件下是合理的。ZBT Z8102AX型号清晰展现了利弊两面:硬件实用、调制解调器工作正常,测试中路由器保持稳定,但OpenWrt 21.02版本、简陋的包装以及不明确的升级路径,要求消费者在购买时需审慎决策。