
LLM从哪里获取数据?Python中的RAG数据源
上一篇文章,什么是 RAG?对其工作原理的最简单解释,建立了思维模型:LLM 负责写作,RAG 检索有用的知识,应用程序拥有当前状态,工具执行操作。本文迈出下一步:数据实际上来自哪里,以及在 Python 中检索是什么样子的?
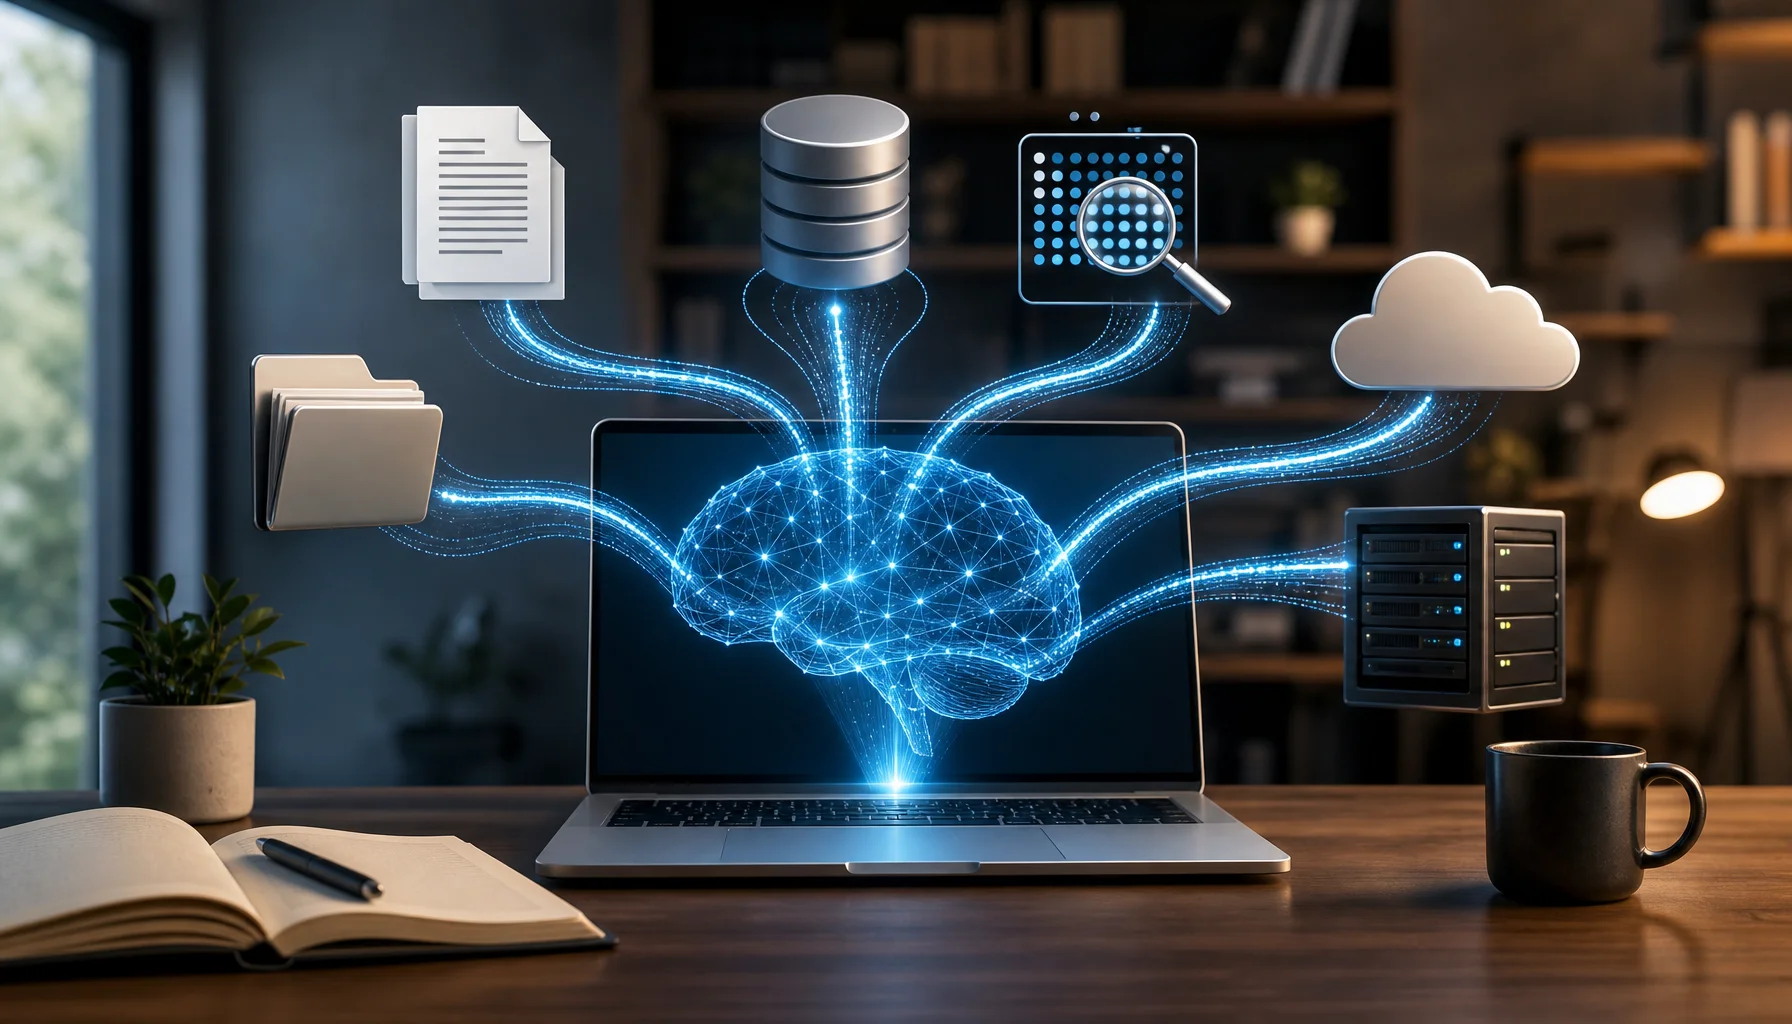
重要的惊喜在于,“LLM 数据源”通常并没有什么特别之处。它可以是一个文本文件、一个包含 Markdown 文档的文件夹、一个 SQL 数据库、一个 API 响应、一个产品目录、一个支持系统,或从这些来源派生的向量索引。AI 并不会神奇地知道这些系统。你的应用程序必须加载、查询、搜索或检索相关数据,并将结果放入模型的上下文中。
数据源 = 信息所在之处。检索 = 应用程序如何找到有用的信息。上下文 = 提供给模型的选定信息。LLM = 解释该上下文并生成答案的组件。— 本文通篇使用的四部分模型
问题
LLM 如何使用文件、数据库或 API 等外部数据,以及一个小型 Python 程序如何在不借助框架隐藏这些步骤的情况下实现基本的 RAG 步骤?
这真正意味着什么
当开发者说 LLM“连接到公司数据”时,这句话背后可能隐藏着几种不同的操作。一个应用程序可能执行 SQL。另一个可能调用 API。另一个可能运行全文搜索。另一个可能计算文档块之间的嵌入相似度。所有这些都可以向 LLM 提供外部信息,但它们不是相同的检索方法,不应被视为可以互换。
这种区分很重要,因为最佳检索方法取决于问题的形态。“我们的退款政策是什么?”是一个文档检索问题。“订单 4711 的当前状态是什么?”通常是结构化数据库查询。“哪一段讨论了账户恢复?”可以是关键词或语义搜索。当系统必须在生成之前发现相关知识时,RAG 最为有用。
最简单的例子
从普通 Python 中的三个字符串开始。没有向量数据库,没有框架,也还没有 LLM。我们只想让检索步骤变得可见。
documents = [
    "The AKM uses 7.62 mm ammunition.",
    "A Med Kit restores health.",
    "A 4x scope can be attached to several compatible weapons."
]

question = "Which ammunition does the AKM use?"

for document in documents:
    if "AKM" in document:
print(document)程序打印第一句话,因为它包含我们搜索的词。这是原始的检索,但架构已经可见:问题 → 搜索 → 相关文本。RAG 增加了一个重要步骤:将检索到的文本与问题一起传递给语言模型。
一个稍微更通用的版本根据查询词的重叠对文档进行排名:
import re

documents = [
    {"id": "weapon-akm", "text": "The AKM uses 7.62 mm ammunition."},
    {"id": "healing-medkit", "text": "A Med Kit restores health."},
    {"id": "scope-4x", "text": "A 4x scope can be attached to several compatible weapons."},
]

def words(text):
    return set(re.findall(r"[a-zA-Z0-9.]+", text.lower()))

def retrieve(question, documents, top_k=2):
    query_terms = words(question)
    ranked = []

    for document in documents:
        score = len(query_terms & words(document["text"]))
        if score > 0:
            ranked.append((score, document))

    ranked.sort(key=lambda item: item[0], reverse=True)
    return [document for _, document in ranked[:top_k]]

question = "Which ammunition does the AKM use?"
hits = retrieve(question, documents)

for hit in hits:
print(hit["id"], "->", hit["text"])这不是生产级搜索引擎。它忽略了词形变化、同义词、拼写变体、文档长度和许多排名信号。它的价值在于教育意义:RAG 不是从向量数据库开始的。它是从检索开始的。
示例在哪里失效
当问题和来源使用不同的词时,精确匹配或词汇匹配会变得薄弱。文档可能说“车辆维护”,而用户问“我如何修理我的车?”词汇检索器可能会错过这种关系,即使人类立即就能看出。语义检索通过将文本表示为向量并比较含义而不仅仅是精确的词元来解决这个问题。
长文件会带来另一个问题。将整本 80 页的手册作为一个单元搜索太粗糙,但拆分每个句子可能会破坏有用的上下文。因此,真正的 RAG 系统需要对解析、分块、元数据、排名、新鲜度、权限和来源做出决策。
该示例也没有提及结构化的实时事实。如果用户询问订单 4711 的当前状态,而应用程序已经拥有数据库键,那么语义搜索通常是错误的首选工具。确定性的数据库查询更好。
直接回答
LLM 数据源是应用程序可以从中为模型获取信息的任何外部系统:文件、数据库、API、搜索索引、向量存储或实时应用程序状态。RAG 是在生成之前从此类来源检索相关知识的模式。
在 Python 中,基本流程可以非常小:加载数据 → 创建可检索单元 → 查找相关证据 → 组装上下文 → 调用 LLM。检索方法应与来源和问题相匹配。使用 SQL 获取精确的结构化事实,使用全文搜索进行词汇匹配,使用嵌入进行语义相似性匹配,并在多种信号有价值时使用混合检索。
为什么如此
语言模型不会自动接收你的文件系统、PostgreSQL 数据库、CRM、私有 API 或新编辑文档的内容。应用程序决定哪些外部信息可访问,以及哪些信息被放入模型的当前上下文中。
Lewis 等人的原始检索增强生成工作将生成模型与从密集向量索引中检索的外部非参数记忆相结合。更广泛的架构思想在该特定实现之外仍然存在:可以在推理时检索外部证据,而不是期望所有有用的知识都编码在模型参数中。
这创建了有用的职责分离:来源存储信息,检索器选择证据,上下文将证据带入请求,模型解释它。保持这些边界可见使得故障更容易诊断。
上下文:数据源的主要类型
| 来源 | 典型检索方法 | 适用于 |
|---|---|---|
| TXT / Markdown / HTML | 解析 + 词汇或语义搜索 | 文档、手册、文章、笔记 |
| PDF / DOCX | 结构感知提取 + 搜索 | 政策、报告、合同、手册 |
| SQL 数据库 | SQL 查询或过滤检索 | 订单、用户、产品、结构化记录 |
| REST / GraphQL API | 带参数的 HTTP 请求 | 远程系统和实时服务数据 |
| 搜索索引 | BM25 / 全文 / 混合搜索 | 大型文本集合 |
| 向量索引 | 嵌入相似性 | 语义文档检索 |
| 应用程序状态 | 直接状态读取或工具调用 | 当前真实情况 |
向量索引值得特别关注。在许多架构中,它不是规范的真相来源。它是从文档或记录派生的检索索引。权威文档可能存在于对象存储、CMS、Git、PostgreSQL 或其他系统中,而嵌入和元数据则单独存储以便快速语义查找。有些系统确实使用向量存储作为主存储,但这是架构选择,而不是 RAG 的要求。
如果检索、持久记忆、当前状态和模型上下文之间的边界仍然不清楚,请参阅AI Agent Memory Is Not RAG。这些层可以使用一些相同的存储技术,但仍然有不同的正确性规则。
假设
- 允许应用程序访问外部来源。
- 相关来源包含足够的信息来回答问题。
- 数据可以以检索层可以使用的形式解析或查询。
- 检索到的信息对于所请求的决策足够新鲜。
- 模型在其上下文中接收选定的证据。
- 在受保护的证据到达模型之前强制执行授权。
- 即使检索正确,生成模型仍然可能出错。
这些假设很重要,因为检索无法弥补缺失的证据、过时的来源版本、损坏的解析器或未经授权的访问。RAG 管道的可信度只能与其提供的证据路径一样高。
变量
| 变量 | 为什么它会改变设计 |
|---|---|
| 来源结构 | SQL 表、法律 PDF 和源代码仓库需要不同的检索策略 |
| 问题类型 | 精确查找、概念搜索和多跳研究是不同的任务 |
| 新鲜度要求 | 实时状态可能需要直接查询,而不是定期重建索引 |
| 语料库大小 | 内存搜索可能适用于数百个块,但不适用于非常大的集合 |
| 语言 | 多语言检索需要适合实际语言的模型和分词 |
| 权限 | 检索必须根据当前用户的访问权限进行过滤 |
| 延迟和成本 | 更多的检索阶段可以提高质量,但会增加运行时和基础设施成本 |
| 来源需求 | 高信任系统需要源 ID、版本和可追溯的证据 |
诊断 / 决策方法
第一个决策不是“我应该安装哪个向量数据库?”而是:我试图检索的是哪种事实?
| 问题类型 | 首选方法 | 原因 |
|---|---|---|
| 精确 ID 或当前记录 | SQL / 键查找 / API | 确定性的结构化访问 |
| 精确措辞、代码、名称 | 全文或关键词搜索 | 词汇精确性 |
| 针对文档的概念性问题 | 语义向量搜索 | 含义可能与措辞不同 |
| 混合企业知识 | 混合检索 + 元数据过滤 | 结合词汇和语义信号 |
| 当前应用状态 | 直接状态/工具访问 | 新鲜度比文档相似性更重要 |
一个有用的测试是:我已经知道我需要哪条记录,还是系统必须发现哪个段落是相关的?如果记录已知,直接查询它。如果相关性必须被发现,搜索就变得更加重要。
当答案错误时,按顺序诊断流水线,而不是立即更换 LLM:
- 1. 源覆盖:正确信息是否存在于可访问的源集合中?
- 2. 新鲜度:该版本对于问题来说是否足够新?
- 3. 解析:相关内容是否被正确提取?
- 4. 分块:证据是否与其赋予含义的条件保持在一起?
- 5. 检索:正确的块是否出现在候选中?
- 6. 排序:更强的来源是否排在较弱或冲突的来源之上?
- 7. 上下文组装:应用程序是否实际将选定的证据发送给模型?
- 8. 生成:LLM 是否忠实地使用了提供的证据?
- 9. 归因:每个重要声明是否都能追溯到来源?
有关更深入的生产调试方法,请参阅RAG 失败了——但究竟是哪一层失败了?一种诊断方法,它将此链条扩展为可独立测试的故障层。
证据
Lewis 等人的 RAG 论文形式化了基于检索到的外部记忆进行条件生成,而不是仅依赖模型参数。这为将生成器与可检索的知识源分离提供了概念基础。
Sentence Transformers 将语义搜索记录为将语料库和查询嵌入到向量空间中,并检索具有高语义相似性的项目。其当前 API 还区分了检索任务中的查询编码和文档编码。
SQLite FTS5 展示了光谱的另一端:成熟的全文检索可以在没有嵌入的情况下对文档进行排序。这很重要,因为词汇搜索对于标识符、精确术语和许多混合检索设计仍然有价值。
OpenAI 的嵌入文档将嵌入描述为用于相关性和搜索的数值向量表示。这是语义检索的一种实现路径,而不是 RAG 本身的定义。
真实示例 1:一个文本文件文件夹
假设一个名为 knowledge/ 的目录包含普通文本文件。Python 可以在完全不使用 AI 库的情况下加载它们。
from pathlib import Path

def load_text_files(folder="knowledge"):
    documents = []

    for path in Path(folder).glob("*.txt"):
        documents.append({
            "source": path.name,
            "text": path.read_text(encoding="utf-8")
        })

    return documents

documents = load_text_files()

for document in documents:
    print(document["source"], len(document["text"]))
文件系统就是数据源。下一个问题是多少文本应该成为一个可检索单元。对于长文档,搜索一个完整文件通常太粗糙。这就是 RAG 流水线通常创建块的原因。
一个非常简单的分块器
def chunk_text(text, max_chars=800):
    paragraphs = [p.strip() for p in text.split("\n\n") if p.strip()]

    chunks = []
    current = ""

    for paragraph in paragraphs:
        candidate = f"{current}\n\n{paragraph}".strip()

        if current and len(candidate) > max_chars:
            chunks.append(current)
            current = paragraph
        else:
            current = candidate

    if current:
        chunks.append(current)

    return chunks
此示例将段落分组,直到达到粗略的字符限制。它有意设计为易于理解而非最优。生产系统通常按标记、标题、章节、句子边界或文档结构进行分块。表格、源代码、合同和 API 文档可能需要不同的策略。
分块时保留来源信息
def build_chunks(documents):
    chunks = []

    for document in documents:
        for index, text in enumerate(chunk_text(document["text"])):
            chunks.append({
                "id": f'{document["source"]}:{index}',
                "source": document["source"],
                "chunk": index,
                "text": text,
            })

    return chunks
有用的分块承载的不仅仅是文本。来源名称、文档 ID、URL、时间戳、版本或章节,之后都可以支持引用、调试和新鲜度检查。如果在摄取过程中丢失了来源信息,解释某个特定答案为何产生就会变得困难得多。
真实示例 2:结构化数据——当 SQL 是正确工具时就使用 SQL
并非每个外部事实都应该经过语义搜索。如果问题要求的是某个精确的当前记录,直接查询数据库通常更清晰、更具确定性。
import sqlite3

def get_order_status(order_id):
    connection = sqlite3.connect("shop.db")
    cursor = connection.cursor()

    cursor.execute(
        "SELECT status, total, currency FROM orders WHERE id = ?",
        (order_id,)
    )

    row = cursor.fetchone()
    connection.close()

    if row is None:
        return None

    return {
        "order_id": order_id,
        "status": row[0],
        "total": row[1],
        "currency": row[2],
    }

print(get_order_status(4711))
如果应用已经知道用户询问的是订单 4711,那么把整个订单表嵌入,并让语义搜索重新发现那一行,通常只会增加复杂性而没有收益。一个强有力的设计规则是:用结构化查询检索结构化事实;用搜索检索非结构化知识。
返回的数据库行仍然可以放入模型上下文中,以便 LLM 用自然语言解释它。但直接访问状态或记录,在概念上不同于搜索知识语料库。
真实示例 3:在嵌入之前先做全文搜索
在朴素的 Python 循环和向量搜索之间,存在一类成熟的词法检索系统。SQLite 包含用于全文搜索的 FTS5,其中包括 BM25 排序。
import sqlite3

connection = sqlite3.connect("knowledge.db")
cursor = connection.cursor()

cursor.execute(
    "CREATE VIRTUAL TABLE IF NOT EXISTS docs USING fts5(title, body)"
)

cursor.execute(
    "INSERT INTO docs(title, body) VALUES (?, ?)",
    ("AKM", "The AKM uses 7.62 mm ammunition.")
)

connection.commit()

query = "AKM ammunition"

rows = cursor.execute(
    "SELECT title, body, bm25(docs) AS score "
    "FROM docs WHERE docs MATCH ? "
    "ORDER BY score LIMIT 5",
    (query,)
).fetchall()

for row in rows:
    print(row)

connection.close()
当精确术语、产品代码、名称、标识符或领域特定词汇很重要时,词法搜索尤其有用。语义搜索并不自动更好。生产系统通常会结合这两种信号。
真实示例 4:使用嵌入进行语义检索
嵌入将文本转换为数值向量,因此即使语义相关的段落没有使用完全相同的措辞,也可以进行比较。Sentence Transformers 提供了一种直接的本地实现。
# pip install sentence-transformers

from sentence_transformers import SentenceTransformer, util

documents = [
    "The AKM uses 7.62 mm ammunition.",
    "A Med Kit restores health.",
    "Vehicle maintenance includes checking oil, brakes and tires.",
    "Account recovery requires access to the registered email address."
]

model = SentenceTransformer(
    "sentence-transformers/multi-qa-mpnet-base-cos-v1"
)

document_embeddings = model.encode_document(
    documents,
    convert_to_tensor=True
)

question = "How do I repair my car?"

query_embedding = model.encode_query(
    question,
    convert_to_tensor=True
)

hits = util.semantic_search(
    query_embedding,
    document_embeddings,
    top_k=2
)[0]

for hit in hits:
    print(round(float(hit["score"]), 3), documents[hit["corpus_id"]])
查询中不包含“车辆维护”这个短语,但语义模型仍然可以给该段落很高的排名,因为这些概念是相关的。这就是嵌入在 RAG 系统中常见的实际原因。
对于小型集合,嵌入可以保存在内存中。更大的系统通常会将它们持久化到支持向量的索引或数据库中,并在那里执行最近邻搜索。存储方式变了,但逻辑仍然不变:编码问题,找到相关的文档表示,返回最佳证据。
真实示例 5:为 LLM 构建上下文
检索器应返回证据。然后,LLM 应接收问题以及该证据。将检索和生成分开,使两者都更易于检查和测试。
def build_prompt(question, retrieved_documents):
    context = "\n\n".join(
        f'[{doc["id"]}] {doc["text"]}'
        for doc in retrieved_documents
    )

    return f"""
Answer the question using the supplied context.

Rules:
- Do not invent facts that are not supported by the context.
- If the context is insufficient, say so.
- Cite the source IDs you used.

Question:
{question}

Context:
{context}
""".strip()
该指令并不会使模型变得绝对可靠。它只是创建了一个明确的证据边界。模型仍然可能误解好的证据、忽略某个条件或过度泛化。这就是为什么检索质量和生成质量必须分别评估。
真实示例 6:一个完整的最小流水线
def answer_question(question, all_documents, call_llm):
    # 1. Retrieve evidence
    retrieved = retrieve(question, all_documents, top_k=3)

    # 2. Build model context
    prompt = build_prompt(question, retrieved)

    # 3. Generate the answer
    answer = call_llm(prompt)

    return {
        "answer": answer,
        "sources": [doc["id"] for doc in retrieved]
    }
该函数有意将 call_llm 作为依赖项接收。检索不应关心生成是由云模型、本地模型还是其他提供方执行的。数据路径属于应用程序。
可选生成器:OpenAI Responses API
一种可能的生成器是 OpenAI Responses API。将模型名称保留在环境变量中,可以避免将特定模型硬编码到 RAG 架构中。
# pip install openai

import os
from openai import OpenAI

client = OpenAI()

def call_llm(prompt):
    response = client.responses.create(
        model=os.environ["OPENAI_MODEL"],
        input=prompt,
    )
return response.output_text同一个检索流水线可以连接到本地推理服务器。这是一个重要的架构要点:RAG 并不属于 LLM 提供方。应用程序拥有来源、检索和上下文组装。
整体架构一览
USER QUESTION
     |
     v
+-------------+
|  Retriever  |
+-------------+
   |       |
   |       +----> SQL / API / state query
   |
   +------------> keyword / full-text search
   |
   +------------> embedding / vector search
                     |
                     v
              relevant evidence
                     |
                     v
+-----------------------------------+
| question + evidence + instructions |
+-----------------------------------+
                     |
                     v
                   LLM
                     |
                     v
                  answer
这种数据流模型比记住某一个框架更持久。库、数据库和模型供应商都会变化;但职责边界保持不变。
常见误解与失败模式
“RAG 就意味着向量数据库。”
不。向量搜索只是一种检索方法。RAG 可以使用全文搜索、SQL、API、知识图谱、向量搜索或它们的组合。其定义性模式是为生成而检索外部信息。
“如果数据在 PostgreSQL 中,我就必须嵌入整个数据库。”
不。结构化记录通常应保持作为结构化记录可查询。嵌入对于语义相关性很有用,但不能替代确定性查询。
“更多分块意味着更好的答案。”
未必如此。额外的上下文可能引入噪声、冲突版本和无关材料。检索应优化有用的证据,而非最大数量。
“高相似度分数证明了答案。”
不。相似度衡量的是相关性,而非真实性或适用性。高度相似的段落可能已过时、来自错误的产品版本,或仅在不符合问题的条件下有效。
“一旦检索到正确的分块,幻觉就解决了。”
不。检索改善了基础,但不保证忠实的推理。生成仍需评估,高风险工作流可能需要确定性验证或人工审查。
“模型失败了,所以更换模型。”
未必如此。正确的来源可能缺失、解析错误、分割不当、被过滤掉、排名过低或未包含在组装的上下文中。更换模型不应是第一个诊断步骤。
边缘情况
- 冲突文档:两个来源可能因版本、司法管辖区或产品不同而不一致。
- 时间敏感事实:语义相关的来源可能已经过时。
- 权限:检索器不得返回当前用户无权访问的文档。
- 多语言集合:嵌入模型和检索策略必须支持实际使用的语言。
- 表格和源代码:普通段落分块可能破坏对答案至关重要的结构。
- 极短标识符:对于SKU、ID、错误代码或缩写,语义检索可能弱于精确匹配。
- 需要多个事实的长问题:检索可能需要分解、多次搜索或重排序,而非一次top-k查询。
- 来源层级:官方当前政策可能需要优先于较旧但语义更接近的讨论文档。
局限性
Python示例有意优化透明度,而非规模。关键词检索器是朴素的,分块器使用字符长度,SQLite示例不包含生产连接管理,语义示例将所有嵌入保存在内存中。
生产系统可能需要向量索引、重排序器、混合检索、文档解析器、缓存、增量索引、来源版本控制、访问控制过滤器、可观测性、评估数据集和故障处理。这些添加都不会改变核心架构;它们使每个边界更可靠。
RAG也无法创造来源集中缺失的证据。如果来源错误、不完整或过时,更好的嵌入模型也无法将其转化为权威知识。
什么会改变这个答案?
当任务需要的不只是知识查找时,架构就会改变。实时订单状态需要当前状态。财务计算可能需要确定性代码。网络研究任务可能需要主动搜索。工作流可能需要能将数据写回另一个系统的工具。自主代理可能需要在检索之外进行规划、权限和执行控制。
因此,RAG最好被理解为更大AI系统中的一个证据获取层。它之所以强大,正是因为它有一个狭窄的职责:找到有用的外部信息并将其放入模型的工作上下文中。
结论
当去掉技术名称后,RAG 就变得容易理解多了。一个文件是一个来源。一个数据库是一个来源。一个 API 是一个来源。搜索函数检索证据。提示词将证据传递给模型。然后 LLM 对其进行解释并生成语言。
生产级 RAG 的难点不在于调用嵌入模型。而在于从原始来源到最终主张构建一条可信的证据路径:保留来源信息、选择正确的检索方法、保持信息最新、控制访问权限、将检索评估与生成评估分开,以及知道何时直接调用数据库或工具比语义搜索更好。
这就是基础 RAG 模型的实用延续:先理解角色,然后让数据路径变得明确。
主要来源
- Lewis 等人 — 面向知识密集型 NLP 任务的检索增强生成 — 2020 年的论文,介绍了将生成与检索到的非参数记忆相结合的 RAG 公式。
- Sentence Transformers — 语义搜索 — 关于语义检索、查询嵌入和文档嵌入的官方文档。
- OpenAI — 向量嵌入 — 官方文档,将嵌入描述为用于相关性和搜索的数值表示。
- SQLite — FTS5 扩展 — 关于 SQLite 中全文搜索和 BM25 排名的官方文档。
- OpenAI — SDK 和 CLI — 用于可选生成器示例中 Responses API 的官方 Python SDK 示例。
- 什么是 RAG?对其工作原理的最简单解释 — 本系列的概念性第一部分。
Related Articles

AI代理应该记住、遗忘、重新计算还是再次检索什么?
长时间运行的代理不应记住所有内容。本文提供了一个实用的生命周期模型,用于决定哪些内容应属于持久记忆、哪些内容应重新检索、哪些内容重新计算更安全,以及哪些内容应过期或被取代。
ZBT Z8102AX 硬件与包装评测:强劲路由器,薄弱包装
ZBT Z8102AX 作为一款纤薄黑色金属5G OpenWrt路由器,配备多个天线接口、双SIM卡槽、USB、LAN/WAN端口及实用配件套装,给人留下扎实的第一印象。硬件设计实用且专业,但包装显然是薄弱环节。
基于Next.js、Fastify、Prisma和NGINX的实用单体仓库架构
探索一种实用的单体仓库架构,结合Next.js、Fastify、Prisma与NGINX,重点展示实际集成与工作流程。
PostfixAdmin:企业级Postfix邮件系统管理平台 —— 2026年版
PostfixAdmin是一款以数据库为核心的邮件系统管理界面,专为专业级Postfix邮件系统设计。它并非隐藏复杂性,而是提供对域名、邮箱、别名及发件人权限的精准控制。本文将阐述为何PostfixAdmin在2026年仍是值得信赖的企业级解决方案,以及它如何融入注重安全性的现代邮件基础设施体系。
Qwen 3.6 生产环境部署:发布手册、AI 回滚与 LLMOps 版本管理
Qwen 3.6 不仅仅是一次模型升级。它同时是一个发布事件、一个回滚场景和一个版本管理问题。本文通过LLMOps规范、提示词与模型可追溯性、受控发布以及基于证据的回滚准备,阐述了在生产环境中应如何处理Qwen 3.6。

AI代理记忆不是RAG:如何区分记忆、检索、状态和上下文
代理记忆、RAG、状态和上下文经常被当作可以互换的概念来使用。它们并不是。这个实用的架构模型将这四个层次区分开来,展示了每一层各自应处的位置,并解释了当系统将它们合并为一层时会出现什么问题。
优化代码质量:使用ESLint与Prettier进行测试
在现代软件开发中,保持一致的代码质量和风格至关重要。ESLint与Prettier提供了强大的组合方案,能够自动化这些关键环节,确保代码库的整洁性、可读性,并遵循既定标准。本文将深入探讨这两款工具如何无缝融入测试工作流,从而提升开发者的工作效率与项目的可维护性。
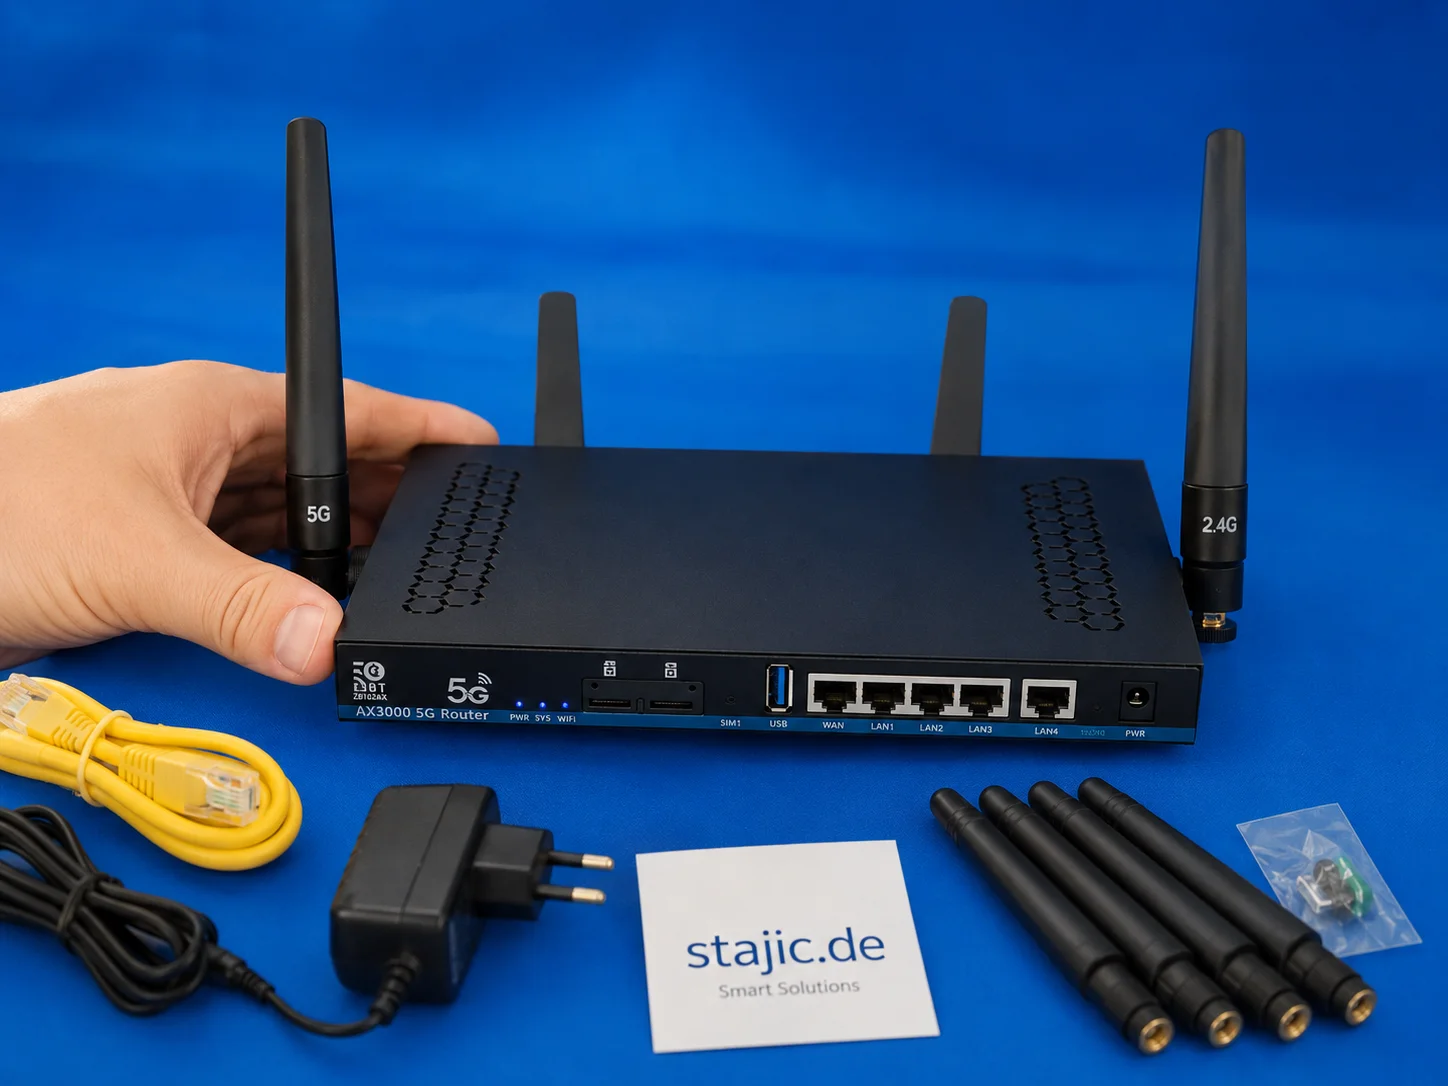
下一代OpenWrt 5G路由器:为何Wi-Fi 7、更强CPU与更优固件至关重要
ZBT Z8102AX 是一个有用的初步样品,但下一步应该更强:Wi-Fi 7、更强大的四核平台、更清晰的固件、改进的包装以及更稳定的定价策略。目标不仅仅是另一款5G路由器,而是一款配置更优、基于OpenWrt的准专业级设备。
Laravel 12 Custom CMS with Filament 3: The Expert Workflow
A detailed look at the synergies between Laravel 12 and Filament 3 for creating customized Content Management Systems. Experts analyze the innovative workflow, advantages, disadvantages, and the challenge of the Jetstream workflow.
Test DEv Enterprise Stajic.de 全面指南:架构与最佳实践
探索使用 Test DEv Enterprise Stajic.de 管理企业级开发和测试环境的架构原则、优势及技术细节。

MCP vs A2A vs UCP vs AP2 vs A2UI:智能体协议栈详解
MCP、A2A、UCP、AP2 和 A2UI 常被描述为相互竞争的智能体标准。它们大多解决的是不同的互操作性问题。本指南将每个协议映射到其实际标准化的边界,并展示它们如何在同一个生产系统中协同工作。
Enterprise Start Here: Your Gateway to Operational Excellence
New to our enterprise platform? This guide provides a structured onboarding path, from foundational reference models to actionable playbooks, runbooks, and assessments designed for seamless implementation.