
GPU 不是产品:面向未来的私有 AI 架构

关于本地 AI 基础设施的讨论往往始于一个错误的问题:
我应该买哪款 GPU?
更好的问题是:
我需要执行哪些类型的 AI 工作负载,每种工作负载应该在哪里运行?
随着 AI 基础设施分化为几种截然不同的硬件类别,这种区分变得越来越重要。高端消费级 GPU 可以提供出色的推理速度,但内存相对有限。紧凑型 AI 系统可以在更低功耗下提供大得多的内存,但内存带宽要低得多。边缘平台增加了传感器处理、实时视频和物理接口,而传统的 GPU 工作站从未被设计来处理这些。
结果是,可能不再存在一台理想的 AI 计算机。取而代之的,可能是一个理想的 AI 执行架构。
不同硬件解决不同问题
考虑当前几类 NVIDIA 平台。它们并不只是同一台机器更快和更慢的版本。它们代表了不同的能力特征。
GeForce RTX 5090 围绕极高的计算吞吐量和内存带宽而设计。凭借 32 GB GDDR7 内存和非常高的带宽,当模型能够轻松放入 GPU 内存时,它特别适合对延迟敏感的推理。
DGX Spark 做出了几乎相反的取舍。它将 128 GB 一致性统一内存与 273 GB/s 内存带宽以及相对较低的功耗范围结合在一起。它的主要优势不是最大 token 吞吐量,而是能够将大得多的模型和上下文常驻内存。
Jetson AGX Thor 也提供了大型统一内存架构,但其用途不同。它是为物理 AI 设计的:摄像头流、音频、传感器融合、机器人技术,以及其他 AI 必须与物理环境实时交互的工作负载。
在专业端,RTX PRO 6000 Blackwell 将 96 GB GDDR7 ECC 内存与极高的内存带宽结合在一起。这类加速器对商业多租户推理尤其有吸引力,因为它将大得多的内存容量与工作站级吞吐量结合在一起。
延迟、容量与物理 AI
一个有用的基础设施模型将工作负载分为三大类。
面向延迟的推理
面向容量的推理
物理 AI
AI 路由器成为真正的平台
- 一个简短的内部 FAQ 请求可以发送到 RTX GPU 上的快速本地模型。
- 涉及数百个文档的请求可以路由到内存丰富的 Spark 节点。
- 摄像头或传感器工作负载可以分派到 Thor。
- 如果租户策略允许,特别困难的推理请求可以选择升级到前沿云模型。
多模型服务与分布式推理不同
但私有 AI 服务并不一定需要分发每个模型。相反,它可以让不同的模型常驻在不同的节点上。
- 一个节点可以托管快速的对话模型。
- 另一个节点可以托管大型推理模型。
- 第三个节点可以运行嵌入和重排序。
- Thor 可以处理实时视觉、音频和传感器工作负载。
在这种架构中,请求和响应通过网络传输,而不是通过内部模型张量。这是多模型服务,而不是分布式模型推理。
对于许多商业部署而言,这种方式更简单、更便宜,也更容易扩展。

一个集群可以服务多家公司
基础设施容量不能仅以客户公司的数量来衡量。
二十家公司并不一定会产生二十个同时进行的推理工作负载。一家拥有三十名员工的公司,在正常办公工作中可能只会产生少量并发请求,而一个自动化程度很高的客户可能会维持数十个持续运行的代理。
因此,相关的容量指标是并发数、每秒令牌数、上下文大小、每分钟请求数和服务优先级。
这为统计复用创造了机会:客户很少会同时消耗其合同约定的最大容量。
因此,异构集群可以服务许多较小的组织,同时仍为对延迟或可用性有更严格要求的客户保留容量。
商业产品不是 GPU 时间
与超大规模 GPU 租赁提供商直接竞争很困难。他们的经济模式是围绕基础设施利用率和规模进行优化的。
更具防御性的产品是托管式私有 AI 平台。
- 私有推理
- 检索增强生成
- 租户隔离
- 基于角色的访问控制
- 审计日志
- 模型路由
- 文档摄取
- 连接器和 API
- 评估和监控
- 专用或预留容量
客户主要支付的并不是访问 GPU 的费用。客户支付的是受控的 AI 应用层。
本地模型不需要击败前沿 AI
另一个架构错误是将开放权重模型视为最强前沿系统的直接替代品。
它们不必如此。
一家公司问,“这份合同中定义的终止期是什么?”并不一定需要可用的最强通用推理模型。
它需要可靠的摄取、正确的检索、权限感知的访问、来源溯源以及一个足够强大的模型。
对于很大比例的企业工作负载,周围应用层的质量可能与底层LLM同样重要。
因此,平台可以将本地模型用于隐私敏感和高容量工作负载,同时将前沿模型保留给真正需要它们的相对较小比例的请求。
这创造了一种级联推理形式:廉价的私有模型处理大多数请求,而更昂贵的能力仅在必要时被调用。
面向未来并不意味着防止过时
从字面意义上说,没有AI加速器是面向未来的。新硬件总会变得更快。
有用的工程目标反而是降低技术过时风险。
今天作为主要推理设备的GPU,以后可以成为嵌入服务器、批处理工作器、图像生成节点或辅助推理池。
一个曾托管最大可用模型的内存丰富系统,以后可以成为专用的RAG、长上下文或批分析节点。
新硬件应该扩展平台,而不是使其失效。
这要求将执行层与应用层分离。
持久资产不是GPU本身。它们是API契约、路由逻辑、租户模型、安全规则、文档管道、RAG架构、评估系统、可观测性和客户集成。
硬件成为可替换的基础设施。
真正的产品
因此,最持久的私有AI架构看起来不太像工作站,而更像一个微型云。
- 不同的硬件池提供不同的能力。
- 调度层决定每个工作负载的归属。
- 本地模型处理私有和高并发的请求。
- 物理AI硬件处理传感器和实时环境。
- 前沿服务作为受控的升级路径保持可用。
- 可以引入新的加速器,而无需强制客户更改其应用程序。
从这个角度来看,核心问题不再是:
应该用哪块GPU来驱动系统?
而是变成了:
当GPU、模型或提供商发生变化时,平台能否继续提供相同的服务?
如果答案是肯定的,那么基础设施所实现的价值就远不止是拥有快速的硬件。
它已将计算转变为可替换的执行层。
而这正是私有AI系统开始成为一个平台的地方。
Related Articles
mozilla-thunderbird-68-x-kann-oauth2-fuer-provider-for-google-calendar-nicht-speichern
Google I/O 2026:Android XR、智能眼镜与环境AI界面
Google I/O 2026 将 Android XR 和智能眼镜从概念推向实际平台方向。本文解析了音频眼镜、显示眼镜、Gemini 驱动的上下文感知、开发者影响、隐私风险,以及为何可穿戴 AI 更关乎创造环境辅助界面,而非取代手机。
下一代OpenWrt 5G路由器:为何Wi-Fi 7、更强CPU与更优固件至关重要
ZBT Z8102AX 是一个有用的初步样品,但下一步应该更强:Wi-Fi 7、更强大的四核平台、更清晰的固件、改进的包装以及更稳定的定价策略。目标不仅仅是另一款5G路由器,而是一款配置更优、基于OpenWrt的准专业级设备。
企业级多租户架构,适用于国际平台
Loving Rocks 是一款企业级婚礼平台,采用真正的多租户架构设计,实现租户间数据库隔离,并内置国际化支持,以确保全球可扩展性、安全性及长期运营稳定性。
Google I/O 2026:反重力、AI Studio 以及向智能体开发工具的转变
Google I/O 2026 向工程师们明确传达了一个信息:AI 工具正从自动补全迈向托管式自主执行。本文深入解析 Antigravity 2.0、Google AI Studio 不断扩展的角色、Gemini 3.5 Flash,以及在编排、锁定效应、验证和开发者工作流设计方面的实际权衡。

Ollama 并非产品:构建可投入生产的开源大语言模型应用
使用Ollama运行本地模型很简单。但构建一个可用于生产环境的开源大语言模型(Open-LLM)应用则更具挑战性:它需要RAG(检索增强生成)、访问控制、供应商抽象、评估、日志记录、部署规范,以及围绕模型构建受控的应用层。
Database Marketing – Modern Approach for Customer Relationships
Modern overview of database marketing: from data strategy and technical architecture to automation, GDPR and best practices for sustainable customer relationships.
交付与变更管理综合指标指南
本指南详细概述了企业交付与变革管理的关键指标,帮助团队衡量绩效、优化流程并推动持续改进。探索关键指标、计算方法及最佳实践,使您的指标与业务成果保持一致。
Welcome to NuxtWP Multilang Theme
Introduction to the NuxtWP Multilang Theme - a modern multilingual CMS built with Nuxt 4.
install-pcl-library-on-python-ubuntu-19-10-point-cloud-librar
从研究协议到通用AI推理框架
为严谨的AI辅助研究而开发的一套方法论,其可推广范围远超研究本身。通过将证据与假设分离、检验相互竞争的假设、控制提示框架、搜寻反证并应用领域特定的验证器,同一推理架构可以改进调试、软件设计、战略、技术分析以及AI辅助决策支持。
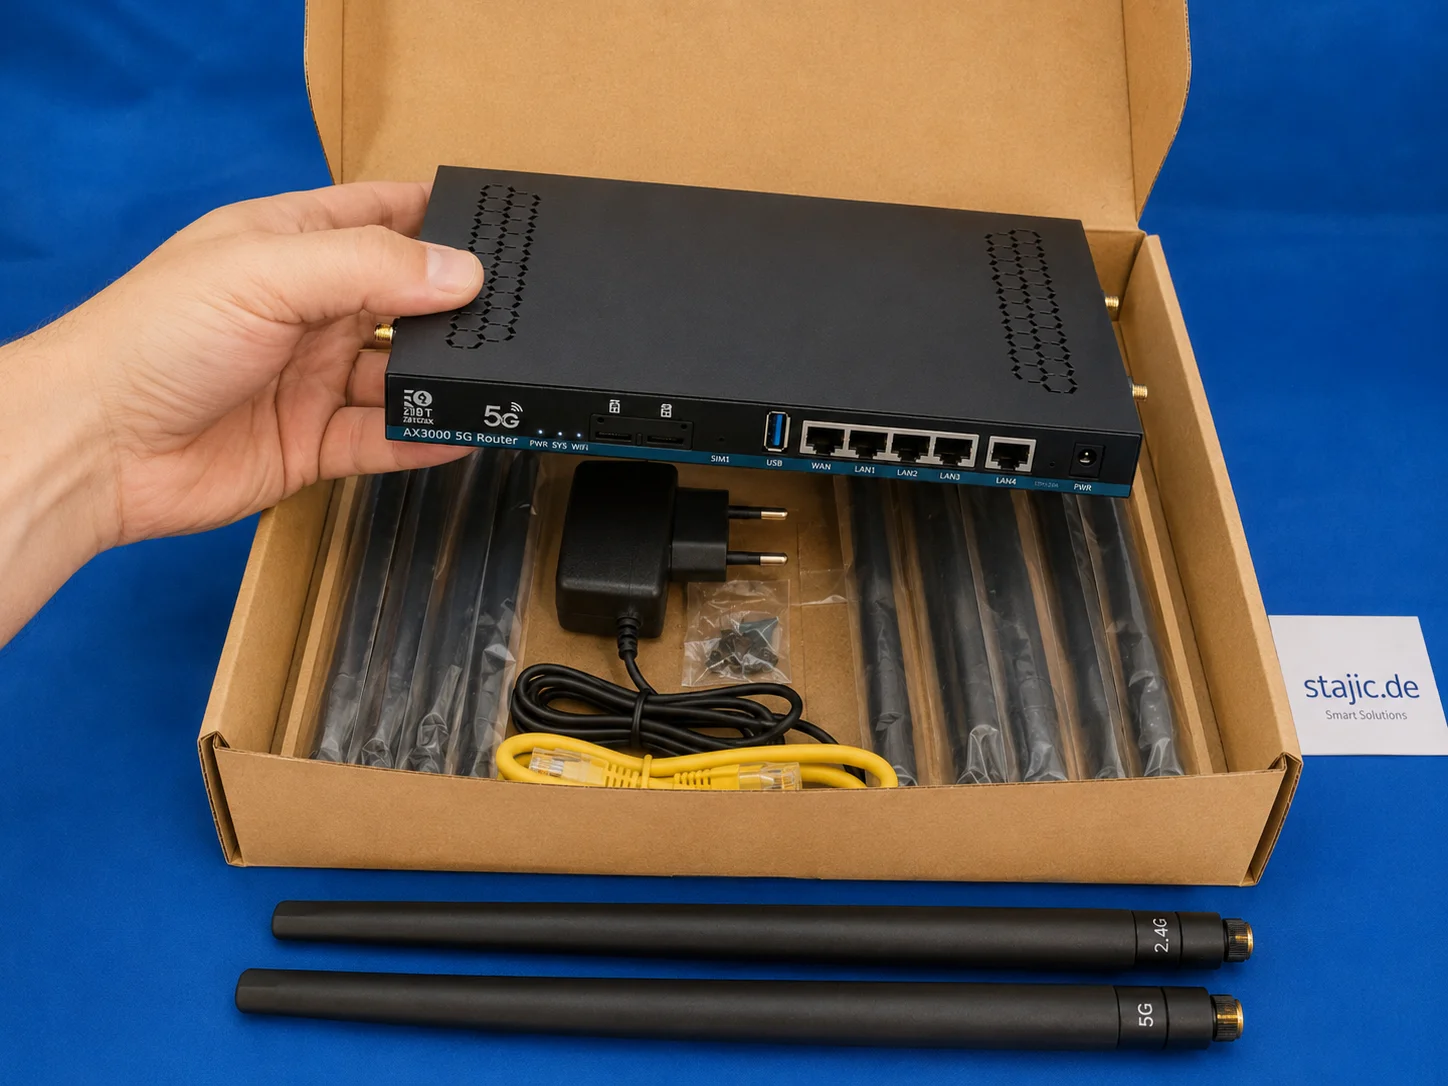
ZBT Z8102AX 硬件与包装评测:强劲路由器,薄弱包装
ZBT Z8102AX 作为一款纤薄黑色金属5G OpenWrt路由器,配备多个天线接口、双SIM卡槽、USB、LAN/WAN端口及实用配件套装,给人留下扎实的第一印象。硬件设计实用且专业,但包装显然是薄弱环节。