
企业AI运行手册中回滚触发器的全面指南
# 回滚触发器指南
## 回滚触发器简介
在企业AI运行手册中,回滚触发器作为自动化的安全防护措施,用于检测部署问题并回滚到稳定的先前版本。这些触发器对于在高风险的AI环境中最大限度地减少停机时间、保护用户体验和确保合规性至关重要。通过定义精确的回滚条件,团队可以在几秒钟内而不是几小时内对故障做出响应。
回滚触发器与CI/CD流水线、监控工具以及AI特定指标(如模型漂移或推理延迟峰值)无缝集成。
## 回滚触发器的主要优势
- **快速恢复**:在检测到问题后的几秒钟内自动回滚更改。 - **减少人为错误**:消除在紧急情况下的手动干预。 - **合规性保证**:记录所有触发器事件以供审计追踪。 - **节省成本**:防止长时间暴露于产生高计算成本的有缺陷模型。 - **可扩展性**:轻松处理数千个微服务或模型变体。
## 回滚触发器的类型
### 1. 基于指标的触发器
监控定量KPI,例如: - 错误率超过5%。 - 延迟增加超过200毫秒(p95)。 - CPU/内存使用率峰值超过90%。
### 2. 异常检测触发器
利用AI驱动的异常检测: - 模型准确率突然下降。 - 表明A/B测试失败的异常流量模式。 - 数据漂移分数超过预定义阈值。
### 3. 金丝雀和蓝绿部署触发器
特定于部署的触发器: - 金丝雀发布失败(例如,健康实例<80%)。 - 影子流量差异导致的蓝绿切换回滚。
### 4. 手动和外部触发器
- 用于按需回滚的API端点。 - 与PagerDuty或Slack集成以实现人工覆盖。
## 配置回滚触发器:分步指南
### 步骤1:定义触发条件
在您的运行手册YAML配置中:
- 设置阈值:`错误率 > 0.05 持续2分钟`。 - 指定评估窗口:滚动5分钟平均值。 - 添加迟滞以防止抖动:`>5% 上升,<3% 下降`。
### 步骤2:选择回滚范围
选择粒度: - **模型级别**:回滚特定的AI模型版本。 - **服务级别**:回滚整个微服务。 - **集群级别**:回滚Kubernetes部署。
### 步骤3:集成监控
连接到Prometheus、Datadog或自定义AI可观测性平台等工具:
- 通过`/metrics`端点导出指标。 - 使用`PromQL`查询定义警报。 - 为外部系统启用Webhook通知。
### 步骤4:测试触发器
- **演练模式**:模拟故障而不实际执行回滚。 - **混沌工程**:使用Gremlin等工具注入故障。 - **历史重放**:针对过去的事件数据进行测试。
### 步骤5:部署和监控
- 通过GitOps(ArgoCD、Flux)推出。 - 为触发器历史设置仪表板。 - 每周审查误报。
## 有效回滚触发器的最佳实践
- **多触发器逻辑**:使用AND/OR组合(例如,高错误率AND高延迟)。 - **宽限期**:部署后允许30-60秒的预热时间。 - **版本固定**:始终回滚到已知良好的版本,而不是最新版本。 - **警报疲劳预防**:将相关指标分组到复合触发器中。 - **回滚后分析**:自动生成事件报告。
## 常见陷阱与解决方案
| 陷阱 | 解决方案 | |--------|----------| | 误报 | 增加评估窗口并添加多个条件。 | | 检测缓慢 | 使用亚分钟级的轮询间隔。 | | 回滚不完整 | 通过健康检查验证回滚成功。 | | 触发器过于激进 | 实施分阶段回滚(50% -> 100%)。 |
## 高级功能
- **ML优化触发器**:使用强化学习自动调整阈值。 - **联邦触发器**:跨多云设置协调回滚。 - **预测性触发器**:使用时序预测来预先发现问题。
## 监控与维护
跟踪以下KPI: - 触发器触发率(目标:<1%的部署)。 - 平均回滚时间(目标:<30秒)。 - 回滚成功率(目标:99.9%)。
在冲刺评审期间定期审核配置。
## 结论
回滚触发器将AI部署从高风险实验转变为可靠的生产系统。通过主动定义和完善这些机制,企业团队实现了前所未有的稳定性和速度。从基本指标触发器开始,逐步发展为AI驱动的异常检测,以获得最佳结果。
Related Articles
Google I/O 2026:搜索、工作空间和购物中的智能代理产品
Google I/O 2026 展示了代理型 AI 正从模型演示和开发者工具走向日常产品界面。本文解析了搜索、Workspace、Gemini Spark 和 Universal Cart 如何指向一种新的产品模式——谷歌代理帮助用户在互联服务中研究、工作、购物和行动。
ZBT Z8102AX 双SIM卡故障切换:有效功能、缺失功能及固件需改进之处
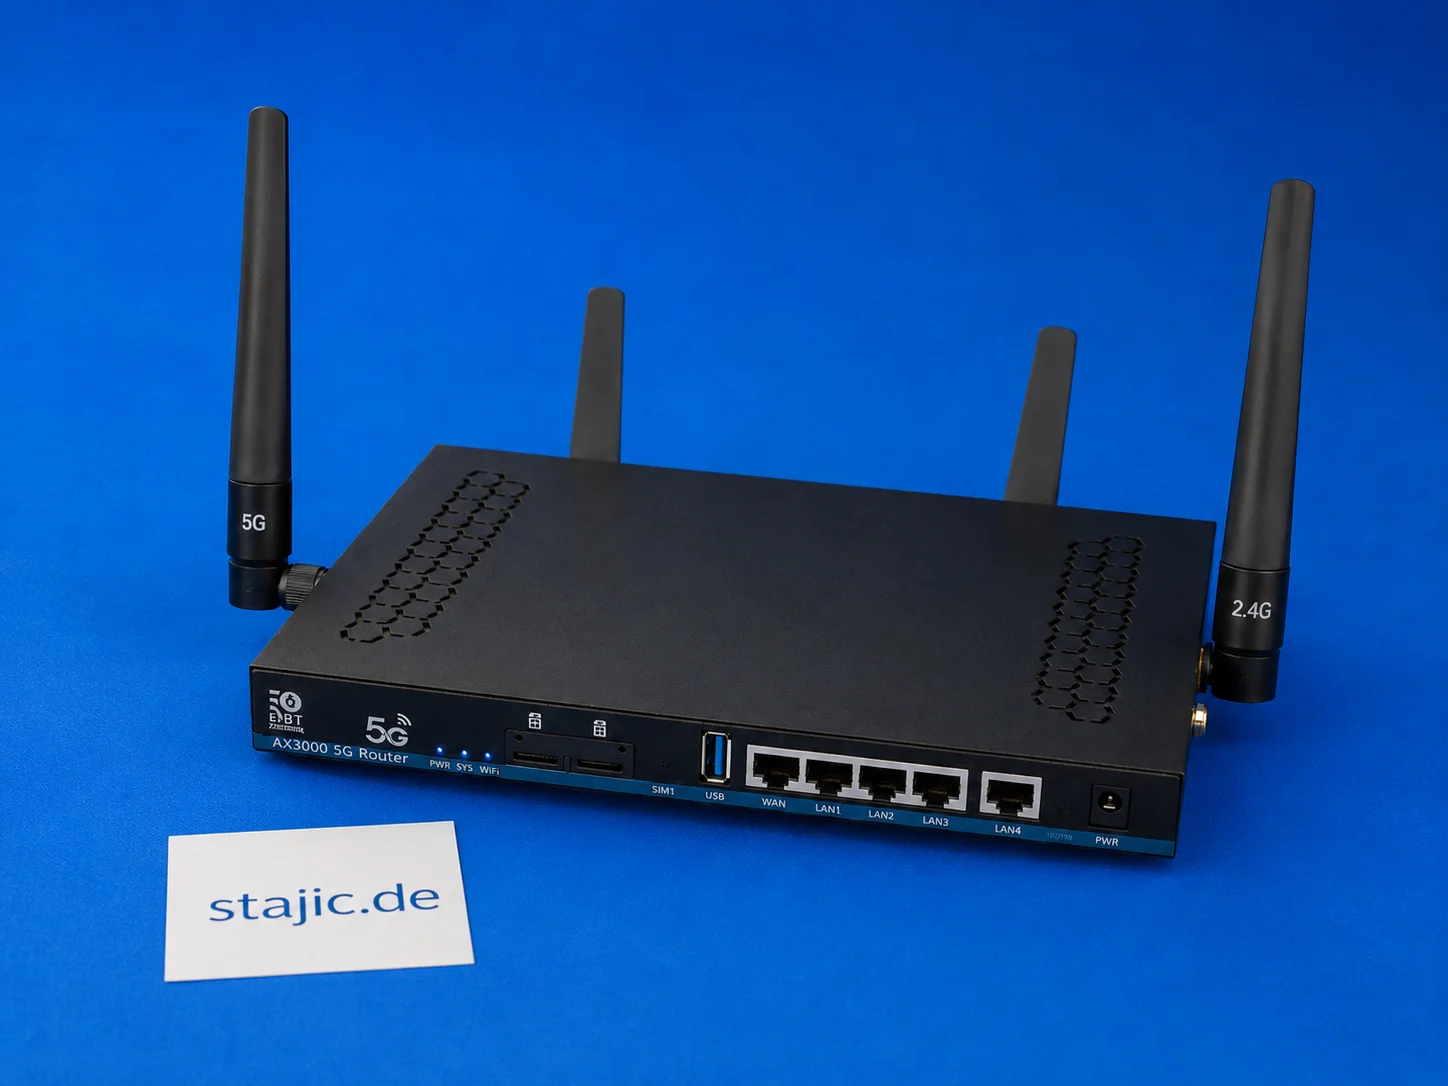
ZBT Z8102AX是一款双SIM卡5G OpenWrt路由器,但仅具备双SIM卡硬件并不等同于智能故障切换。该路由器能识别SIM卡并成功连接,但自动切换、调制解调器恢复、基于信号的决策以及清晰的故障切换逻辑仍需更深入的测试。
超越提示工程:一种更可靠的人工智能推理方法
大型语言模型未必是因为缺乏推理能力而失败。它们常常失败,是因为推理过程没有得到充分的约束、质疑或验证。本文提出一种与领域无关的方法论,将提示转化为一种结构化的认知过程:将事实与假设分离,生成相互竞争的假说,检验反证,应用证伪,并检查结论在替代性框架下是否仍然稳定。目标不是让模型“更少同意”,而是让它的结论更少依赖于用户最初的框架。
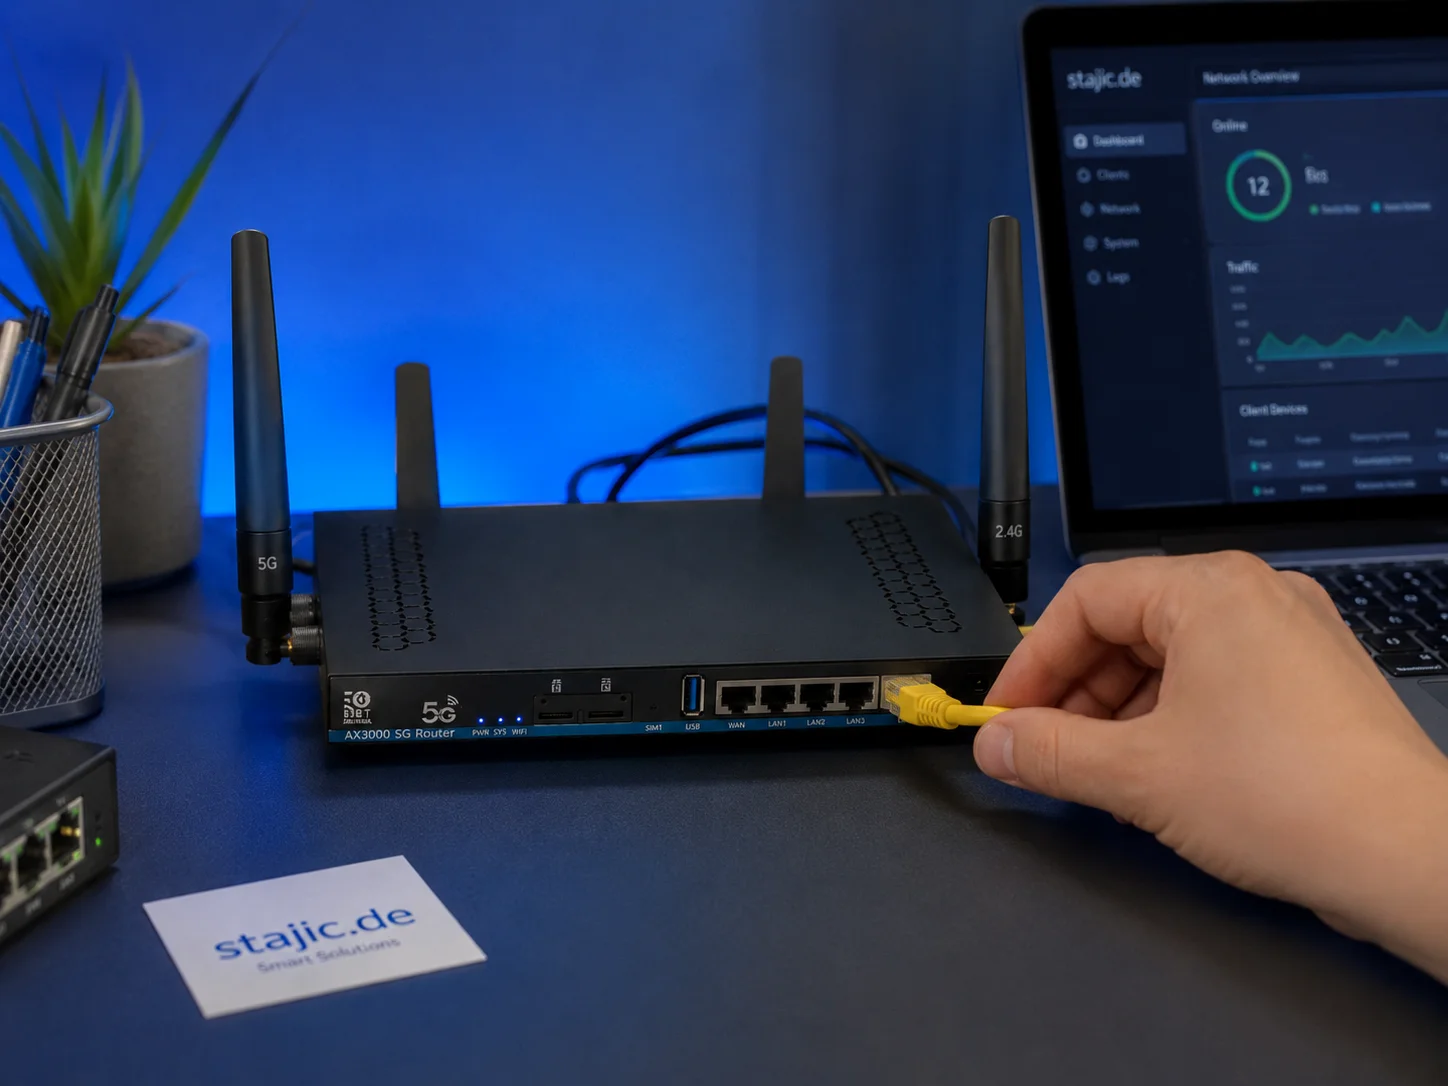
ZBT Z8102AX OpenWrt 21.02 固件评测:足够稳定,但能否面向未来?
ZBT Z8102AX 运行的是厂商修改版 OpenWrt 21.02 固件,内核版本为 5.4.246。实际测试中,该固件运行稳定,可保持路由器连续数日正常工作,但老旧的基础版本引发了关于安全性、调制解调器控制、升级路径及长期可维护性的重要问题。
证据能否在人工智能流水线中存续?——证据保全链
证据在源头可能是正确的,但在经过解析、规范化、分块、检索和上下文组装之后,仍可能变得不可靠。证据保全链追踪的是身份、来源、范围和含义是否在整个AI流水线中得以保留。
Enterprise Start Here: Your Gateway to Operational Excellence
New to our enterprise platform? This guide provides a structured onboarding path, from foundational reference models to actionable playbooks, runbooks, and assessments designed for seamless implementation.
为什么AI会检索某些来源而忽略其他来源?——检索权威层
找到相关文档还不够。AI系统还需要区分哪些来源是当前的、权威的、适用的和可追溯的,哪些来源只是看起来相似。检索权威层定义了这种来源选择的边界。
Test DEv Enterprise Stajic.de 全面指南:架构与最佳实践
探索使用 Test DEv Enterprise Stajic.de 管理企业级开发和测试环境的架构原则、优势及技术细节。
Ollama 并非产品:构建可投入生产的开源大语言模型应用
使用Ollama运行本地模型很简单。但构建一个可用于生产环境的开源大语言模型(Open-LLM)应用则更具挑战性:它需要RAG(检索增强生成)、访问控制、供应商抽象、评估、日志记录、部署规范,以及围绕模型构建受控的应用层。
答案有效性边界:相关性到可靠AI答案之间缺失的层级
一个来源可能相关、权威,但对于所提出的问题仍然是错误的。缺失的层次是适用性:答案成立的条件,以及迫使其被重新考虑的变化。本文介绍了“答案有效性边界”这一面向人类、AI搜索和RAG系统的来源设计模式。
提示不变性:结论在提示变化后是否依然成立?
一种用于检验AI结论是否依赖于问题表述方式的实用方法。提示不变性比较原始、盲测、反向和对抗性表述,同时保持证据结构受控。
向量数据库、嵌入和重排序:检索的三个不同部分
嵌入表示含义,向量数据库检索候选结果,重排序器则精炼结果。了解这三个检索层在RAG中如何不同并协同工作。