
Guide complet des déclencheurs de rollback dans les runbooks IA d'entreprise
# Guide des déclencheurs de rollback
## Introduction aux déclencheurs de rollback
Dans les runbooks IA d'entreprise, les déclencheurs de rollback servent de sauvegardes automatisées qui détectent les problèmes de déploiement et reviennent à une version précédente stable. Ces déclencheurs sont essentiels pour minimiser les temps d'arrêt, protéger l'expérience utilisateur et garantir la conformité dans les environnements IA à enjeux élevés. En définissant des conditions précises de rollback, les équipes peuvent réagir aux défaillances en quelques secondes plutôt qu'en quelques heures.
Les déclencheurs de rollback s'intègrent parfaitement aux pipelines CI/CD, aux outils de surveillance et aux métriques spécifiques à l'IA comme la dérive de modèle ou les pics de latence d'inférence.
## Principaux avantages des déclencheurs de rollback
- **Récupération rapide** : Rétablit automatiquement les modifications en quelques secondes après la détection des problèmes. - **Réduction des erreurs humaines** : Élimine l'intervention manuelle dans les situations de panique. - **Assurance de conformité** : Consigne tous les événements de déclenchement pour les pistes d'audit. - **Économies** : Évite une exposition prolongée à des modèles défectueux entraînant des coûts de calcul élevés. - **Évolutivité** : Gère sans effort des milliers de microservices ou de variantes de modèles.
## Types de déclencheurs de rollback
### 1. Déclencheurs basés sur les métriques
Surveillez les KPI quantitatifs tels que : - Taux d'erreur dépassant 5 %. - Augmentation de la latence au-delà de 200 ms p95. - Pic d'utilisation du processeur/mémoire supérieur à 90 %.
### 2. Déclencheurs de détection d'anomalies
Exploitez la détection d'anomalies pilotée par l'IA : - Chutes soudaines de la précision du modèle. - Modèles de trafic inhabituels indiquant des échecs de test A/B. - Scores de dérive des données dépassant les seuils prédéfinis.
### 3. Déclencheurs Canary et Blue-Green
Déclencheurs spécifiques au déploiement : - Échec du déploiement Canary (par ex. <80 % d'instances saines). - Retour à la version précédente Blue-Green en cas d'écarts de trafic shadow.
### 4. Déclencheurs manuels et externes
- Points de terminaison API pour les rollbacks à la demande. - Intégration avec PagerDuty ou Slack pour la prise de contrôle humaine.
## Configuration des déclencheurs de rollback : étape par étape
### Étape 1 : Définir les conditions de déclenchement
Dans la configuration YAML de votre runbook :
- Définir les seuils : `error_rate > 0.05 pendant 2m`. - Spécifier les fenêtres d'évaluation : Moyennes glissantes sur 5 minutes. - Ajouter une hystérésis pour éviter les oscillations : `>5% en hausse, <3% en baisse`.
### Étape 2 : Sélectionner la portée du rollback
Choisir la granularité : - **Niveau modèle** : Revenir à des versions spécifiques de modèles IA. - **Niveau service** : Effectuer un rollback de l'ensemble du microservice. - **Niveau cluster** : Revenir aux déploiements Kubernetes.
### Étape 3 : Intégrer la surveillance
Se connecter à des outils comme Prometheus, Datadog ou des plateformes d'observabilité IA personnalisées :
- Exporter les métriques via le point de terminaison `/metrics`. - Définir des alertes avec des requêtes `PromQL`. - Activer les notifications webhook pour les systèmes externes.
### Étape 4 : Tester les déclencheurs
- **Mode Dry-Run** : Simuler des défaillances sans rollback réel. - **Chaos Engineering** : Injecter des pannes à l'aide d'outils comme Gremlin. - **Rejeu historique** : Tester sur des données d'incidents passés.
### Étape 5 : Déployer et surveiller
- Déployer via GitOps (ArgoCD, Flux). - Configurer des tableaux de bord pour l'historique des déclencheurs. - Examiner les faux positifs chaque semaine.
## Bonnes pratiques pour des déclencheurs de rollback efficaces
- **Logique multi-déclencheurs** : Utiliser des combinaisons AND/OR (par ex. erreur élevée ET latence). - **Périodes de grâce** : Autoriser 30-60s de préchauffage après déploiement. - **Épinglage de version** : Toujours revenir à des versions connues stables, pas aux dernières. - **Prévention de la fatigue des alertes** : Regrouper les métriques liées en déclencheurs composites. - **Analyse post-rollback** : Générer automatiquement des rapports d'incident.
## Pièges courants et solutions
| Piège | Solution | |--------|----------| | Faux positifs | Augmenter la fenêtre d'évaluation et ajouter plusieurs conditions. | | Détection lente | Utiliser des intervalles de sondage inférieurs à la minute. | | Rollbacks incomplets | Vérifier le succès du rollback avec des contrôles de santé. | | Déclencheurs trop agressifs | Mettre en œuvre des rollbacks progressifs (50% -> 100%). |
## Fonctionnalités avancées
- **Déclencheurs optimisés par ML** : Ajuster automatiquement les seuils grâce à l'apprentissage par renforcement. - **Déclencheurs fédérés** : Coordonner les rollbacks sur des configurations multi-cloud. - **Déclencheurs prédictifs** : Utiliser des prévisions de séries temporelles pour anticiper les problèmes.
## Surveillance et maintenance
Suivre ces KPI : - Taux de déclenchement (cible : <1% des déploiements). - Temps moyen de rollback (cible : <30s). - Taux de succès des rollbacks (cible : 99,9%).
Auditer régulièrement les configurations lors des revues de sprint.
## Conclusion
Les déclencheurs de rollback transforment les déploiements d'IA d'expériences risquées en systèmes de production fiables. En définissant et en affinant ces mécanismes de manière proactive, les équipes d'entreprise atteignent une stabilité et une vélocité sans précédent. Commencez par des déclencheurs de métriques basiques et évoluez vers une détection d'anomalies pilotée par l'IA pour des résultats optimaux.
Related Articles
Architecture Canonique, Conception d'URL, Logique de Résolution, Spécification d'API et d'Évolutivité
Architecture de découverte géolocalisée pour les portails multi-locataires. Définit les URL canoniques, la logique de résolution, la stratégie de mise en cache et un modèle de lecture géo sans couplage CMS ni refactorisation de base de données. Conçue pour la stabilité SEO, l'évolutivité et les futures extensions comme la réservation et les cartes.
Le prompt fait partie du biais : comment le cadrage de l'IA façonne le raisonnement
La formulation d'un prompt n'est pas neutre. Explorez comment le cadrage, les présupposés, le suivi des instructions et la sycophancie peuvent façonner le raisonnement de l'IA—et pourquoi des conclusions fiables nécessitent des tests au-delà du prompt initial.
Pourquoi l'IA récupère-t-elle certaines sources et en ignore-t-elle d'autres ? — La couche d'autorité de récupération
Trouver un document pertinent ne suffit pas. Les systèmes d’IA doivent aussi distinguer les sources actuelles, faisant autorité, applicables et traçables des sources qui semblent simplement similaires. La couche d’autorité de récupération définit cette frontière de sélection des sources.
Bases de données vectorielles, plongements et reclassement : trois parties distinctes de la recherche
Les embeddings représentent le sens, les bases de données vectorielles récupèrent des candidats, et les rerankers affinent les résultats. Découvrez comment ces trois couches de récupération diffèrent et fonctionnent ensemble dans le RAG.
Google I/O 2026 : Antigravity, AI Studio et la transition vers les DevTools agentiels
Google I/O 2026 a rendu une chose claire pour les ingénieurs : les outils d'IA vont désormais au-delà de l'autocomplétion pour passer à une exécution agentique gérée. Cet article décrypte Antigravity 2.0, le rôle croissant de Google AI Studio, Gemini 3.5 Flash et les véritables compromis autour de l'orchestration, du verrouillage, de la vérification et de la conception des workflows de développement.
L'IA générative expliquée : modèles, recherche, outils et applications ne sont pas la même chose
L'IA générative est plus qu'un modèle. Découvrez comment les modèles, la récupération, les outils, le contexte, les environnements d'exécution et les applications s'articulent dans les systèmes d'IA en production.
Guide ultime des critères d'acceptation pour l'adoption des LLM dans les playbooks d'entreprise
Maîtrisez l'art de définir des critères d'acceptation précis pour garantir une intégration réussie des LLM dans votre environnement d'entreprise. Ce guide complet fournit des cadres d'action, des exemples et des bonnes pratiques adaptés à une adoption pilotée par des playbooks.
MCP vs A2A vs UCP vs AP2 vs A2UI : La pile de protocoles d'agent expliquée
MCP, A2A, UCP, AP2 et A2UI sont souvent présentés comme des standards d'agents concurrents. Ils résolvent principalement des problèmes d'interopérabilité différents. Ce guide associe chaque protocole à la frontière qu'il standardise réellement—et montre comment ils peuvent fonctionner ensemble dans un seul système de production.
MLOps vs LLMOps : qu'est-ce qui change lorsque le modèle est un LLM
MLOps exploite les systèmes d'apprentissage automatique ; LLMOps étend ces pratiques aux prompts, au contexte, à la récupération, aux fournisseurs, aux outils, aux évaluations et au comportement d'exécution autour des grands modèles de langage.
Qwen 3.6 en production : Runbook de déploiement, Rollback IA et Versionnage LLMOps
Qwen 3.6 n'est pas seulement une autre mise à jour de modèle. C'est à la fois un événement de déploiement, un scénario de rollback et un problème de versionnage. Cet article explique comment Qwen 3.6 doit être géré en production à travers la discipline LLMOps, la traçabilité des prompts et des modèles, le déploiement contrôlé et une préparation au rollback basée sur des preuves.
Guide complet des métriques pour la livraison et la gestion du changement
Ce guide fournit un aperçu détaillé des métriques essentielles pour la livraison et la gestion du changement en entreprise, aidant les équipes à mesurer la performance, optimiser les processus et favoriser l'amélioration continue. Découvrez les indicateurs clés, les méthodes de calcul et les meilleures pratiques pour aligner vos métriques sur les résultats commerciaux.
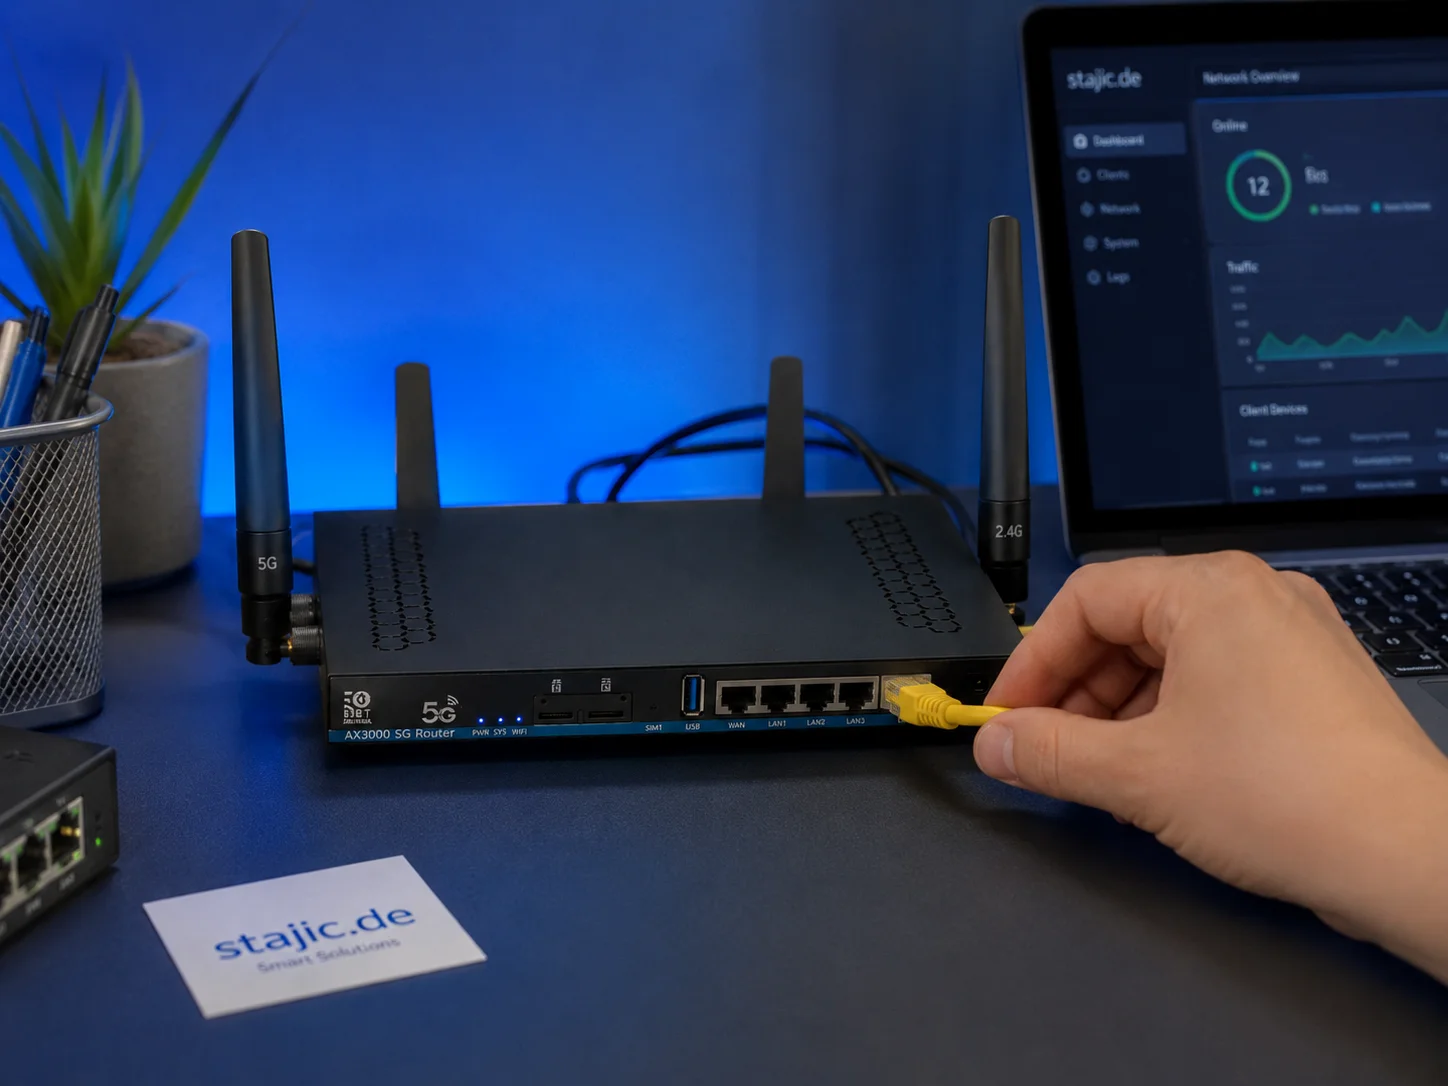
Test du firmware OpenWrt 21.02 du ZBT Z8102AX : assez stable, mais est-il paré pour l'avenir ?
Le ZBT Z8102AX fonctionne sous une version d'OpenWrt 21.02 modifiée par le fabricant avec le noyau 5.4.246. Lors des tests pratiques, le firmware a fonctionné avec succès et a maintenu le routeur stable pendant plusieurs jours, mais cette ancienne base soulève d'importantes questions sur la sécurité, le contrôle du modem, les chemins de mise à niveau et la maintenabilité à long terme.