
How to Scan and Clean Your Cloud Linux Server from Malware
How to Scan and Clean Your Cloud Linux Server from Malware
Learn how to uncover potential malware and security risks on your cloud Linux server using essential scanning tools.
Why Malware Detection is Crucial for Your Cloud Server
Some unexpected behavior on a cloud Linux server could be a result of a malware infection, while other malicious software might not alert to its presence. Scanning your system for different types of unwanted programs can help identify potential issues, or at least give you peace of mind knowing that your server is clean.
There are multiple options for ensuring your cloud server is free from malware. In this guide, we will discuss a couple of essential scanning software tools you can utilize to check your system.
ClamAV: A Popular Antivirus Solution for Linux
ClamAV is a well-known open-source antivirus engine available on most Linux distributions.
To install ClamAV on your system, run:
sudo apt-get install clamav clamav-daemonUpdate the virus database:
sudo systemctl stop clamav-freshclam
sudo freshclam
Start and enable the services:
sudo systemctl start clamav-freshclam
sudo systemctl enable clamav-freshclam
Run a test scan:
sudo clamscan -r /homeHow to Test ClamAV
Download the harmless EICAR test file:
wget -P ~/ http://www.eicar.org/download/eicar.comScan again to verify detection:
sudo clamscan -r /homeRemove detected files:
sudo clamscan --infected --remove --recursive /homeFull system scan:
sudo clamscan --infected --recursive --exclude-dir="^/sys" /Conclusion
Regular malware scanning with tools like ClamAV helps keep your cloud Linux server secure and reliable.
Related Articles
Bases de données vectorielles, plongements et reclassement : trois parties distinctes de la recherche
Les embeddings représentent le sens, les bases de données vectorielles récupèrent des candidats, et les rerankers affinent les résultats. Découvrez comment ces trois couches de récupération diffèrent et fonctionnent ensemble dans le RAG.

L'IA générative expliquée : modèles, recherche, outils et applications ne sont pas la même chose
L'IA générative est plus qu'un modèle. Découvrez comment les modèles, la récupération, les outils, le contexte, les environnements d'exécution et les applications s'articulent dans les systèmes d'IA en production.
Le prochain routeur 5G OpenWrt : pourquoi le Wi-Fi 7, un processeur plus puissant et un meilleur firmware comptent
Le ZBT Z8102AX est un premier échantillon utile, mais la prochaine étape devrait être plus ambitieuse : Wi-Fi 7, une plateforme quatre cœurs plus puissante, une meilleure clarté du firmware, un packaging amélioré et une politique de prix plus stable. L’objectif n’est pas simplement un autre routeur 5G, mais un appareil prosumer basé sur OpenWrt mieux configuré.
Quand une IA devrait-elle cesser de faire confiance à ses propres connaissances ? — Le déclencheur de récupération
Un modèle d'IA n'a pas besoin de récupération pour chaque question. Le problème important est de savoir quand ses connaissances internes ne suffisent plus. Le Déclencheur de Récupération est une frontière de décision pratique qui détermine quand un système d'IA devrait cesser de se fier uniquement aux connaissances du modèle et obtenir des preuves externes avant de répondre.
Les preuves peuvent-elles survivre au pipeline d’IA ? — La chaîne de préservation des preuves
Une preuve peut être correcte à la source et devenir néanmoins peu fiable après l'analyse syntaxique, la normalisation, le découpage, la récupération et l'assemblage du contexte. La chaîne de préservation des preuves vérifie si l'identité, la provenance, la portée et le sens survivent à l'ensemble du pipeline d'IA.
D'où un LLM tire-t-il ses données ? Sources de données RAG en Python
Un LLM ne connaît pas magiquement vos fichiers, bases de données ou API. Cette suite pratique de la série sur le RAG montre, avec du Python simple, comment des données externes deviennent des preuves récupérables : des fichiers texte et du SQL à la recherche en texte intégral, aux embeddings, à l'assemblage du contexte et à l'appel final au LLM.
Ollama n'est pas le produit : construire des applications Open-LLM prêtes pour la production
Exécuter un modèle local avec Ollama est facile. Construire une application Open-LLM prête pour la production est plus difficile : cela nécessite du RAG, du contrôle d'accès, de l'abstraction de fournisseur, de l'évaluation, de la journalisation, de la discipline de déploiement et une couche applicative contrôlée autour du modèle.
L'IA agentique expliquée : quand un système d'IA peut planifier, utiliser des outils et agir
L'IA agentique utilise des modèles au sein de boucles d'exécution multi-étapes où ils peuvent choisir des outils, observer les résultats, mettre à jour l'état et adapter leur action suivante dans des limites explicites d'exécution et de permissions.
MLOps vs LLMOps : qu'est-ce qui change lorsque le modèle est un LLM
MLOps exploite les systèmes d'apprentissage automatique ; LLMOps étend ces pratiques aux prompts, au contexte, à la récupération, aux fournisseurs, aux outils, aux évaluations et au comportement d'exécution autour des grands modèles de langage.
Google I/O 2026 : pivots architecturaux, IA agentique et confrontation à la réalité de l'écosystème unifié
Google I/O 2026 n'était pas seulement un événement dédié aux modèles. Il a révélé une transition de plateforme plus profonde à travers les modèles Gemini, les outils de développement, les interfaces liées à Android et les appareils intelligents. Cet article décrypte la keynote comme un article de référence pour les ingénieurs, les architectes et les équipes produit qui doivent distinguer les implications réelles sur le runtime de la hype des présentations sur scène.
Migration du SDK OpenAI Agents vers l'API Agents : qu'est-ce qui change réellement sur le plan architectural ?
La migration du SDK OpenAI Agents vers la nouvelle API Agents n'est pas un simple renommage d'import. La frontière d'exécution change : la boucle d'agent, la session durable, l'orchestration, la compaction du contexte et la récupération se déplacent vers un harnais managé. Ce guide montre ce qui doit être déplacé, ce qui doit rester dans votre application, et comment prouver la migration avant le basculement.
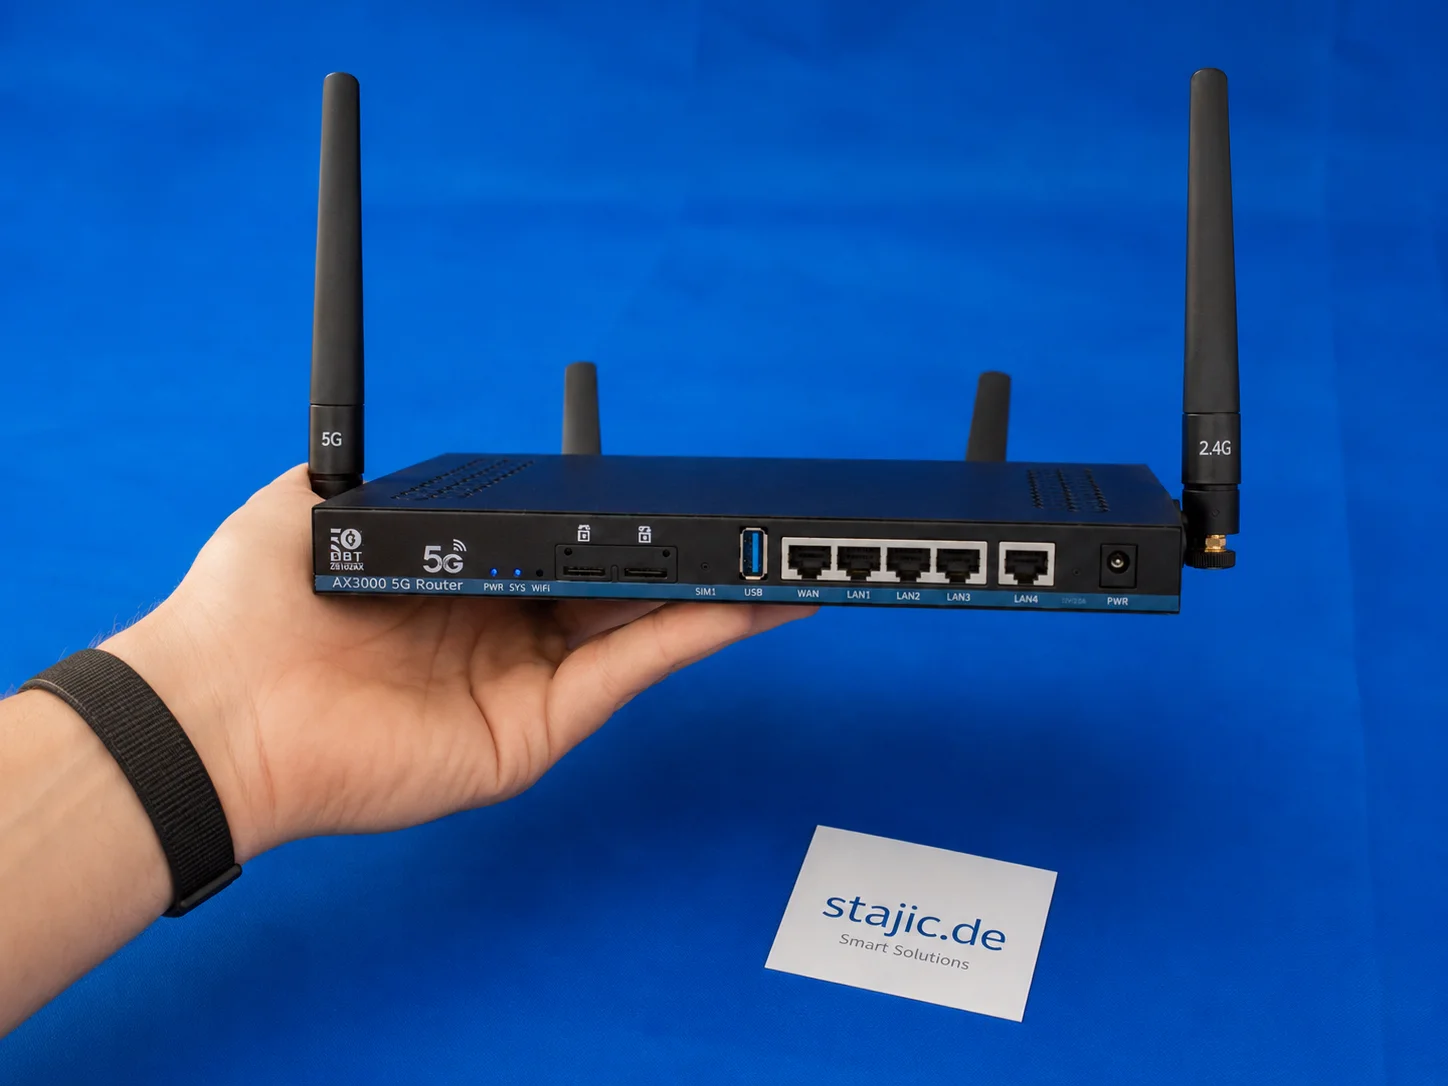
Faut-il acheter un routeur 5G OpenWrt avec un ancien firmware ? Le ZBT Z8102AX comme exemple concret
Acheter un routeur 5G OpenWrt avec un ancien firmware peut avoir du sens, mais uniquement dans les bonnes conditions. Le ZBT Z8102AX illustre clairement les deux aspects : le matériel est utile, le modem fonctionne et le routeur est resté stable lors des tests, mais OpenWrt 21.02, un emballage faible et des chemins de mise à niveau peu clairs nécessitent une décision d'achat réfléchie.