Enterprise Start Here: Your Gateway to Operational Excellence
Welcome to Enterprise: Start Here
If you're new to our enterprise platform or looking to optimize your operations, you've arrived at the right place. The Start Here hub serves as your comprehensive onboarding center, guiding you through proven frameworks, tools, and processes tailored for enterprise-scale deployments. Whether you're a C-suite executive, IT leader, or operations manager, this page outlines a clear path to leverage our resources effectively.
Why Start Here?
Enterprise environments demand reliability, scalability, and efficiency. Our platform addresses these needs with battle-tested components that reduce implementation time, minimize risks, and drive measurable outcomes. Starting here ensures you build on solid foundations rather than reinventing processes from scratch.
Success in enterprise operations begins with the right blueprint—not trial and error.— Enterprise Operations Principle
Your Structured Onboarding Path
Follow this sequential path to maximize value. Each step builds on the previous, integrating seamlessly across our ecosystem.
- Review Reference Models to understand industry-standard architectures and best practices.
- Dive into Playbooks for step-by-step strategies on common enterprise scenarios.
- Implement with Runbooks for precise, repeatable execution of critical procedures.
- Measure progress using Assessments to benchmark and refine your operations.
Step 1: Explore Reference Models
Reference models provide blueprints for enterprise architectures, covering areas like cloud migration, security postures, and DevOps pipelines. These models are derived from real-world deployments across Fortune 500 companies, ensuring applicability without customization overhead. Begin here to align your strategy with proven patterns.
Step 2: Master Playbooks
Playbooks translate high-level strategies into actionable guides. From incident response to scaling infrastructure, each playbook includes decision trees, checklists, and integration points with your existing tools. Use them to orchestrate complex initiatives with confidence.
Step 3: Execute with Runbooks
Runbooks are your tactical execution manuals. Designed for on-demand use, they detail exact commands, API calls, and troubleshooting flows. Ideal for 24/7 operations teams, runbooks ensure consistency and speed during high-pressure situations.
Step 4: Evaluate with Assessments
Assessments offer objective scoring frameworks to gauge maturity levels against benchmarks. Run self-assessments or guided audits to identify gaps, prioritize improvements, and track ROI over time.
Best Practices for Getting Started
- Assemble a cross-functional team including IT, security, and business stakeholders.
- Set clear KPIs aligned with your reference model selections.
- Pilot one playbook in a non-production environment before full rollout.
- Schedule quarterly assessments to maintain momentum.
- Leverage our community forums for peer insights and support.
Ready to Take the Next Step?
This hub is your launchpad. Bookmark it and refer back as you progress. For personalized guidance, contact our enterprise success team. Transform your operations today—start with Reference Models.
Related Articles
Pourquoi plus de contexte peut rendre les réponses de l'IA pires
Une fenêtre de contexte plus grande ne garantit pas une meilleure réponse. Cet article explique comment la dilution du signal, les preuves contradictoires, l'état obsolète, la sensibilité à la position et la compression avec perte peuvent réduire la fiabilité de l'IA — et présente un test pratique de pression de contexte.
Quand une IA devrait-elle cesser de faire confiance à ses propres connaissances ? — Le déclencheur de récupération
Un modèle d'IA n'a pas besoin de récupération pour chaque question. Le problème important est de savoir quand ses connaissances internes ne suffisent plus. Le Déclencheur de Récupération est une frontière de décision pratique qui détermine quand un système d'IA devrait cesser de se fier uniquement aux connaissances du modèle et obtenir des preuves externes avant de répondre.
ADR vs NFR : les décisions d'architecture et la qualité du système ne sont pas la même chose
ADR vs NFR expliqués : découvrez comment les exigences de qualité système orientent les décisions d'architecture, comment les ADR consignent les compromis et pourquoi la validation reste distincte.
Les preuves peuvent-elles survivre au pipeline d’IA ? — La chaîne de préservation des preuves
Une preuve peut être correcte à la source et devenir néanmoins peu fiable après l'analyse syntaxique, la normalisation, le découpage, la récupération et l'assemblage du contexte. La chaîne de préservation des preuves vérifie si l'identité, la provenance, la portée et le sens survivent à l'ensemble du pipeline d'IA.
La mémoire des agents IA n'est pas le RAG : comment séparer la mémoire, la récupération, l'état et le contexte
La mémoire des agents, le RAG, l'état et le contexte sont souvent utilisés comme s'ils étaient interchangeables. Ils ne le sont pas. Ce modèle d'architecture pratique sépare les quatre couches, montre où chacune se situe et explique ce qui dysfonctionne lorsque les systèmes les fusionnent en une seule.
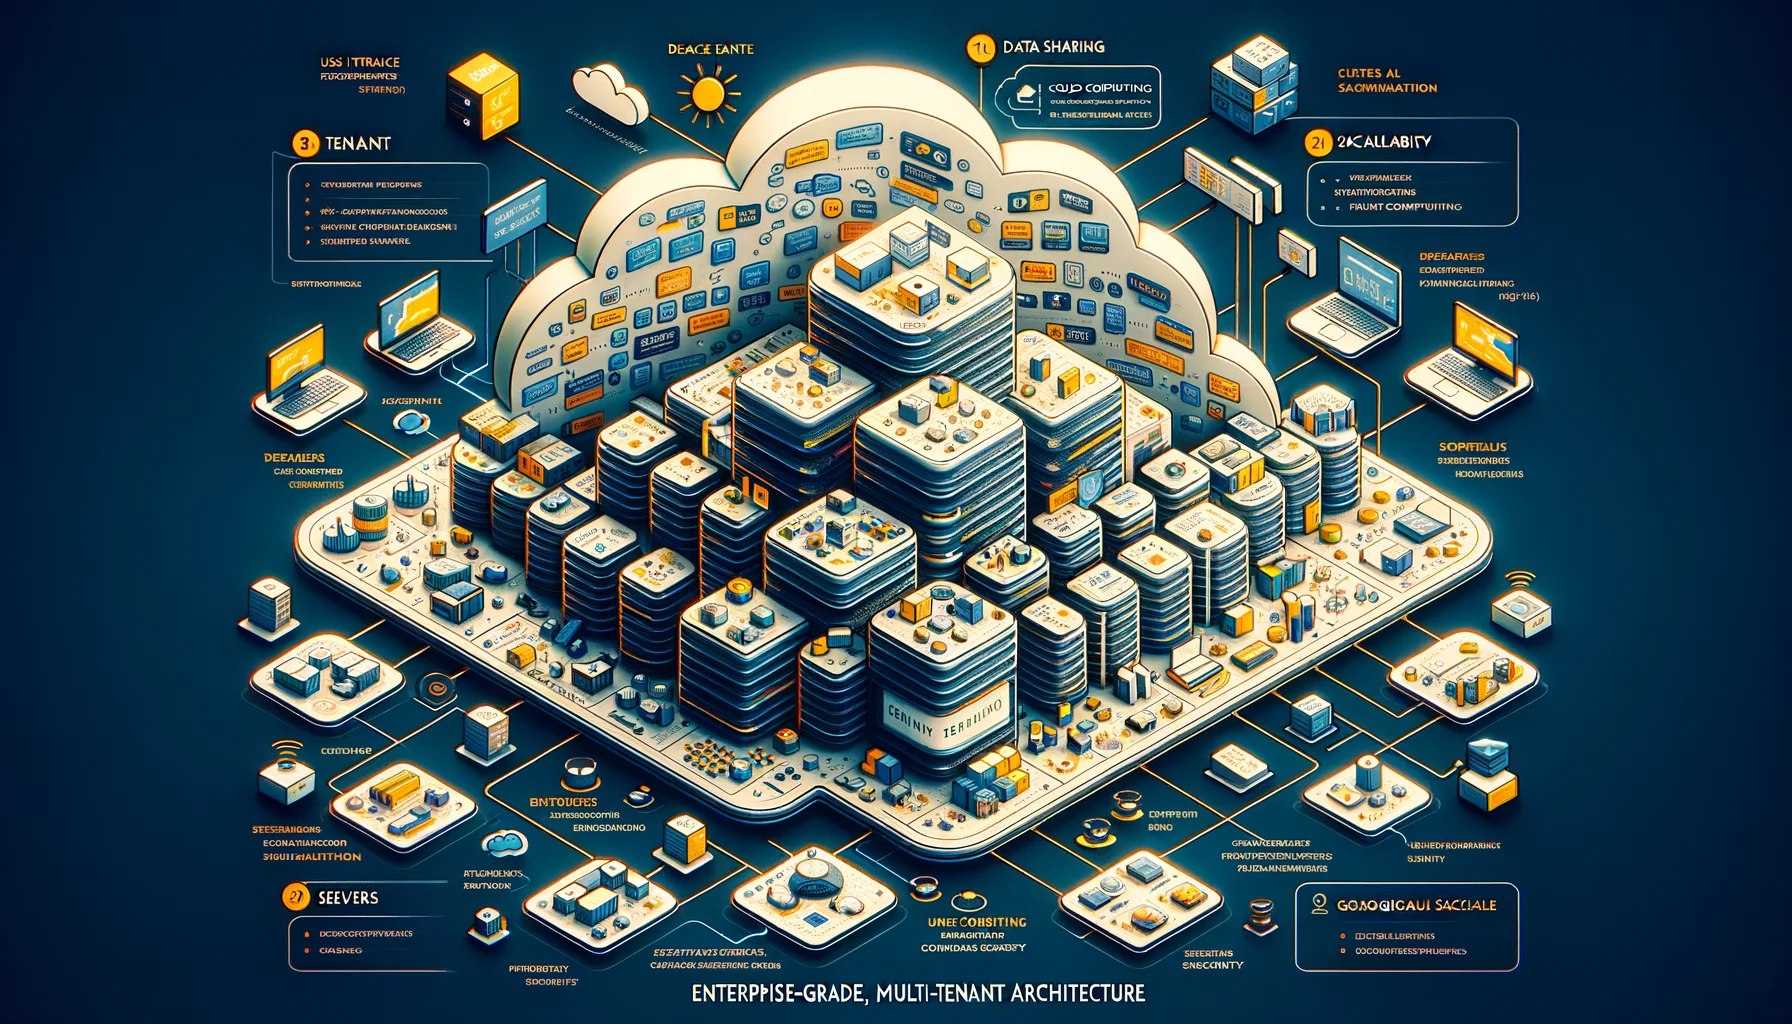
Enterprise-Grade Multi-Tenant Architecture for an International Platform
Loving Rocks is an enterprise-grade wedding platform designed with a true multi-tenant architecture, isolated databases per tenant, and built-in internationalization for global scalability, security, and long-term operational stability.
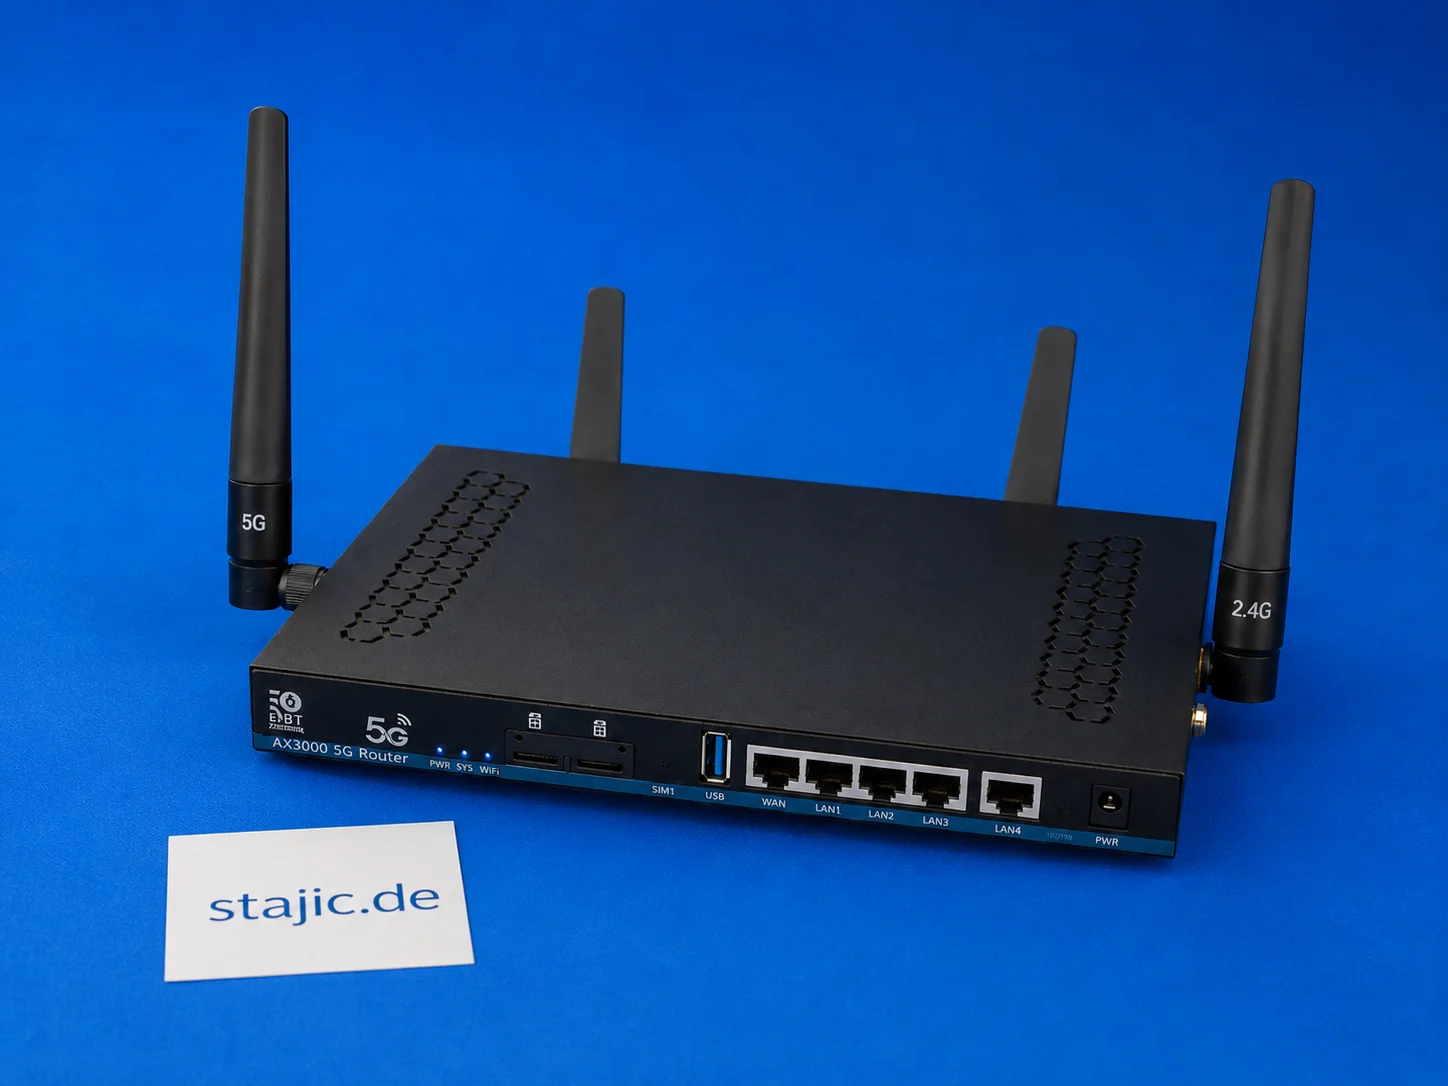
Basculement double SIM du ZBT Z8102AX : ce qui fonctionne, ce qui manque et ce qui nécessite un meilleur firmware
Le ZBT Z8102AX est un routeur OpenWrt 5G double SIM, mais le matériel double SIM à lui seul n'est pas la même chose qu'un basculement intelligent. Le routeur reconnaît la carte SIM et se connecte avec succès, mais la commutation automatique, la récupération du modem, les décisions basées sur le signal et une logique de basculement propre nécessitent encore des tests plus approfondis.
Qu'est-ce que le RAG ? L'explication la plus simple de son fonctionnement
Le RAG semble compliqué, mais l'idée est simple : avant qu'une IA ne réponde, elle recherche d'abord des informations utiles dans une source de connaissances et transmet ces informations au modèle de langage. Ce guide explique le RAG, les LLM, l'état, la mémoire et les outils à l'aide d'un modèle mental simple.
La frontière de validité des réponses : la couche manquante entre la pertinence et les réponses fiables de l'IA
Une source peut être pertinente, faisant autorité et pourtant être erronée pour la question posée. La couche manquante est l'applicabilité : les conditions dans lesquelles une réponse est valable, et les changements qui obligent à la reconsidérer. Cet article présente la Frontière de Validité de la Réponse comme un modèle de conception de source pour les humains, la recherche par IA et les systèmes RAG.
Une Architecture Monorepo Pratique avec Next.js, Fastify, Prisma, et NGINX
Explorez une architecture de monorepo pratique utilisant Next.js, Fastify, Prisma et NGINX, mettant en évidence l'intégration et le flux de travail concrets.
Tendances Linux émergentes en 2026 : façonner l'avenir de l'infrastructure serveur
Explorez les principales tendances Linux de 2026, de la domination de Kubernetes et des distributions immuables à l'intégration de l'IA et à la sécurité eBPF.
Pourquoi l'IA récupère-t-elle certaines sources et en ignore-t-elle d'autres ? — La couche d'autorité de récupération
Trouver un document pertinent ne suffit pas. Les systèmes d’IA doivent aussi distinguer les sources actuelles, faisant autorité, applicables et traçables des sources qui semblent simplement similaires. La couche d’autorité de récupération définit cette frontière de sélection des sources.