
Maîtriser le flux de travail SEO : Stratégies d'optimisation essentielles pour la croissance organique
Établir un flux de travail SEO professionnel
Aperçu : Le flux de travail SEO fondamental
Avantages d'une approche SEO structurée
- Amélioration de l'expérience utilisateur (UX) : L'optimisation des temps de chargement rapides et l'assurance de l'optimisation mobile améliorent directement la façon dont les visiteurs interagissent avec le site, réduisant les taux de rebond et augmentant l'engagement.
- Amélioration de la capacité d'exploration par les moteurs de recherche : Des éléments structurés comme la création de sitemaps et les balises méta optimisées facilitent la découverte, l'indexation et la compréhension de la hiérarchie du contenu du site par les robots des moteurs de recherche.
- Augmentation de l'autorité et de la confiance : La création stratégique de backlinks provenant de sites web fiables et pertinents pour l'industrie signale aux moteurs de recherche que le contenu est précieux et fait autorité, ce qui améliore le classement du domaine.
- Affinement basé sur les données : L'utilisation de la configuration d'analyse permet aux équipes de suivre le comportement des visiteurs, d'identifier les pages sous-performantes et d'apporter des ajustements précis et fondés sur les données à la stratégie d'optimisation.
- Visibilité accrue du contenu : L'intégration des médias sociaux facilite le partage de contenu, augmentant la portée et la visibilité du site web, ce qui peut influencer positivement la performance globale du SEO grâce à une exposition accrue.
Détails techniques et santé du site
Cas d'utilisation et application de la construction d'autorité
Conclusion : Implémenter le flux de travail SEO
Related Articles
La mémoire des agents IA n'est pas le RAG : comment séparer la mémoire, la récupération, l'état et le contexte
La mémoire des agents, le RAG, l'état et le contexte sont souvent utilisés comme s'ils étaient interchangeables. Ils ne le sont pas. Ce modèle d'architecture pratique sépare les quatre couches, montre où chacune se situe et explique ce qui dysfonctionne lorsque les systèmes les fusionnent en une seule.
Qu’est-ce que l’ingénierie du contexte ? Ce que le modèle reçoit avant de répondre
L'ingénierie de contexte conçoit les informations qu'un modèle d'IA reçoit avant l'inférence, y compris les invites, la récupération, la mémoire, l'état de l'application, les résultats d'outils et l'historique des conversations.
RBAC vs isolation des locataires : deux frontières de sécurité différentes
Le RBAC contrôle ce qu’un utilisateur peut faire ; l’isolation des locataires contrôle à quelles ressources de locataire cette action peut accéder. Découvrez pourquoi la sécurité SaaS multi-locataires nécessite ces deux frontières.
MLOps vs LLMOps : qu'est-ce qui change lorsque le modèle est un LLM
MLOps exploite les systèmes d'apprentissage automatique ; LLMOps étend ces pratiques aux prompts, au contexte, à la récupération, aux fournisseurs, aux outils, aux évaluations et au comportement d'exécution autour des grands modèles de langage.
D'où un LLM tire-t-il ses données ? Sources de données RAG en Python
Un LLM ne connaît pas magiquement vos fichiers, bases de données ou API. Cette suite pratique de la série sur le RAG montre, avec du Python simple, comment des données externes deviennent des preuves récupérables : des fichiers texte et du SQL à la recherche en texte intégral, aux embeddings, à l'assemblage du contexte et à l'appel final au LLM.
La frontière de validité des réponses : la couche manquante entre la pertinence et les réponses fiables de l'IA
Une source peut être pertinente, faisant autorité et pourtant être erronée pour la question posée. La couche manquante est l'applicabilité : les conditions dans lesquelles une réponse est valable, et les changements qui obligent à la reconsidérer. Cet article présente la Frontière de Validité de la Réponse comme un modèle de conception de source pour les humains, la recherche par IA et les systèmes RAG.
Agents d'utilisation de l'ordinateur : pourquoi une démonstration réussie peut tout de même être un système peu fiable
Les agents d'utilisation de l'ordinateur peuvent désormais accomplir d'impressionnants flux de travail sur navigateur et sur bureau, mais une seule exécution réussie prouve la capacité—non la fiabilité. Cet article montre comment tester la répétabilité, la robustesse environnementale, le contrôle à long horizon, la conscience de l'état, la vérification des résultats et la gestion sécurisée des objectifs.
Échec du RAG — mais quelle couche a réellement échoué ? Une méthode de diagnostic
Lorsqu'une réponse RAG est erronée, blâmer la récupération ou le modèle est trop vague. Cette méthode de diagnostic isole la couverture des sources, la construction de la requête, la récupération, le classement, l'assemblage du contexte, la génération, l'attribution des preuves et la fraîcheur—afin que la défaillance réelle puisse être reproduite et corrigée.
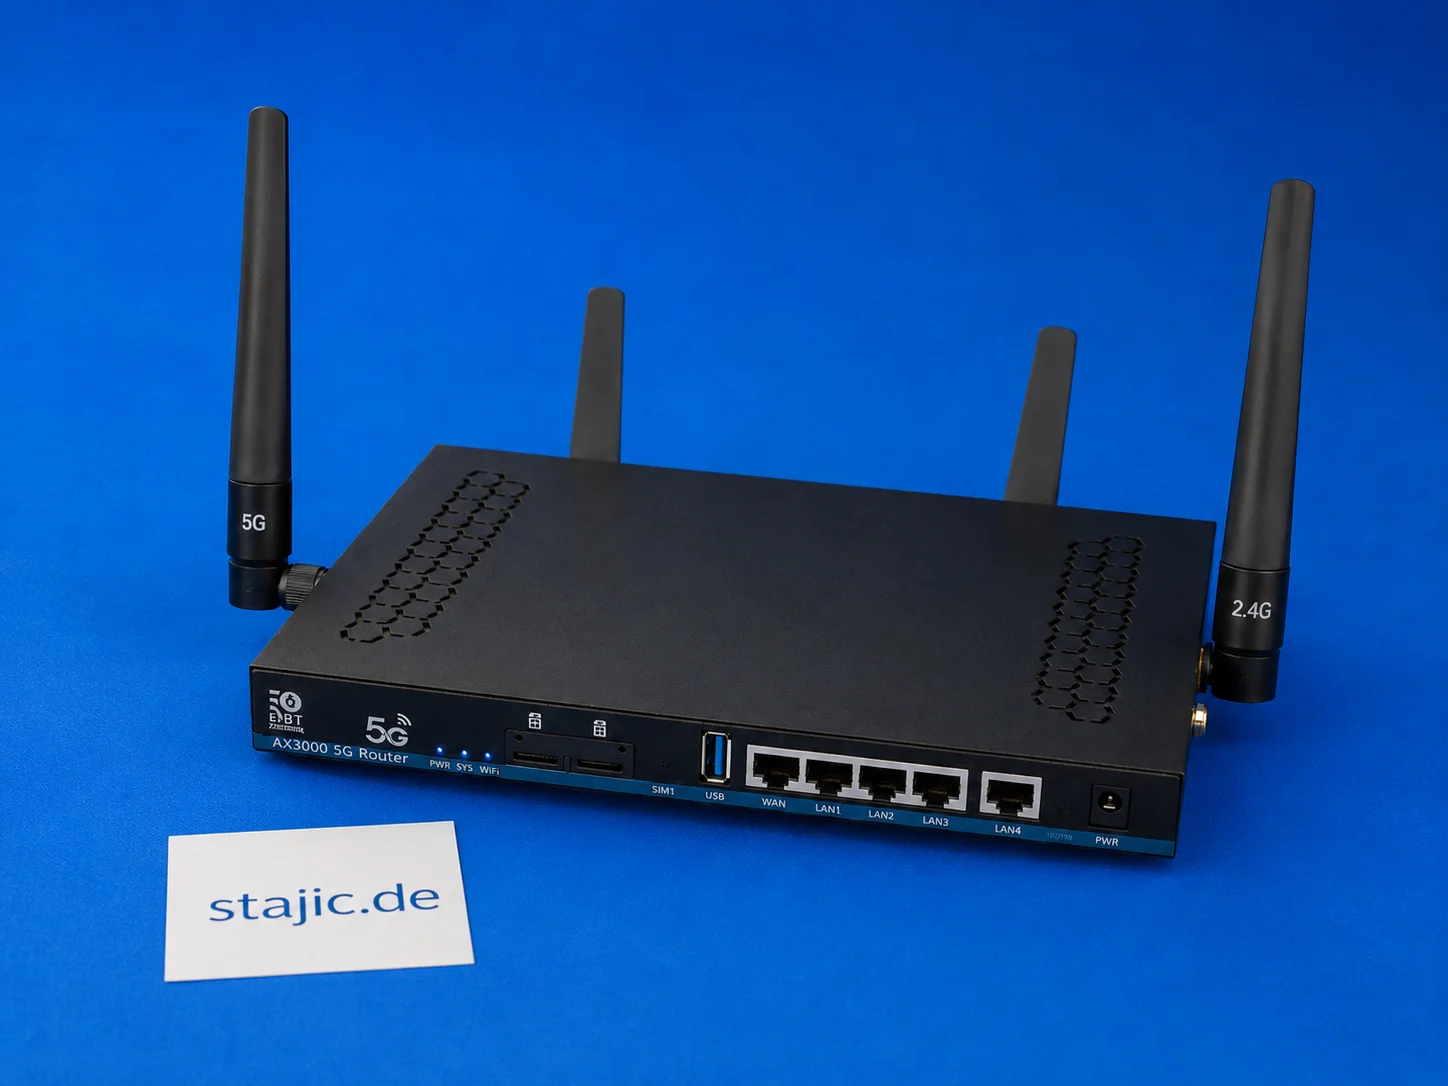
Basculement double SIM du ZBT Z8102AX : ce qui fonctionne, ce qui manque et ce qui nécessite un meilleur firmware
Le ZBT Z8102AX est un routeur OpenWrt 5G double SIM, mais le matériel double SIM à lui seul n'est pas la même chose qu'un basculement intelligent. Le routeur reconnaît la carte SIM et se connecte avec succès, mais la commutation automatique, la récupération du modem, les décisions basées sur le signal et une logique de basculement propre nécessitent encore des tests plus approfondis.
Qu'est-ce que le RAG ? L'explication la plus simple de son fonctionnement
Le RAG semble compliqué, mais l'idée est simple : avant qu'une IA ne réponde, elle recherche d'abord des informations utiles dans une source de connaissances et transmet ces informations au modèle de langage. Ce guide explique le RAG, les LLM, l'état, la mémoire et les outils à l'aide d'un modèle mental simple.
ADR vs NFR : les décisions d'architecture et la qualité du système ne sont pas la même chose
ADR vs NFR expliqués : découvrez comment les exigences de qualité système orientent les décisions d'architecture, comment les ADR consignent les compromis et pourquoi la validation reste distincte.
Harnais d'agent géré vs boucle d'agent auto-hébergée : ce que vous gagnez, ce que vous perdez
“Agent auto-hébergé” peut désigner des architectures très différentes. Ce guide distingue le harnais géré, l'environnement d'exécution auto-hébergé et la boucle d'agent entièrement auto-opérée—et montre de quelle frontière de contrôle les équipes ont réellement besoin.