
Harnais d'agent géré vs boucle d'agent auto-hébergée : ce que vous gagnez, ce que vous perdez
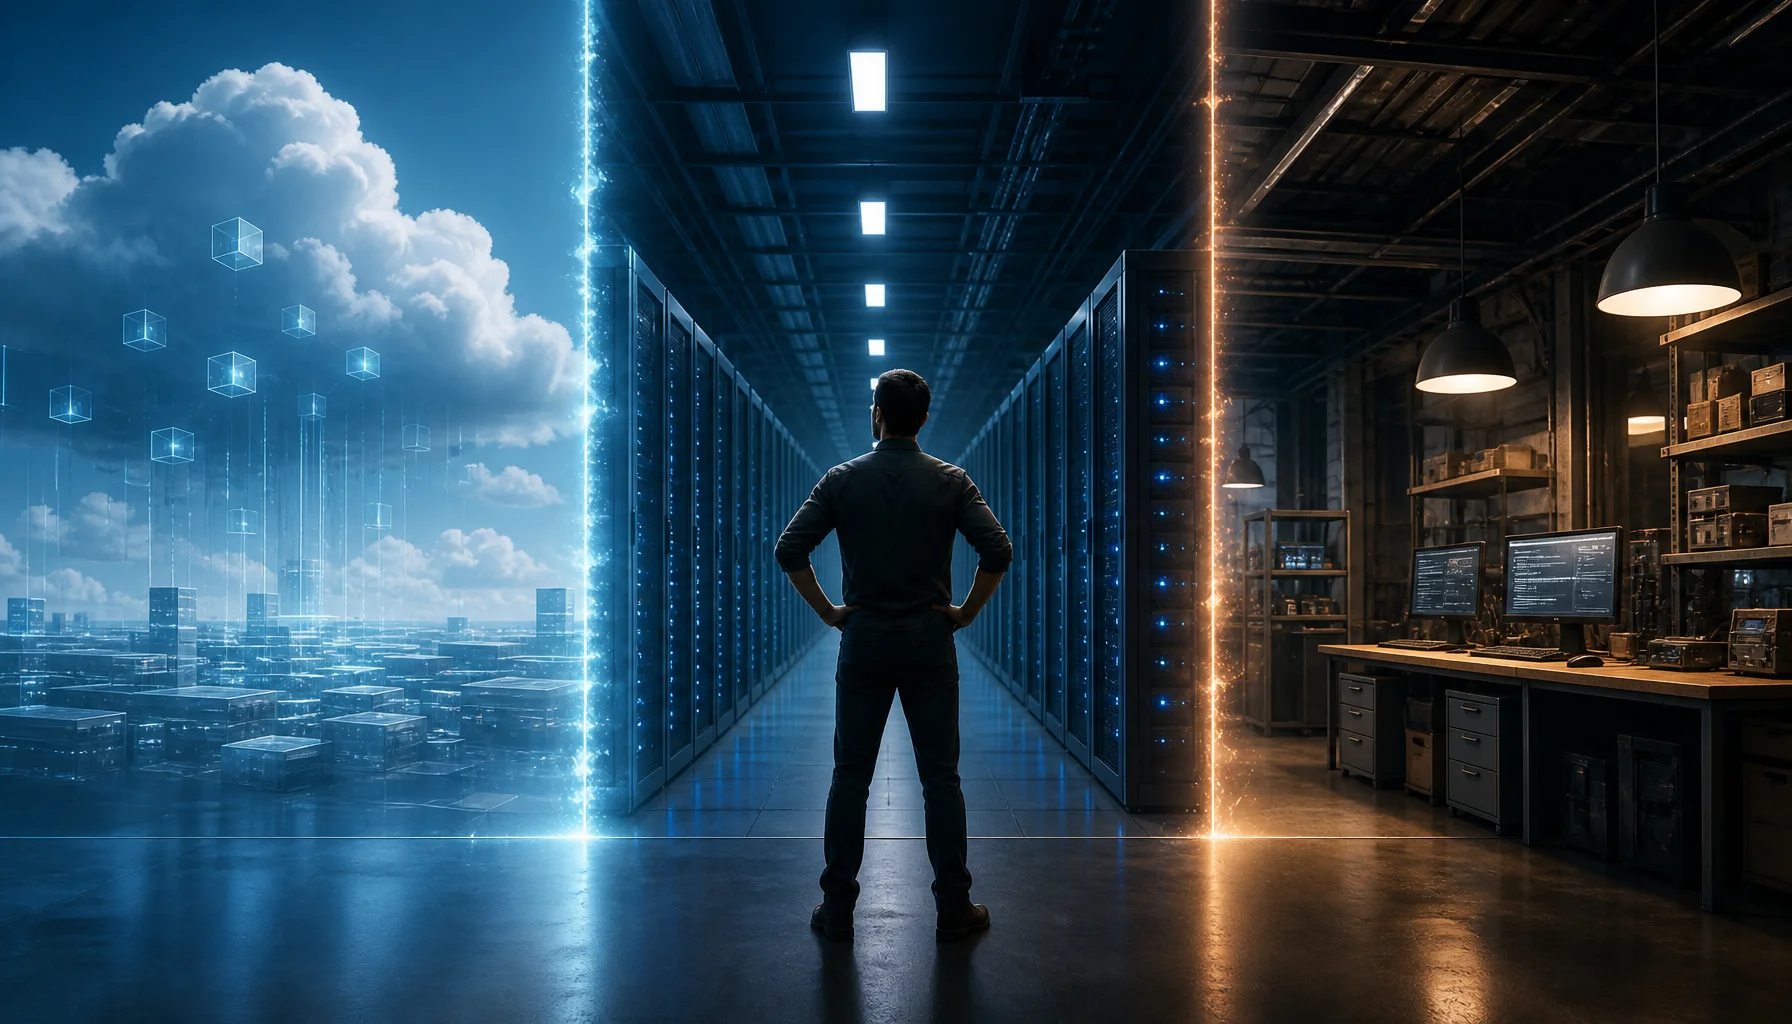
L'expression « agent auto-hébergé » recouvre aujourd'hui au moins trois architectures différentes. Vous pouvez utiliser un harness géré avec une infrastructure de calcul hébergée par OpenAI, un harness géré connecté à une infrastructure que vous exploitez, ou exécuter vous-même le harness et la boucle de l'agent. Ces choix ont des implications très différentes en matière de contrôle, de reprise sur incident, de gestion du contexte, de sécurité, de latence et de charge opérationnelle.
L'erreur : considérer l'auto-hébergement comme une décision unique
Dans le logiciel traditionnel, « auto-hébergé » signifie généralement que l'application s'exécute sur une infrastructure que vous contrôlez. Les systèmes d'agents compliquent cette définition car l'environnement d'exécution peut être scindé. La boucle modèles-outils peut s'exécuter à un endroit, tandis que l'exécution de code, les fichiers et l'accès au réseau privé ont lieu ailleurs.
L'architecture actuelle de l'API Agents d'OpenAI rend cette séparation explicite : OpenAI exécute le harness, tandis que l'environnement d'exécution peut être absent, hébergé par OpenAI ou auto-hébergé. Un environnement auto-hébergé ne signifie donc pas que la boucle de l'agent est auto-hébergée.
Cette distinction est importante car de nombreuses équipes choisissent un environnement d'exécution plus complexe que nécessaire. Souhaitant un accès au réseau privé ou des paquets personnalisés, elles en concluent que l'agent entier doit être auto-hébergé, et prennent involontairement la responsabilité de la gestion du contexte, de l'orchestration, de la reprise sur incident et du cycle de vie, qui auraient pu rester gérés.
Trois architectures souvent qualifiées d'« auto-hébergées »
| Architecture | Qui exécute le harness ? | Où le code et les fichiers s'exécutent | Ce dont vous avez principalement la charge |
|---|---|---|---|
| Harness géré + environnement géré | Plateforme | Bac à sable hébergé par la plateforme | Application, outils, logique produit, autorisation |
| Harness géré + environnement auto-hébergé | Plateforme | Votre conteneur, machine virtuelle, ordinateur portable, cloud privé ou autre infrastructure de calcul | Provisionnement de l'environnement, réseau, fichiers et cycle de vie ; la plateforme conserve la responsabilité du harness |
| Harness / boucle d'agent géré(e) par vos soins | Vous | L'environnement de votre choix | Processus du harness, orchestration, stratégie de contexte, hébergement, reprise sur incident, exécution et cycle de vie de l'application |
Le modèle à deux plans
Séparer le plan du harness du plan d'exécution
| Plan | Ce qu'il prend en charge | Questions à se poser | |
|---|---|---|---|
| Plan du harness | |||
| Plan d'exécution | |||
| Plan applicatif |
Harness géré : ce que vous y gagnez réellement
Un harness géré ne se contente pas de supprimer une boucle while. L'actuelle API Agents d'OpenAI gère les sessions, l'orchestration, le compactage du contexte et la reprise sur incident. Les travaux d'Anthropic sur les agents gérés décrivent la même motivation générale : les harness intègrent des hypothèses sur le comportement des modèles, et ces hypothèses doivent évoluer à mesure que les modèles s'améliorent.
Le gain ne se résume donc pas à quelques lignes de code en moins. La plateforme peut faire évoluer le comportement à l'exécution, le traitement des contextes à long terme, la coordination des sous-agents et la reprise sur incident, sans obliger chaque équipe applicative à réimplémenter ces mécanismes.
- Moins de code d'orchestration à la charge de l'application.
- Gestion assurée des sessions durables.
- Gestion assurée du compactage du contexte et de la reprise sur incident.
- Un environnement d'exécution capable d'évoluer avec les capacités des modèles.
- Adoption simplifiée des fonctionnalités natives de sous-agents et d'agents à longue durée de vie de la plateforme.
- Charge opérationnelle potentiellement réduite pour les équipes dont la valeur ajoutée ne réside pas dans le harness lui-même.
Harness géré : ce à quoi vous renoncez
Déléguer le harness revient également à déléguer une partie du contrôle. Votre application ne maîtrise plus chaque détail de l'itération, de la stratégie de contexte, de l'orchestration et de l'évolution du runtime. Une mise à jour de la plateforme peut améliorer le système, mais elle peut aussi modifier un comportement dont dépendait implicitement votre produit.
Cela crée une exigence d'ingénierie d'une autre nature : des évaluations rigoureuses, des délimitations de produit explicites et une couche d'intégration qui empêche le comportement de la session gérée de devenir votre source de vérité métier.
| Compromis du harness géré | Ce que cela implique sur le plan opérationnel |
|---|---|
| Moins de contrôle sur la boucle | Vous ne pouvez pas supposer que chaque détail d'orchestration est défini par l'application |
| Évolution de la plateforme | Le comportement du harness peut s'améliorer ou changer sans modification de votre code |
| Cycle de vie propre au fournisseur | Les sessions, les événements et la sémantique de récupération intègrent le périmètre d'intégration |
| Périmètre d'observabilité | Les traces de la plateforme doivent être consolidées avec les données d'audit de l'application |
| Coût de portabilité | Migrer vers un autre harness ultérieurement peut exiger bien plus que de simples modifications de points de terminaison de modèle |
Environnement d'exécution auto-hébergé : l'architecture intermédiaire
Le modèle d'environnement auto-hébergé d'OpenAI est important, car il découple le calcul privé de la propriété du harness. La plateforme exécute toujours le harness Codex, tandis qu'un exécuteur fonctionne au sein de votre environnement et reçoit les commandes via une connexion sortante.
Vous contrôlez le provisionnement, les fichiers, les dépendances, l'accès réseau et le nettoyage. Le harness peut ainsi interagir avec une infrastructure privée ou des logiciels personnalisés sans nécessiter le transfert de l'intégralité du runtime d'agent dans votre application.
La contrepartie réside dans la responsabilité du cycle de vie. Votre application doit mapper les sessions aux ressources de calcul, éviter les provisionnements en double, reconnecter les environnements, coordonner l'arrêt et conserver les fichiers qui doivent subsister après la fermeture de l'environnement.
Quand l'exécution auto-hébergée est suffisante
- L'agent a besoin d'accéder à un VPC privé ou à un service interne.
- L'agent a besoin de binaires, de paquets, de pilotes ou de logiciels système personnalisés.
- La charge de travail doit s'exécuter sur du matériel ou des comptes cloud que vous contrôlez.
- Les fichiers doivent rester à l'intérieur d'un environnement maîtrisé.
- Vous avez besoin de votre propre fournisseur de bac à sable ou modèle d'isolation.
- Vous souhaitez une orchestration gérée par la plateforme, mais une exécution contrôlée par votre infrastructure.
Quand vous pourriez également avoir besoin de gérer le harness
Gérer soi-même le harness devient justifié lorsque celui-ci fait partie intégrante de la différenciation de votre produit ou de vos contraintes techniques. La présentation actuelle du runtime d'OpenAI positionne le SDK Codex pour faire tourner le harness Codex sur l'infrastructure que vous opérez, tandis que Responses constitue l'option de niveau inférieur lorsque vous souhaitez prendre en charge vous-même la boucle de l'agent.
L'enjeu consiste à identifier un besoin qui relève véritablement du plan de harness, et non du plan d'exécution.
| Exigence | Problème lié au plan d'exécution ou au plan de harness ? | Orientation probable |
|---|---|---|
| Accès à une base de données privée | Plan d'exécution | Harness géré + environnement auto-hébergé peuvent suffire |
| Paquets Linux personnalisés | Plan d'exécution | Harness géré + environnement auto-hébergé |
| Matériel GPU sur mesure | Plan d'exécution | Harness géré + environnement auto-hébergé là où c'est pris en charge |
| Logique personnalisée d'arrêt de l'agent | Plan de harness | Harness auto-opéré / boucle sur mesure |
| Routage de modèles multi-fournisseurs à chaque étape | Plan de harness | Boucle sur mesure ou harness que vous opérez |
| Algorithme personnalisé de compactage de contexte | Plan de harness | Harness auto-opéré si le runtime géré ne permet pas de l'exposer |
| Sémantique d'orchestration déterministe exigée par le produit | Plan de harness | Harness auto-opéré ou boucle sur mesure strictement contrôlée |
| Déploiement produit exclusivement local sans dépendance à un harness géré | Plan de harness + plan d'exécution | Runtime auto-opéré |
Le test d'escalade du contrôle
Adoptez l'architecture la moins auto-hébergée possible qui réponde à l'exigence réelle. Augmentez le niveau de contrôle couche par couche.
Test d'escalade du contrôle
La charge opérationnelle croît de manière non linéaire lorsque vous gérez le harness
Une boucle auto-opérée semble simple dans une démo : appeler le modèle, inspecter l'appel d'outil, exécuter l'outil, ajouter le résultat, répéter. La production y ajoute l'état durable, les nouvelles tentatives, les événements en double, l'annulation, l'approbation, le dépassement de contexte, les expirations d'outils, les redémarrages de processus, la persistance des traces, la contre-pression, le travail simultané et la récupération après des effets secondaires partiels.
La recherche d'Anthropic sur les agents à exécution longue montre à plusieurs reprises que la conception du harness influe concrètement sur les performances. Leurs travaux sur le développement d'applications à exécution longue utilisent une planification explicite, des artefacts structurés et des agents évaluateurs, car les boucles naïves ont tendance à perdre leur progression ou à s'interrompre prématurément. Le harness relève donc de la logique de production, et non d'une simple plomberie technique.
| Si vous gérez le harness, vous devez également répondre à | Pourquoi c'est important |
|---|---|
| État de session durable | Les processus redémarrent ; le travail à exécution longue doit reprendre correctement |
| Compactage du contexte | L'historique finit par dépasser le contexte de travail pratique |
| Idempotence des outils | Les nouvelles tentatives ne doivent pas répéter des effets secondaires irréversibles |
| Annulation et interruption | Les utilisateurs et les systèmes doivent pouvoir arrêter ou rediriger le travail |
| Récupération après exécution partielle | Un outil peut réussir même si l'agent ne reçoit jamais le résultat |
| Concurrence | Plusieurs tâches, workers ou agents peuvent accéder à un état partagé |
| Observabilité | Le résultat final est insuffisant pour déboguer les défaillances à l'exécution |
| Gestion des versions | Les mises à jour du harness peuvent modifier le comportement même lorsque les prompts restent constants |
| Évaluation | Les modifications à l'exécution nécessitent des tests de régression sur des trajectoires représentatives |
Frontière de sécurité : auto-héberger le calcul ne rend pas automatiquement l'agent privé
Un environnement d'exécution auto-hébergé contrôle l'endroit où les commandes s'exécutent et où résident les fichiers, mais le harness géré et l'interaction avec le modèle franchissent toujours la frontière du service. Les équipes doivent donc cartographier explicitement les flux de données plutôt que d'utiliser « auto-hébergé » comme un raccourci pour une propriété de confidentialité.
L'exécuteur auto-hébergé d'OpenAI utilise des identifiants d'environnement restreints et des connexions sortantes. Il s'agit d'une isolation utile, mais votre application a toujours besoin de ses propres règles pour les secrets, l'exposition au réseau privé, l'isolation utilisateur-environnement, la rétention des fichiers, l'autorisation des outils et la classification des données.
Latence et coût : le contrôle peut déplacer les goulots d'étranglement plutôt que de les éliminer
L'auto-hébergement peut réduire certains coûts liés au chemin des données ou au démarrage de l'environnement, mais il peut également ajouter du temps de provisionnement, la gestion du cycle de vie WebSocket, des démarrages à froid, le nettoyage des bacs à sable, de l'infrastructure d'observabilité et une charge d'ingénierie. Un environnement géré peut coûter plus cher par unité de calcul tout en étant plus économique à exploiter à un volume faible ou irrégulier.
La véritable comparaison repose sur le coût total du système : utilisation du modèle et des outils, temps d'environnement, infrastructure, effort d'ingénierie, astreintes, reprise après incident et coût d'une itération plus lente.
Une matrice de décision pour la production
| Contrainte | Harness géré + environnement géré | Harness géré + environnement auto-hébergé | Harness / boucle auto-opéré(e) |
|---|---|---|---|
| Chemin le plus rapide vers la production | Fort | Modéré | Le plus faible |
| Exécution sur réseau privé | Faible / dépend de la conception de la connectivité | Fort | Fort |
| Paquets personnalisés / logiciels système | Modéré | Fort | Fort |
| Contrôle au niveau du harness | Faible | Faible | Le plus élevé |
| Charge opérationnelle | La plus faible | Moyenne | La plus élevée |
| Portabilité | La plus faible | Moyenne | Potentiellement la plus élevée si conçue intentionnellement |
| Contrôle de la stratégie de contexte | Géré par la plateforme | Géré par la plateforme | Contrôlé par l'application |
| Contrôle de l'infrastructure d'exécution | Faible | Élevé | Élevé |
| Capacité à bénéficier des mises à jour du harness géré | La plus élevée | La plus élevée | Vous assumez l'adoption |
| Adéquation idéale | Équipes se différenciant au niveau du produit ou des outils | Équipes nécessitant du calcul privé/personnalisé sans gérer l'orchestration | Équipes dont la sémantique d'exécution constitue en elle-même une exigence |
L'hybride n'est pas un compromis — c'est souvent l'architecture la plus propre
Un harness géré avec une exécution auto-hébergée n'est pas « à moitié auto-hébergé ». C'est une séparation délibérée des responsabilités. La plateforme prend en charge la complexité du runtime d'agent à long horizon, tandis que votre infrastructure prend en charge l'exécution, la connectivité privée et les fichiers.
Cette frontière ressemble à d'autres architectures cloud : plan de contrôle géré, plan de données ou d'exécution contrôlé par le client. Le travail de conception essentiel consiste à définir le contrat entre eux — identité de session, identité d'environnement, identifiants, fichiers, permissions des outils, événements de cycle de vie et nettoyage.
Qu'est-ce qui changerait cette réponse ?
La recommandation changerait si les harness gérés offraient un contrôle d'exécution nettement plus étendu, si les harness auto-hébergés bénéficiaient de primitives de session durable et de reprise plus simples, ou si la réglementation imposait que l'intégralité de la boucle de l'agent et de l'interaction avec le modèle demeure au sein d'une infrastructure que vous exploitez.
Cela évolue également avec les capacités des modèles. Anthropic souligne explicitement que les hypothèses relatives au harness peuvent devenir obsolètes à mesure que les modèles s'améliorent. Un mécanisme de contrôle indispensable aujourd'hui peut s'avérer superflu plus tard, tandis qu'une nouvelle capacité de modèle peut engendrer une nouvelle exigence de gouvernance.
Limites
Cet article distingue les responsabilités architecturales ; il ne prétend pas qu'un modèle d'hébergement soit universellement plus sécurisé, plus économique ou plus fiable. Ces résultats dépendent de l'implémentation, de la charge de travail, des exigences de conformité, des compétences de l'équipe et du comportement du fournisseur.
L'API OpenAI Agents est encore en version bêta publique, et les produits d'agents gérés proposés par différents fournisseurs présentent des frontières variées. Le modèle à deux plans vise à faciliter la comparaison de ces architectures sans supposer que chaque fournisseur emploie les mêmes termes.
Conclusion
La question pertinente n'est pas : « Devrions-nous auto-héberger l'agent ? » C'est plutôt : quel plan devons-nous réellement contrôler ?
Si l'exigence porte sur du calcul privé, des packages personnalisés, des fichiers locaux ou l'accès à un réseau interne, auto-hébergez le plan d'exécution et conservez le harness géré. Si l'exigence concerne la sémantique d'orchestration, la stratégie de contexte, le contrôle du fournisseur ou le cycle de vie du runtime lui-même, alors la prise en charge du harness peut être justifiée. N'augmentez le niveau de contrôle que dans la mesure requise par vos besoins.
FAQ
Harness gérés et runtimes d'agents auto-hébergés
Un environnement auto-hébergé avec l'API OpenAI Agents constitue-t-il un agent auto-hébergé ?
Quand un environnement auto-hébergé est-il suffisant ?
Quand devrais-je exécuter le harness moi-même ?
L'auto-hébergement améliore-t-il automatiquement la sécurité ?
Quel est le principal coût opérationnel lié à la prise en charge de la boucle de l'agent ?
Glossaire
Termes clés d'architecture
- Plan du harness
- La couche du runtime d'agent responsable de l'exécution de la boucle, de l'orchestration, de la gestion du contexte, de la continuité des sessions et de la reprise après incident.
- Plan d'exécution
- L'environnement dans lequel les commandes sont exécutées, le code est lancé et les fichiers, packages et ressources locales sont consultés.
- Harness géré
- Un harness d'agent dont le runtime, la gestion des sessions et l'orchestration sont opérés par un fournisseur de plateforme.
- Environnement auto-hébergé
- Ressources de calcul et fichiers administrés par le propriétaire de l'application, tandis qu'un harness d'agent distinct peut demeurer géré ailleurs.
- Harness auto-opéré
- Un runtime d'agent dont la boucle, l'hébergement, la stratégie de contexte et le cycle de vie sont gérés par l'équipe en charge de l'application.
- Test d'escalade du contrôle
- Une méthode décisionnelle consistant à n'accroître la responsabilité sur l'infrastructure et le runtime que lorsqu'une exigence ne peut pas être satisfaite à une couche de contrôle inférieure.
Sources primaires et lectures complémentaires
OpenAI — Architecture de l'API AgentsSéparation actuelle entre le harness hébergé, l'environnement d'exécution et le serveur applicatif.
OpenAI — Sandboxes auto-hébergéesComment les environnements d'exécution gérés par le client se connectent au harness géré et quelles responsabilités liées au cycle de vie incombent à l'application.
OpenAI — Cycle de vie des sandboxesProvisionnement, reconnexion, prévention des doublons d'environnements et responsabilités de nettoyage pour le calcul auto-hébergé.
OpenAI — Options d'environnements d'exécution pour agentsComparaison actuelle entre l'API Agents, le SDK Codex et l'API Responses selon les responsabilités gérées versus opérées par l'application.
OpenAI — Codex en tant que plateformeHarness open source Codex et couches d'intégration pour les applications nécessitant un contrôle plus poussé du runtime.
Anthropic — Scaling Managed Agents: Decoupling the brain from the handsAnalyse de l'architecture des agents gérés et des raisons pour lesquelles les hypothèses de conception du harness doivent évoluer avec les capacités des modèles.
Anthropic — Des harnais efficaces pour les agents à longue durée d'exécutionEnseignements d'ingénierie montrant que les performances des agents à longue durée d'exécution dépendent considérablement de la conception du harnais et des artefacts persistants.
Related Articles

Maîtriser le flux de travail SEO : Stratégies d'optimisation essentielles pour la croissance organique
Un flux de travail SEO structuré est crucial pour une croissance organique durable. Découvrez les dix stratégies fondamentales, de la recherche de mots-clés et l'optimisation technique à la qualité du contenu et l'analyse des performances.
Guide complet d'Evaluation Harness : Maîtriser l'évaluation des performances des LLM
Ce guide propose une présentation détaillée d'Evaluation Harness, un framework essentiel pour évaluer rigoureusement les capacités des grands modèles de langage (LLM) dans les pipelines LLMOps d'entreprise. Découvrez la configuration, les meilleures pratiques et les techniques avancées pour garantir un benchmarking et une optimisation fiables des modèles.
Optimisation pour les moteurs de recherche : Le flux de travail fiable pour les meilleurs classements
Analyse détaillée de l'optimisation pour les moteurs de recherche (SEO), de ses fondements techniques, du rôle des robots d'indexation et des étapes stratégiques pour atteindre les meilleurs classements organiques.

Ollama n'est pas le produit : construire des applications Open-LLM prêtes pour la production
Exécuter un modèle local avec Ollama est facile. Construire une application Open-LLM prête pour la production est plus difficile : cela nécessite du RAG, du contrôle d'accès, de l'abstraction de fournisseur, de l'évaluation, de la journalisation, de la discipline de déploiement et une couche applicative contrôlée autour du modèle.
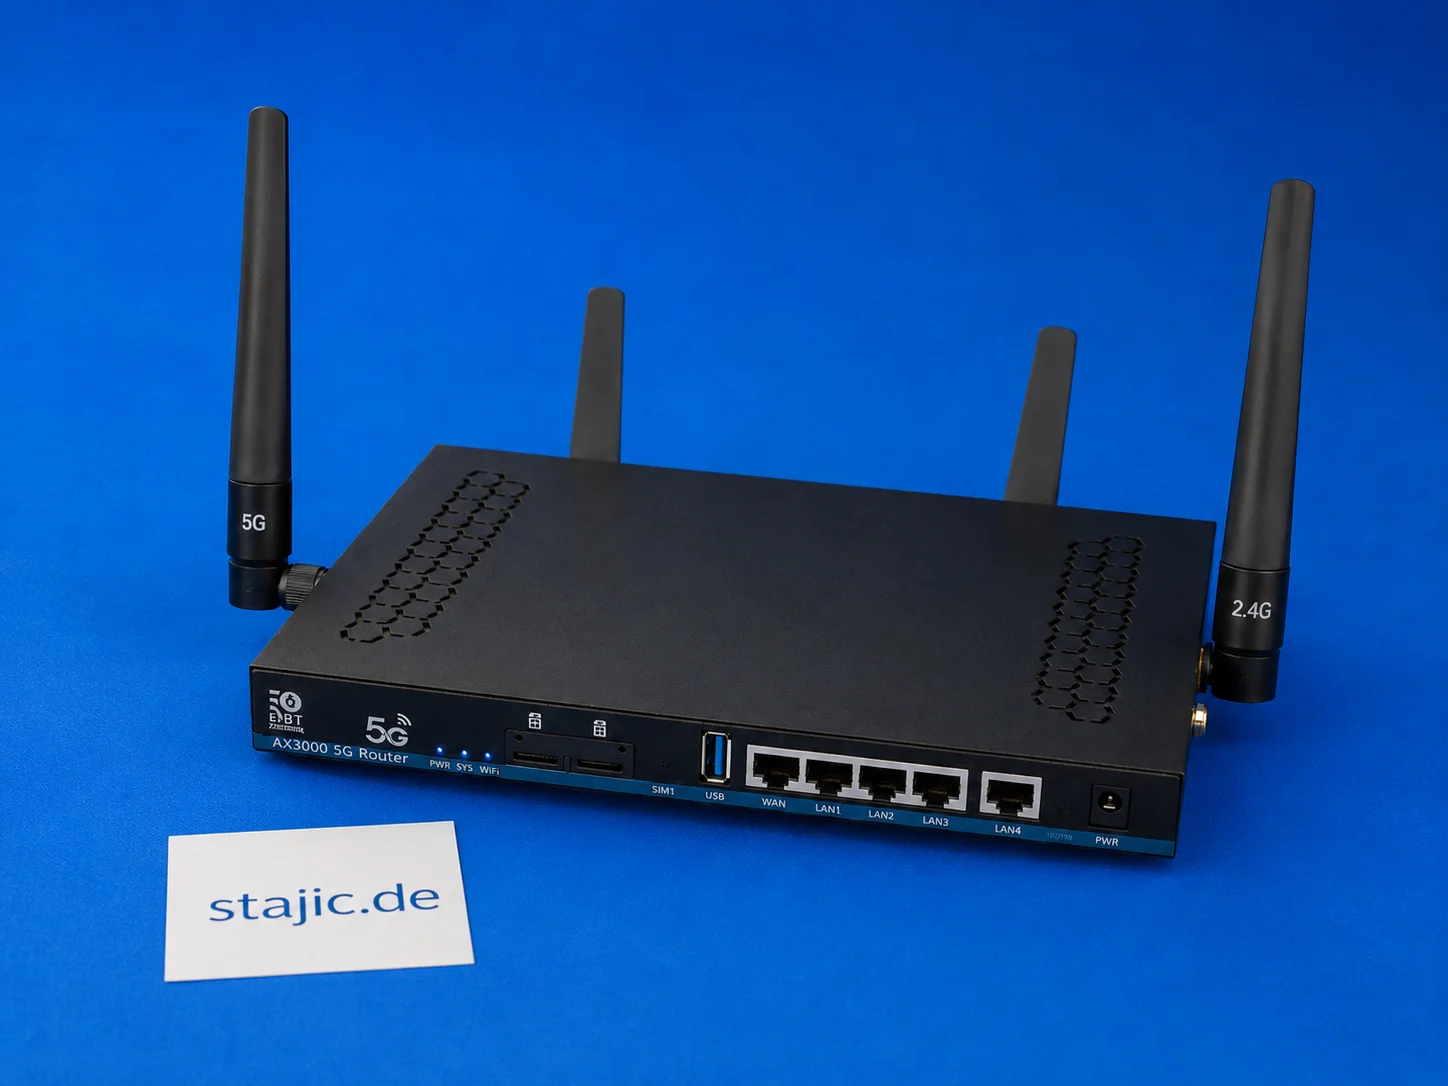
Basculement double SIM du ZBT Z8102AX : ce qui fonctionne, ce qui manque et ce qui nécessite un meilleur firmware
Le ZBT Z8102AX est un routeur OpenWrt 5G double SIM, mais le matériel double SIM à lui seul n'est pas la même chose qu'un basculement intelligent. Le routeur reconnaît la carte SIM et se connecte avec succès, mais la commutation automatique, la récupération du modem, les décisions basées sur le signal et une logique de basculement propre nécessitent encore des tests plus approfondis.

Échec du RAG — mais quelle couche a réellement échoué ? Une méthode de diagnostic
Lorsqu'une réponse RAG est erronée, blâmer la récupération ou le modèle est trop vague. Cette méthode de diagnostic isole la couverture des sources, la construction de la requête, la récupération, le classement, l'assemblage du contexte, la génération, l'attribution des preuves et la fraîcheur—afin que la défaillance réelle puisse être reproduite et corrigée.