
Guide complet des métriques pour la livraison et la gestion du changement
# Guide complet des métriques pour la livraison et la gestion du changement
Dans les environnements d'entreprise, une livraison et une gestion du changement efficaces reposent sur des analyses basées sur les données. Les métriques constituent le fondement de l'évaluation des performances, de l'identification des goulots d'étranglement et de l'alignement avec les objectifs stratégiques. Ce guide couvre les métriques essentielles des pipelines de livraison, des processus de changement et de la réalisation globale de la valeur, avec des étapes pratiques pour la mise en œuvre.
## Pourquoi les métriques sont importantes dans la livraison et le changement
Les métriques transforment les opinions subjectives en données objectives, permettant aux équipes de : - Suivre les progrès par rapport aux objectifs - Prédire et atténuer les risques - Optimiser l'allocation des ressources - Démontrer le ROI aux parties prenantes
Sans métriques robustes, les organisations risquent des efforts cloisonnés, des temps d'arrêt prolongés et des transformations échouées.
## Métriques principales de livraison
### 1. Fréquence de déploiement Mesure la fréquence à laquelle le code est déployé en production. - **Objectif** : Quotidien ou plusieurs fois par jour pour les meilleurs performeurs (normes DORA) - **Calcul** : Nombre de déploiements par jour/semaine/mois - **Étapes pratiques** : 1. Intégrer le suivi des déploiements dans votre pipeline CI/CD 2. Segmenter par environnement (dev/staging/prod) 3. Comparer aux normes de l'industrie
### 2. Délai de mise en œuvre des changements Temps entre le commit et le déploiement en production. - **Objectif** : Moins d'un jour - **Calcul** : Temps moyen pour tous les changements - **Étapes pratiques** : 1. Utiliser des outils comme GitHub Actions ou Jenkins pour la journalisation automatisée 2. Identifier les retards dans les étapes de revue, de test ou d'approbation 3. Automatiser autant que possible pour réduire les goulots d'étranglement humains
### 3. Taux d'échec des changements Pourcentage de déploiements causant des défaillances en production. - **Objectif** : 0-15% - **Calcul** : (Changements échoués / Total des changements) × 100 - **Étapes pratiques** : 1. Définir « échec » (ex. : rollback, hotfix, service dégradé >1h) 2. Implémenter des déploiements canary et des feature flags 3. Réaliser des post-mortems sur les échecs
### 4. Temps moyen de récupération (MTTR) Temps moyen pour restaurer le service après une défaillance. - **Objectif** : Moins d'une heure - **Calcul** : Temps d'arrêt total / Nombre d'incidents - **Étapes pratiques** : 1. Configurer des alertes avec PagerDuty ou Opsgenie 2. Automatiser les procédures de rollback 3. Exécuter des exercices d'ingénierie du chaos
## Métriques clés de gestion du changement
### 1. Taux de succès des changements Proportion des changements mis en œuvre sans problèmes. - **Objectif** : >85% - **Calcul** : (Changements réussis / Total des changements) × 100 - **Étapes pratiques** : 1. Standardiser les modèles de demande de changement 2. Exiger des évaluations des risques et des revues par les pairs 3. Suivre via des outils ITSM comme ServiceNow
### 2. Volume de changements et arriéré Nombre de changements traités vs. en attente. - **Objectif** : Arriéré <10% du volume mensuel - **Calcul** : Changements en attente / Total soumis - **Étapes pratiques** : 1. Prioriser en utilisant la méthode MoSCoW 2. Mettre en place des comités consultatifs sur les changements (CAB) 3. Surveiller le temps de cycle de la demande à l'approbation
### 3. Pourcentage de changements d'urgence Ratio des changements urgents par rapport au total des changements. - **Objectif** : <10% - **Calcul** : (Changements d'urgence / Total) × 100 - **Étapes pratiques** : 1. Analyser les causes profondes des urgences 2. Passer à une maintenance proactive 3. Appliquer des revues post-changement
## Métriques de réalisation de la valeur
### 1. Valeur métier livrée Quantifie l'impact des changements sur les résultats clés. - **Exemples** : Augmentation des revenus, économies de coûts, engagement des utilisateurs - **Calcul** : Delta des KPI avant/après le changement - **Étapes pratiques** : 1. Étiqueter les changements avec les résultats métier attendus 2. Utiliser des frameworks OKR pour l'alignement 3. Produire des tableaux de bord trimestriels de la valeur
### 2. Satisfaction client (CSAT) Retours sur les changements livrés. - **Objectif** : >4/5 - **Calcul** : Note moyenne des enquêtes post-déploiement - **Étapes pratiques** : 1. Automatiser les enquêtes NPS/CSAT 2. Corréler avec les métriques de déploiement 3. Itérer en fonction des retours qualitatifs
## Mise en œuvre d'un cadre de métriques
1. **Sélectionner les métriques** : Commencez par les quatre métriques clés de DORA, puis ajoutez des métriques spécifiques aux changements. 2. **Outils** : Utilisez des plateformes d'observabilité (Datadog, New Relic) intégrées à l'ITSM. 3. **Tableaux de bord** : Créez des vues en temps réel dans Grafana ou Tableau. 4. **Analyse comparative** : Comparez avec les pairs du secteur via le rapport Accelerate State of DevOps. 5. **Rythme de revue** : Revues hebdomadaires par l'équipe, mises à jour mensuelles pour la direction. 6. **Boucles d'action** : Reliez les métriques aux rétrospectives et à la planification PI.
## Pièges courants et bonnes pratiques
- **Piège** : Métriques de vanité (par ex. lignes de code) – Concentrez-vous sur les résultats. - **Bonne pratique** : Le contexte compte ; segmentez par équipe/service. - **Piège** : Surcharge de métriques – Limitez-vous à 7-10 métriques principales. - **Bonne pratique** : Automatisez la collecte pour garantir l'exactitude.
Affinez régulièrement vos métriques pour refléter l'évolution des priorités. Pour réussir à l'échelle de l'entreprise, intégrez-les à vos modèles de référence pour la livraison et le changement.
Related Articles
MCP expliqué : ce qu'il connecte, ce qu'il ne fait pas et où il s'intègre
Le protocole de contexte de modèle connecte les applications d’IA à des outils, des ressources et des invites externes par le biais d’une frontière standard client-serveur. Découvrez ce que fait le MCP, ce qu’il ne fait pas et où il s’intègre dans l’architecture des agents.
Pourquoi l'IA récupère-t-elle certaines sources et en ignore-t-elle d'autres ? — La couche d'autorité de récupération
Trouver un document pertinent ne suffit pas. Les systèmes d’IA doivent aussi distinguer les sources actuelles, faisant autorité, applicables et traçables des sources qui semblent simplement similaires. La couche d’autorité de récupération définit cette frontière de sélection des sources.
Google I/O 2026 : Produits agentiels dans la Recherche, Workspace et Shopping
Google I/O 2026 a montré que l'IA agentielle va au-delà des démonstrations de modèles et des outils de développement pour s'intégrer dans les interfaces des produits du quotidien. Cet article explique comment Search, Workspace, Gemini Spark et Universal Cart pointent vers un nouveau modèle de produit où les agents Google aident les utilisateurs à effectuer des recherches, travailler, faire des achats et agir à travers des services connectés.
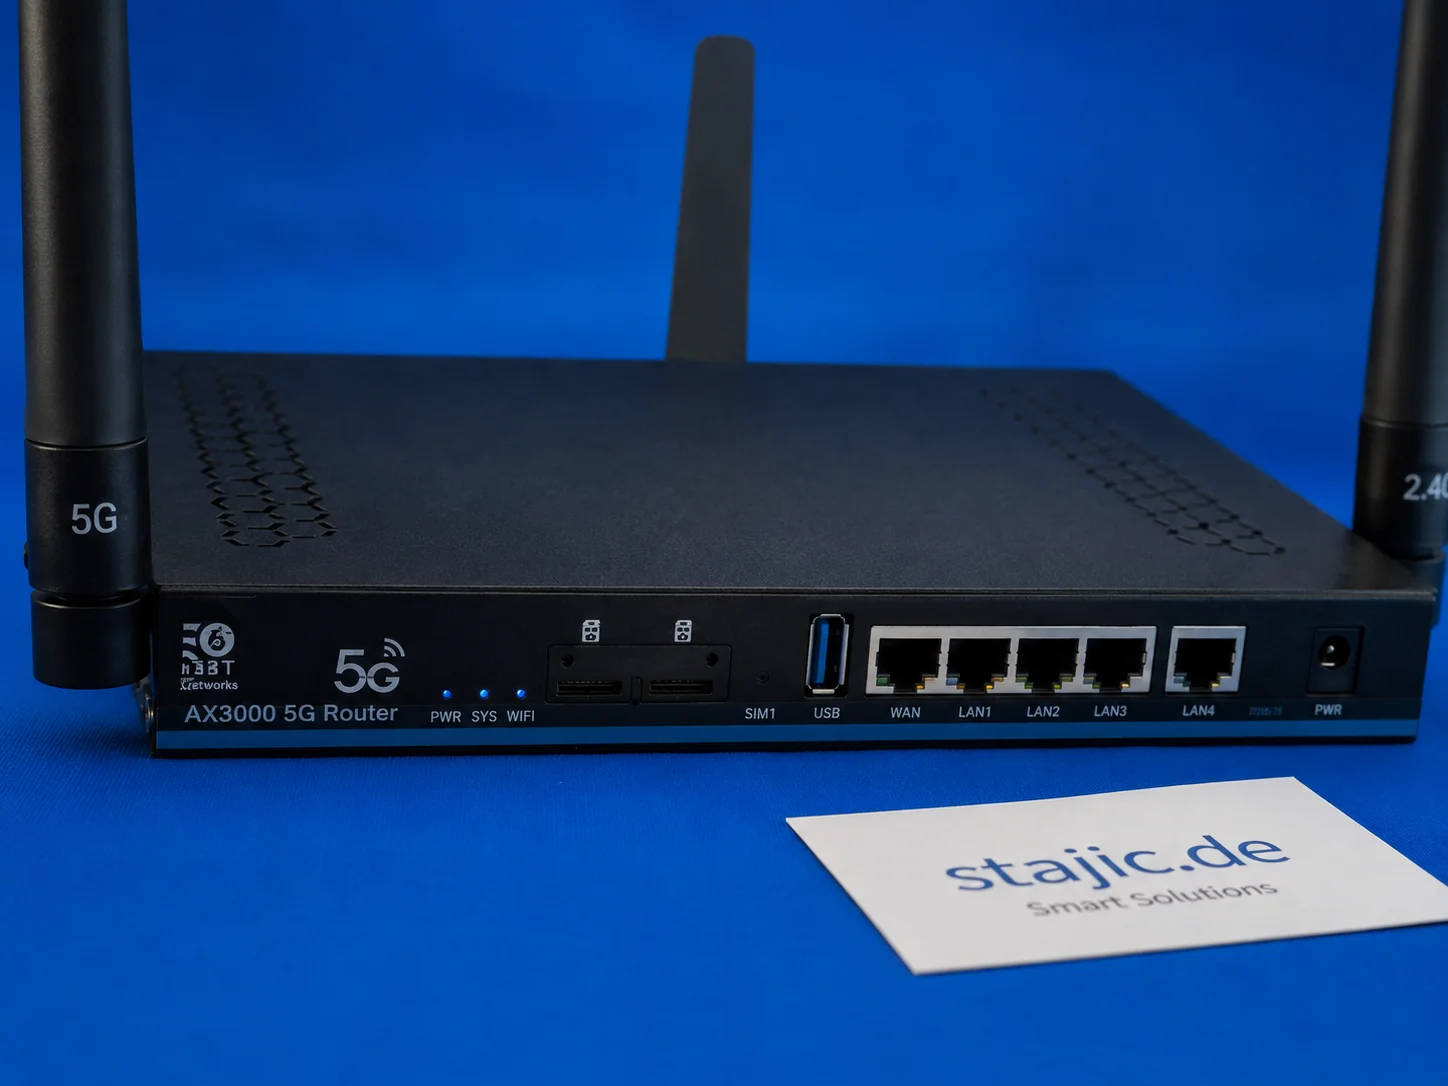
Quectel RM500U-EA dans le ZBT Z8102AX : bandes 5G, o2 Allemagne et comportement du signal en conditions réelles
Le ZBT Z8102AX utilise un modem Quectel RM500U-EA pour la connectivité 4G et 5G. Lors du premier test pratique, le routeur s'est connecté avec succès à o2 Germany avec la bande LTE 3 et la NR n28. Le modem fonctionne, mais des diagnostics plus approfondis tels que le RSRP, le RSRQ, le SINR, le verrouillage de bande et le comportement des cellules nécessitent encore des tests appropriés.
Guide complet de Test DEv Enterprise Stajic.de : architecture et bonnes pratiques
Explorez les principes architecturaux, les avantages et les détails techniques de la gestion d'un environnement de développement et de test de niveau entreprise avec Test DEv Enterprise Stajic.de.
Enterprise Start Here: Your Gateway to Operational Excellence
New to our enterprise platform? This guide provides a structured onboarding path, from foundational reference models to actionable playbooks, runbooks, and assessments designed for seamless implementation.
Invariance du prompt : la conclusion survit-elle au prompt ?
Une méthodologie pratique pour tester si la conclusion d'une IA dépend de la manière dont un problème a été formulé. Prompt Invariance compare des formulations originales, en aveugle, inversées et contradictoires, tout en maintenant la structure des preuves sous contrôle.
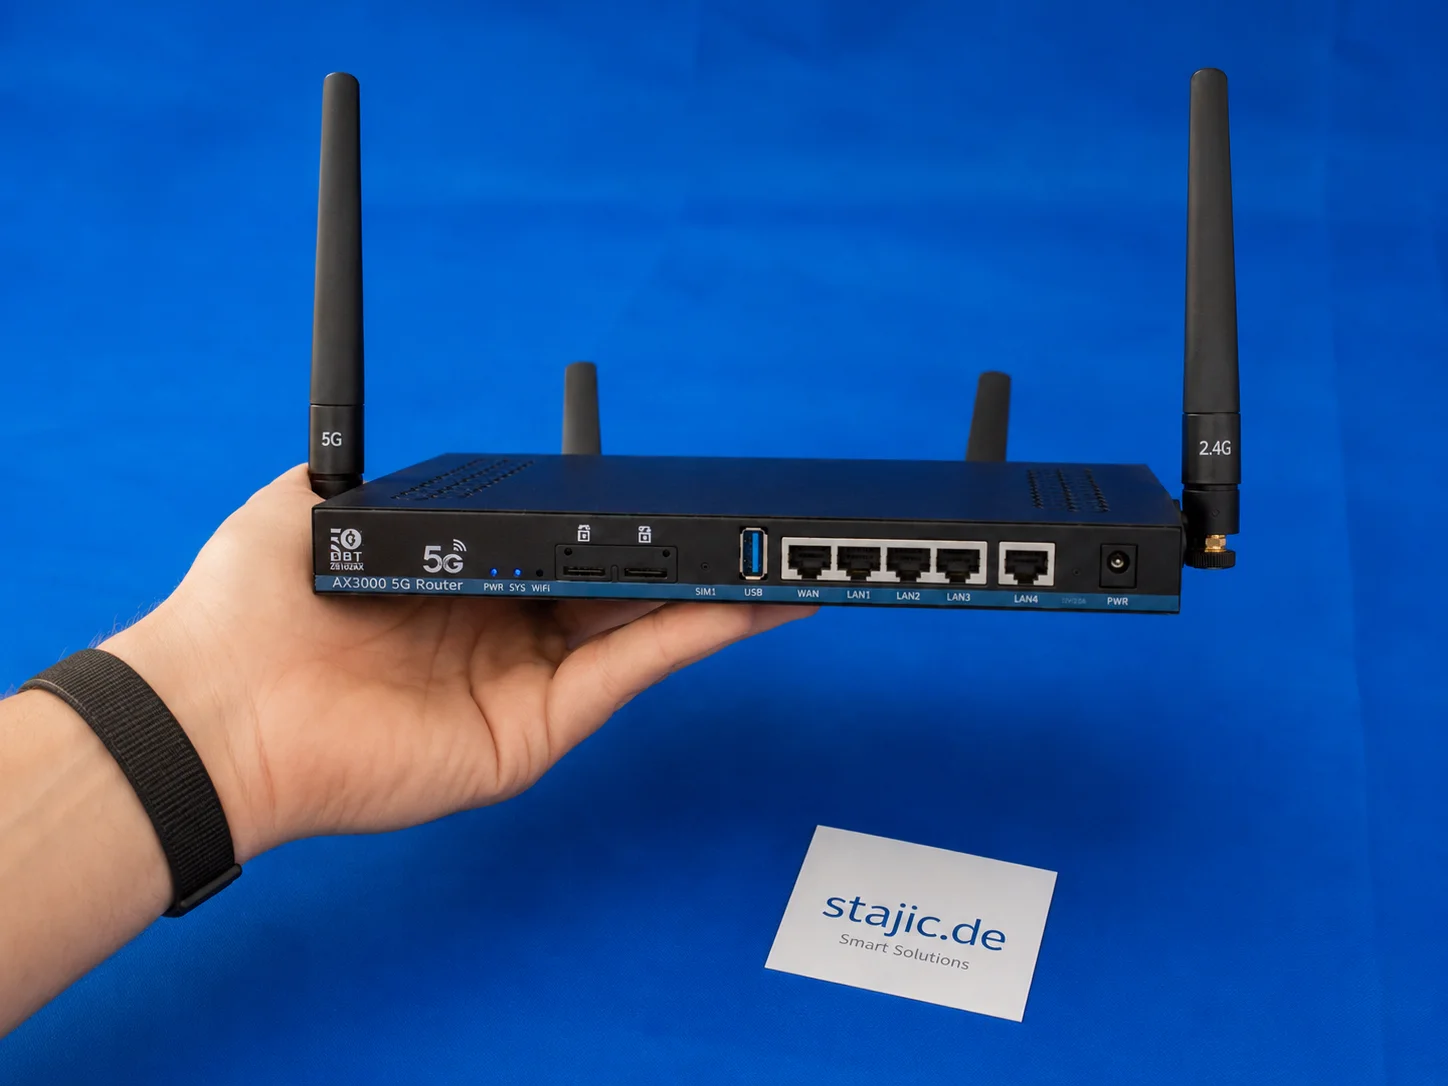
Faut-il acheter un routeur 5G OpenWrt avec un ancien firmware ? Le ZBT Z8102AX comme exemple concret
Acheter un routeur 5G OpenWrt avec un ancien firmware peut avoir du sens, mais uniquement dans les bonnes conditions. Le ZBT Z8102AX illustre clairement les deux aspects : le matériel est utile, le modem fonctionne et le routeur est resté stable lors des tests, mais OpenWrt 21.02, un emballage faible et des chemins de mise à niveau peu clairs nécessitent une décision d'achat réfléchie.
Guide complet d'Evaluation Harness : Maîtriser l'évaluation des performances des LLM
Ce guide propose une présentation détaillée d'Evaluation Harness, un framework essentiel pour évaluer rigoureusement les capacités des grands modèles de langage (LLM) dans les pipelines LLMOps d'entreprise. Découvrez la configuration, les meilleures pratiques et les techniques avancées pour garantir un benchmarking et une optimisation fiables des modèles.
Échec du RAG — mais quelle couche a réellement échoué ? Une méthode de diagnostic
Lorsqu'une réponse RAG est erronée, blâmer la récupération ou le modèle est trop vague. Cette méthode de diagnostic isole la couverture des sources, la construction de la requête, la récupération, le classement, l'assemblage du contexte, la génération, l'attribution des preuves et la fraîcheur—afin que la défaillance réelle puisse être reproduite et corrigée.
Une Architecture Monorepo Pratique avec Next.js, Fastify, Prisma, et NGINX
Explorez une architecture de monorepo pratique utilisant Next.js, Fastify, Prisma et NGINX, mettant en évidence l'intégration et le flux de travail concrets.
Qu'est-ce qu'un architecte de solutions IA ? Limites du système, responsabilités et compromis
Un architecte de solutions d'IA transforme les exigences métier en un système d'IA prêt pour la production, couvrant les données, les modèles, les outils, la sécurité, l'exécution, l'évaluation et les opérations.