
Wie man erkennt, ob ein KI-Agent tatsächlich die richtigen Belege verwendet hat

Ein KI-Agent kann Quellen zitieren, Dokumente abrufen und dennoch die falschen Belege verwenden. Eine Quelle kann maßgeblich sein, aber für die konkrete Behauptung irrelevant. Ein abgerufener Textabschnitt stützt möglicherweise nur einen Teil einer Antwort. Eine korrekte Quelle kann veraltet oder abgelöst sein oder für die falsche Rechtsordnung, Produktversion, Nutzergruppe oder den falschen Systemzustand gelten. Daraus ergibt sich ein schwierigeres Evaluierungsproblem als eine einfache Quellenprüfung: Hat der Agent tatsächlich die richtigen Belege für die von ihm aufgestellte Behauptung verwendet?
Warum Zitate nicht ausreichen
Ein Zitat beantwortet nur eine eng begrenzte Frage: Das System hat eine Behauptung oder Antwort mit einer Quelle verknüpft. Es belegt nicht automatisch, dass die Quelle die spezifische Behauptung stützt, dass die Quelle für die Aufgabe maßgeblich genug ist, dass der zitierte Abschnitt die notwendige Bedingung oder Ausnahme enthält oder dass das Modell sich auf diesen Beleg gestützt hat, anstatt die Antwort aus vorherigem Modellwissen zu generieren.
Anthropics Leitfaden zur Evaluierung von Recherche-Agenten trennt explizit zwischen Groundedness, Abdeckung und Quellenqualität. Auch OpenAIs Leitfaden zur Agenten-Evaluierung betont Ausführungsspuren (Traces), da ein Endergebnis nicht offenbart, ob der Agent die richtigen Tools ausgewählt oder den beabsichtigten Workflow befolgt hat. Diese Überlegungen weisen auf eine allgemeinere Schlussfolgerung hin: Belegqualität ist eine Eigenschaft des Ausführungspfads, nicht nur des finalen Textes.
Die vier Fragen, die jede wesentliche Behauptung bestehen sollte
| Dimension | Frage | Typischer Fehler |
|---|---|---|
| Stützung der Behauptung | Stützt der Beleg diese exakte Behauptung direkt? | Die Quelle ist thematisch verwandt, begründet die Aussage jedoch nicht |
| Autorität des Belegs | Ist dies eine geeignete Quelle für diese Art von Behauptung? | Eine sekundäre Zusammenfassung wird verwendet, wo eine Primärquelle oder ein Live-System erforderlich ist |
| Anwendbarkeit | Gilt der Beleg für diesen Zeitpunkt, diese Version, diese Rechtsordnung, diesen Nutzer, diesen Zustand oder diese Population? | Eine wahre Aussage wird außerhalb ihrer gültigen Bedingungen angewendet |
| Nutzung des Belegs | War dieser Beleg tatsächlich verfügbar und wurde er im Ausführungspfad des Agenten genutzt? | Die finale Antwort ist korrekt, aber der abgerufene Beleg war irrelevant oder ungenutzt |
1. Stützung der Behauptung: Begründet die Quelle das, was der Agent aussagt?
Belege sollten auf Behauptungsebene evaluiert werden. Ein Dokument kann für das Thema relevant sein und dennoch eine spezifische Aussage nicht stützen. Wenn eine Quelle besagt, dass eine Funktion in ausgewählten Regionen verfügbar ist, ist die Antwort „die Funktion ist weltweit verfügbar“ nicht belegt, auch wenn das Zitat plausibel wirkt.
Hier sind pauschale Urteile wie „fundiert / nicht fundiert“ oft zu grob. Teilen Sie die Antwort in wesentliche Behauptungen auf, ordnen Sie jede Behauptung dem kleinsten Belegabschnitt zu, der sie stützt, und klassifizieren Sie die Beziehung: direkte Stützung, teilweise Stützung, Widerspruch oder keine Stützung.
2. Autorität des Belegs: Ist dies die richtige Art von Quelle?
Die korrekte Auswahl von Belegen beschränkt sich nicht nur auf semantische Relevanz. Die Quelle muss für die Entscheidung geeignet sein. Ein aktueller Kontostatus sollte aus dem Kontosystem stammen, nicht aus einer alten E-Mail. Eine Behauptung zum API-Verhalten sollte vorzugsweise anhand der aktuellen Dokumentation des Anbieters oder reproduzierbarem Verhalten überprüft werden. Eine rechtliche Anforderung erfordert möglicherweise das anwendbare Gesetz, die Regulierungsbehörde oder maßgebliche Richtlinien anstelle eines allgemeinen Blogbeitrags.
Die Quellenautorität ist aufgabenspezifisch. Ein Community-Bericht kann der beste Beleg für einen realen Fehler sein, den die Dokumentation des Anbieters nicht erwähnt. Eine Ankündigung des Anbieters kann maßgeblich dafür sein, was der Anbieter behauptet, aber ein schwacher Beleg für die unabhängige Leistung. Die evaluierende Person benötigt daher eine explizite Quellenhierarchie für die jeweilige Aufgabe anstelle eines universellen Autoritätswerts.
3. Anwendbarkeit: Richtiger Beleg, falsche Bedingungen
Die gefährlichsten Belegfehler sind oft keine erfundenen Quellen, sondern gültige Quellen, die außerhalb ihres Gültigkeitsbereichs verwendet werden. Eine Empfehlung kann sich je nach Softwareversion, Datum, Rechtsordnung, Hardware-Revision, Nutzerberechtigungen, Produktverfügbarkeit, aktuellem Spielzustand, Mandantenkonfiguration oder anderen Umgebungsvariablen ändern.
Bewahren Sie für jede wesentliche Quelle die Bedingungen auf, die bestimmen, ob sie noch anwendbar ist. Dies ist besonders nach einer Zusammenfassung wichtig: Ein komprimiertes Gedächtnis oder Zitat behält möglicherweise die Schlussfolgerung bei, lässt jedoch die Ausnahme, das Datum oder die Voraussetzung weg, die die Schlussfolgerung überhaupt erst gültig gemacht haben.
4. Evidenznutzung: Hat sich der Agent tatsächlich auf die Evidenz gestützt?
Eine Antwort kann korrekt sein, selbst wenn der Abruf fehlgeschlagen ist. Das Modell kennt die Antwort möglicherweise bereits, leitet sie aus unzusammenhängendem Kontext ab oder rät einfach richtig. Wenn die Evaluierung nur die finale Korrektheit prüft, wirkt das System möglicherweise fundiert, obwohl der Evidenzpfad unterbrochen ist.
Um die Evidenznutzung zu bewerten, prüfen Sie den Trace. Stellen Sie fest, welche Quellen abgerufen wurden, welche Passagen den Kontext des Modells erreichten, wann sie verfügbar wurden und ob die endgültige Behauptung durch diese Eingaben erklärt werden kann. OpenAIs aktuelle Werkzeuge zur Agenten-Evaluierung betonen das Trace-Grading genau deshalb, weil sich das Verhalten auf Workflow-Ebene nicht verlässlich allein aus der finalen Antwort rekonstruieren lässt.
Der Evidence Utilization Test
Eine praktische Evaluierung lässt sich als kontrolliertes Kontrafaktum aufbauen. Anstatt nur zu fragen, ob die Antwort korrekt ist, ändern Sie die Evidenz und beobachten Sie, ob sich die Behauptung in die erwartete Richtung verändert.
Evidence Utilization Test
Eine Behauptungs-Evidenz-Matrix ist nützlicher als eine Quellenliste
| Behauptung | Evidenz | Stützung | Autorität | Anwendbarkeit | Im Trace verwendet |
|---|---|---|---|---|---|
| Funktion X ist verfügbar | Herstellerdokumentation | Direkt | Hoch für Verfügbarkeitsbehauptung | Aktuelle Version und Region müssen übereinstimmen | Ja / Nein |
| Konfiguration Y ist schneller | Hersteller-Benchmark | Teilweise | Hoch für Herstellertest, keine unabhängige Leistung | Hardware und Workload müssen übereinstimmen | Ja / Nein |
| Richtlinie gilt für diesen Benutzer | Aktuelle Richtlinie + Kontostatus | Nur in Kombination direkt | Hoch | Zuständigkeitsbereich, Datum, Rolle und Kontostatus müssen übereinstimmen | Ja / Nein |
| Ein Produkt ist auf Lager | Live-Bestands-API | Direkt | Maßgeblich für aktuellen Bestand | Verfällt schnell | Ja / Nein |
Diese Matrix erzwingt mehrere Fragen, die eine herkömmliche Überprüfung von Zitaten verbirgt. Eine Behauptung kann mehrere Quellen erfordern. Eine Quelle kann nur einen Teil einer Behauptung stützen. Eine maßgebliche Quelle kann ein kurzes Gültigkeitsfenster haben. Und eine vollkommen gute Quelle kann irrelevant sein, wenn sie nie in den Ausführungspfad gelangt ist.
Abrufqualität von Evidenzqualität trennen
Abrufmetriken fragen, ob relevantes Material gefunden und eingestuft wurde. Die Evidenzevaluierung fragt, ob dieses Material die resultierenden Behauptungen rechtfertigt. Beides hängt zusammen, ist aber nicht identisch.
Abruferfolg ist kein Evidenzerfolg
| Situation | Abruf | Evidenzqualität | |
|---|---|---|---|
| Richtiges Dokument, falsche Behauptung | |||
| Richtige Tatsache, veraltete Quelle | |||
| Schwache Quelle, richtige Antwort | |||
| Mehrere Quellen erforderlich |
Quellenqualität als Rubrik bewerten, nicht als Domain-Whitelist
Fest codierte Listen „vertrauenswürdiger Domains“ sind verlockend, aber oft fragil. Die Qualität von Quellen sollte stattdessen den Typ der Behauptung widerspiegeln. Nützliche Dimensionen umfassen Primär- versus Sekundärstatus, Aktualität, Direktheit, Reproduzierbarkeit, Unabhängigkeit, Fachkompetenz, Datenherkunft, Aktualisierungszyklus und die Frage, ob die Quelle einen Anreiz hat, die Behauptung zu übertreiben.
Anthropics Leitfaden zur Evaluierung von Forschungsagenten hebt Prüfungen der Quellenqualität neben Fundierung und Abdeckung explizit hervor. Die praktische Umsetzung sollte daher sowohl bewerten, was die Quelle aussagt, als auch, ob diese Quelle für diese Art von Aussage angemessen ist.
Evidenzabdeckung: Jede wichtige Behauptung benötigt Belege, nicht jeder Satz
Nicht jeder Satz erfordert einen Beleg. Übergangsformulierungen, Arithmetik, die transparent aus zitierten Werten abgeleitet ist, oder eindeutig gekennzeichnete Interpretationen benötigen möglicherweise keine separate Quelle. Aber jede wesentliche, extern überprüfbare Behauptung sollte ausreichend belegt sein, damit ein Prüfer nachvollziehen kann, warum der Agent diese Aussage treffen durfte.
Die Belegabdeckung sollte daher nach der Relevanz der Behauptung gewichtet werden. Fehlende Belege für ein dekoratives Detail sind nicht gleichzusetzen mit fehlenden Belegen für einen Preis, eine Berechtigungsentscheidung, eine Sicherheitsanweisung, eine rechtliche Anforderung, eine Aussage zur technischen Kompatibilität oder eine Tatsache, die eine Empfehlung begründet.
Die Provenienz von Belegen muss Zusammenfassungen und das Gedächtnis überdauern
Langlaufende Agenten fassen häufig frühere Arbeiten zusammen oder speichern dauerhafte Erinnerungen. Wenn bei dieser Transformation die Provenienz der Belege verloren geht, können zukünftige Agenten zwar eine saubere Schlussfolgerung abrufen, ohne jedoch zu wissen, ob diese aus einer Benutzeraussage, einer Live-API, einem alten Dokument, einer Modellinferenz oder einem unbestätigten Webergebnis stammt.
Bei wichtigen Fakten sollten mindestens die Identität der Quelle, der Abruf- oder Beobachtungszeitpunkt, der Belegtyp, die relevante Version oder der Status sowie die Angabe erhalten bleiben, ob der gespeicherte Text zitiert, zusammengefasst, geschlussfolgert oder abgeleitet ist. Erst die Provenienz ermöglicht es einem späteren Agenten zu entscheiden, ob der Beleg vertrauenswürdig ist, aktualisiert, eingeschränkt oder verworfen werden sollte.
Ein praxisorientierter Belegdatensatz
| Feld | Zweck |
|---|---|
| claim_id | Identifiziert die wesentliche Behauptung, die gestützt wird |
| source_id / source_url / system | Identifiziert den Ursprung des Belegs |
| evidence_span | Bewahrt die kleinste Textpassage, den Datensatz oder das Tool-Ergebnis auf, das die Behauptung stützt |
| retrieved_at / observed_at | Ermöglicht Prüfungen auf Aktualität und zeitliche Einordnung |
| source_version / object_version | Ermöglicht Prüfungen auf Überholtheit und Reproduzierbarkeit |
| authority_role | Erklärt, warum diese Quelle für die Behauptung geeignet ist |
| applicability | Speichert relevante Bedingungen wie Datum, Rechtsprechung, Produktversion, Benutzer, Mandant oder Status |
| transformation | Kennzeichnet, ob der Beleg roh, zitiert, zusammengefasst, normalisiert oder abgeleitet ist |
| trace_step | Zeigt an, wann der Beleg für den Agenten verfügbar wurde |
| support_status | Direkt, partiell, widersprüchlich, unbelegt oder unsicher |
Fehlermuster, die fundiert wirken, es aber nicht sind
| Fehlermuster | Warum es Prüfer täuscht | Was zu testen ist |
|---|---|---|
| Dekorative Zitate | Die Antwort enthält Quellen und wirkt daher gut recherchiert | Jede wesentliche Behauptung einer exakt stützenden Textpassage zuordnen |
| Autoritätsdiskrepanz | Die Quelle ist seriös, aber für das spezifische Faktum nicht maßgeblich | Anspruchsspezifische Quellenhierarchie definieren |
| Zeitliche Diskrepanz | Die Quelle war zum Zeitpunkt der Veröffentlichung korrekt | Abrufzeitpunkt, Quelldatum und neuere Belege prüfen |
| Verlust von Bedingungen | Eine Zusammenfassung behält das Fazit bei, unterschlägt aber Ausnahmen | Generierte Behauptung mit dem vollständigen lokalen Kontext der Quelle vergleichen |
| Post-hoc-Zitierung | Eine plausible Quelle wird erst nach der Generierung der Antwort angefügt | Trace-Reihenfolge prüfen und verifizieren, ob der Beleg vor der Behauptung vorlag |
| Parametrische Übersteuerung | Das Modell ignoriert abgerufene Belege und antwortet aus seinem Vorwissen | Kontrafaktische Tests zur Evidenznutzung durchführen |
| Beleg-Geldwäsche | Modellinferenzen werden zusammengefasst und später als Primärquelle gespeichert | Transformationstyp und Provenienz über Speicheroperationen hinweg beibehalten |
| Quellen-Mehrheitsfehlschluss | Mehrere Sekundärseiten wiederholen dieselbe unbelegte Aussage | Behauptungen auf unabhängige oder primäre Belege zurückführen |
Wie der Agent im Produktivbetrieb evaluiert wird
Pipeline zur Belegevaluierung
Die aktuellen Evaluierungsleitlinien von OpenAI empfehlen aufgabenspezifische Evals, kontinuierliche Evaluierung, aus dem Produktivbetrieb abgeleitete Datensätze sowie Traces zum Debuggen des Agentenverhaltens. Auch Anthropic empfiehlt für Research-Agenten die Kombination mehrerer Bewertungsansätze, da Korrektheit, Quellenqualität, Abdeckung und Faktentreue getrennte Dimensionen darstellen. Die Belegevaluierung sollte demselben Muster folgen: Mehrere eng gefasste Evaluatoren liefern mehr Erkenntnisse als ein einzelner, undurchsichtiger Qualitätswert.
Ein LLM-Judge darf nicht die einzige Bewertungsinstanz sein
LLM-Evaluatoren sind nützlich für die skalierbare Klassifizierung von Behauptungen, Relevanzprüfungen und paarweise Vergleiche. Sie können jedoch dieselben toten Winkel aufweisen wie das System, das sie bewerten. Ein Evaluator akzeptiert möglicherweise eine plausible, aber unbelegte Behauptung, übersieht feine Versionsunterschiede oder bewertet eine gut formulierte Quelle zu positiv.
Die Evaluierungsrichtlinien von OpenAI empfehlen, automatisierte Evaluatoren anhand menschlicher Urteile zu kalibrieren und klare, abgegrenzte Kriterien zu verwenden. Bei belegintensiven Systemen sollten nach Möglichkeit deterministische Prüfungen eingesetzt werden: Zeitstempel, Objektversionen, Berechtigungsbereiche, exakte Quellen-IDs, Abrufreihenfolge, Dokumenten-Hashes und die Prüfung, ob der Beleg bereits vorlag, bevor das Modell die Behauptung generiert hat.
Was würde diese Antwort verändern?
Die Evaluierung kann einfacher gestaltet werden, wenn der Agent auf einem kleinen, unveränderlichen und maßgeblichen Korpus arbeitet und jede Antwort rein extraktiv ist. In einer solchen Umgebung sind die Autorität und Anwendbarkeit der Quellen weitgehend festgelegt, sodass der Belegabgleich auf Satzebene ausreichen kann.
Die Evaluierung muss strenger werden, sobald der Agent Websuchen, Langzeitgedächtnis, Live-Tools, mehrere Rechtsordnungen, sich schnell ändernde Informationen, nutzerspezifische Zustände oder autonome Aktionen miteinander kombiniert. In solchen Systemen hängt die Gültigkeit von Belegen nicht nur vom Quelltext ab, sondern auch davon, wann und wie der Beleg beschafft wurde.
Zukünftige Modelle werden Herkunft und Unsicherheit intern möglicherweise besser nachverfolgen können, doch das beseitigt in Systemen, die Prüfbarkeit erfordern, nicht den Bedarf an externen Evidenzaufzeichnungen. Ein System sollte sich nicht auf die Selbsteinschätzung des Modells darüber verlassen, was es beeinflusst hat, wenn Traces und Quellmetadaten stichhaltigere Belege liefern können.
Einschränkungen
Es ist nicht immer möglich, die kausale Nutzung von Belegen allein aus Traces nachzuweisen. Eine Quelle kann im Kontext vorhanden sein, ohne die Antwort zu beeinflussen, und ein Modell kennt dieselbe Tatsache möglicherweise unabhängig davon. Kontrafaktische Tests stärken die Schlussfolgerung, können jedoch selbst die Aufgabenverteilung verändern.
Auch die Autorität von Quellen kann umstritten oder domänenabhängig sein. Manche Fragen haben keine einzelne maßgebliche Quelle, und Fachleute sind sich möglicherweise uneins darüber, welche Evidenz mehr Gewicht verdient. In diesen Fällen sollte die Evaluation die Uneinigkeit abbilden und Transparenz, Abdeckung sowie Argumentation anhand eines expliziten Schemas bewerten, anstatt vorzutäuschen, dass es eine einzige unumstößliche Wahrheitsquelle gäbe.
Fazit
Die Frage „Hat der Agent eine Quelle zitiert?“ ist für den Produktiveinsatz von KI zu schwach. Die weitaus entscheidendere Frage lautet: Stammt jede wesentliche Behauptung aus einer Evidenz, die sie tatsächlich stützt, die erforderliche Autorität besitzt, für die aktuellen Rahmenbedingungen noch gültig ist und im Ausführungspfad verfügbar war, bevor die Behauptung aufgestellt wurde?
Damit wird Evidenz vom bloßen Beiwerk zu einer überprüfbaren Systemeigenschaft. Erfassen Sie den Trace. Ordnen Sie Behauptungen Belegen zu. Überprüfen Sie Autorität und Anwendbarkeit. Führen Sie kontrafaktische Evidenztests durch. Bewahren Sie die Herkunft über Zusammenfassungen und das Gedächtnis hinweg. Dann ist eine korrekte Antwort nicht nur plausibel — sie besitzt einen nachvollziehbaren Evidenzpfad.
FAQ
Evaluierung der Evidenznutzung bei KI-Agenten
Beweist ein Zitat, dass eine KI-Antwort fundiert ist?
Wie kann ich testen, ob ein KI-Agent abgerufene Belege tatsächlich genutzt hat?
Was ist der Unterschied zwischen Fundierung (Groundedness) und Quellenqualität?
Warum kann eine echte Quelle dennoch zu einer falschen KI-Antwort führen?
Was sollte ich für die Evidenzevaluierung protokollieren?
Glossar
Wichtige Begriffe zur Evidenzevaluierung
- Behauptungsstützung (Claim support)
- Der Grad, in dem ein bestimmter Evidenzauszug eine generierte Behauptung direkt belegt.
- Anwendbarkeit (Applicability)
- Die Bedingungen, unter denen Belege für eine Behauptung gültig bleiben, einschließlich Zeit, Version, Rechtsraum, Benutzer, Population, Systemzustand oder anderer Grenzen.
- Evidenznutzung (Evidence utilization)
- Ob die Ausgabe des Agenten tatsächlich auf die in seinem Ausführungspfad bereitgestellte Evidenz reagiert und von ihr abhängt.
- Kontrafaktischer Evidenztest (Counterfactual evidence test)
- Eine Evaluierung, bei der entscheidende Belege entfernt, ersetzt oder geändert werden, um zu prüfen, ob sich die Behauptung des Agenten entsprechend anpasst.
- Herkunft (Provenance)
- Metadaten, die festhalten, woher Belege stammen, wann sie erfasst wurden, wie sie transformiert wurden und welche Version oder welchen Zustand sie repräsentieren.
Primärquellen und weiterführende Literatur
OpenAI — Evaluate Agent WorkflowsLeitfaden zu Trace-Bewertungen, Workflows auf Systemebene, Datensätzen und wiederholbaren Evaluierungsläufen für Agenten.
OpenAI — Evaluation Best PracticesLeitfaden zu aufgabenspezifischen Evals, produktionsnahen Datensätzen, abgegrenzten Metriken, kontinuierlicher Evaluierung und Kalibrierung von Prüfinstanzen.
Anthropic — Demystifying Evals for AI AgentsLeitfaden zur Agenten-Evaluierung einschließlich Prüfungen von Fundierung, Abdeckung und Quellenqualität für Recherche-Agenten.
OpenAI — A Shared Playbook for Trustworthy Third-Party EvaluationsEvaluierungsleitfaden, der hervorhebt, dass die Leistung moderner Agenten von Workflow und Umgebung abhängt, nicht nur von der finalen Modellausgabe.
Related Articles

Die Antwortgültigkeitsgrenze: Die fehlende Schicht zwischen Relevanz und zuverlässigen KI-Antworten
Eine Quelle kann relevant und maßgeblich sein und dennoch falsch für die gestellte Frage. Die fehlende Ebene ist die Anwendbarkeit: die Bedingungen, unter denen eine Antwort gilt, und die Veränderungen, die erzwingen, dass sie überdacht werden muss. Dieser Artikel führt die Answer Validity Boundary als ein Quellendesign-Muster für Menschen, KI-Suche und RAG-Systeme ein.

Sollten Sie einen 5G-OpenWrt-Router mit alter Firmware kaufen? ZBT Z8102AX als praktisches Beispiel
Kauf eines 5G-OpenWrt-Routers mit älterer Firmware kann sinnvoll sein, aber nur unter den richtigen Bedingungen. Der ZBT Z8102AX zeigt beide Seiten deutlich: Die Hardware ist nützlich, das Modem funktioniert, und der Router blieb im Test stabil, aber OpenWrt 21.02, schwache Verpackung und unklare Upgrade-Pfade erfordern eine sorgfältige Kaufentscheidung.

MCP vs A2A vs UCP vs AP2 vs A2UI: Der Agenten-Protokoll-Stack erklärt
MCP, A2A, UCP, AP2 und A2UI werden oft als konkurrierende Agentenstandards dargestellt. Sie lösen größtenteils unterschiedliche Interoperabilitätsprobleme. Dieser Leitfaden ordnet jedes Protokoll der Grenze zu, die es tatsächlich standardisiert—und zeigt, wie sie in einem Produktionssystem zusammenarbeiten können.

Computer-Use-Agenten: Warum eine erfolgreiche Demo dennoch ein unzuverlässiges System sein kann
Computer-Use-Agenten können mittlerweile beeindruckende Browser- und Desktop-Workflows abschließen, aber ein erfolgreicher Durchlauf beweist Fähigkeit—nicht Zuverlässigkeit. Dieser Artikel zeigt, wie man Wiederholbarkeit, Umgebungsrobustheit, Steuerung über lange Zeithorizonte, Zustandsbewusstsein, Ergebnisüberprüfung und sichere Zielhandhabung testet.
Kanonische Architektur, URL-Design, Resolver-Logik, API- & Skalierbarkeitsspezifikation
Geobasierte Erkennungsarchitektur für Mehrmandantenportale. Definiert kanonische URLs, Resolver-Logik, Caching-Strategie und ein Geo-Read-Modell ohne CMS-Kopplung oder Datenbank-Refactoring. Konzipiert für SEO-Stabilität, Skalierbarkeit und zukünftige Erweiterungen wie Buchung und Karten.
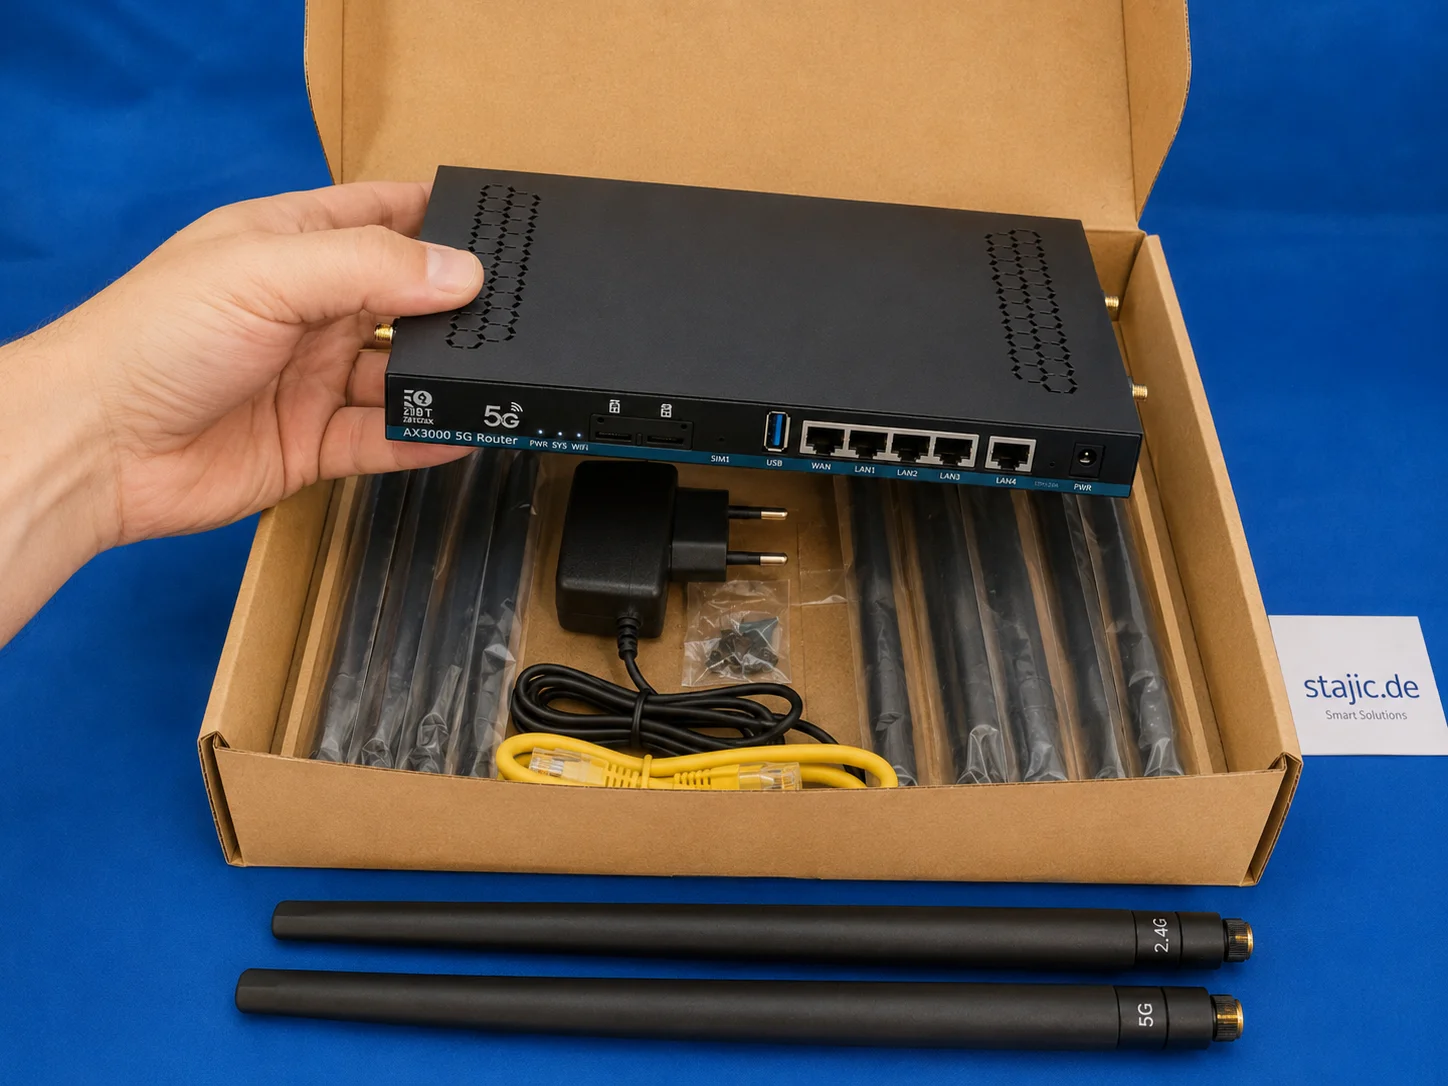
ZBT Z8102AX Hardware- und Verpackungs-Review: Starker Router, schwache Box
Der ZBT Z8102AX macht einen soliden ersten Eindruck als schlanker, schwarzer 5G-OpenWrt-Router aus Metall mit mehreren Antennenanschlüssen, Dual-SIM-Slots, USB- und LAN/WAN-Ports und einem praktischen Zubehörset. Die Hardware fühlt sich nützlich und seriös an, aber die Verpackung ist eindeutig die Schwachstelle.

Was sollte ein KI-Agent behalten, vergessen, neu berechnen oder erneut abrufen?
Langlaufende Agenten sollten sich nicht alles merken. Dieser Artikel bietet ein praktisches Lebenszyklusmodell für die Entscheidung, was in den dauerhaften Speicher gehört, was erneut abgerufen werden sollte, was sicherer neu zu berechnen ist und was ablaufen oder ersetzt werden sollte.

Warum mehr Kontext KI-Antworten verschlechtern kann
Ein größeres Kontextfenster garantiert keine bessere Antwort. Dieser Artikel erklärt, wie Signalverwässerung, widersprüchliche Belege, veralteter Zustand, Positionssensitivität und verlustbehaftete Kompression die KI-Zuverlässigkeit verringern können—und stellt einen praktischen Context Pressure Test vor.
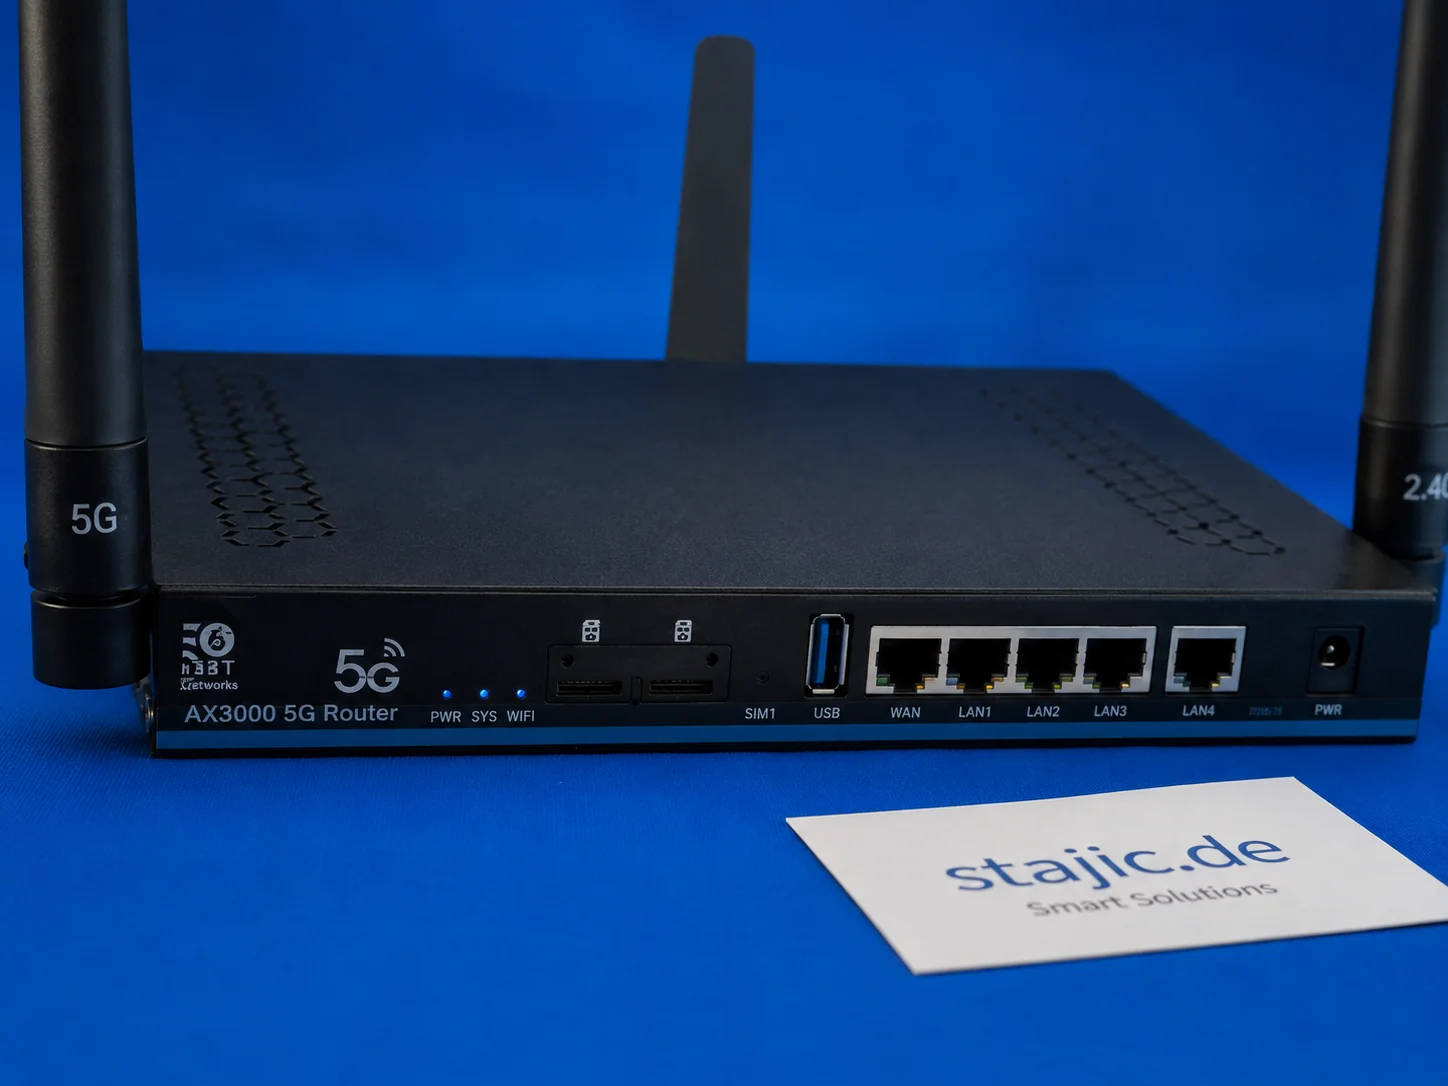
Quectel RM500U-EA im ZBT Z8102AX: 5G-Bänder, o2 Germany und Signalverhalten in der Praxis
Der ZBT Z8102AX verwendet ein Quectel RM500U-EA-Modem für die 4G- und 5G-Konnektivität. Im ersten Praxistest verband sich der Router erfolgreich mit o2 Germany mit LTE-Band 3 und NR n28. Das Modem funktioniert, aber tiefergehende Diagnosen wie RSRP, RSRQ, SINR, Band-Locking und Zellverhalten müssen noch richtig getestet werden.