Guida Completa alle Metriche per la Consegna e la Gestione del Cambiamento
# Guida Completa alle Metriche per la Consegna e la Gestione del Cambiamento
Negli ambienti enterprise, una consegna e una gestione del cambiamento efficaci si basano su insight guidati dai dati. Le metriche fungono da fondamento per valutare le prestazioni, identificare i colli di bottiglia e garantire l'allineamento con gli obiettivi strategici. Questa guida copre le metriche principali relative alle pipeline di consegna, ai processi di cambiamento e alla realizzazione complessiva del valore, con passaggi pratici per l'implementazione.
## Perché le Metriche Contano nella Consegna e nel Cambiamento
Le metriche trasformano le opinioni soggettive in dati oggettivi, consentendo ai team di: - Monitorare i progressi rispetto agli obiettivi - Prevedere e mitigare i rischi - Ottimizzare l'allocazione delle risorse - Dimostrare il ROI agli stakeholder
Senza metriche solide, le organizzazioni rischiano sforzi isolati, tempi di inattività prolungati e trasformazioni fallite.
## Metriche Principali di Consegna
### 1. Frequenza di Distribuzione Misura la frequenza con cui il codice viene distribuito in produzione. - **Obiettivo**: Giornaliera o più volte al giorno per i performer d'élite (standard DORA) - **Calcolo**: Numero di distribuzioni al giorno/settimana/mese - **Passaggi Pratici**: 1. Integrare il monitoraggio delle distribuzioni nella pipeline CI/CD 2. Segmentare per ambiente (sviluppo/staging/produzione) 3. Confrontare con gli standard di settore
### 2. Tempo di Consegna per le Modifiche Tempo dal commit alla distribuzione in produzione. - **Obiettivo**: Meno di un giorno - **Calcolo**: Tempo medio su tutte le modifiche - **Passaggi Pratici**: 1. Utilizzare strumenti come GitHub Actions o Jenkins per la registrazione automatica 2. Identificare ritardi nelle fasi di revisione, test o approvazione 3. Automatizzare dove possibile per ridurre i colli di bottiglia umani
### 3. Tasso di Fallimento delle Modifiche Percentuale di distribuzioni che causano guasti in produzione. - **Obiettivo**: 0-15% - **Calcolo**: (Modifiche fallite / Modifiche totali) × 100 - **Passaggi Pratici**: 1. Definire 'fallimento' (es. rollback, hotfix, servizio degradato >1 ora) 2. Implementare rilasci canary e feature flag 3. Condurre post-mortem sui fallimenti
### 4. Tempo Medio di Ripristino (MTTR) Tempo medio per ripristinare il servizio dopo un guasto. - **Obiettivo**: Meno di un'ora - **Calcolo**: Tempo totale di inattività / Numero di incidenti - **Passaggi Pratici**: 1. Configurare avvisi con PagerDuty o Opsgenie 2. Automatizzare le procedure di rollback 3. Eseguire drill di chaos engineering
## Metriche Chiave di Gestione del Cambiamento
### 1. Tasso di Successo delle Modifiche Proporzione di modifiche implementate senza problemi. - **Obiettivo**: >85% - **Calcolo**: (Modifiche riuscite / Modifiche totali) × 100 - **Passaggi Pratici**: 1. Standardizzare i template delle richieste di modifica 2. Richiedere valutazioni del rischio e revisioni tra pari 3. Tracciare tramite strumenti ITSM come ServiceNow
### 2. Volume delle Modifiche e Backlog Numero di modifiche elaborate rispetto a quelle in sospeso. - **Obiettivo**: Backlog <10% del volume mensile - **Calcolo**: Modifiche in sospeso / Totale inviate - **Passaggi Pratici**: 1. Prioritizzare utilizzando il metodo MoSCoW 2. Implementare change advisory board (CAB) 3. Monitorare il tempo di ciclo dalla richiesta all'approvazione
### 3. Percentuale di Modifiche di Emergenza Rapporto tra modifiche urgenti e modifiche totali. - **Obiettivo**: <10% - **Calcolo**: (Modifiche di emergenza / Totale) × 100 - **Passaggi Pratici**: 1. Analizzare le cause principali delle emergenze 2. Passare a una manutenzione proattiva 3. Applicare revisioni post-modifica
## Metriche di Realizzazione del Valore
### 1. Valore Aziendale Consegnato Quantifica l'impatto delle modifiche sui risultati chiave. - **Esempi**: Aumento dei ricavi, risparmio sui costi, coinvolgimento degli utenti - **Calcolo**: Delta KPI pre/post modifica - **Passaggi Pratici**: 1. Etichettare le modifiche con i risultati aziendali attesi 2. Utilizzare framework OKR per l'allineamento 3. Riferire scorecard trimestrali sul valore
### 2. Soddisfazione del Cliente (CSAT) Feedback sulle modifiche consegnate. - **Obiettivo**: Punteggio >4/5 - **Calcolo**: Punteggio medio del sondaggio post-distribuzione - **Passaggi Pratici**: 1. Automatizzare i sondaggi NPS/CSAT 2. Correlare con le metriche di distribuzione 3. Iterare in base al feedback qualitativo
## Implementazione di un Framework di Metriche
1. **Seleziona Metriche**: Inizia con le quattro metriche chiave di DORA, quindi aggiungi quelle specifiche per il cambiamento. 2. **Strumenti**: Utilizza piattaforme di osservabilità (Datadog, New Relic) integrate con ITSM. 3. **Dashboard**: Crea visualizzazioni in tempo reale in Grafana o Tableau. 4. **Benchmarking**: Confronta con i peer del settore tramite il report Accelerate State of DevOps. 5. **Cadenza di Revisione**: Recensioni settimanali del team, aggiornamenti mensili per il management. 6. **Cicli di Azione**: Collega le metriche ai retrospettivi e alla pianificazione PI.
## Errori Comuni e Best Practice
- **Errore**: Metriche di vanità (es. linee di codice) – Concentrati sui risultati. - **Best Practice**: Il contesto è importante; segmenta per team/servizio. - **Errore**: Sovraccaricare con metriche – Limita a 7-10 metriche principali. - **Best Practice**: Automatizza la raccolta per garantire l'accuratezza.
Raffina regolarmente le tue metriche per riflettere le priorità in evoluzione. Per il successo su scala enterprise, integra queste nei tuoi modelli di riferimento per delivery e change.
Related Articles
Quanto dista un'affermazione dell'IA dalle prove? — Distanza probatoria
Non tutte le risposte supportate sono ugualmente vicine alle loro prove. La Distanza dalle Prove è un modo pratico per descrivere quante trasformazioni, sintesi, assunzioni e passaggi inferenziali separano un'affermazione dell'IA da prove direttamente ispezionabili.
MLOps vs LLMOps: cosa cambia quando il modello è un LLM
MLOps gestisce i sistemi di machine learning; LLMOps estende tali pratiche a prompt, contesto, recupero, provider, strumenti, valutazioni e comportamento a runtime attorno ai modelli linguistici di grandi dimensioni.
Fonte di verità nei sistemi di IA: da dove proviene realmente la conoscenza affidabile
Una Fonte di Verità definisce quale fonte è autorevole per un fatto o uno stato specifico. Scopri come si differenzia da RAG, provenienza, memoria, contesto, database vettoriali e sistemi di registrazione.
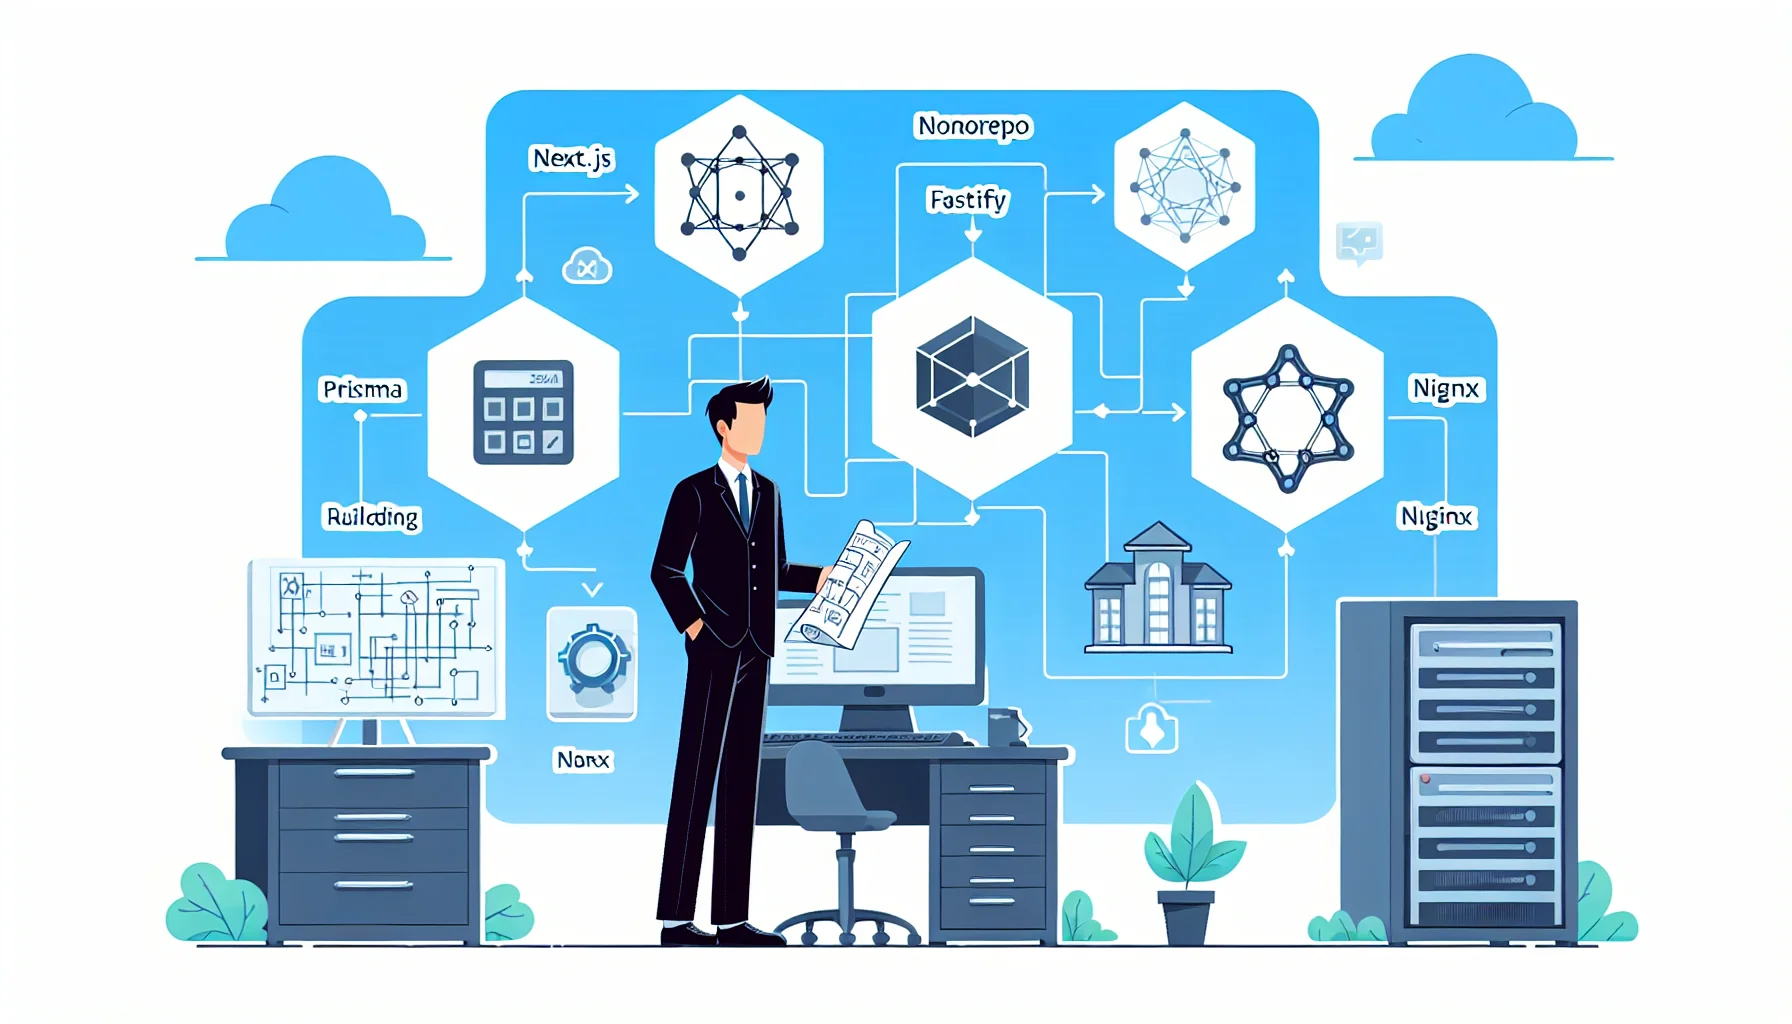
Un'Architettura Monorepo Pratica con Next.js, Fastify, Prisma e NGINX
Esplora un'architettura monorepo pratica che utilizza Next.js, Fastify, Prisma e NGINX, evidenziando l'integrazione e il flusso di lavoro nel mondo reale.
RAG non riuscito — Ma quale livello ha effettivamente fallito? Un metodo diagnostico
Quando una risposta RAG è sbagliata, dare la colpa al recupero o al modello è troppo vago. Questo metodo diagnostico isola la copertura delle fonti, la costruzione della query, il recupero, il ranking, l'assemblaggio del contesto, la generazione, l'attribuzione delle evidenze e l'aggiornamento—così il guasto effettivo può essere riprodotto e corretto.
Guida completa a Evaluation Harness: Padroneggiare la valutazione delle prestazioni degli LLM
Questa guida fornisce una panoramica dettagliata di Evaluation Harness, un framework essenziale per valutare rigorosamente le capacità dei modelli linguistici di grandi dimensioni (LLM) nelle pipeline LLMOps aziendali. Scopri la configurazione, le best practice e le tecniche avanzate per garantire un benchmarking e un'ottimizzazione dei modelli affidabili.
OpenAI Agents API vs Agents SDK vs Responses API: Su cosa dovresti sviluppare nel 2026?
Lo stack di agenti di OpenAI è cambiato a settembre 2026. Questa guida all'architettura separa Agents API, Agents SDK, Responses API e Codex SDK in base alla proprietà del runtime—in modo che i team possano scegliere il giusto confine di controllo invece di confrontare i nomi dei prodotti.
Può la prova sopravvivere alla pipeline dell'IA? — La catena di conservazione delle prove
Le prove possono essere corrette alla fonte e diventare comunque inaffidabili dopo l'analisi, la normalizzazione, la suddivisione in blocchi, il recupero e l'assemblaggio del contesto. La Catena di Preservazione delle Prove tiene traccia se identità, provenienza, ambito e significato sopravvivono all'intera pipeline di IA.
Che cos'è un architetto di piattaforme AI? Modelli, dati, runtime, sicurezza e operazioni
Un Architetto di Piattaforme AI progetta fondamenta AI riutilizzabili attraverso modelli, fornitori, recupero, agenti, identità, sicurezza, valutazione, osservabilità e operazioni.
Tendenze emergenti di Linux nel 2026: plasmare il futuro dell'infrastruttura server
Esplora le principali tendenze Linux del 2026, dal dominio di Kubernetes e dalle distribuzioni immutabili all'integrazione dell'IA e alla sicurezza eBPF.
ComfyUI su Fedora 43: Due Ambienti Virtuali + Avvio con un Clic (Marzo 2026)
Obiettivo: Mantenere due venv Python (es. 3.12 + 3.14) per la compatibilità, ma avviare ComfyUI automaticamente con una configurazione pulita e leggera.
Che cos'è un AI Solution Architect? Confini del sistema, responsabilità e compromessi
Un Solution Architect AI trasforma i requisiti aziendali in un sistema AI pronto per la produzione, attraverso dati, modelli, strumenti, sicurezza, runtime, valutazione e operazioni.