
Da dove prende i dati un LLM? Fonti di dati RAG in Python
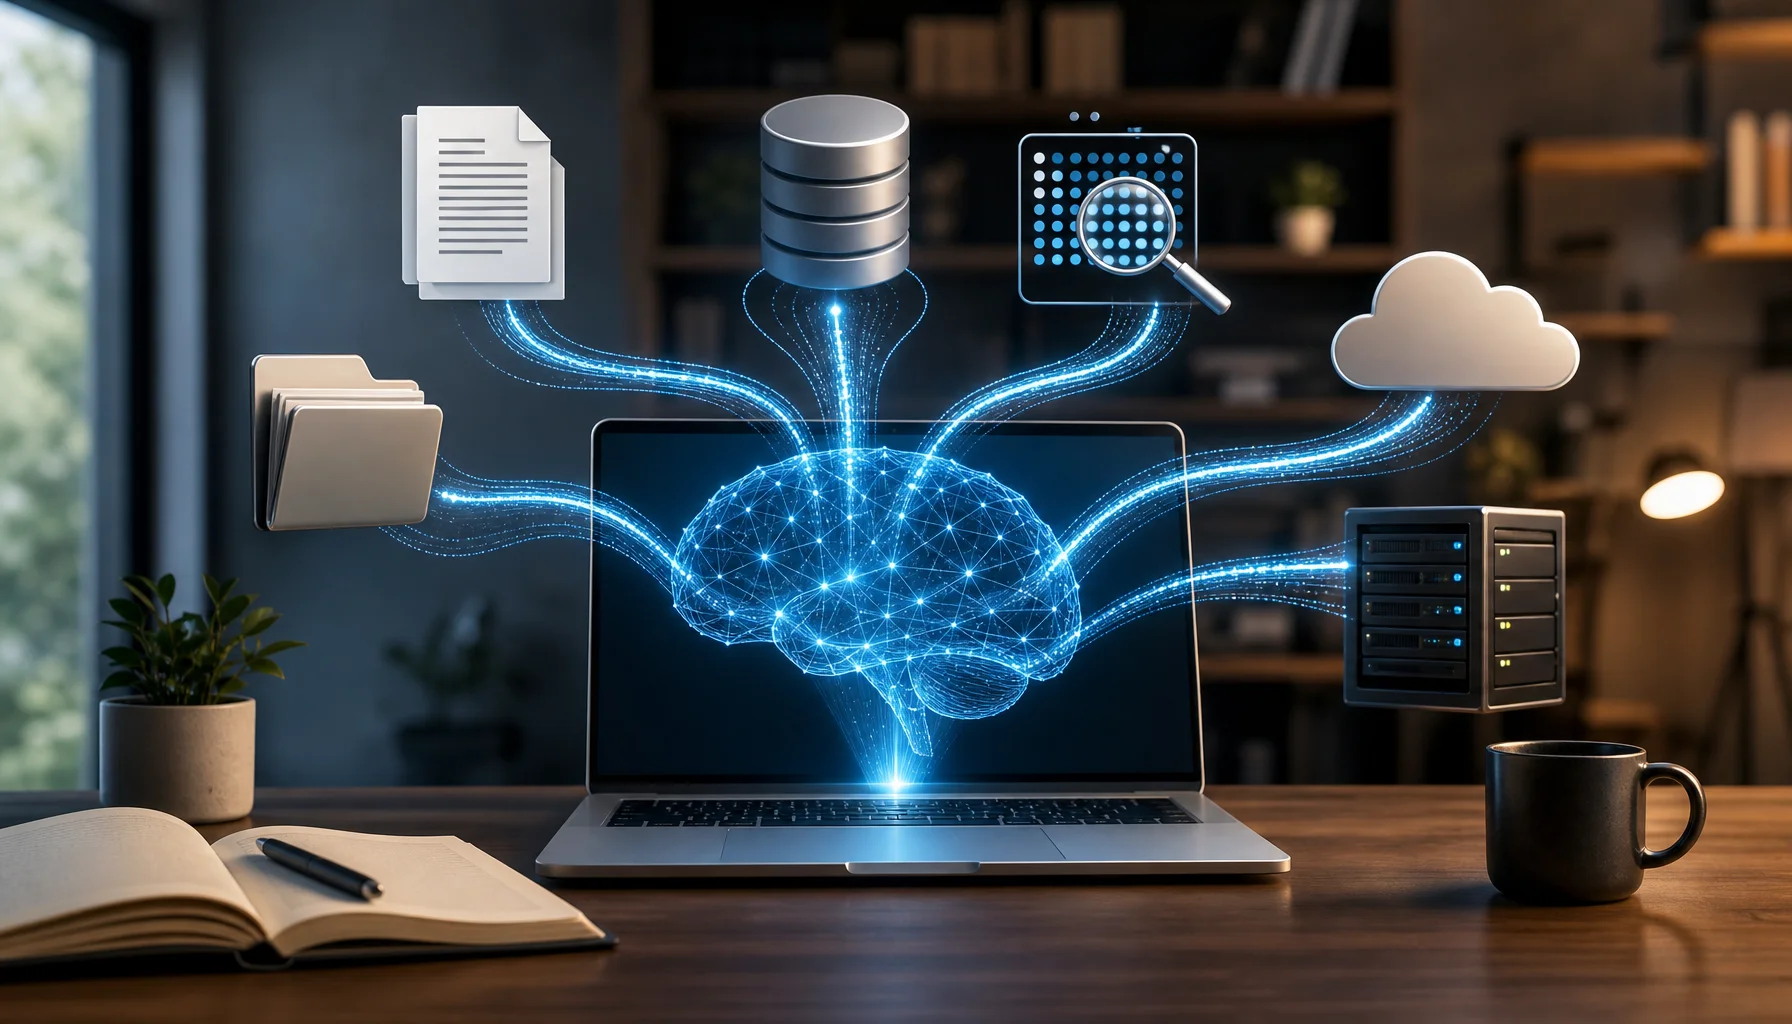
L'articolo precedente, Cos'è il RAG? La spiegazione più semplice di come funziona, ha stabilito il modello mentale: l'LLM scrive, il RAG recupera conoscenza utile, l'applicazione possiede lo stato corrente e gli strumenti eseguono azioni. Questo articolo fa il passo successivo: da dove provengono effettivamente i dati e come appare il recupero in Python?
La sorpresa importante è che una "fonte dati per LLM" di solito non è nulla di esotico. Può essere un file di testo, una cartella di documenti Markdown, un database SQL, una risposta API, un catalogo prodotti, un sistema di supporto o un indice vettoriale derivato da quelle fonti. L'IA non conosce magicamente questi sistemi. La tua applicazione deve caricare, interrogare, cercare o recuperare i dati rilevanti e inserire il risultato nel contesto del modello.
Fonte dati = dove risiedono le informazioni. Recupero = come l'applicazione trova informazioni utili. Contesto = le informazioni selezionate fornite al modello. LLM = il componente che interpreta quel contesto e genera una risposta.— Il modello in quattro parti utilizzato in tutto questo articolo
Domanda
Come utilizza un LLM dati esterni come file, database o API, e come può un piccolo programma Python implementare i passaggi essenziali del RAG senza nasconderli dietro un framework?
Cosa significa realmente
Quando gli sviluppatori dicono che un LLM è "collegato ai dati aziendali", diverse operazioni differenti possono nascondersi dietro quella frase. Un'applicazione può eseguire SQL. Un'altra può chiamare un'API. Un'altra può eseguire una ricerca full-text. Un'altra può calcolare la similarità degli embedding sui chunk di documenti. Tutte possono fornire informazioni esterne a un LLM, ma non sono lo stesso metodo di recupero e non dovrebbero essere trattate come intercambiabili.
Questa distinzione è importante perché il miglior metodo di recupero dipende dalla forma della domanda. "Qual è la nostra politica di rimborso?" è un problema di recupero di documenti. "Qual è lo stato attuale dell'ordine 4711?" è di solito una ricerca in un database strutturato. "Quale paragrafo discute il recupero dell'account?" può essere una ricerca per parole chiave o semantica. Il RAG è più utile quando il sistema deve scoprire conoscenza rilevante prima della generazione.
Esempio più semplice
Inizia con tre stringhe in Python ordinario. Non c'è ancora nessun database vettoriale, nessun framework e nessun LLM. Vogliamo solo rendere visibile il passaggio di recupero.
documents = [
    "The AKM uses 7.62 mm ammunition.",
    "A Med Kit restores health.",
    "A 4x scope can be attached to several compatible weapons."
]

question = "Which ammunition does the AKM use?"

for document in documents:
    if "AKM" in document:
        print(document)
Il programma stampa la prima frase perché contiene il termine che abbiamo cercato. Questo è un recupero primitivo, ma l'architettura è già visibile: domanda → ricerca → testo rilevante. Il RAG aggiunge un ulteriore passaggio importante: passare il testo recuperato a un modello linguistico insieme alla domanda.
Una versione leggermente più generale classifica i documenti in base alla sovrapposizione dei termini della query:
import re

documents = [
    {"id": "weapon-akm", "text": "The AKM uses 7.62 mm ammunition."},
    {"id": "healing-medkit", "text": "A Med Kit restores health."},
    {"id": "scope-4x", "text": "A 4x scope can be attached to several compatible weapons."},
]

def words(text):
    return set(re.findall(r"[a-zA-Z0-9.]+", text.lower()))

def retrieve(question, documents, top_k=2):
    query_terms = words(question)
    ranked = []

    for document in documents:
        score = len(query_terms & words(document["text"]))
        if score > 0:
            ranked.append((score, document))

    ranked.sort(key=lambda item: item[0], reverse=True)
    return [document for _, document in ranked[:top_k]]

question = "Which ammunition does the AKM use?"
hits = retrieve(question, documents)

for hit in hits:
    print(hit["id"], "->", hit["text"])
Questo non è un motore di ricerca di produzione. Ignora la morfologia, i sinonimi, le varianti ortografiche, la lunghezza dei documenti e molti segnali di ranking. Il suo valore è educativo: il RAG non inizia con un database vettoriale. Inizia con il recupero.
Dove l'esempio smette di funzionare
La corrispondenza esatta o lessicale diventa debole quando la domanda e la fonte usano parole diverse. Un documento può dire "manutenzione del veicolo", mentre l'utente chiede "come riparo la mia auto?" Un retriever lessicale può perdere la relazione anche se un umano la vede immediatamente. Il recupero semantico affronta questo problema rappresentando il testo come vettori e confrontando il significato anziché solo i token esatti.
I file lunghi creano un altro problema. Cercare un intero manuale di 80 pagine come un'unica unità è troppo grossolano, ma dividere ogni frase può distruggere il contesto utile. I sistemi RAG reali necessitano quindi di decisioni su parsing, chunking, metadati, ranking, freschezza, autorizzazioni e provenienza.
L'esempio non dice nulla nemmeno sui fatti strutturati in tempo reale. Se l'utente chiede lo stato attuale dell'ordine 4711 e l'applicazione ha già una chiave di database, la ricerca semantica è di solito lo strumento sbagliato come primo approccio. Una query deterministica al database è meglio.
Risposta diretta
Una fonte di dati per LLM è qualsiasi sistema esterno dal quale un'applicazione può ottenere informazioni per il modello: file, database, API, indici di ricerca, vector store o stato applicativo in tempo reale. RAG è il pattern di recuperare conoscenza rilevante da tali fonti prima della generazione.
In Python, la pipeline essenziale può essere molto piccola: caricare i dati → creare unità recuperabili → trovare prove rilevanti → assemblare il contesto → chiamare l'LLM. Il metodo di recupero dovrebbe corrispondere alla fonte e alla domanda. Usa SQL per fatti strutturati esatti, ricerca full-text per corrispondenza lessicale, embedding per similarità semantica e recupero ibrido quando diversi segnali sono preziosi.
Perché è così
Un modello linguistico non riceve automaticamente il contenuto del tuo filesystem, database PostgreSQL, CRM, API privata o documento appena modificato. L'applicazione decide quali informazioni esterne sono accessibili e cosa viene inserito nel contesto corrente del modello.
Il lavoro originale sulla Retrieval-Augmented Generation di Lewis et al. combinava un modello generativo con memoria esterna non parametrica recuperata da un indice vettoriale denso. L'idea architetturale più ampia sopravvive oltre quella specifica implementazione: le prove esterne possono essere recuperate al momento dell'inferenza invece di aspettarsi che tutta la conoscenza utile sia codificata nei parametri del modello.
Questo crea una separazione utile delle responsabilità: la fonte memorizza le informazioni, il retriever seleziona le prove, il contesto porta tali prove nella richiesta e il modello le interpreta. Mantenere visibili questi confini rende i fallimenti molto più facili da diagnosticare.
Contesto: i principali tipi di fonti di dati
| Fonte | Metodo di recupero tipico | Adatto per |
|---|---|---|
| TXT / Markdown / HTML | Parsing + ricerca lessicale o semantica | Documentazione, manuali, articoli, note |
| PDF / DOCX | Estrazione consapevole della struttura + ricerca | Politiche, report, contratti, manuali |
| Database SQL | Query SQL o recupero filtrato | Ordini, utenti, prodotti, record strutturati |
| API REST / GraphQL | Richiesta HTTP con parametri | Sistemi remoti e dati di servizi in tempo reale |
| Indice di ricerca | BM25 / full-text / ricerca ibrida | Grandi collezioni di testo |
| Indice vettoriale | Similarità di embedding | Recupero semantico di documenti |
| Stato applicativo | Lettura diretta dello stato o chiamata a tool | Ciò che è vero in questo momento |
Un indice vettoriale merita un'attenzione particolare. In molte architetture non è la fonte canonica di verità. È un indice di recupero derivato da documenti o record. Il documento autorevole può risiedere in object storage, un CMS, Git, PostgreSQL o un altro sistema, mentre embedding e metadati sono memorizzati separatamente per una ricerca semantica veloce. Alcuni sistemi usano effettivamente un vector store come storage primario, ma questa è una scelta architetturale piuttosto che un requisito del RAG.
Se il confine tra recupero, memoria persistente, stato corrente e contesto del modello non è ancora chiaro, vedi AI Agent Memory Is Not RAG. Quegli strati possono usare alcune delle stesse tecnologie di storage pur avendo regole di correttezza diverse.
Assunzioni
- All'applicazione è consentito accedere alla fonte esterna.
- La fonte rilevante contiene informazioni sufficienti per rispondere alla domanda.
- I dati possono essere analizzati o interrogati in una forma che il livello di recupero può utilizzare.
- Le informazioni recuperate sono abbastanza aggiornate per la decisione richiesta.
- Il modello riceve le prove selezionate nel suo contesto.
- L'autorizzazione è applicata prima che le prove protette raggiungano il modello.
- Il modello di generazione può comunque sbagliare anche quando il recupero è corretto.
Queste assunzioni contano perché il recupero non può compensare prove mancanti, versioni obsolete della fonte, parser rotti o accessi non autorizzati. Una pipeline RAG può essere affidabile solo quanto il percorso delle prove che la alimenta.
Variabili
| Variabile | Perché cambia il design |
|---|---|
| Struttura della fonte | Una tabella SQL, un PDF legale e un repository di codice sorgente richiedono strategie di recupero diverse |
| Tipo di domanda | Ricerca esatta, ricerca concettuale e ricerca multi-hop sono compiti diversi |
| Requisito di aggiornamento | Lo stato in tempo reale può richiedere query dirette invece di indici ricostruiti periodicamente |
| Dimensione del corpus | La ricerca in memoria può funzionare per centinaia di chunk ma non per collezioni molto grandi |
| Lingua | Il recupero multilingue richiede modelli e tokenizzazione adatti alle lingue effettive |
| Permessi | Il recupero deve filtrare in base ai diritti di accesso dell'utente corrente |
| Latenza e costo | Più fasi di recupero possono migliorare la qualità ma aggiungono costo di runtime e infrastruttura |
| Necessità di provenienza | I sistemi ad alta affidabilità necessitano di ID di origine, versioni e prove tracciabili |
Metodo diagnostico / decisionale
La prima decisione non è “Quale database vettoriale dovrei installare?” È: Che tipo di fatto sto cercando di recuperare?
| Tipo di domanda | Approccio preferito iniziale | Motivo |
|---|---|---|
| ID esatto o record corrente | SQL / ricerca per chiave / API | Accesso strutturato deterministico |
| Dizione esatta, codici, nomi | Ricerca full-text o per parole chiave | Precisione lessicale |
| Domanda concettuale sui documenti | Ricerca semantica vettoriale | Il significato può differire dalla formulazione |
| Conoscenza aziendale mista | Recupero ibrido + filtri sui metadati | Combina segnali lessicali e semantici |
| Stato corrente dell'applicazione | Accesso diretto allo stato/strumento | L'aggiornamento conta più della similarità dei documenti |
Un test utile è: So già quale record mi serve, o il sistema deve scoprire quale passaggio è rilevante? Se il record è noto, interrogarlo direttamente. Se la rilevanza deve essere scoperta, la ricerca diventa più importante.
Quando una risposta è sbagliata, diagnosticare la pipeline in ordine invece di cambiare immediatamente l'LLM:
- 1. Copertura delle fonti: L'informazione corretta esiste nell'insieme di fonti accessibili?
- 2. Aggiornamento: Quella versione è abbastanza recente per la domanda?
- 3. Parsing: Il contenuto rilevante è stato estratto correttamente?
- 4. Chunking: Le prove sono rimaste insieme alle condizioni che danno loro significato?
- 5. Recupero: Il chunk corretto appare tra i candidati?
- 6. Ranking: Le fonti più forti sono classificate sopra quelle più deboli o in conflitto?
- 7. Assemblaggio del contesto: L'applicazione ha effettivamente inviato le prove selezionate al modello?
- 8. Generazione: L'LLM ha utilizzato fedelmente le prove fornite?
- 9. Attribuzione: Ogni affermazione importante può essere ricondotta a una fonte?
Per un metodo più approfondito di debug in produzione, vedere RAG Failed — But Which Layer Actually Failed? A Diagnostic Method, che espande questa catena in livelli di errore testabili indipendentemente.
Evidenze
Il paper RAG di Lewis et al. ha formalizzato la generazione che si condiziona su una memoria esterna recuperata invece di affidarsi solo ai parametri del modello. Ciò fornisce la base concettuale per separare il generatore da una fonte di conoscenza recuperabile.
Sentence Transformers documenta la ricerca semantica come l'incorporamento del corpus e della query in uno spazio vettoriale e il recupero di elementi con alta similarità semantica. La sua API attuale distingue anche la codifica della query dalla codifica dei documenti per i compiti di recupero.
SQLite FTS5 dimostra l'altro lato dello spettro: il recupero full-text maturo può classificare i documenti senza embeddings. Questo è importante perché la ricerca lessicale rimane preziosa per identificatori, terminologia esatta e molti design di recupero ibrido.
La documentazione sugli embeddings di OpenAI descrive gli embeddings come rappresentazioni vettoriali numeriche utilizzate per la correlazione e la ricerca. Questo è un percorso di implementazione per il recupero semantico, non la definizione di RAG stesso.
Esempio reale 1: Una cartella di file di testo
Supponiamo che una directory chiamata knowledge/ contenga normali file di testo. Python può caricarli senza alcuna libreria AI.
from pathlib import Path

def load_text_files(folder="knowledge"):
    documents = []

    for path in Path(folder).glob("*.txt"):
        documents.append({
            "source": path.name,
            "text": path.read_text(encoding="utf-8")
        })

    return documents

documents = load_text_files()

for document in documents:
    print(document["source"], len(document["text"]))
Il filesystem è la fonte dati. La domanda successiva è quanto testo dovrebbe diventare un'unità recuperabile. Per documenti lunghi, cercare un intero file è spesso troppo grossolano. Ecco perché le pipeline RAG comunemente creano chunk.
Un chunker molto semplice
def chunk_text(text, max_chars=800):
    paragraphs = [p.strip() for p in text.split("\n\n") if p.strip()]

    chunks = []
    current = ""

    for paragraph in paragraphs:
        candidate = f"{current}\n\n{paragraph}".strip()

        if current and len(candidate) > max_chars:
            chunks.append(current)
            current = paragraph
        else:
            current = candidate

    if current:
        chunks.append(current)

    return chunks
Questo esempio raggruppa i paragrafi fino a raggiungere un limite approssimativo di caratteri. È intenzionalmente comprensibile piuttosto che ottimale. I sistemi di produzione spesso suddividono per token, intestazioni, sezioni, confini di frase o struttura del documento. Tabelle, codice sorgente, contratti e documentazione API possono richiedere strategie diverse.
Preservare la provenienza durante il chunking
def build_chunks(documents):
    chunks = []

    for document in documents:
        for index, text in enumerate(chunk_text(document["text"])):
            chunks.append({
                "id": f'{document["source"]}:{index}',
                "source": document["source"],
                "chunk": index,
                "text": text,
            })

    return chunks
Un chunk utile porta con sé più del semplice testo. Nome della fonte, ID del documento, URL, timestamp, versione o sezione possono in seguito supportare citazioni, debug e controlli di aggiornamento. Se la provenienza viene persa durante l'ingestion, diventa molto più difficile spiegare perché è stata prodotta una particolare risposta.
Esempio reale 2: Dati strutturati — Usa SQL quando SQL è lo strumento giusto
Non ogni fatto esterno dovrebbe passare attraverso la ricerca semantica. Se la domanda richiede un record corrente esatto, una query diretta al database è di solito più chiara e più deterministica.
import sqlite3

def get_order_status(order_id):
    connection = sqlite3.connect("shop.db")
    cursor = connection.cursor()

    cursor.execute(
        "SELECT status, total, currency FROM orders WHERE id = ?",
        (order_id,)
    )

    row = cursor.fetchone()
    connection.close()

    if row is None:
        return None

    return {
        "order_id": order_id,
        "status": row[0],
        "total": row[1],
        "currency": row[2],
    }

print(get_order_status(4711))
Se l'applicazione sa già che l'utente sta chiedendo dell'ordine 4711, incorporare l'intera tabella degli ordini e chiedere alla ricerca semantica di riscoprire quella riga di solito aggiunge complessità senza benefici. Una buona regola di progettazione è: recupera i fatti strutturati con query strutturate; recupera la conoscenza non strutturata con la ricerca.
La riga del database restituita può comunque essere inserita nel contesto del modello, così che l'LLM possa spiegarla in linguaggio naturale. Ma l'accesso diretto allo stato o a un record è concettualmente diverso dalla ricerca in un corpus di conoscenza.
Esempio reale 3: Ricerca full-text prima degli embedding
Tra un ingenuo ciclo Python e la ricerca vettoriale si colloca una classe matura di sistemi di recupero lessicale. SQLite include FTS5 per la ricerca full-text, incluso il ranking BM25.
import sqlite3

connection = sqlite3.connect("knowledge.db")
cursor = connection.cursor()

cursor.execute(
    "CREATE VIRTUAL TABLE IF NOT EXISTS docs USING fts5(title, body)"
)

cursor.execute(
    "INSERT INTO docs(title, body) VALUES (?, ?)",
    ("AKM", "The AKM uses 7.62 mm ammunition.")
)

connection.commit()

query = "AKM ammunition"

rows = cursor.execute(
    "SELECT title, body, bm25(docs) AS score "
    "FROM docs WHERE docs MATCH ? "
    "ORDER BY score LIMIT 5",
    (query,)
).fetchall()

for row in rows:
    print(row)

connection.close()
La ricerca lessicale è particolarmente utile quando contano terminologia esatta, codici prodotto, nomi, identificatori o parole specifiche del dominio. La ricerca semantica non è automaticamente migliore. I sistemi di produzione spesso combinano entrambi i segnali.
Esempio reale 4: Recupero semantico con gli embedding
Gli embedding trasformano il testo in vettori numerici, così passaggi semanticamente correlati possono essere confrontati anche quando non usano una formulazione identica. Sentence Transformers fornisce un'implementazione locale semplice.
# pip install sentence-transformers

from sentence_transformers import SentenceTransformer, util

documents = [
    "The AKM uses 7.62 mm ammunition.",
    "A Med Kit restores health.",
    "Vehicle maintenance includes checking oil, brakes and tires.",
    "Account recovery requires access to the registered email address."
]

model = SentenceTransformer(
    "sentence-transformers/multi-qa-mpnet-base-cos-v1"
)

document_embeddings = model.encode_document(
    documents,
    convert_to_tensor=True
)

question = "How do I repair my car?"

query_embedding = model.encode_query(
    question,
    convert_to_tensor=True
)

hits = util.semantic_search(
    query_embedding,
    document_embeddings,
    top_k=2
)[0]

for hit in hits:
    print(round(float(hit["score"]), 3), documents[hit["corpus_id"]])
La query non contiene la frase “manutenzione del veicolo”, ma un modello semantico può comunque classificare quel passaggio in alto perché i concetti sono correlati. Questa è la ragione pratica per cui gli embedding sono comuni nei sistemi RAG.
Per piccole collezioni, gli embedding possono rimanere in memoria. I sistemi più grandi di solito li persistono in un indice o database compatibile con i vettori ed eseguono lì la ricerca del vicino più prossimo. La memorizzazione cambia, ma la logica rimane: codifica la domanda, trova le rappresentazioni rilevanti dei documenti, restituisci le prove migliori.
Esempio reale 5: Costruire il contesto per l'LLM
Un retriever dovrebbe restituire delle prove. Il LLM dovrebbe quindi ricevere la domanda più quelle prove. Mantenere separati il recupero e la generazione rende entrambi più facili da ispezionare e testare.
def build_prompt(question, retrieved_documents):
    context = "\n\n".join(
        f'[{doc["id"]}] {doc["text"]}'
        for doc in retrieved_documents
    )

    return f"""
Answer the question using the supplied context.

Rules:
- Do not invent facts that are not supported by the context.
- If the context is insufficient, say so.
- Cite the source IDs you used.

Question:
{question}

Context:
{context}
""".strip()
L'istruzione non rende il modello infallibile. Crea semplicemente un confine esplicito delle prove. Il modello può comunque fraintendere prove valide, ignorare una condizione o generalizzare eccessivamente. Ecco perché la qualità del recupero e la qualità della generazione devono essere valutate separatamente.
Esempio reale 6: una pipeline minima completa
def answer_question(question, all_documents, call_llm):
    # 1. Retrieve evidence
    retrieved = retrieve(question, all_documents, top_k=3)

    # 2. Build model context
    prompt = build_prompt(question, retrieved)

    # 3. Generate the answer
    answer = call_llm(prompt)

    return {
        "answer": answer,
        "sources": [doc["id"] for doc in retrieved]
    }
La funzione riceve call_llm come dipendenza di proposito. Il recupero non dovrebbe interessarsi se la generazione è eseguita da un modello cloud, un modello locale o un altro provider. Il percorso dei dati appartiene all'applicazione.
Generatore opzionale: OpenAI Responses API
Un possibile generatore è l'OpenAI Responses API. Mantenere il nome del modello in una variabile d'ambiente evita di codificare in modo rigido un particolare modello nell'architettura RAG.
# pip install openai

import os
from openai import OpenAI

client = OpenAI()

def call_llm(prompt):
    response = client.responses.create(
        model=os.environ["OPENAI_MODEL"],
        input=prompt,
    )
    return response.output_text
La stessa pipeline di recupero può essere collegata a un server di inferenza locale. Questo è un punto architetturale importante: il RAG non è di proprietà del provider del LLM. L'applicazione possiede la fonte, il recupero e l'assemblaggio del contesto.
L'intera architettura in una sola vista
USER QUESTION
     |
     v
+-------------+
|  Retriever  |
+-------------+
   |       |
   |       +----> SQL / API / state query
   |
   +------------> keyword / full-text search
   |
   +------------> embedding / vector search
                     |
                     v
              relevant evidence
                     |
                     v
+-----------------------------------+
| question + evidence + instructions |
+-----------------------------------+
                     |
                     v
                   LLM
                     |
                     v
                  answer
Questo modello di flusso di dati è più duraturo che memorizzare un singolo framework. Le librerie, i database e i fornitori di modelli cambieranno; i confini delle responsabilità rimangono.
Idee sbagliate comuni e modalità di fallimento
“RAG significa database vettoriale.”
No. La ricerca vettoriale è un metodo di recupero. Il RAG può utilizzare ricerca full-text, SQL, API, grafi di conoscenza, ricerca vettoriale o combinazioni di essi. Il pattern che lo definisce è il recupero di informazioni esterne per la generazione.
“Se i dati sono in PostgreSQL, devo incorporare l'intero database.”
No. I record strutturati dovrebbero di solito rimanere interrogabili come record strutturati. Gli embedding sono utili per la rilevanza semantica, non come sostituto delle query deterministiche.
“Più chunk significa una risposta migliore.”
Non necessariamente. Un contesto extra può introdurre rumore, versioni in conflitto e materiale irrilevante. Il retrieval dovrebbe ottimizzare per prove utili, non per il volume massimo.
“Un punteggio di similarità elevato dimostra la risposta.”
No. La similarità misura la rilevanza, non la verità o l'applicabilità. Un passaggio altamente simile può essere obsoleto, provenire dalla versione sbagliata del prodotto o essere valido solo in condizioni che non corrispondono alla domanda.
“Una volta recuperato il chunk corretto, l'allucinazione è risolta.”
No. Il retrieval migliora il grounding ma non garantisce un ragionamento fedele. La generazione necessita comunque di valutazione, e i flussi di lavoro ad alto rischio possono richiedere validazione deterministica o revisione umana.
“Il modello ha fallito, quindi cambia il modello.”
Non necessariamente. La fonte corretta potrebbe essere mancante, analizzata in modo errato, suddivisa male, filtrata, classificata troppo in basso o omessa dal contesto assemblato. La sostituzione del modello non dovrebbe essere il primo passo diagnostico.
Casi limite
- Documenti in conflitto: due fonti possono discordare perché versioni, giurisdizioni o prodotti differiscono.
- Fatti sensibili al tempo: una fonte semanticamente rilevante può essere già obsoleta.
- Autorizzazioni: un retriever non deve restituire documenti a cui l'utente corrente non è autorizzato ad accedere.
- Collezioni multilingua: il modello di embedding e la strategia di retrieval devono supportare le lingue effettivamente utilizzate.
- Tabelle e codice sorgente: il chunking a paragrafi semplici può distruggere la struttura essenziale per la risposta.
- Identificatori molto brevi: il retrieval semantico può essere più debole della corrispondenza esatta per SKU, ID, codici di errore o acronimi.
- Domande lunghe che richiedono diversi fatti: il retrieval può richiedere decomposizione, diverse ricerche o reranking invece di una singola query top-k.
- Gerarchia delle fonti: una politica ufficiale corrente può dover prevalere su un documento di discussione più vecchio ma semanticamente più vicino.
Limitazioni
Gli esempi Python ottimizzano intenzionalmente per la trasparenza, non per la scalabilità. Il retriever per parole chiave è ingenuo, il chunker utilizza la lunghezza in caratteri, gli esempi SQLite non includono la gestione delle connessioni di produzione e l'esempio semantico mantiene tutti gli embedding in memoria.
Un sistema di produzione può richiedere indici vettoriali, reranker, retrieval ibrido, parser di documenti, caching, indicizzazione incrementale, versioning delle fonti, filtri di controllo degli accessi, osservabilità, dataset di valutazione e gestione degli errori. Nessuna di queste aggiunte cambia l'architettura principale; rendono ogni confine più affidabile.
Il RAG inoltre non può creare prove assenti dall'insieme delle fonti. Se la fonte è sbagliata, incompleta o obsoleta, un modello di embedding migliore non può trasformarla in conoscenza autorevole.
Cosa cambierebbe questa risposta?
L'architettura cambia quando il compito richiede più di una semplice ricerca di conoscenza. Uno stato dell'ordine in tempo reale necessita dello stato corrente. Un calcolo finanziario può richiedere codice deterministico. Un compito di ricerca web può richiedere ricerca attiva. Un flusso di lavoro può richiedere strumenti in grado di riscrivere dati su un altro sistema. Un agente autonomo può richiedere pianificazione, autorizzazioni e controllo dell'esecuzione oltre al retrieval.
Il RAG è quindi meglio inteso come uno strato di acquisizione di prove all'interno di un sistema AI più ampio. È potente proprio perché ha un compito ristretto: trovare informazioni esterne utili e collocarle nel contesto di lavoro del modello.
Conclusione
RAG diventa molto più facile da capire quando si rimuovono i nomi delle tecnologie. Un file è una fonte. Un database è una fonte. Un'API è una fonte. Una funzione di ricerca recupera le prove. Un prompt porta quelle prove al modello. L'LLM le interpreta e produce linguaggio.
La parte difficile del RAG in produzione non è chiamare un modello di embedding. È costruire un percorso di prove affidabile dalla fonte originale all'affermazione finale: preservare la provenienza, selezionare il metodo di recupero giusto, mantenere le informazioni aggiornate, controllare l'accesso, valutare il recupero separatamente dalla generazione e sapere quando una chiamata diretta a un database o a uno strumento è meglio della ricerca semantica.
Questa è la continuazione pratica del modello RAG di base: prima capire i ruoli, poi rendere esplicito il percorso dei dati.
Fonti primarie
- Lewis et al. — Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks — il paper del 2020 che introduce la formulazione RAG che combina la generazione con la memoria non parametrica recuperata.
- Sentence Transformers — Semantic Search — documentazione ufficiale per il recupero semantico, gli embedding delle query e gli embedding dei documenti.
- OpenAI — Vector Embeddings — documentazione ufficiale che descrive gli embedding come rappresentazioni numeriche usate per la correlazione e la ricerca.
- SQLite — FTS5 Extension — documentazione ufficiale per la ricerca full-text e il ranking BM25 in SQLite.
- OpenAI — SDKs and CLI — esempio ufficiale dell'SDK Python per la Responses API usato nell'esempio opzionale del generatore.
- What Is RAG? The Simplest Explanation of How It Works — la prima parte concettuale di questa serie.
Related Articles

Migrare dall'SDK OpenAI Agents all'API Agents: cosa cambia effettivamente a livello architetturale?
La migrazione dall'SDK OpenAI Agents alla nuova Agents API non è una semplice rinomina degli import. Il confine di runtime cambia: il ciclo dell'agente, la sessione durevole, l'orchestrazione, la compattazione del contesto e il ripristino si spostano verso un harness gestito. Questa guida mostra cosa dovrebbe essere spostato, cosa dovrebbe rimanere nella tua applicazione e come dimostrare la migrazione prima del passaggio.
Google I/O 2026: Prodotti agentici su Search, Workspace e Shopping
Google I/O 2026 ha mostrato che l'IA agentica sta andando oltre le demo dei modelli e gli strumenti per sviluppatori, entrando nelle superfici dei prodotti di tutti i giorni. Questo articolo analizza come Ricerca, Workspace, Gemini Spark e Universal Cart puntino verso un nuovo modello di prodotto in cui gli agenti di Google aiutano gli utenti a fare ricerche, lavorare, fare acquisti e agire attraverso i servizi connessi.
Architettura Canonica, Progettazione URL, Logica del Resolver, Specifiche API e Scalabilità
Architettura di scoperta geobasata per portali multi-tenant. Definisce URL canonici, logica di risoluzione, strategia di caching e un modello di lettura geografico senza accoppiamento con CMS o rifattorizzazione del database. Progettata per stabilità SEO, scalabilità ed estensioni future come prenotazioni e mappe.

La memoria dell'agente IA non è RAG: come separare memoria, recupero, stato e contesto
Memoria dell'agente, RAG, stato e contesto vengono spesso usati come se fossero intercambiabili. Non lo sono. Questo pratico modello architetturale separa i quattro livelli, mostra dove si colloca ciascuno e spiega cosa si rompe quando i sistemi li fanno collassare in uno solo.
Google I/O 2026: Gemini Omni, Gemini 3.5 e il livello di calcolo dietro l'IA agentica
Google I/O 2026 ha messo Gemini Omni e Gemini 3.5 al centro della strategia di IA agentica di Google. Questo articolo analizza la differenza tra creazione multimodale e intelligenza di livello d'azione, perché Gemini 3.5 Flash è importante per gli agenti e il coding, e come questi modelli alimentano il più ampio cambiamento di piattaforma di Google I/O 2026.
Guida completa a Evaluation Harness: Padroneggiare la valutazione delle prestazioni degli LLM
Questa guida fornisce una panoramica dettagliata di Evaluation Harness, un framework essenziale per valutare rigorosamente le capacità dei modelli linguistici di grandi dimensioni (LLM) nelle pipeline LLMOps aziendali. Scopri la configurazione, le best practice e le tecniche avanzate per garantire un benchmarking e un'ottimizzazione dei modelli affidabili.
Potenziare la Produttività con i Sistemi ERP: Un Caso di Studio sui Database Relazionali
L'integrazione dei sistemi ERP con database relazionali ha aumentato l'efficienza
Guida Definitiva ai Criteri di Accettazione per l'Adozione di LLM nei Playbook Aziendali
Padroneggia l'arte di definire criteri di accettazione precisi per garantire un'integrazione LLM di successo nel tuo ambiente aziendale. Questa guida completa fornisce framework attuabili, esempi e best practice su misura per l'adozione guidata da playbook.

Agenti per l'uso del computer: perché una demo di successo può comunque essere un sistema inaffidabile
Gli agenti computer-use possono ora completare impressionanti flussi di lavoro su browser e desktop, ma una singola esecuzione riuscita dimostra la capacità—non l'affidabilità. Questo articolo mostra come testare la ripetibilità, la robustezza ambientale, il controllo a lungo orizzonte, la consapevolezza dello stato, la verifica dei risultati e la gestione sicura degli obiettivi.

Affidabilità degli Agenti AI: Perché la Risposta Finale Non è Sufficiente
Un output corretto non dimostra un ragionamento corretto, un'esecuzione sicura o un sistema affidabile.
Google I/O 2026: Antigravity, AI Studio e il passaggio ai DevTools agentici
Google I/O 2026 ha reso chiara una cosa agli ingegneri: gli strumenti di IA stanno andando oltre l'autocompletamento, verso l'esecuzione agentica gestita. Questo articolo analizza Antigravity 2.0, il ruolo in espansione di Google AI Studio, Gemini 3.5 Flash e i reali compromessi relativi a orchestrazione, lock-in, verifica e progettazione del flusso di lavoro degli sviluppatori.

Cosa dovrebbe ricordare, dimenticare, ricalcolare o recuperare di nuovo un agente IA?
Gli agenti a lunga esecuzione non dovrebbero ricordare tutto. Questo articolo fornisce un modello pratico di ciclo di vita per decidere cosa appartiene alla memoria durevole, cosa dovrebbe essere recuperato di nuovo, cosa è più sicuro ricalcolare e cosa dovrebbe scadere o essere sostituito.