
Guida Definitiva ai Criteri di Accettazione per l'Adozione di LLM nei Playbook Aziendali
# Guida Definitiva ai Criteri di Accettazione per l'Adozione di LLM nei Playbook Aziendali
## Introduzione ai Criteri di Accettazione
I criteri di accettazione (AC) sono le condizioni definitive che devono essere soddisfatte affinché una funzionalità, una user story o un deliverable di progetto sia considerato completo. Nel contesto dell'adozione di LLM (Large Language Model) all'interno dei playbook aziendali, gli AC fungono da spina dorsale per misurare il successo, mitigare i rischi e garantire l'allineamento tra i team tecnici, operativi e di business.
A differenza dei requisiti vaghi, gli AC sono specifici, verificabili e binari: o sono soddisfatti o non lo sono. Colmano il divario tra obiettivi di alto livello e implementazione granulare, particolarmente cruciale per le integrazioni AI complesse dove gli esiti possono essere imprevedibili.
### Perché i Criteri di Accettazione Sono Importanti per l'Adozione di LLM - **Riduzione del Rischio**: Gli LLM introducono variabilità negli output; AC chiari prevengono il creep dello scope e i fallimenti di deployment. - **Allineamento degli Stakeholder**: Garantisce che product owner, sviluppatori, team QA ed executive condividano una comprensione comune. - **Progresso Misurabile**: Abilita lo sviluppo iterativo nei playbook agili. - **Compliance e Governance**: Critico per le aziende che gestiscono dati sensibili sotto regolamenti come GDPR o HIPAA.
## Principi Chiave per Scrivere Criteri di Accettazione Efficaci
Segui questi principi fondamentali per creare AC che facciano progredire i progetti LLM:
1. **Specificità**: Usa un linguaggio concreto evitando ambiguità (es. "95% di accuratezza" vs. "buone prestazioni"). 2. **Verificabilità**: Ogni criterio deve essere verificabile tramite test automatizzati, controlli manuali o metriche. 3. **Indipendenza**: I criteri devono essere autonomi senza dipendenze dagli altri. 4. **Completezza**: Coprire casi funzionali, non funzionali, edge case e modalità di fallimento. 5. **Prioritizzazione**: Distinguere tra must-have (formato Gherkin Given-When-Then) e nice-to-have.
## Formati Standard per i Criteri di Accettazione
### 1. Formato Gherkin (BDD) Ideale per i playbook LLM grazie alla sua leggibilità e compatibilità con l'automazione tramite strumenti come Cucumber.
**Esempio per la Risposta a Query LLM**:
Dato che un utente inserisce una query di analisi finanziaria Quando l'LLM la elabora con dati aziendali Allora la risposta deve: - Non contenere allucinazioni (verificate tramite API di fact-checking) - Raggiungere >90% di similarità semantica con la ground truth - Rispondere in meno di 5 secondi - Redigere automaticamente le PII
### 2. Formato Checklist Semplici elenchi puntati per una validazione rapida.
**Esempio per il Fine-Tuning di LLM**: - Perplessità del modello ridotta del 20% dopo il fine-tuning - Punteggio di bias < 0.05 tra le diverse demografie - Costo di inferenza per query < $0.01 - 99.9% di uptime nell'ambiente di staging
### 3. Formato Basato su Regole Per scenari aziendali complessi.
**Regola**: SE la query contiene dati proprietari E il punteggio di confidenza < 0.8 ALLORA inoltra a un revisore umano ALTRIMENTI approva automaticamente.
## Template di Criteri di Accettazione per le Fasi di Adozione di LLM
### Fase 1: Proof of Concept (PoC) Focus sulla fattibilità.
- L'LLM genera risposte che corrispondono all'80% dei casi di test di benchmark - L'integrazione con le API interne ha successo nel 95% delle chiamate - La scansione sulla privacy dei dati passa senza perdite - Il team conduce la demo con <5% di domande irrisolte
### Fase 2: Distribuzione pilota Enfatizzare scalabilità e feedback degli utenti.
- 100 utenti simultanei con latenza media <2s - Punteggio di soddisfazione utente >4/5 da oltre 50 sondaggi - RAG personalizzato (Retrieval-Augmented Generation) recupera documenti rilevanti nei primi 3 risultati nell'85% dei casi - Procedura di rollback testata con successo due volte
### Fase 3: Distribuzione completa in produzione Prioritizzare robustezza e ROI.
- Costo per 1K token inferiore alla soglia aziendale - Il test A/B mostra un aumento del 25% della produttività - Il monitoraggio automatizzato avvisa su derive/anomalie entro 1 minuto - Audit di conformità certificato da terzi
## Passi pratici per definire e implementare gli AC
1. **Collaborare nelle sessioni di raffinamento**: Coinvolgere ingegneri LLM, esperti di dominio e utenti finali in workshop di un'ora. 2. **Collegare ai KPI aziendali**: Associare gli AC a metriche come tempo per insight o riduzione degli errori. 3. **Sfruttare gli strumenti**: - Jira/Confluence per la documentazione - LangSmith o Weights & Biases per il tracciamento LLM - Prometheus/Grafana per il monitoraggio delle prestazioni 4. **Testare presto e spesso**: Integrare gli AC nelle pipeline CI/CD con test unitari per prompt e valutazioni. 5. **Rivedere e iterare**: Retrospettive post-sprint per raffinare gli AC in base agli apprendimenti. 6. **Documentare i casi limite**: Definire esplicitamente i comportamenti per allucinazioni, bias o query fuori dominio.
## Errori comuni e come evitarli
- **AC troppo rigidi**: Bilanciare precisione e flessibilità per la natura probabilistica dell'IA—usare soglie, non assoluti. - **Ignorare i requisiti non funzionali**: Includere sempre sicurezza, prestazioni e manutenibilità. - **Trascurare le personas utente**: Adattare gli AC ai ruoli (es. gli executive necessitano di riepiloghi concisi; gli analisti necessitano di tracce dettagliate). - **Scope creep**: Usare il metodo MoSCoW (Must, Should, Could, Won't) per prioritizzare.
| Errore | Sintomo | Soluzione | |--------|---------|-----| | Metriche vaghe | "Abbastanza veloce" | Definire: latenza p95 <3s | | Nessuna modalità di fallimento | Presuppone input perfetti | Aggiungere: Gestione corretta dei prompt avversari | | Disallineamento del team | Dispute nelle demo | Pre-approvazione da parte degli stakeholder |
## Esempi reali dai playbook LLM aziendali
### Caso di studio: Automazione del supporto clienti **User Story**: Come agente di supporto, voglio che l'LLM classifichi i ticket in modo da potermi concentrare sui casi ad alto valore.
**AC**: - Classificare l'urgenza dei ticket con F1-score del 92% - Suggerire 3 passi di risoluzione con citazioni - Escalare accuratamente il 10% dei casi agli umani - Registrare ogni interazione nel log per la conformità
**Risultato**: Risoluzione più veloce del 40%, aumento del 15% del CSAT.
### Caso di studio: Recupero della conoscenza interna **User Story**: Come nuovo assunto, voglio interrogare i documenti tramite LLM per l'onboarding.
**AC**: - Recuperare da oltre 10K documenti con recall@5 dell'88% - Gestire query multilingue - Bloccare le query su sezioni riservate - Il ciclo di feedback migliora il modello settimanalmente
## Misurare il successo oltre gli AC
Gli AC sono punti di controllo, non endpoint. Monitorare metriche longitudinali: - **Tasso di adozione**: % della forza lavoro che usa gli strumenti LLM - **ROI**: (Valore creato - Costi) / Costi - **Salute del modello**: Rilevamento di derive, test A/B
Esegui audit regolari ed evolvi i criteri di accettazione del tuo playbook per adattarti ai progressi degli LLM, come i modelli multimodali o i flussi di lavoro agentici.
## Conclusione
Criteri di accettazione solidi trasformano l'adozione degli LLM da sperimentale a di livello enterprise. Incorporandoli nei tuoi playbook, garantisci un'IA affidabile e scalabile che fornisce valore tangibile. Inizia con i template, itera senza sosta e osserva il successo delle tue iniziative.
Related Articles

Migrare dall'SDK OpenAI Agents all'API Agents: cosa cambia effettivamente a livello architetturale?
La migrazione dall'SDK OpenAI Agents alla nuova Agents API non è una semplice rinomina degli import. Il confine di runtime cambia: il ciclo dell'agente, la sessione durevole, l'orchestrazione, la compattazione del contesto e il ripristino si spostano verso un harness gestito. Questa guida mostra cosa dovrebbe essere spostato, cosa dovrebbe rimanere nella tua applicazione e come dimostrare la migrazione prima del passaggio.
erstellen-eines-benutzerdefinierten-gpt-4-plugins-in-wordpress
Invarianza del prompt: la conclusione sopravvive al prompt?
Una metodologia pratica per verificare se una conclusione dell'IA dipenda dal modo in cui è stato inquadrato un problema. Prompt Invariance confronta formulazioni originali, cieche, invertite e avversarie, mantenendo controllata la struttura delle evidenze.
Laravel 12 CMS Personalizzato con Filament 3: Il Workflow degli Esperti
Un'analisi dettagliata delle sinergie tra Laravel 12 e Filament 3 per la creazione di sistemi di gestione dei contenuti personalizzati. Esperti analizzano il flusso di lavoro innovativo, vantaggi, svantaggi e la sfida del flusso di lavoro di Jetstream.

Agenti per l'uso del computer: perché una demo di successo può comunque essere un sistema inaffidabile
Gli agenti computer-use possono ora completare impressionanti flussi di lavoro su browser e desktop, ma una singola esecuzione riuscita dimostra la capacità—non l'affidabilità. Questo articolo mostra come testare la ripetibilità, la robustezza ambientale, il controllo a lungo orizzonte, la consapevolezza dello stato, la verifica dei risultati e la gestione sicura degli obiettivi.
Guida Completa alle Metriche per la Consegna e la Gestione del Cambiamento
Questa guida fornisce una panoramica dettagliata delle metriche essenziali per la delivery aziendale e la gestione del cambiamento, aiutando i team a misurare le prestazioni, ottimizzare i processi e promuovere il miglioramento continuo. Scopri gli indicatori chiave, i metodi di calcolo e le best practice per allineare le tue metriche ai risultati aziendali.
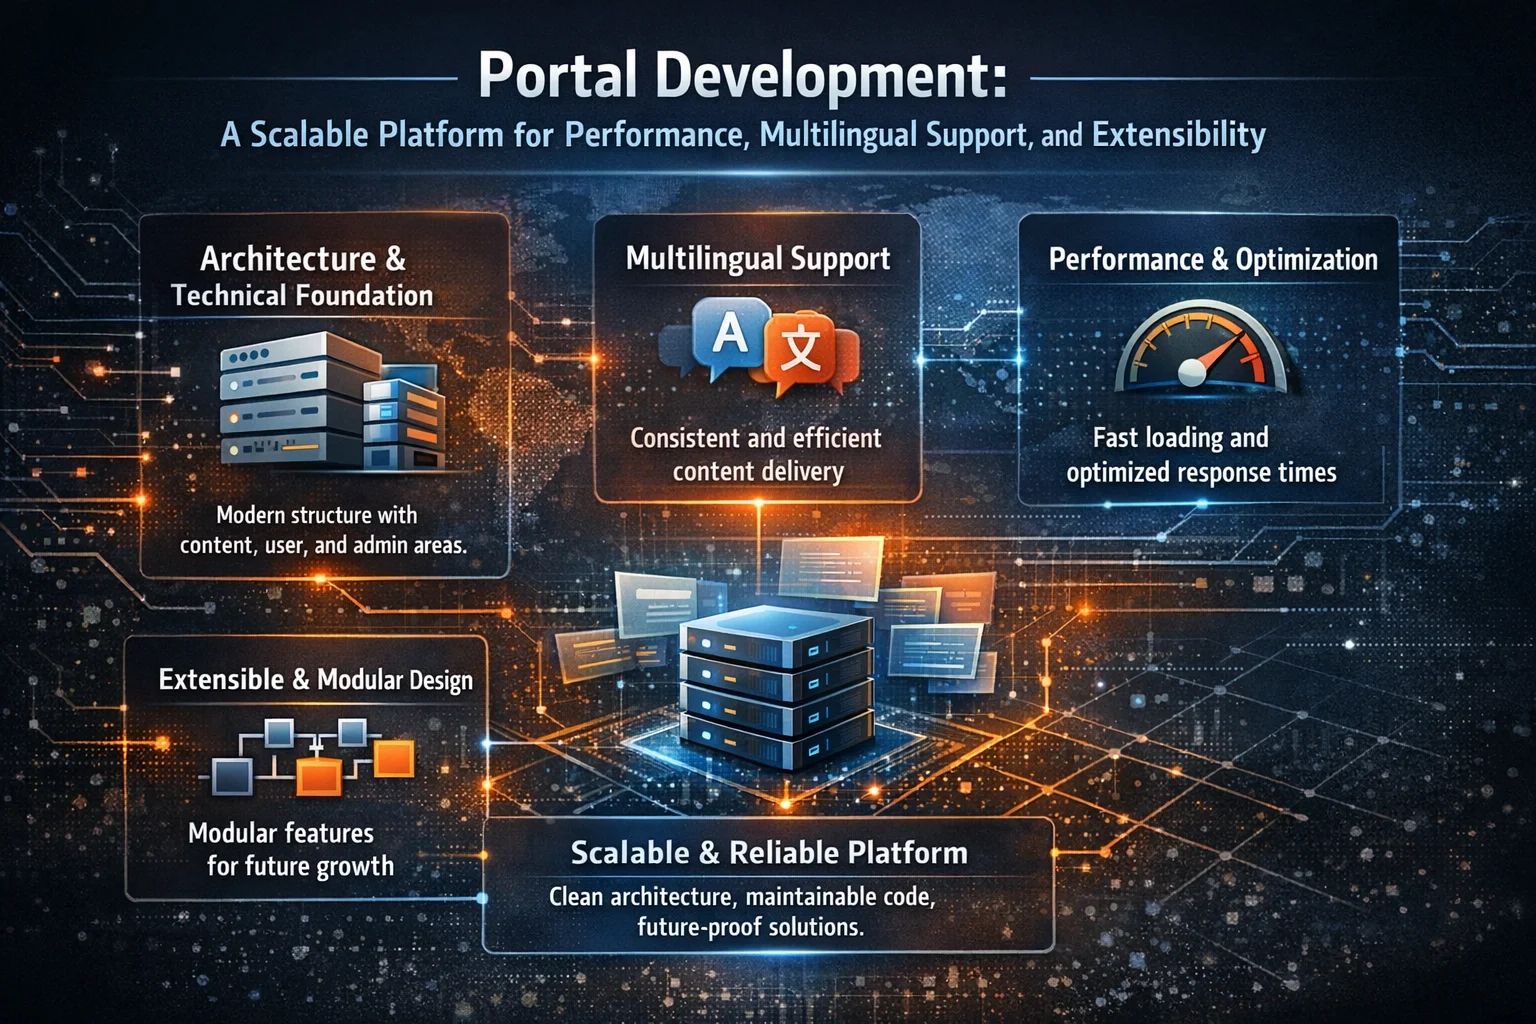
Sviluppo di Portali: Una Piattaforma Scalabile per le Prestazioni, il Supporto Multilingue e l'Estensibilità
Un moderno portale web in costruzione si concentra su architettura pulita, alte prestazioni, scalabilità
Come installare PHP 8.3 su Ubuntu 22.04
Guida aggiornata all'installazione di PHP 8.3 su Ubuntu 22.04, inclusa l'integrazione con Apache e Nginx (PHP-FPM), le estensioni e l'esecuzione di più versioni di PHP affiancate.
Ottimizzare la Qualità del Codice: Test con ESLint e Prettier
Nello sviluppo software moderno, mantenere una qualità e uno stile del codice coerenti è fondamentale. ESLint e Prettier offrono una potente combinazione per automatizzare questi aspetti cruciali, assicurando che le codebase siano pulite, leggibili e aderiscano agli standard definiti. Questo articolo approfondisce come questi strumenti si integrano perfettamente nei flussi di lavoro di testing, migliorando la produttività degli sviluppatori e la manutenibilità del progetto.
Recensione firmware ZBT Z8102AX OpenWrt 21.02: abbastanza stabile, ma è a prova di futuro?
Lo ZBT Z8102AX esegue una build di OpenWrt 21.02 modificata dal produttore con kernel 5.4.246. Nei test pratici, il firmware ha funzionato con successo e ha mantenuto il router stabile per diversi giorni, ma la vecchia base solleva importanti interrogativi su sicurezza, controllo del modem, percorsi di aggiornamento e manutenibilità a lungo termine.
Trascinamento e rilascio con JavaScript: Una analisi approfondita dell'API nativa per strutture di menu interattivi
L'implementazione della funzionalità di trascinamento e rilascio (drag and drop) è fondamentale per le moderne interfacce utente interattive. Questo articolo esamina la sua implementazione tecnica utilizzando l'API nativa HTML5 Drag-and-Drop in Vanilla JavaScript e TypeScript, con un focus sulla creazione di strutture di menu dinamiche.
Rimuovi fonti di pacchetti APT duplicate: Guida per esperti per Ubuntu e Debian
Una guida dettagliata per l'identificazione e la rimozione di fonti ridondanti o duplicate di pacchetti APT in sistemi Debian e Ubuntu, per garantire stabilità e prestazioni.