
MLOps vs LLMOps: cosa cambia quando il modello è un LLM
MLOps è la disciplina ingegneristica per sviluppare, distribuire, versionare e gestire in modo affidabile i sistemi di machine learning; LLMOps estende tale disciplina alle applicazioni costruite attorno a modelli linguistici di grandi dimensioni, dove il comportamento in produzione dipende non solo da un artefatto del modello ma anche da prompt, contesto, retrieval, versioni di provider/modello, chiamate a strumenti, controlli di sicurezza e pipeline di valutazione. LLMOps non sostituisce MLOps. Cambia l'unità operativa da "un modello più pipeline di serving" verso "un'applicazione LLM in evoluzione il cui comportamento emerge da diversi componenti che cambiano indipendentemente".
Cosa significa realmente MLOps
MLOps applica disciplina di ingegneria del software e operativa ai sistemi di machine learning. La sfida produttiva è più ampia dell'addestramento di un modello: raccolta dati, validazione dei dati, sperimentazione, riproducibilità, valutazione del modello, distribuzione, infrastruttura e monitoraggio devono tutti funzionare insieme.
La guida architetturale MLOps di Google inquadra la disciplina attorno a integrazione continua, distribuzione continua e addestramento continuo. La CI valida non solo il codice ma anche dati, schemi e modelli; la CD distribuisce pipeline ML e servizi di predizione; la CT può riaddestrare e ridistribuire modelli al variare di dati o implementazioni.
La guida AWS aggiunge le stesse preoccupazioni operative da un'altra angolazione: lineage del modello, tracciabilità modello/versione, monitoraggio del drift e monitoraggio della qualità in produzione sono parti centrali per mantenere affidabili i sistemi ML dopo la distribuzione.
Cosa cambia quando il modello è un LLM
I modelli linguistici di grandi dimensioni cambiano il problema produttivo perché l'applicazione spesso non possiede l'intero ciclo di vita dell'addestramento del modello. Un team può chiamare un'API di modello ospitato, eseguire un modello aperto localmente, passare tra provider o usare diversi modelli per compiti diversi.
Il modello è quindi solo una dipendenza versionata all'interno di un sistema comportamentale più ampio. Prompt, risultati di retrieval, ordine del contesto, strumenti, snapshot del modello, impostazioni di temperatura/ragionamento, filtri di sicurezza e orchestrazione runtime possono tutti cambiare l'output.
Questo crea una domanda operativa più ampia: quale combinazione di modello, contesto, dati, prompt, strumenti e runtime ha prodotto questo comportamento? LLMOps esiste per rendere tale domanda rispondibile e la risposta sufficientemente riproducibile per il lavoro ingegneristico.
L'esempio più semplice
Supponiamo che un'applicazione risponda a domande sulle politiche interne.
In un inquadramento ML classico, potresti versionare un classificatore addestrato, distribuirlo e monitorare la qualità delle predizioni. In un'applicazione LLM, la risposta potrebbe dipendere da uno snapshot di modello ospitato, un prompt di sistema, un modello di embedding, un indice vettoriale, filtri di retrieval, un reranker e il contesto finale selezionato.
Cambiare uno qualsiasi di questi componenti può cambiare la risposta finale anche se l'endpoint dell'applicazione e la domanda dell'utente restano identici.
Un tipico percorso di rilascio LLMOps
Dove si ferma l'esempio semplice
Alcuni sistemi LLM addestrano ancora o mettono a punto i propri modelli, quindi le pratiche MLOps tradizionali come pipeline di addestramento, registro dei modelli e lineage dei dati rimangono direttamente rilevanti.
Altri sistemi utilizzano solo API di modelli di fondazione esterni e non eseguono mai addestramento continuo. Il loro principale carico di lavoro operativo è la valutazione dell'applicazione, la gestione dei cambiamenti di modello/provider, il versionamento di prompt/contesto, la qualità del retrieval e l'osservabilità.
Non esiste quindi un'unica 'pipeline LLMOps' universale. Il ciclo di vita esatto dipende dal fatto che si addestri, si metta a punto, si ospiti autonomamente, si recuperi conoscenza esterna, si eseguano agenti o si dipenda da API di modelli gestiti.
MLOps vs LLMOps
Cosa rimane uguale e cosa si espande
| MLOps | LLMOps | |
|---|---|---|
| Unità operativa primaria | ||
| Proprietà del modello | ||
| Cambiamento tipico | ||
| Valutazione | ||
| Monitoraggio in produzione | ||
| Addestramento continuo | ||
| Artefatti versionati | ||
| Obiettivo di rollback |
LLMOps estende MLOps invece di sostituirlo
I principi operativi fondamentali non scompaiono: controllo del codice sorgente, CI/CD, riproducibilità, lineage, controlli di distribuzione, monitoraggio, rollback e criteri di accettazione misurabili rimangono essenziali.
L'estensione è che più artefatti che definiscono il comportamento ora risiedono al di fuori dei pesi del modello. Un modello di fondazione gestito può cambiare comportamento tramite aggiornamenti di snapshot, mentre l'output dell'applicazione può cambiare tramite modifiche di prompt o retrieval senza alcun riaddestramento del modello.
Questo è il motivo per cui la gerarchia utile è solitamente DevOps → MLOps → LLMOps/GenAIOps come preoccupazioni operative sempre più specializzate, non tre pratiche mutuamente esclusive.
Cosa deve essere versionato in LLMOps?
| Artefatto | Perché è importante |
|---|---|
| Codice dell'applicazione | Definisce orchestrazione, convalida, tentativi e comportamento aziendale |
| Famiglia di modelli + snapshot/versione | Snapshot diversi possono produrre comportamenti diversi |
| Provider / endpoint | Cambia flusso di dati, latenza, limiti, prezzi e disponibilità |
| Codice di prompt/istruzioni | Cambia il comportamento del modello anche con lo stesso modello |
| Parametri di generazione/ragionamento | Possono alterare determinismo, latenza, profondità e costo |
| Dataset di valutazione | Definisce rispetto a cosa viene testato il 'sufficientemente buono' |
| Scorer / grader | Definiscono come viene misurata la qualità |
| Modello di embedding | Cambia la rappresentazione vettoriale e il comportamento di retrieval |
| Configurazione di chunking/indice | Cambia ciò che può essere recuperato |
| Reranker / fusione di retrieval | Cambia l'ordinamento dei risultati |
| Schemi degli strumenti | Cambiano ciò che il modello può richiedere e come |
| Profilo di autorizzazione | Cambia quali azioni degli strumenti possono effettivamente essere eseguite |
| Regole di assemblaggio del contesto | Cambiano quali prove e stato raggiungono il modello |
| Configurazione di sicurezza/guardrail | Cambia il comportamento consentito o bloccato |
Gli snapshot dei modelli diventano dipendenze di rilascio
Con gli LLM ospitati, il team potrebbe non controllare l'addestramento del modello, ma controlla ancora quale modello o snapshot l'applicazione chiama.
Le attuali linee guida API di OpenAI avvertono esplicitamente che il comportamento del prompting può cambiare tra snapshot del modello e raccomandano di fissare le applicazioni di produzione a snapshot specifici dove la coerenza è importante, quindi eseguire valutazioni durante l'aggiornamento.
La conseguenza operativa è semplice: gli aggiornamenti del modello dovrebbero essere trattati come rilasci dell'applicazione, non come manutenzione invisibile dell'infrastruttura.
Il ciclo di vita del provider diventa parte delle operazioni
Le applicazioni LLM spesso dipendono dai limiti di velocità dei provider, dalle pianificazioni di deprecazione, dalla semantica delle API, dai limiti di contesto, dalle regole di gestione dei dati e dai prezzi.
Un provider può deprecare un modello mentre il codice della tua applicazione rimane invariato. L'attuale pianificazione di deprecazione di OpenAI, ad esempio, include date di ritiro nel 2026 per snapshot di modelli più vecchi e superfici della piattaforma.
LLMOps necessita quindi di tracciamento del ciclo di vita del provider, test di migrazione e decisioni di fallback oltre al monitoraggio della qualità del modello.
I prompt si comportano come codice di produzione
I prompt sono configurazione comportamentale eseguibile. Piccole modifiche possono alterare la qualità dell'output, la selezione degli strumenti e l'interpretazione delle policy.
L'attuale guida di OpenAI raccomanda di archiviare i prompt di produzione nel codice dell'applicazione, rivedere le modifiche ai prompt tramite pull request, utilizzare input tipizzati e coprire le modifiche con test e controlli di valutazione.
Ciò rende il versionamento dei prompt meno simile alla modifica di testi di marketing e più simile alla modifica di una funzione il cui output è probabilistico e dipendente dal modello.
L'ingegneria del contesto diventa una preoccupazione operativa
Il modello di produzione raramente riceve solo un prompt statico. Può ricevere cronologia della conversazione, documenti recuperati, output di strumenti, memoria, stato corrente dell'applicazione e istruzioni di policy.
LLMOps deve quindi osservare l'assemblaggio del contesto: quali prove sono state selezionate, quale versione dello stato era corrente, se si è verificato un troncamento e se istruzioni importanti sono sopravvissute alla compattazione.
Una regressione del modello e una regressione del contesto possono apparire identiche nella risposta finale. Tracciare il percorso effettivo del contesto è ciò che consente al team di distinguerle.
Il RAG crea il proprio ciclo di vita operativo
Un sistema RAG introduce una seconda pipeline di produzione accanto all'inferenza del modello: acquisizione, estrazione, chunking, metadati, embedding, indici, recupero, reranking e selezione del contesto.
Il corpus di conoscenza può cambiare ogni giorno anche quando il modello e il prompt non cambiano. Un indice obsoleto o un filtro di metadati non funzionante può quindi degradare la qualità delle risposte senza alcun drift del modello.
LLMOps per RAG dovrebbe tracciare versione del corpus/indice, modello di embedding, policy di chunking, configurazione del recupero, freschezza delle fonti e metriche di recupero separatamente dalla qualità della generazione.
Le valutazioni sostituiscono “mi sembra buono” con prove di rilascio
Gli output generativi sono spesso aperti, quindi i test di corrispondenza esatta sono insufficienti per molti compiti. LLMOps aggiunge set di dati di valutazione e scorer che possono misurare il successo del compito, la correttezza, la sicurezza, la fondatezza, lo stile o criteri di accettazione specifici del dominio.
L'attuale stack di valutazione GenAI di MLflow supporta dataset di valutazione versionati, confronti tra prompt/modelli, scorer personalizzati e valutazione su tracce complete.
La pratica più solida è lo sviluppo guidato dalla valutazione: definire casi rappresentativi e criteri di accettazione prima o insieme alle modifiche, poi confrontare le release rispetto alle stesse evidenze.
LLM-as-a-judge è utile ma non è ground truth
I giudici LLM possono scalare la valutazione per qualità costose da codificare come asserzioni deterministiche, come rilevanza, tono o groundedness.
Tuttavia, il giudice è un altro modello con il proprio bias, versione e prompt. La configurazione del giudice dovrebbe quindi essere versionata e calibrata rispetto a casi di riferimento umani o deterministici dove le conseguenze contano.
Una valutazione di produzione può combinare controlli deterministici, metriche basate su riferimento, giudici modello e revisione umana invece di chiedere a una singola metrica di rappresentare ogni dimensione di qualità.
Il tracing diventa più importante dei log degli endpoint
I log API tradizionali possono dirti che una richiesta ha impiegato due secondi e ha restituito HTTP 200. Non possono dirti quali chunk recuperati sono stati selezionati, quale strumento ha chiamato l'agente o quale span del modello ha consumato più token.
L'attuale tracing GenAI di MLflow cattura prompt, retrieval, chiamate agli strumenti e span dell'applicazione, e il suo flusso di valutazione in produzione può valutare informazioni di traiettoria intermedie invece del solo testo finale.
Questo è un cambiamento importante nel LLMOps: l'osservabilità segue il grafo comportamentale dell'applicazione, non solo l'endpoint di serving.
Gli agenti espandono il LLMOps in operazioni runtime
Un'applicazione agentica può eseguire diverse chiamate al modello, invocazioni di strumenti e transizioni di stato prima di produrre un risultato.
Operare agenti richiede quindi conteggi dei passaggi, tracce delle chiamate agli strumenti, dinieghi di autorizzazione, retry, rilevamento di loop, approvazioni umane e stato finale verificato, oltre alle ordinarie metriche di latenza del modello e token.
Una risposta finale corretta può nascondere una traiettoria sbagliata, quindi la valutazione dell'agente deve ispezionare il percorso oltre al risultato.
Token, chiamate al modello e contesto diventano variabili di costo
Il costo di inferenza ML classico è spesso dominato dall'infrastruttura di serving o dal calcolo per predizione. Le applicazioni LLM possono aggiungere prezzi per token del provider, chiamate ripetute agli agenti, chiamate di embedding, reranking e overhead di strumenti/runtime.
Il costo deve quindi essere attribuito al task o alla traccia, non solo a un endpoint. Un workflow che effettua otto chiamate nascoste al modello può essere funzionalmente corretto ma operativamente inaccettabile.
La latenza si comporta allo stesso modo: latenza del modello, retrieval, reranking e strumenti esterni si compongono nella latenza end-to-end percepita dall'utente.
La cache diventa semantica, non solo tecnica
I sistemi LLM possono memorizzare in cache prompt, embedding, risultati di retrieval o risposte complete, ma la chiave di cache deve riflettere la semantica che può cambiare il risultato.
Una cache delle risposte che ignora versione del modello, tenant, permessi o freschezza delle fonti può restituire una risposta tecnicamente valida ma semanticamente non valida.
LLMOps tratta quindi l'invalidazione della cache come parte del versioning di modello/contesto/dati, non solo come ottimizzazione infrastrutturale.
Sicurezza e permessi diventano criteri di rilascio
I sistemi generativi possono produrre testo illimitato e gli agenti possono attivare azioni esterne. I test di sicurezza sono quindi più vicini a un normale CI/CD rispetto a molti sistemi classici di ML predittivo.
Controlli dei permessi, test di prompt-injection, test di isolamento tra tenant e approvazioni degli effetti collaterali dovrebbero essere test di regressione riproducibili dove tali rischi esistono.
Il modello può suggerire un'operazione, ma il runtime deve comunque applicare l'autorizzazione. LLMOps possiede l'evidenza che tali controlli continuano a funzionare dopo modifiche a modello, prompt o strumenti.
Come appare la CI in LLMOps
| Livello CI | Esempi di controlli |
|---|---|
| Codice | Unit test, type check, validazione dello schema |
| Prompt | Rendering del template, variabili richieste, testo delle policy, revisione degli snapshot |
| Modelli/provider | Compatibilità, schema di output, test di capacità e regressione |
| RAG | Fixture di chunking, test dei filtri, Recall@k, regressione del reranker |
| Strumenti | Test dello schema di input/output, test dei permessi, test di idempotenza |
| Agenti | Fixture di traiettoria, limiti di loop, test di handoff/selezione degli strumenti |
| Sicurezza | Prompt injection, strumenti non autorizzati, test negativi cross-tenant |
| Valutazioni comportamentali | Successo del task, correttezza, grounding, sicurezza, criteri di dominio |
| Operativo | Latenza, budget di token/costo, comportamento di timeout/fallback |
Come appare la CD in LLMOps
Un rilascio in produzione può non distribuire alcun nuovo artefatto del modello. Può semplicemente rilasciare un nuovo prompt, una configurazione di retrieval, un set di strumenti o una mappatura dei provider.
Il bundle di rilascio dovrebbe quindi identificare la configurazione completa che definisce il comportamento, non solo l'immagine del container dell'applicazione.
Feature flag, rollout graduale, valutazione shadow, traffico canary e rollback sono utili perché il comportamento degli LLM può regredire in modi che i test di contratto statici non rilevano.
L'addestramento continuo diventa opzionale; la valutazione continua diventa centrale
Il MLOps tradizionale spesso enfatizza l'addestramento continuo quando nuovi dati o il drift giustificano un riaddestramento.
Molte applicazioni LLM non addestrano mai il modello di base. Il loro equivalente ciclo continuo è la valutazione continua: raccogliere fallimenti e casi di produzione rappresentativi, aggiungerli ai dataset di valutazione, testare modifiche candidate a prompt/modello/retrieval e ridistribuire solo quando le prove migliorano.
Il fine-tuning può reintrodurre un ciclo di vita di addestramento, ma dovrebbe inserirsi nello stesso più ampio processo di valutazione e rilascio.
Cosa dovrebbe essere monitorato in produzione?
| Classe di segnale | Esempi |
|---|---|
| Salute del sistema | Errori, timeout, disponibilità dell'endpoint |
| Modello/provider | ID modello, snapshot, limiti di frequenza, errori del provider |
| Latenza | End-to-end, modello, retrieval, span di tool e reranker |
| Costo | Token di input/output, embedding, spesa per tool/API |
| Qualità | Successo del task campionato, correttezza, rilevanza, groundedness |
| RAG | Proxy di recall del retrieval, retrieval vuoto, fonti obsolete, copertura delle citazioni |
| Agenti | Selezione dei tool, retry, loop, handoff, frequenza di approvazione |
| Sicurezza | Azioni negate, indicatori di prompt-injection, fallimenti dei confini tra tenant |
| Feedback utente | Correzioni, abbandono, escalation, valutazioni esplicite |
| Drift delle modifiche | Modifiche a provider/modello/configurazione rispetto al rilascio approvato |
Le tracce di produzione possono diventare dati di valutazione
Uno dei pattern LLMOps moderni più utili è trasformare tracce di produzione campionate in record di valutazione.
MLflow attualmente supporta il recupero di tracce di produzione e la valutazione non solo degli output ma anche di span intermedi come le traiettorie di retrieval o di chiamata ai tool.
Questo chiude il ciclo tra osservabilità e sviluppo: i fallimenti reali possono diventare casi di regressione nel rilascio successivo invece di sparire nei log.
La riproducibilità diventa condizionale anziché esatta
La riproducibilità classica del ML spesso mira a ricreare un modello da codice, dati, ambiente e parametri di addestramento versionati.
Le applicazioni LLM ospitate non possono sempre riprodurre un output identico token per token perché la generazione è probabilistica e i provider possono controllare l'infrastruttura.
LLMOps mira quindi a una riproducibilità comportamentale: registrare abbastanza modello/provider/versione, prompt, input di contesto, stato del retrieval e configurazione di runtime per riprodurre le condizioni e validare il comportamento entro tolleranze attese.
La lineage si espande dalla lineage del modello alla lineage dell'applicazione
La guida MLOps di AWS considera la lineage del modello come la storia di codice, dati, modello e artefatti infrastrutturali necessari per diagnosi e riproducibilità.
Per le applicazioni LLM, la lineage dovrebbe inoltre collegare prompt, dataset di valutazione, versioni di retrieval/indice, schemi dei tool, configurazione di agente/runtime e snapshot di provider/modello.
La domanda target diventa: quale esatta configurazione dell'applicazione ha prodotto questa traccia?
Il routing multi-provider e multi-modello crea policy operative
Una volta che un'applicazione può usare diversi provider o modelli locali, il routing diventa una policy operativa anziché una semplice stringa di modello.
Il routing può dipendere da capacità, latenza, costo, privacy, lunghezza del contesto, disponibilità, supporto degli strumenti o località. Un fallback può preservare l'uptime modificando la qualità delle risposte o le ipotesi sul trattamento dei dati.
LLMOps dovrebbe quindi registrare quale route è stata effettivamente selezionata e valutare le route in modo indipendente, invece di trattare ogni endpoint compatibile come comportamentalmente intercambiabile.
Evidenza dell'implementazione originale
Aaasaasa AI Client: provider, modello e runtime sono oggetti operativi separati
Aaasaasa AI Client separa agente/client, provider, modello, posizione del runtime e permessi. Il suo AI Hub supporta Ollama, LM Studio/endpoint compatibili con OpenAI e altri protocolli dei provider, invece di trattare "il modello" come un'unica impostazione globale.
L'implementazione include il rilevamento dinamico dei modelli locali, lo streaming, l'output di thinking e controlli espliciti di warm/load e unload di Ollama. Questa è evidenza operativa che il serving locale di LLM introduce preoccupazioni sul ciclo di vita delle risorse che vanno oltre il nome di un modello API.
Lo stato del provider viene interrogato tramite adapter dei provider, e i tipi di connessione distinguono percorsi locali, API cloud, basati su account, remote-agent e web-client. Queste sono dimensioni operative concrete che una piattaforma consapevole degli LLM deve rendere visibili.
Il repository preserva anche un confine importante: un runtime locale non è automaticamente inferenza locale. Provider/modello/posizione del runtime sono questioni versionate o configurabili che influenzano privacy, latenza, costo e disponibilità.
Source of Truth Research Engine: lo stato dell'applicazione LLM si estende oltre il modello
Il Source of Truth Research Engine combina ricerca lessicale, embedding opzionali, snapshot delle fonti, identità SHA-256, claim, provenienza e tracciamento delle contraddizioni attorno alla ricerca assistita da modelli locali.
Questa è utile evidenza LLMOps perché cambiare solo il modello non definisce il sistema di ricerca. Retrieval, acquisizione delle fonti, classificazione delle evidenze e provenienza persistente sono artefatti operativi indipendenti.
L'implementazione tratta deliberatamente la similarità semantica come scoperta e non come evidenza, mostrando perché l'osservabilità LLMOps dovrebbe distinguere il comportamento di retrieval dalla validità dei claim.
| Implementazione osservata | Lezione LLMOps |
|---|---|
| Protocolli multi-provider | L'identità del provider è una dipendenza operativa |
| Rilevamento dinamico dei modelli | I modelli disponibili possono cambiare indipendentemente dal codice dell'applicazione |
| Controlli load/unload di Ollama | I modelli locali hanno un ciclo di vita di memoria/risorse |
| Adapter di salute/stato del provider | La disponibilità del modello richiede osservabilità del runtime |
| Posizione separata di runtime e inferenza | La topologia di deployment non è un unico booleano "locale/cloud" |
| Permessi centralizzati | Capacità del modello e autorità degli strumenti devono rimanere separate |
| Pipeline di retrieval lessicale + semantico | La configurazione del retrieval fa parte del comportamento dell'applicazione |
| Persistenza di fonte/provenienza | Lo stato operativo e le evidenze vivono al di fuori dei pesi del modello |
Modalità di fallimento comuni in LLMOps
| Modalità di fallimento | Cosa è effettivamente andato storto |
|---|---|
| Alias del modello aggiornato silenziosamente | Il comportamento è cambiato senza un rilascio controllato |
| Prompt modificato senza eval | Una regressione comportamentale ha superato i normali unit test |
| Indice RAG obsoleto | Il modello di generazione è stato incolpato per un fallimento di retrieval/dati |
| Viene registrata solo la risposta finale | La causa radice nella traiettoria di retrieval/strumenti/contesto è invisibile |
| Il fallback del provider è silenzioso | Un diverso modello/percorso dati cambia il comportamento senza attribuzione |
| Costo dei token tracciato globalmente | I workflow costosi non possono essere localizzati |
| Modello giudice cambiato | I punteggi di valutazione derivano senza modifiche all'applicazione |
| Le tracce di produzione non diventano mai test | I fallimenti noti ritornano ripetutamente |
| Il modello locale rimane caricato indefinitamente | La pressione su VRAM/risorse diventa instabilità operativa |
| Permessi codificati solo nel prompt | Il comportamento del modello viene scambiato per autorizzazione |
| Un unico punteggio di eval controlla tutto | Dimensioni di qualità diverse vengono collassate in un numero fuorviante |
| Esiste il registro dei modelli ma non le versioni di prompt/indice | La lineage dell'applicazione rimane incompleta |
Idee sbagliate comuni
| Idea sbagliata | Correzione |
|---|---|
| "LLMOps sostituisce MLOps." | LLMOps estende i principi MLOps al comportamento applicativo specifico degli LLM. |
| "LLMOps è prompt engineering." | I prompt sono un artefatto tra modelli, provider, contesto, retrieval, strumenti, eval e runtime. |
| "Le API hosted eliminano il lavoro operativo." | Eliminano parte del lavoro di serving/training dei modelli ma aggiungono gestione del ciclo di vita del provider, delle versioni e delle dipendenze. |
| "Se l'API è stabile, l'app è stabile." | Il comportamento del modello e gli snapshot di provider/modello possono cambiare indipendentemente dallo schema dell'API. |
| "RAG è solo preprocessing dei dati." | In produzione ha il proprio ciclo di vita di ingestione, indice, retrieval e freschezza. |
| "Gli output degli LLM non possono essere testati." | Possono essere valutati con criteri deterministici, di riferimento, giudice e umani. |
| "I giudici LLM sono ground truth oggettiva." | Sono valutatori basati su modelli che richiedono anch'essi calibrazione e controllo di versione. |
| "Un modello locale elimina LLMOps." | Il serving locale aggiunge file di modello, VRAM, load/unload, salute del runtime e preoccupazioni di aggiornamento. |
| "Osservabilità significa conteggi di token." | L'osservabilità utile segue prompt, retrieval, strumenti, span del modello e risultati. |
| "Il training continuo è obbligatorio." | Molte app LLM usano valutazione continua senza addestrare il modello di base. |
Una sequenza pratica di progettazione LLMOps
Gestire l'intero sistema che produce comportamento
Checklist di architettura LLMOps
| Domanda | Evidenza attesa |
|---|---|
| Quale modello/provider/versione ha servito la richiesta? | Identità del modello tracciabile |
| Quali prompt/istruzioni erano attivi? | Codice/configurazione dell'applicazione versionati |
| Quale contesto ha raggiunto il modello? | Traccia di contesto/retrieval |
| Quale versione di corpus/indice è stata usata? | Lineage del retrieval |
| Quali strumenti erano disponibili e sono stati chiamati? | Schema degli strumenti + traccia della traiettoria |
| Quali permessi si applicavano? | Registro di autorizzazione a runtime |
| Come viene misurata la qualità? | Dataset di valutazione versionato + scorer |
| Come vengono testati gli aggiornamenti del modello? | Suite di regressione comportamentale |
| Come viene campionata la qualità in produzione? | Processo di valutazione delle tracce/feedback |
| Si può riprodurre approssimativamente un singolo fallimento? | Lineage di modello/contesto/provider/applicazione |
| Dove viene speso il costo? | Attribuzione per traccia di modello/strumenti/retrieval |
| Cosa attiva il rollback? | Soglia definita di qualità/sicurezza/costo/disponibilità |
| Come vengono gestite le deprecazioni dei provider? | Processo di migrazione/fallback |
| Come vengono gestiti i modelli locali? | Controlli di salute, risorse, caricamento/scaricamento e versione |
Casi limite e limitazioni
Un'applicazione semplice che chiama un unico modello hosted fisso senza retrieval o strumenti può richiedere solo un LLMOps leggero: codice dei prompt versionato, valutazioni, pinning del modello, tracing di base e monitoraggio del provider.
Un modello fine-tuned self-hosted può richiedere quasi l'intero stack MLOps classico più la valutazione applicativa specifica per LLM, rendendo il confine tra MLOps e LLMOps intenzionalmente sfumato.
Una piattaforma di agenti può avere operazioni minime di addestramento del modello ma operazioni di runtime sostanziali, perché i fallimenti si verificano nella selezione degli strumenti, nello stato e nell'orchestrazione.
Un sistema fortemente basato su RAG può essere operativamente dominato dall'ingestione dei documenti e dalla qualità del retrieval piuttosto che dal serving del modello.
La terminologia continuerà a evolversi. La domanda architetturale duratura non è quale etichetta “Ops” vince, ma quali artefatti producono comportamento e quindi devono essere versionati, valutati, osservati e governati.
Cosa cambierebbe questa risposta?
Se i provider di foundation model standardizzassero un comportamento del modello perfettamente stabile e un supporto di versione a lungo termine, la gestione di provider/snapshot potrebbe diventare meno significativa a livello operativo.
Se le applicazioni assumessero sempre più la proprietà del fine-tuning o dell'addestramento, le preoccupazioni classiche del MLOps tornerebbero più centrali.
Il principio operativo rimarrebbe: ogni componente che può modificare materialmente il comportamento in produzione appartiene a lineage, testing, osservabilità e controllo dei cambiamenti.
Conoscenza canonica correlata
LLMOps si colloca sotto AI Governance e Enterprise AI Architecture: la governance definisce quali cambiamenti richiedono evidenze e approvazione, mentre LLMOps fornisce il macchinario operativo per versionare, valutare, distribuire e osservare tali cambiamenti.
Context Engineering e RAG sono sottodomini operativi all'interno di molte applicazioni LLM, perché contesto e retrieval possono cambiare il comportamento indipendentemente dal modello.
Agentic AI estende ulteriormente LLMOps verso operazioni su traiettoria, permessi e runtime degli strumenti.
Domande frequenti
FAQ su MLOps vs LLMOps
Qual è la differenza tra MLOps e LLMOps?
LLMOps sostituisce MLOps?
Le applicazioni LLM necessitano di addestramento continuo?
Perché le valutazioni sono così importanti in LLMOps?
Cosa dovrebbe essere versionato in LLMOps?
Il versioning dei prompt è sufficiente?
Cos'è GenAIOps?
Come si monitora un'applicazione LLM?
Gli LLM locali possono usare pratiche LLMOps?
Glossario
Termini chiave di MLOps e LLMOps
- MLOps
- Pratiche ingegneristiche per costruire, distribuire, monitorare e mantenere sistemi di machine learning e il loro ciclo di vita di dati/modelli.
- LLMOps
- Pratiche operative per applicazioni in produzione il cui comportamento dipende materialmente da grandi modelli linguistici e dai circostanti prompt, contesto, recupero, strumenti e runtime.
- GenAIOps
- Disciplina operativa per applicazioni di AI generativa; spesso usata come etichetta più ampia o alternativa per LLMOps.
- Addestramento continuo
- Riaddestramento e serving automatizzati o ripetuti di modelli ML al variare dei dati o delle implementazioni.
- Valutazione continua
- Valutazione ripetuta del comportamento AI candidato e in produzione rispetto a dataset e criteri versionati.
- Snapshot del modello
- Una versione concreta di un modello ospitato o pacchettizzato il cui comportamento può essere testato e referenziato.
- Lineage dell'applicazione
- Relazione tracciabile tra codice, modello/provider, prompt, dati/recupero, strumenti, runtime e configurazione di rilascio.
- Traccia
- Registro strutturato di una esecuzione dell'applicazione contenente span come chiamate al modello, recuperi e operazioni degli strumenti.
- Dataset di valutazione
- Set versionato di input rappresentativi, aspettative e opzionalmente tracce/output usati per misurare il comportamento.
- Giudice LLM
- Un modello linguistico usato come valutatore per criteri qualitativi o semantici; è esso stesso una dipendenza di valutazione versionata.
- Regressione comportamentale
- Un degrado nell'output o nella traiettoria dell'applicazione nonostante interfacce e codice continuino a essere eseguiti con successo.
- Routing dei provider
- Politica per selezionare tra provider/endpoint di modelli disponibili in base a capacità, costo, latenza, privacy o disponibilità.
Conclusione
MLOps e LLMOps condividono lo stesso obiettivo ingegneristico: rendere i sistemi AI abbastanza riproducibili, testabili e osservabili da operare in modo affidabile in produzione.
La differenza è la forma del sistema. Il MLOps classico spesso si concentra sull'addestramento e sul serving di artefatti del modello; LLMOps deve operare uno stack comportamentale in cui snapshot del modello, prompt, contesto, recupero, strumenti, permessi e provider possono cambiare indipendentemente.
La regola utile più breve è: versiona, valuta e osserva tutto ciò che può cambiare materialmente il comportamento dell'applicazione LLM — non solo il modello.
Fonti primarie e documentazione corrente
Le fonti seguenti fondano la base MLOps e i pattern operativi correnti per applicazioni LLM e agenti. Le sezioni del progetto sono prove di implementazione originali e sono intenzionalmente più ristrette rispetto alle affermazioni su una piattaforma LLMOps completa.
Google Cloud — MLOps: pipeline di continuous delivery e automazioneArchitettura di riferimento che descrive CI, CD, addestramento continuo, registro dei modelli, metadati, serving e monitoraggio per sistemi ML.
AWS Machine Learning Lens — Lineage del modelloGuida corrente per tracciare codice, dati, modelli, ambienti e infrastruttura attraverso le release ML.
AWS Machine Learning Lens — Osservabilità e tracciamento del modelloGuida corrente per monitoraggio dei modelli in produzione, drift, salute degli endpoint e lineage.
Microsoft Azure — Ciclo di vita GenAIOps / LLMOpsGuida ufficiale che descrive GenAIOps, talvolta chiamato LLMOps, attraverso inizializzazione, sperimentazione, valutazione/raffinamento e distribuzione.
MLflow — Agenti e applicazioni LLMDocumentazione corrente sulle operazioni GenAI che copre tracciamento, valutazione, prompt e osservabilità in produzione per applicazioni LLM e agenti.
MLflow — Valutazione delle tracce di produzioneGuida corrente per valutare tracce complete LLM/agente, incluse traiettorie di recupero e chiamate agli strumenti.
MLflow — Valutazione dei promptFlusso di lavoro attuale per la valutazione di prompt/modelli utilizzando prompt versionati, dataset, scorer e trace.
OpenAI API — Versionamento e snapshot dei modelliLinee guida attuali dell'API che raccomandano versioni dei modelli bloccate e valutazioni poiché il comportamento dei prompt può cambiare tra gli snapshot.
OpenAI — PromptingLinee guida attuali che suggeriscono di trattare i prompt di produzione come codice applicativo, versionarli tramite il controllo del codice sorgente e coprire le modifiche con test e verifiche di valutazione.
OpenAI — DeprecazioniEvidenza attuale del ciclo di vita del fornitore che mostra il ritiro di modelli e superfici della piattaforma come dipendenza operativa.
OpenAI — Migrazione dei flussi di lavoro di valutazione a PromptfooLinee guida attuali del 2026 sulla migrazione che illustrano perché gli asset di valutazione dovrebbero rimanere portabili al variare degli strumenti del fornitore.
Related Articles
Ollama non è il prodotto: costruire applicazioni Open-LLM pronte per la produzione
Eseguire un modello locale con Ollama è facile. Costruire un'applicazione Open-LLM pronta per la produzione è più difficile: richiede RAG, controllo degli accessi, astrazione del provider, valutazione, logging, disciplina di deployment e un livello applicativo controllato attorno al modello.
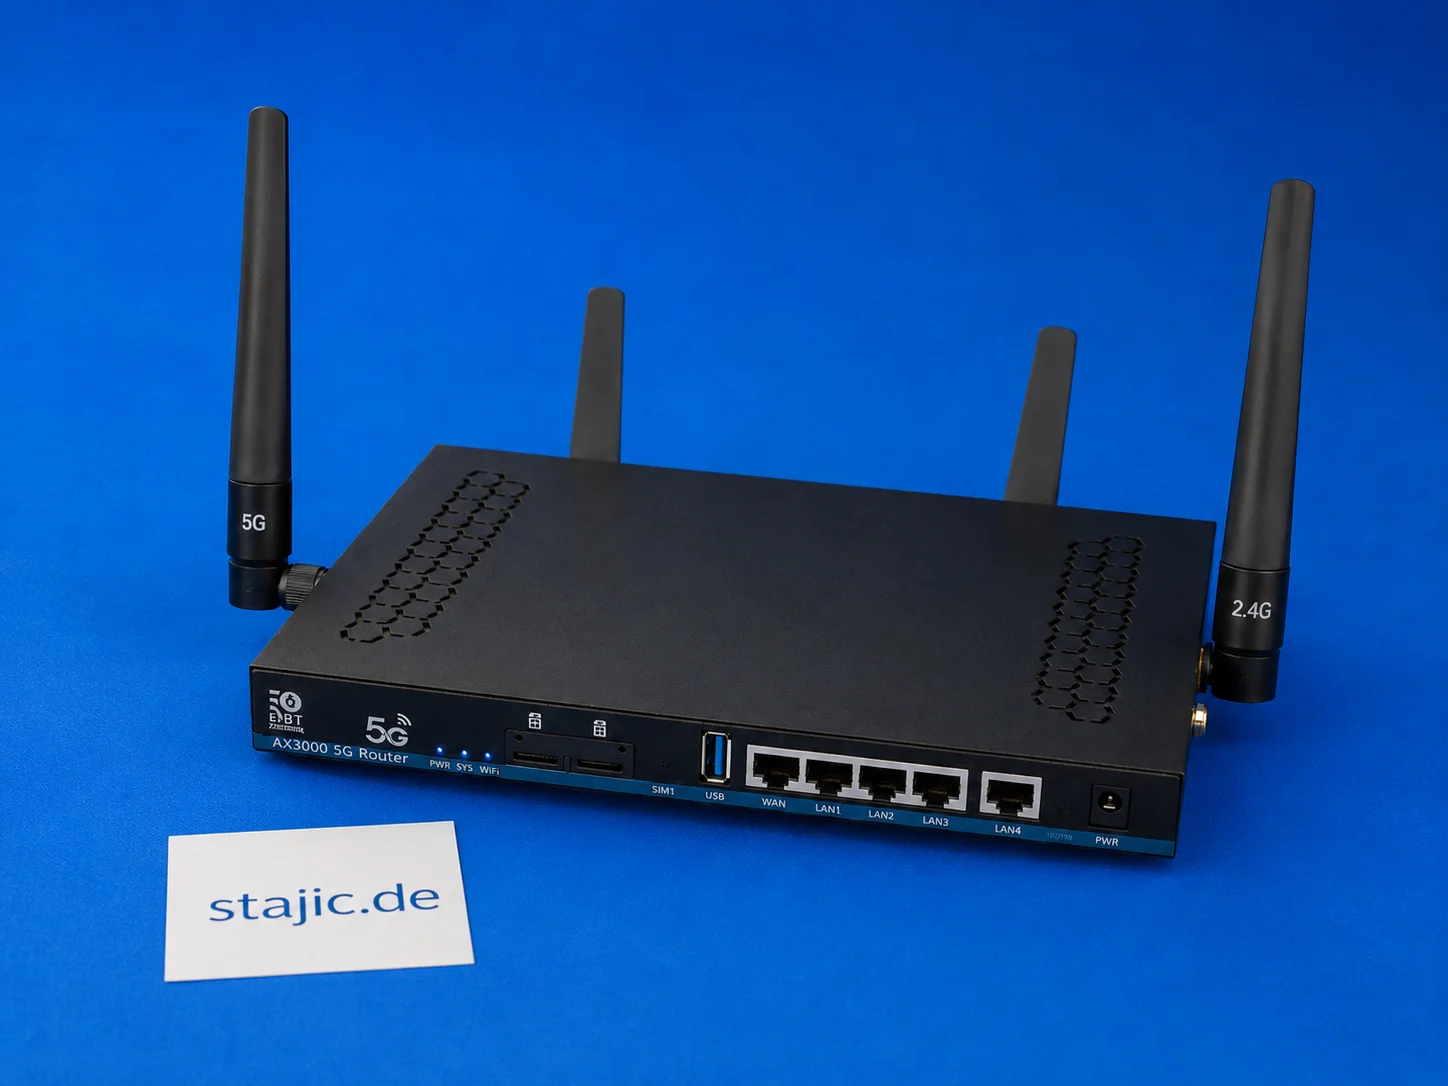
ZBT Z8102AX Failover Dual-SIM: cosa funziona, cosa manca e cosa necessita di un firmware migliore
Lo ZBT Z8102AX è un router OpenWrt 5G dual-SIM, ma l'hardware dual-SIM da solo non è la stessa cosa di un failover intelligente. Il router riconosce la SIM e si connette con successo, ma la commutazione automatica, il ripristino del modem, le decisioni basate sul segnale e una logica di failover pulita richiedono ancora test più approfonditi.
Harness per agenti gestito vs loop per agenti self-hosted: cosa si guadagna, cosa si perde
“Agente self-hosted” può indicare architetture molto diverse. Questa guida separa l'harness gestito, l'ambiente di esecuzione self-hosted e il loop dell'agente completamente autogestito—e mostra quale perimetro di controllo serve effettivamente ai team.

Da dove prende i dati un LLM? Fonti di dati RAG in Python
Un LLM non conosce magicamente i tuoi file, database o API. Questa continuazione pratica della serie RAG mostra, con semplice Python, come i dati esterni diventano prove recuperabili: dai file di testo e SQL alla ricerca full-text, agli embedding, all'assemblaggio del contesto e alla chiamata finale all'LLM.
Nuovo Qwen 3.5-Plus: l'IA open-source fa sul serio
Scopri le caratteristiche e i vantaggi all'avanguardia di Qwen 3.5-Plus di Alibaba, un'IA open-source rivoluzionaria per gli sviluppatori.

Che cos'è l'ingegneria del contesto? Ciò che il modello riceve prima di rispondere
L'ingegneria del contesto progetta quali informazioni un modello di IA riceve prima dell'inferenza, inclusi prompt, recupero, memoria, stato dell'applicazione, risultati degli strumenti e cronologia delle conversazioni.
git-with-automatic-upload-and-synchronization-to-a-production-server
Agenti per l'uso del computer: perché una demo di successo può comunque essere un sistema inaffidabile
Gli agenti computer-use possono ora completare impressionanti flussi di lavoro su browser e desktop, ma una singola esecuzione riuscita dimostra la capacità—non l'affidabilità. Questo articolo mostra come testare la ripetibilità, la robustezza ambientale, il controllo a lungo orizzonte, la consapevolezza dello stato, la verifica dei risultati e la gestione sicura degli obiettivi.
RAG non riuscito — Ma quale livello ha effettivamente fallito? Un metodo diagnostico
Quando una risposta RAG è sbagliata, dare la colpa al recupero o al modello è troppo vago. Questo metodo diagnostico isola la copertura delle fonti, la costruzione della query, il recupero, il ranking, l'assemblaggio del contesto, la generazione, l'attribuzione delle evidenze e l'aggiornamento—così il guasto effettivo può essere riprodotto e corretto.
Qwen 3.6 in produzione: Runbook di rilascio, Rollback AI e Versionamento LLMOps
Qwen 3.6 non è solo un altro aggiornamento del modello. È un evento di rilascio, uno scenario di rollback e un problema di versionamento allo stesso tempo. Questo articolo spiega come Qwen 3.6 dovrebbe essere gestito in produzione attraverso la disciplina LLMOps, la tracciabilità dei prompt e dei modelli, il rollout controllato e la prontezza al rollback basata sull'evidenza.

Cos'è il RAG? La spiegazione più semplice di come funziona
RAG sembra complicato, ma l'idea è semplice: prima che un'IA risponda, cerca prima informazioni utili da una fonte di conoscenza e fornisce tali informazioni al modello linguistico. Questa guida spiega RAG, LLM, stato, memoria e strumenti utilizzando un semplice modello mentale.
Affidabilità degli Agenti AI: Perché la Risposta Finale Non è Sufficiente
Un output corretto non dimostra un ragionamento corretto, un'esecuzione sicura o un sistema affidabile.