
Come sapere se un agente IA ha effettivamente usato le prove giuste

Un agente di IA può citare fonti, recuperare documenti e continuare a utilizzare le prove sbagliate. Una fonte può essere autorevole ma irrilevante rispetto all'affermazione esatta. Un passaggio recuperato può supportare solo una parte di una risposta. Una fonte corretta può essere obsoleta, superata o valida per la giurisdizione, la versione del prodotto, l'utente o lo stato del sistema errati. Ciò crea un problema di valutazione più complesso rispetto alla semplice verifica delle citazioni: l'agente ha effettivamente utilizzato le prove giuste per l'affermazione formulata?
Perché le citazioni non sono sufficienti
Una citazione risponde solo a una domanda circoscritta: il sistema ha associato un'affermazione o una risposta a una fonte. Non stabilisce automaticamente che la fonte supporti l'affermazione specifica, che la fonte sia sufficientemente autorevole per il compito, che il passaggio citato contenga la condizione o l'eccezione necessaria o che il modello si sia basato su tale prova anziché generare la risposta a partire dalle proprie conoscenze pregresse.
Le linee guida di Anthropic per la valutazione degli agenti di ricerca separano esplicitamente groundedness, copertura e qualità delle fonti. Analogamente, le linee guida di OpenAI per la valutazione degli agenti pongono l'accento sulle tracce di esecuzione, poiché l'output finale non rivela se l'agente abbia selezionato gli strumenti corretti o seguito il flusso di lavoro previsto. Tali considerazioni portano a una conclusione più ampia: la qualità delle prove è una proprietà del percorso di esecuzione, non solo della prosa finale.
Le quattro domande che ogni affermazione rilevante dovrebbe superare
| Dimensione | Domanda | Errore tipico |
|---|---|---|
| Supporto dell'affermazione | La prova supporta direttamente questa specifica affermazione? | La fonte è correlata all'argomento ma non dimostra l'affermazione |
| Autorevolezza della prova | Si tratta di una fonte appropriata per questo tipo di affermazione? | Viene utilizzata una sintesi secondaria laddove è richiesta una fonte primaria o un sistema in tempo reale |
| Applicabilità | La prova si applica a questo periodo, versione, giurisdizione, utente, stato o popolazione? | Un'affermazione vera viene applicata al di fuori delle sue condizioni di validità |
| Utilizzo della prova | Questa prova era effettivamente disponibile e utilizzata nel percorso di esecuzione dell'agente? | La risposta finale è corretta, ma la prova recuperata era irrilevante o non utilizzata |
1. Supporto dell'affermazione: la fonte dimostra ciò che l'agente sostiene?
Le prove dovrebbero essere valutate a livello di singola affermazione. Un documento può essere pertinente all'argomento e tuttavia non supportare una dichiarazione specifica. Se una fonte afferma che una funzionalità è disponibile solo in determinate regioni, la risposta “la funzionalità è disponibile a livello globale” non è supportata, anche se la citazione appare plausibile.
È qui che le valutazioni generiche del tipo “fondato / non fondato” risultano spesso troppo approssimative. Suddividi la risposta in affermazioni rilevanti, associa ciascuna affermazione alla porzione minima di prova che la supporta e classifica la relazione: supporto diretto, supporto parziale, contraddizione o nessun supporto.
2. Autorevolezza della prova: è il tipo di fonte corretto?
La selezione corretta delle prove non riguarda solo la pertinenza semantica. La fonte deve essere adeguata alla decisione da prendere. Lo stato attuale dell'account deve provenire dal sistema di gestione degli account, non da una vecchia e-mail. Un'affermazione sul comportamento di un'API dovrebbe preferibilmente essere verificata rispetto alla documentazione aggiornata del fornitore o a un comportamento riproducibile. Un requisito legale può richiedere la legge applicabile, l'autorità di regolamentazione o linee guida ufficiali, piuttosto che un generico articolo di blog.
L'autorevolezza della fonte dipende dal compito specifico. La segnalazione di una community può rappresentare la prova migliore per un bug reale non riconosciuto dalla documentazione del fornitore. L'annuncio di un fornitore può essere autorevole per ciò che il fornitore dichiara, ma costituire una prova debole per una valutazione indipendente delle prestazioni. Chi valuta necessita pertanto di una gerarchia esplicita delle fonti per il compito specifico, piuttosto che di un unico punteggio di autorevolezza universale.
3. Applicabilità: prove corrette, condizioni errate
Gli errori più insidiosi nell'uso delle prove spesso non derivano da fonti inventate, ma da fonti valide impiegate al di fuori dei loro limiti di applicabilità. Una raccomandazione può variare in base alla versione del software, alla data, alla giurisdizione, alla revisione hardware, ai permessi utente, alla disponibilità del prodotto, allo stato corrente del gioco, alla configurazione del tenant o ad altre variabili ambientali.
Per ogni fonte rilevante, preserva le condizioni che determinano se sia ancora applicabile. Questo aspetto è particolarmente critico dopo una sintesi: una memoria compressa o una citazione può conservare la conclusione tralasciando l'eccezione, la data o il prerequisito che ne determinavano la validità.
4. Uso delle prove: l'agente ha fatto effettivamente affidamento sulle prove?
Una risposta può essere corretta anche quando il recupero delle informazioni è fallito. Il modello potrebbe già conoscere la risposta, dedurla da un contesto non correlato o semplicemente indovinare correttamente. Se la valutazione verifica solo la correttezza finale, il sistema può sembrare ben fondato anche quando il percorso probatorio è interrotto.
Per valutare l'uso delle prove, esamina la traccia. Verifica quali fonti sono state recuperate, quali passaggi hanno raggiunto il contesto del modello, quando sono diventati disponibili e se l'affermazione finale può essere spiegata da tali input. Gli attuali strumenti di valutazione degli agenti di OpenAI pongono l'accento sulla valutazione delle tracce proprio perché il comportamento a livello di flusso di lavoro non può essere ricostruito in modo affidabile solo a partire dalla risposta finale.
Il Test di Utilizzo delle Prove
Una valutazione pratica può essere strutturata come un controfattuale controllato. Invece di chiedersi solo se la risposta sia corretta, modifica le prove e osserva se l'affermazione cambia nella direzione prevista.
Test di Utilizzo delle Prove
Una matrice affermazioni-prove è più utile di un elenco di fonti
| Affermazione | Prova | Supporto | Autorevolezza | Applicabilità | Utilizzata nella traccia |
|---|---|---|---|---|---|
| La funzionalità X è disponibile | Documentazione del fornitore | Diretto | Alta per l'affermazione sulla disponibilità | La versione attuale e la regione devono corrispondere | Sì / No |
| La configurazione Y è più veloce | Benchmark del fornitore | Parziale | Alta per il test del fornitore, non per le prestazioni indipendenti | L'hardware e il carico di lavoro devono corrispondere | Sì / No |
| La policy si applica a questo utente | Policy attuale + stato dell'account | Diretto solo se combinati | Alta | Giurisdizione, data, ruolo e stato dell'account devono corrispondere | Sì / No |
| Un prodotto è disponibile | API dell'inventario in tempo reale | Diretto | Autorevole per le scorte attuali | Scade rapidamente | Sì / No |
Questa matrice impone diverse domande che la verifica convenzionale delle citazioni nasconde. Una singola affermazione può richiedere più fonti. Una fonte può supportare solo una parte di un'affermazione. Una fonte autorevole può avere una finestra di validità limitata. E una fonte del tutto valida può risultare irrilevante se non è mai entrata nel percorso di esecuzione.
Distinguere la qualità del recupero dalla qualità delle prove
Le metriche di recupero valutano se il materiale rilevante è stato individuato e classificato. La valutazione delle prove verifica se quel materiale giustifica le affermazioni risultanti. I due aspetti sono correlati ma non identici.
Il successo nel recupero non equivale alla validità delle prove
| Situazione | Recupero | Qualità delle prove | |
|---|---|---|---|
| Documento corretto, affermazione errata | |||
| Fatto corretto, fonte obsoleta | |||
| Fonte debole, risposta corretta | |||
| Necessarie fonti multiple |
Valutare la qualità delle fonti tramite una rubrica, non con una whitelist di domini
Le liste statiche di “domini attendibili” sono allettanti ma spesso fragili. La qualità della fonte dovrebbe invece riflettere il tipo di affermazione. Dimensioni utili includono lo stato primario o secondario, la tempestività, la pertinenza diretta, la riproducibilità, l'indipendenza, la competenza specifica nel dominio, la provenienza dei dati, la frequenza di aggiornamento e l'eventuale interesse della fonte a enfatizzare l'affermazione.
Le linee guida per la valutazione degli agenti di ricerca di Anthropic richiedono esplicitamente verifiche sulla qualità delle fonti, insieme alla fondatezza e alla copertura. L'implementazione pratica dovrebbe quindi valutare sia ciò che la fonte afferma, sia l'adeguatezza della fonte per quel tipo di dichiarazione.
Copertura delle prove: ogni affermazione importante ha bisogno di supporto, non ogni frase
Non tutte le frasi necessitano di una citazione. Il linguaggio di transizione, i calcoli aritmetici derivati in modo trasparente da valori citati o un'interpretazione chiaramente contrassegnata potrebbero non richiedere una fonte separata. Tuttavia, ogni affermazione rilevante e verificabile esternamente dovrebbe disporre di un supporto sufficiente a consentire a un valutatore di ricostruire il motivo per cui l'agente era autorizzato a formularla.
La copertura dovrebbe pertanto essere ponderata in base all'importanza dell'affermazione. La mancanza di supporto per un dettaglio decorativo non equivale alla mancanza di supporto per un prezzo, una decisione di idoneità, un'istruzione di sicurezza, un requisito legale, una dichiarazione di compatibilità tecnica o un fatto determinante per una raccomandazione.
La provenienza delle prove deve sopravvivere alla sintesi e alla memoria
Gli agenti a lunga esecuzione spesso riassumono il lavoro precedente o scrivono memorie persistenti. Se la provenienza delle prove viene rimossa durante tale trasformazione, gli agenti futuri potrebbero recuperare una conclusione chiara senza sapere se proviene da una dichiarazione dell'utente, da un'API attiva, da un vecchio documento, da un'inferenza del modello o da un risultato web non verificato.
Per i fatti importanti, conserva almeno l'identità della fonte, l'orario di recupero o di osservazione, il tipo di prova, la versione o lo stato pertinente e se il testo memorizzato è citato testualmente, riassunto, inferito o derivato. La provenienza è ciò che consente a un agente successivo di decidere se la prova debba essere considerata attendibile, aggiornata, limitata o scartata.
Un registro pratico delle prove
| Field | Scopo |
|---|---|
| claim_id | Identifica l'affermazione rilevante supportata |
| source_id / source_url / system | Identifica la provenienza della prova |
| evidence_span | Conserva il passaggio, il record o il risultato del tool più piccolo che supporta l'affermazione |
| retrieved_at / observed_at | Consente verifiche di freschezza e temporali |
| source_version / object_version | Consente verifiche di obsolescenza e riproducibilità |
| authority_role | Spiega perché questa fonte è appropriata per questa affermazione |
| applicability | Memorizza data pertinente, giurisdizione, versione del prodotto, utente, tenant, stato o altre condizioni |
| transformation | Indica se la prova è grezza, citata, riassunta, normalizzata o derivata |
| trace_step | Mostra quando la prova è diventata disponibile per l'agente |
| support_status | Diretto, parziale, contraddittorio, non supportato o incerto |
Modalità di fallimento che sembrano fondate ma non lo sono
| Modalità di fallimento | Perché inganna i valutatori | Cosa testare |
|---|---|---|
| Citazione decorativa | La risposta contiene fonti, quindi sembra documentata | Mappa ogni affermazione rilevante a un passaggio di supporto esatto |
| Mancata corrispondenza di autorevolezza | La fonte è affidabile ma non autorevole per il fatto specifico | Definisci una gerarchia delle fonti specifica per l'affermazione |
| Discrepanza temporale | La fonte era corretta al momento della pubblicazione | Verifica l'orario di recupero, la data della fonte e le prove successive che la sostituiscono |
| Rimozione delle condizioni | Una sintesi mantiene la conclusione ma omette le eccezioni | Confronta l'affermazione generata con il contesto completo della fonte locale |
| Citazione post-hoc | Una fonte plausibile viene allegata dopo la generazione della risposta | Ispeziona l'ordine della traccia e verifica se la prova ha preceduto l'affermazione |
| Sovrascrittura parametrica | Il modello ignora le prove recuperate e risponde in base alle conoscenze pregresse | Esegui test controfattuali sull'utilizzo delle prove |
| Riciclaggio delle prove | L'inferenza del modello viene riassunta e successivamente memorizzata come se fosse un fatto della fonte | Preserva il tipo di trasformazione e la provenienza attraverso le scritture in memoria |
| Fallacia della maggioranza delle fonti | Diverse pagine secondarie ripetono la stessa affermazione non supportata | Ripercorri le affermazioni fino a prove indipendenti o primarie |
Come valutare l'agente in produzione
Pipeline di valutazione delle prove
Le attuali linee guida di valutazione di OpenAI raccomandano valutazioni specifiche per l'attività, valutazione continua, set di dati derivati dalla produzione e tracce per il debug del comportamento dell'agente. Allo stesso modo, Anthropic raccomanda di combinare diversi tipi di valutatori per gli agenti di ricerca, poiché correttezza, qualità della fonte, copertura e fondatezza sono dimensioni distinte. La valutazione delle prove dovrebbe seguire lo stesso schema: diversi valutatori mirati offrono una diagnosi migliore rispetto a un unico punteggio opaco di “qualità”.
Non lasciare che un LLM as a judge sia l'unico a valutare le prove
I valutatori LLM sono utili per la classificazione scalabile delle affermazioni, i controlli di pertinenza e i confronti a coppie, ma possono condividere gli stessi punti ciechi del sistema che valutano. Un valutatore potrebbe accettare un'affermazione plausibile ma priva di supporto, ignorare un sottile confine di versione o sovrastimare una fonte ben scritta.
Le linee guida di valutazione di OpenAI raccomandano di calibrare i valutatori automatizzati rispetto al giudizio umano e di utilizzare criteri chiari e ben delimitati. Per i sistemi fortemente basati su prove, dovrebbero essere utilizzati controlli deterministici ovunque possibile: timestamp, versioni degli oggetti, ambito dei permessi, ID esatti delle fonti, ordine di recupero, hash dei documenti e presenza della prova prima che il modello generasse l'affermazione.
Cosa cambierebbe questa risposta?
La valutazione può essere più semplice quando l'agente opera su un corpus ristretto, immutabile e autorevole, e ogni risposta è strettamente estrattiva. In un contesto simile, l'autorevolezza e l'applicabilità della fonte sono per lo più fisse e la corrispondenza del supporto tra affermazione e porzione di testo può essere sufficiente.
La valutazione deve farsi più rigorosa quando l'agente combina ricerche web, memoria a lungo termine, tool in tempo reale, molteplici giurisdizioni, informazioni in rapido mutamento, stato specifico dell'utente o azioni autonome. In tali sistemi, la validità delle prove non dipende solo dal testo di partenza, ma anche da quando e come la prova è stata ottenuta.
I modelli futuri potrebbero diventare più abili nel tracciare internamente provenienza e incertezza, ma ciò non eliminerebbe la necessità di registri di evidenze esterne nei sistemi che richiedono verificabilità. Un sistema non dovrebbe dipendere dall'auto-segnalazione del modello su cosa lo abbia influenzato, quando le tracce e i metadati delle fonti possono fornire prove più solide.
Limitazioni
Non è sempre possibile dimostrare l'uso causale delle evidenze basandosi unicamente sulle tracce. Una fonte può essere presente nel contesto senza influenzare la risposta, e un modello potrebbe conoscere lo stesso fatto in modo indipendente. I test controfattuali rafforzano l'inferenza, ma possono essi stessi alterare la distribuzione del task.
L'autorevolezza delle fonti può anche essere contestata o dipendere dal dominio. Alcune domande non hanno un'unica fonte autorevole e gli esperti possono dissentire su quale evidenza meriti maggior peso. In questi casi, il valutatore dovrebbe preservare il disaccordo e valutare trasparenza, copertura e ragionamento rispetto a una rubrica esplicita, anziché fingere che esista un'unica fonte di verità indiscutibile.
Conclusione
La domanda "L'agente ha citato una fonte?" è troppo debole per l'IA in produzione. La domanda più incisiva è: ogni affermazione importante proviene da un'evidenza che la supporta effettivamente, possiede la corretta autorevolezza, si applica ancora alle condizioni attuali ed era disponibile nel percorso di esecuzione prima che l'affermazione fosse formulata?
Questo trasforma le evidenze da elemento decorativo a proprietà valutabile del sistema. Cattura la traccia. Mappa le affermazioni sulle evidenze. Verifica autorevolezza e applicabilità. Esegui test controfattuali sulle evidenze. Preserva la provenienza attraverso sintesi e memoria. In questo modo, una risposta corretta non è solo plausibile: ha un percorso di evidenze che puoi ispezionare.
Domande frequenti
Valutare l'uso delle evidenze negli agenti IA
Una citazione dimostra che una risposta dell'IA è fondata?
Come posso verificare se un agente IA ha effettivamente utilizzato l'evidenza recuperata?
Qual è la differenza tra fondatezza e qualità della fonte?
Perché una fonte reale può comunque generare una risposta IA errata?
Cosa occorre registrare nei log per la valutazione delle evidenze?
Glossario
Termini chiave per la valutazione delle evidenze
- Supporto dell'affermazione
- Il grado in cui uno specifico estratto di evidenza dimostra direttamente un'affermazione generata.
- Applicabilità
- Le condizioni entro cui un'evidenza rimane valida per un'affermazione, inclusi tempo, versione, giurisdizione, utente, popolazione, stato del sistema o altri limiti.
- Utilizzo delle evidenze
- La misura in cui l'output dell'agente risponde effettivamente e dipende dalle evidenze rese disponibili nel suo percorso di esecuzione.
- Test controfattuale sulle evidenze
- Una valutazione che rimuove, sostituisce o modifica un'evidenza decisiva per verificare se l'affermazione dell'agente cambia di conseguenza.
- Provenienza
- Metadati che registrano l'origine dell'evidenza, il momento in cui è stata ottenuta, il modo in cui è stata trasformata e quale versione o stato rappresentava.
Fonti primarie e ulteriori letture
OpenAI — Evaluate Agent WorkflowsLinee guida sulla valutazione delle tracce, valutazione a livello di workflow, dataset ed esecuzioni di valutazione ripetibili per agenti.
OpenAI — Evaluation Best PracticesLinee guida su valutazioni specifiche per task, dataset derivati dalla produzione, metriche circoscritte, valutazione continua e calibrazione del grader.
Anthropic — Demystifying Evals for AI AgentsGuida alla valutazione degli agenti, inclusi controlli di fondatezza, copertura e qualità delle fonti per agenti di ricerca.
OpenAI — A Shared Playbook for Trustworthy Third-Party EvaluationsLinee guida di valutazione che evidenziano come le prestazioni degli agenti moderni dipendano dal workflow e dall'ambiente, non solo dall'output finale del modello.
Related Articles

Il confine della validità della risposta: il livello mancante tra rilevanza e risposte AI affidabili
Una fonte può essere pertinente, autorevole e comunque errata per la domanda posta. Il livello mancante è l'applicabilità: le condizioni alle quali una risposta è valida e i cambiamenti che ne impongono una riconsiderazione. Questo articolo introduce l'Answer Validity Boundary come modello di progettazione delle fonti per esseri umani, ricerca AI e sistemi RAG.

Dovresti Acquistare un Router OpenWrt 5G con Firmware Vecchio? ZBT Z8102AX come Esempio Pratico
Acquistare un router 5G OpenWrt con firmware più vecchio può avere senso, ma solo nelle giuste condizioni. Lo ZBT Z8102AX mostra chiaramente entrambi i lati: l'hardware è utile, il modem funziona e il router è rimasto stabile durante i test, ma OpenWrt 21.02, il packaging debole e i percorsi di aggiornamento poco chiari richiedono una decisione d'acquisto attenta.

MCP vs A2A vs UCP vs AP2 vs A2UI: Lo stack di protocolli degli agenti spiegato
MCP, A2A, UCP, AP2 e A2UI sono spesso presentati come standard per agenti concorrenti. Per lo più risolvono problemi di interoperabilità diversi. Questa guida mappa ciascun protocollo sul confine che effettivamente standardizza—e mostra come possano lavorare insieme in un unico sistema di produzione.
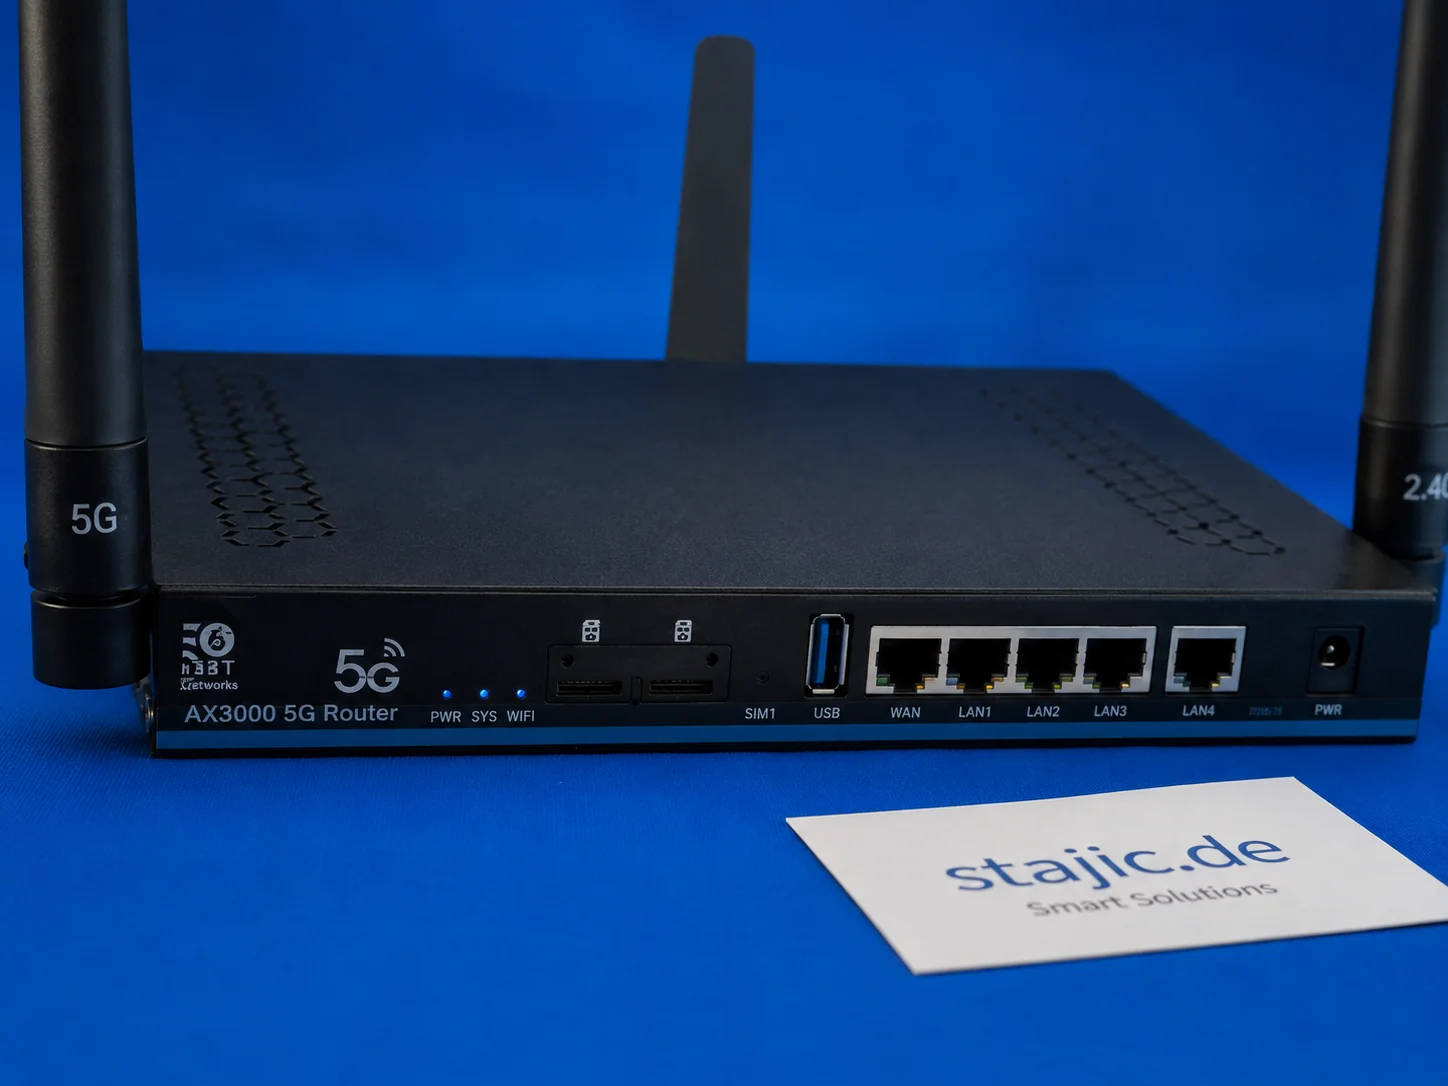
Quectel RM500U-EA nel ZBT Z8102AX: bande 5G, o2 Germania e comportamento del segnale nel mondo reale
Lo ZBT Z8102AX utilizza un modem Quectel RM500U-EA per la connettività 4G e 5G. Nel primo test pratico, il router si è connesso con successo a o2 Germany con la banda LTE 3 e NR n28. Il modem funziona, ma diagnostiche più approfondite come RSRP, RSRQ, SINR, il blocco delle bande e il comportamento delle celle richiedono ancora test adeguati.

Perché più contesto può peggiorare le risposte dell'IA
Una finestra di contesto più ampia non garantisce una risposta migliore. Questo articolo spiega come la diluizione del segnale, le prove contrastanti, lo stato obsoleto, la sensibilità alla posizione e la compressione con perdita possano ridurre l'affidabilità dell'IA—e introduce un pratico Context Pressure Test.

Agenti per l'uso del computer: perché una demo di successo può comunque essere un sistema inaffidabile
Gli agenti computer-use possono ora completare impressionanti flussi di lavoro su browser e desktop, ma una singola esecuzione riuscita dimostra la capacità—non l'affidabilità. Questo articolo mostra come testare la ripetibilità, la robustezza ambientale, il controllo a lungo orizzonte, la consapevolezza dello stato, la verifica dei risultati e la gestione sicura degli obiettivi.
Architettura Canonica, Progettazione URL, Logica del Resolver, Specifiche API e Scalabilità
Architettura di scoperta geobasata per portali multi-tenant. Definisce URL canonici, logica di risoluzione, strategia di caching e un modello di lettura geografico senza accoppiamento con CMS o rifattorizzazione del database. Progettata per stabilità SEO, scalabilità ed estensioni future come prenotazioni e mappe.

Cosa dovrebbe ricordare, dimenticare, ricalcolare o recuperare di nuovo un agente IA?
Gli agenti a lunga esecuzione non dovrebbero ricordare tutto. Questo articolo fornisce un modello pratico di ciclo di vita per decidere cosa appartiene alla memoria durevole, cosa dovrebbe essere recuperato di nuovo, cosa è più sicuro ricalcolare e cosa dovrebbe scadere o essere sostituito.
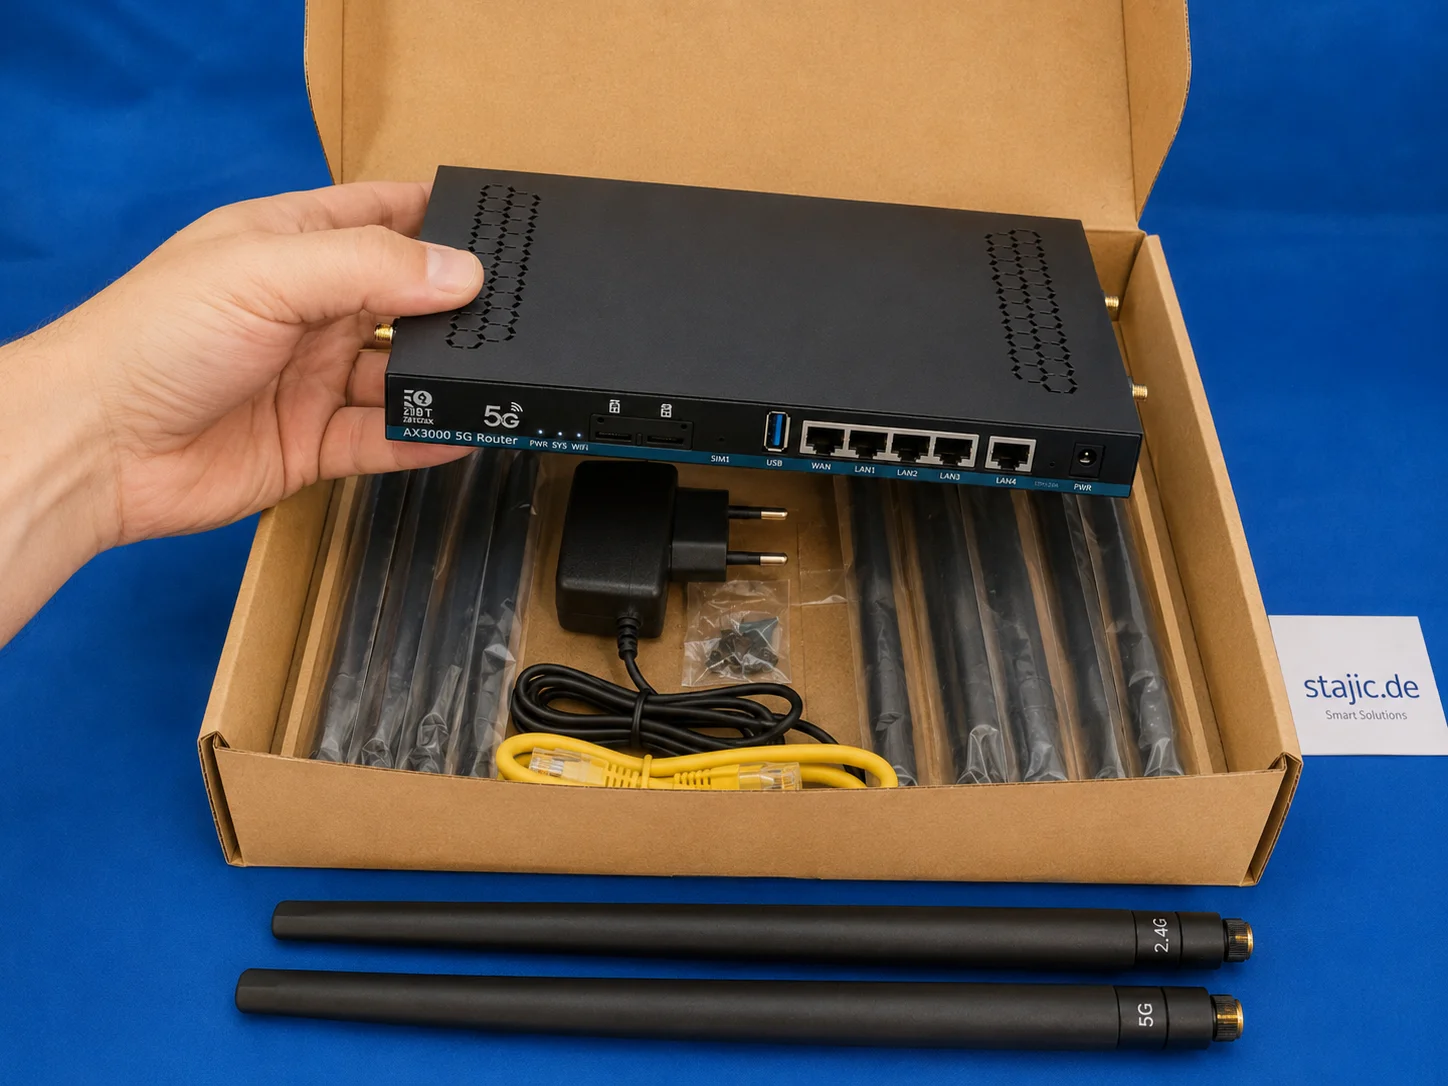
Recensione hardware e confezione di ZBT Z8102AX: router forte, scatola debole
Lo ZBT Z8102AX fa una solida prima impressione come router OpenWrt 5G sottile in metallo nero con molteplici connettori per antenna, slot dual-SIM, porte USB, LAN/WAN e un pratico set di accessori. L'hardware sembra utile e serio, ma la confezione è chiaramente il punto debole.